TCP/IP por dentro: como os dados atravessam a internet
Uma imersão na base da internet. As camadas, o IP e os endereços, o roteamento, as portas e o NAT, o UDP, o TCP por dentro, o controle de congestionamento, o IPv6 e o QUIC, com as ferramentas de diagnóstico, os erros mais comuns e o jeito como a Gothor usa tudo isso.
Uma consulta ao sistema de gestão, a nota fiscal que sai para a Sefaz, o Pix que chega ao banco, a mensagem que a equipe manda pelo celular: tudo isso viaja pela rede em pequenos pedaços, que atravessam cabos, antenas e dezenas de equipamentos que nunca se viram antes, e chegam ao destino na ordem certa e sem erros. Quem organiza essa viagem é um conjunto de protocolos com um nome que quase todo profissional de tecnologia já ouviu, mas poucos conhecem por dentro: o TCP/IP.
O TCP/IP costuma aparecer só quando alguma coisa dá errado. Uma conexão que "cai sozinha" depois de alguns minutos parada, um sistema que funciona na rede da empresa e não funciona pela VPN, um servidor que responde no endereço de dentro e não responde no de fora, uma integração que fica lenta só em certos horários. Nesses momentos, entender o que acontece por baixo da aplicação é o que separa horas de tentativa e erro de um diagnóstico em minutos.
Este artigo é uma imersão no TCP/IP, de baixo para cima: a ideia das camadas, o protocolo IP e os endereços, o caminho de um pacote pelos roteadores, as portas e a tradução de endereços, o UDP, o TCP com a abertura da conexão, as janelas, as retransmissões e o controle de congestionamento, o IPv6 e o QUIC. Depois, as ferramentas para investigar, um diagnóstico passo a passo e os erros mais comuns. No fim, contamos em poucas linhas como a Gothor aplica esses conceitos.
O que é o TCP/IP
O nome engana um pouco. TCP/IP não é um protocolo, é uma família de protocolos, também chamada de Internet Protocol Suite. O nome vem dos dois mais conhecidos: o IP (Internet Protocol), que leva pacotes de um endereço a outro, e o TCP (Transmission Control Protocol), que transforma essa entrega de pacotes numa conversa confiável entre dois programas. Ao redor deles há dezenas de outros: o UDP, o ICMP, o ARP, o DHCP, o DNS, o HTTP, o TLS, o SMTP.
A família foi desenhada para resolver um problema específico: ligar redes diferentes entre si. Nos anos 1970 já existiam redes por cabo, por rádio e por satélite, cada uma com o seu formato e as suas regras. A ideia central do TCP/IP é colocar por cima de todas elas um protocolo comum, o IP, de modo que um computador numa rede possa falar com um computador em outra sem saber nada sobre o caminho entre os dois. É daí que vem o nome internet: uma rede de redes.
Três princípios explicam quase todas as decisões do projeto:
- Entrega de melhor esforço. O IP faz o possível para entregar cada pacote, mas não promete nada. Um pacote pode se perder, chegar duplicado, chegar fora de ordem ou chegar corrompido. A rede não guarda estado sobre as conversas que passam por ela; cada pacote é tratado sozinho.
- Inteligência nas pontas. O que precisa de garantias, como entregar tudo, na ordem certa, sem sobrecarregar ninguém, é feito pelos computadores das pontas, e não pelos equipamentos do meio. Esse é o chamado princípio de ponta a ponta. A rede fica simples e barata, e as aplicações escolhem quanta garantia querem.
- Camadas independentes. Cada protocolo cuida de uma parte do problema e usa a camada de baixo como serviço. Trocar o cabo por Wi-Fi não muda nada para o TCP; trocar o TCP pelo UDP não muda nada para o roteador.
A arquitetura costuma ser descrita como uma ampulheta: embaixo, muitas tecnologias físicas (Ethernet, Wi-Fi, fibra, 4G e 5G); em cima, muitas aplicações; no meio, na cintura estreita, um único protocolo, o IP. Tudo embaixo só precisa carregar pacotes IP, e tudo em cima só precisa entregá-los ao IP. Foi essa cintura que permitiu à internet crescer sem um coordenador central.
Uma história curta
A história do TCP/IP começa com a ARPANET, a rede financiada pela ARPA, a agência de projetos de pesquisa avançada do Departamento de Defesa dos Estados Unidos. Em 1969, os primeiros nós entraram em operação: o primeiro equipamento de comutação de pacotes, um IMP (Interface Message Processor), foi instalado na Universidade da Califórnia em Los Angeles em setembro, e o segundo, no Stanford Research Institute, um mês depois. A ARPANET usava um protocolo próprio, o NCP, que funcionava bem dentro dela, mas não sabia ligar redes diferentes.
Em 1973, Vinton Cerf e Robert Kahn começaram a trabalhar justamente nesse problema. A proposta deles, publicada em maio de 1974 no artigo A Protocol for Packet Network Intercommunication, era esconder as diferenças entre as redes atrás de um protocolo comum e deixar os computadores das pontas responsáveis pela confiabilidade. Em dezembro de 1974, a primeira especificação do Transmission Control Program saiu como a RFC 675, assinada por Cerf, Yogen Dalal e Carl Sunshine.
Naquela primeira versão, um único programa fazia tudo: o endereçamento entre redes e a entrega confiável. Em 1977, uma demonstração famosa fez dados atravessarem três redes diferentes, uma de rádio, uma de satélite e a própria ARPANET, a partir de uma van na Califórnia, passando pela Europa e voltando aos Estados Unidos. Em 1978, na quarta versão, o programa foi dividido em dois: o IP, sem conexão, cuidando de levar pacotes entre redes, e o TCP, cuidando da conversa confiável entre as pontas. A divisão abriu espaço para aplicações que não precisavam de toda a garantia do TCP, e é dela que nasce o UDP.
As especificações que ainda servem de base vieram em setembro de 1981: a RFC 791, do IP, e a RFC 793, do TCP, editadas por Jon Postel. Em março de 1982, o Departamento de Defesa adotou o TCP/IP como padrão para as suas redes, e em 1º de janeiro de 1983 a ARPANET trocou o NCP pelo TCP/IP de uma vez, num dia de virada que ficou conhecido como flag day. No mesmo ano, a versão 4.2 do BSD, o Unix da Universidade da Califórnia em Berkeley, trouxe uma implementação do TCP/IP e a interface de sockets, que até hoje é a forma como os programas abrem conexões de rede em quase todos os sistemas operacionais.
Nos anos seguintes, o TCP/IP disputou espaço com o modelo OSI, padronizado pela ISO, e venceu na prática: já funcionava, era aberto e tinha implementações gratuitas. Da disputa ficou o vocabulário: até hoje se fala em "camada 3" e "camada 7", números que vêm do OSI.
A família continuou evoluindo. Em 1989, as RFCs 1122 e 1123 consolidaram os requisitos para um computador conectado à internet. Em 1993, o CIDR mudou a forma de dividir os endereços, para conter o esgotamento do IPv4. O IPv6 foi especificado nos anos 1990 e chegou à forma atual na RFC 8200, de 2017. E, em 2022, a RFC 9293 reuniu numa só especificação do TCP as correções e extensões que se acumularam desde 1981, substituindo a RFC 793 depois de mais de quarenta anos.
As camadas, uma dentro da outra
O TCP/IP organiza a comunicação em quatro camadas. Cada uma conversa com a camada equivalente do outro lado e usa a camada de baixo como transporte.
- Enlace (ou acesso à rede). Leva os dados de um equipamento ao próximo, dentro da mesma rede física. É o mundo da Ethernet, do Wi-Fi e da fibra, com endereços físicos, os endereços MAC, gravados nas placas de rede.
- Internet. Leva pacotes de um computador a outro, atravessando quantas redes forem necessárias. É o território do IP e do ICMP, a camada dos endereços IP e dos roteadores.
- Transporte. Entrega os dados ao programa certo dentro do computador, pelas portas, e decide quanta garantia a conversa tem. É onde vivem o TCP e o UDP.
- Aplicação. O que o programa realmente quer dizer: uma página web pelo HTTP, uma consulta pelo DNS, um e-mail pelo SMTP, uma conexão segura pelo TLS.
Encapsulamento: o envelope dentro do envelope
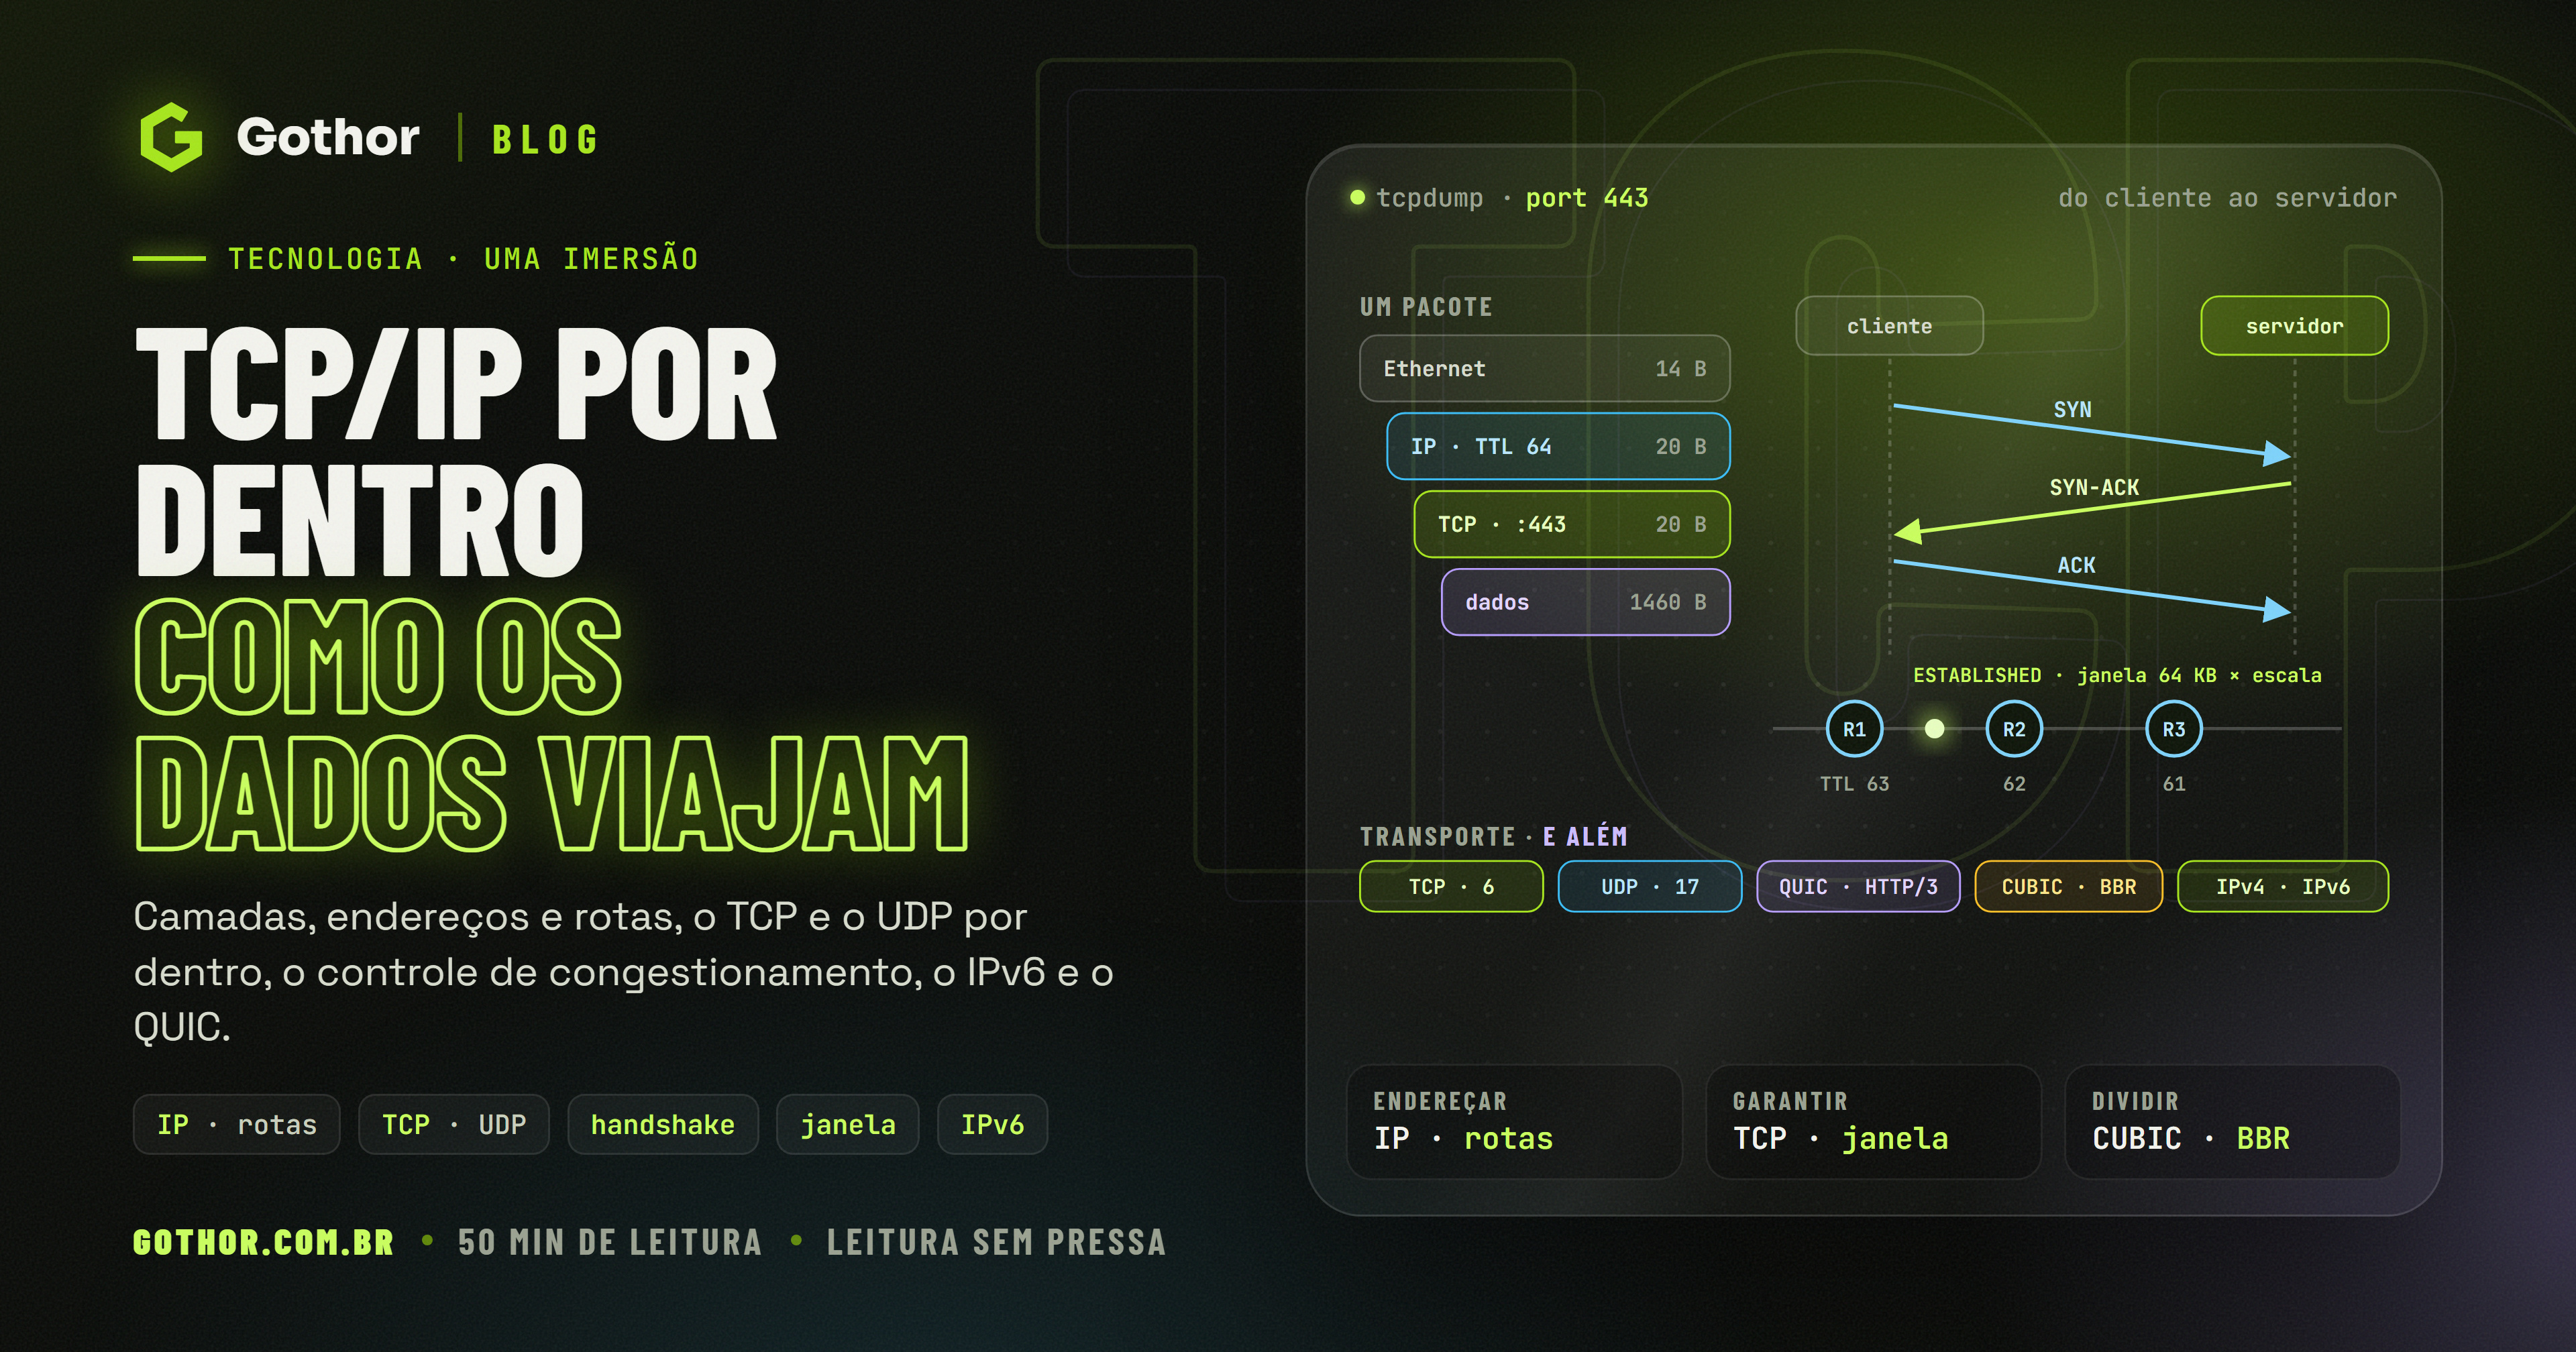
Quando um programa envia dados, cada camada acrescenta o seu próprio cabeçalho, como um envelope dentro de outro. O TCP corta a mensagem da aplicação em segmentos, cada um com um cabeçalho com as portas e os números de sequência. O IP coloca cada segmento num pacote, com os endereços de origem e de destino. A camada de enlace coloca o pacote num quadro, com os endereços físicos do próximo salto e um código de verificação no fim. Do outro lado, o caminho é o inverso: cada camada lê o seu cabeçalho, retira o envelope e entrega o conteúdo à camada de cima.
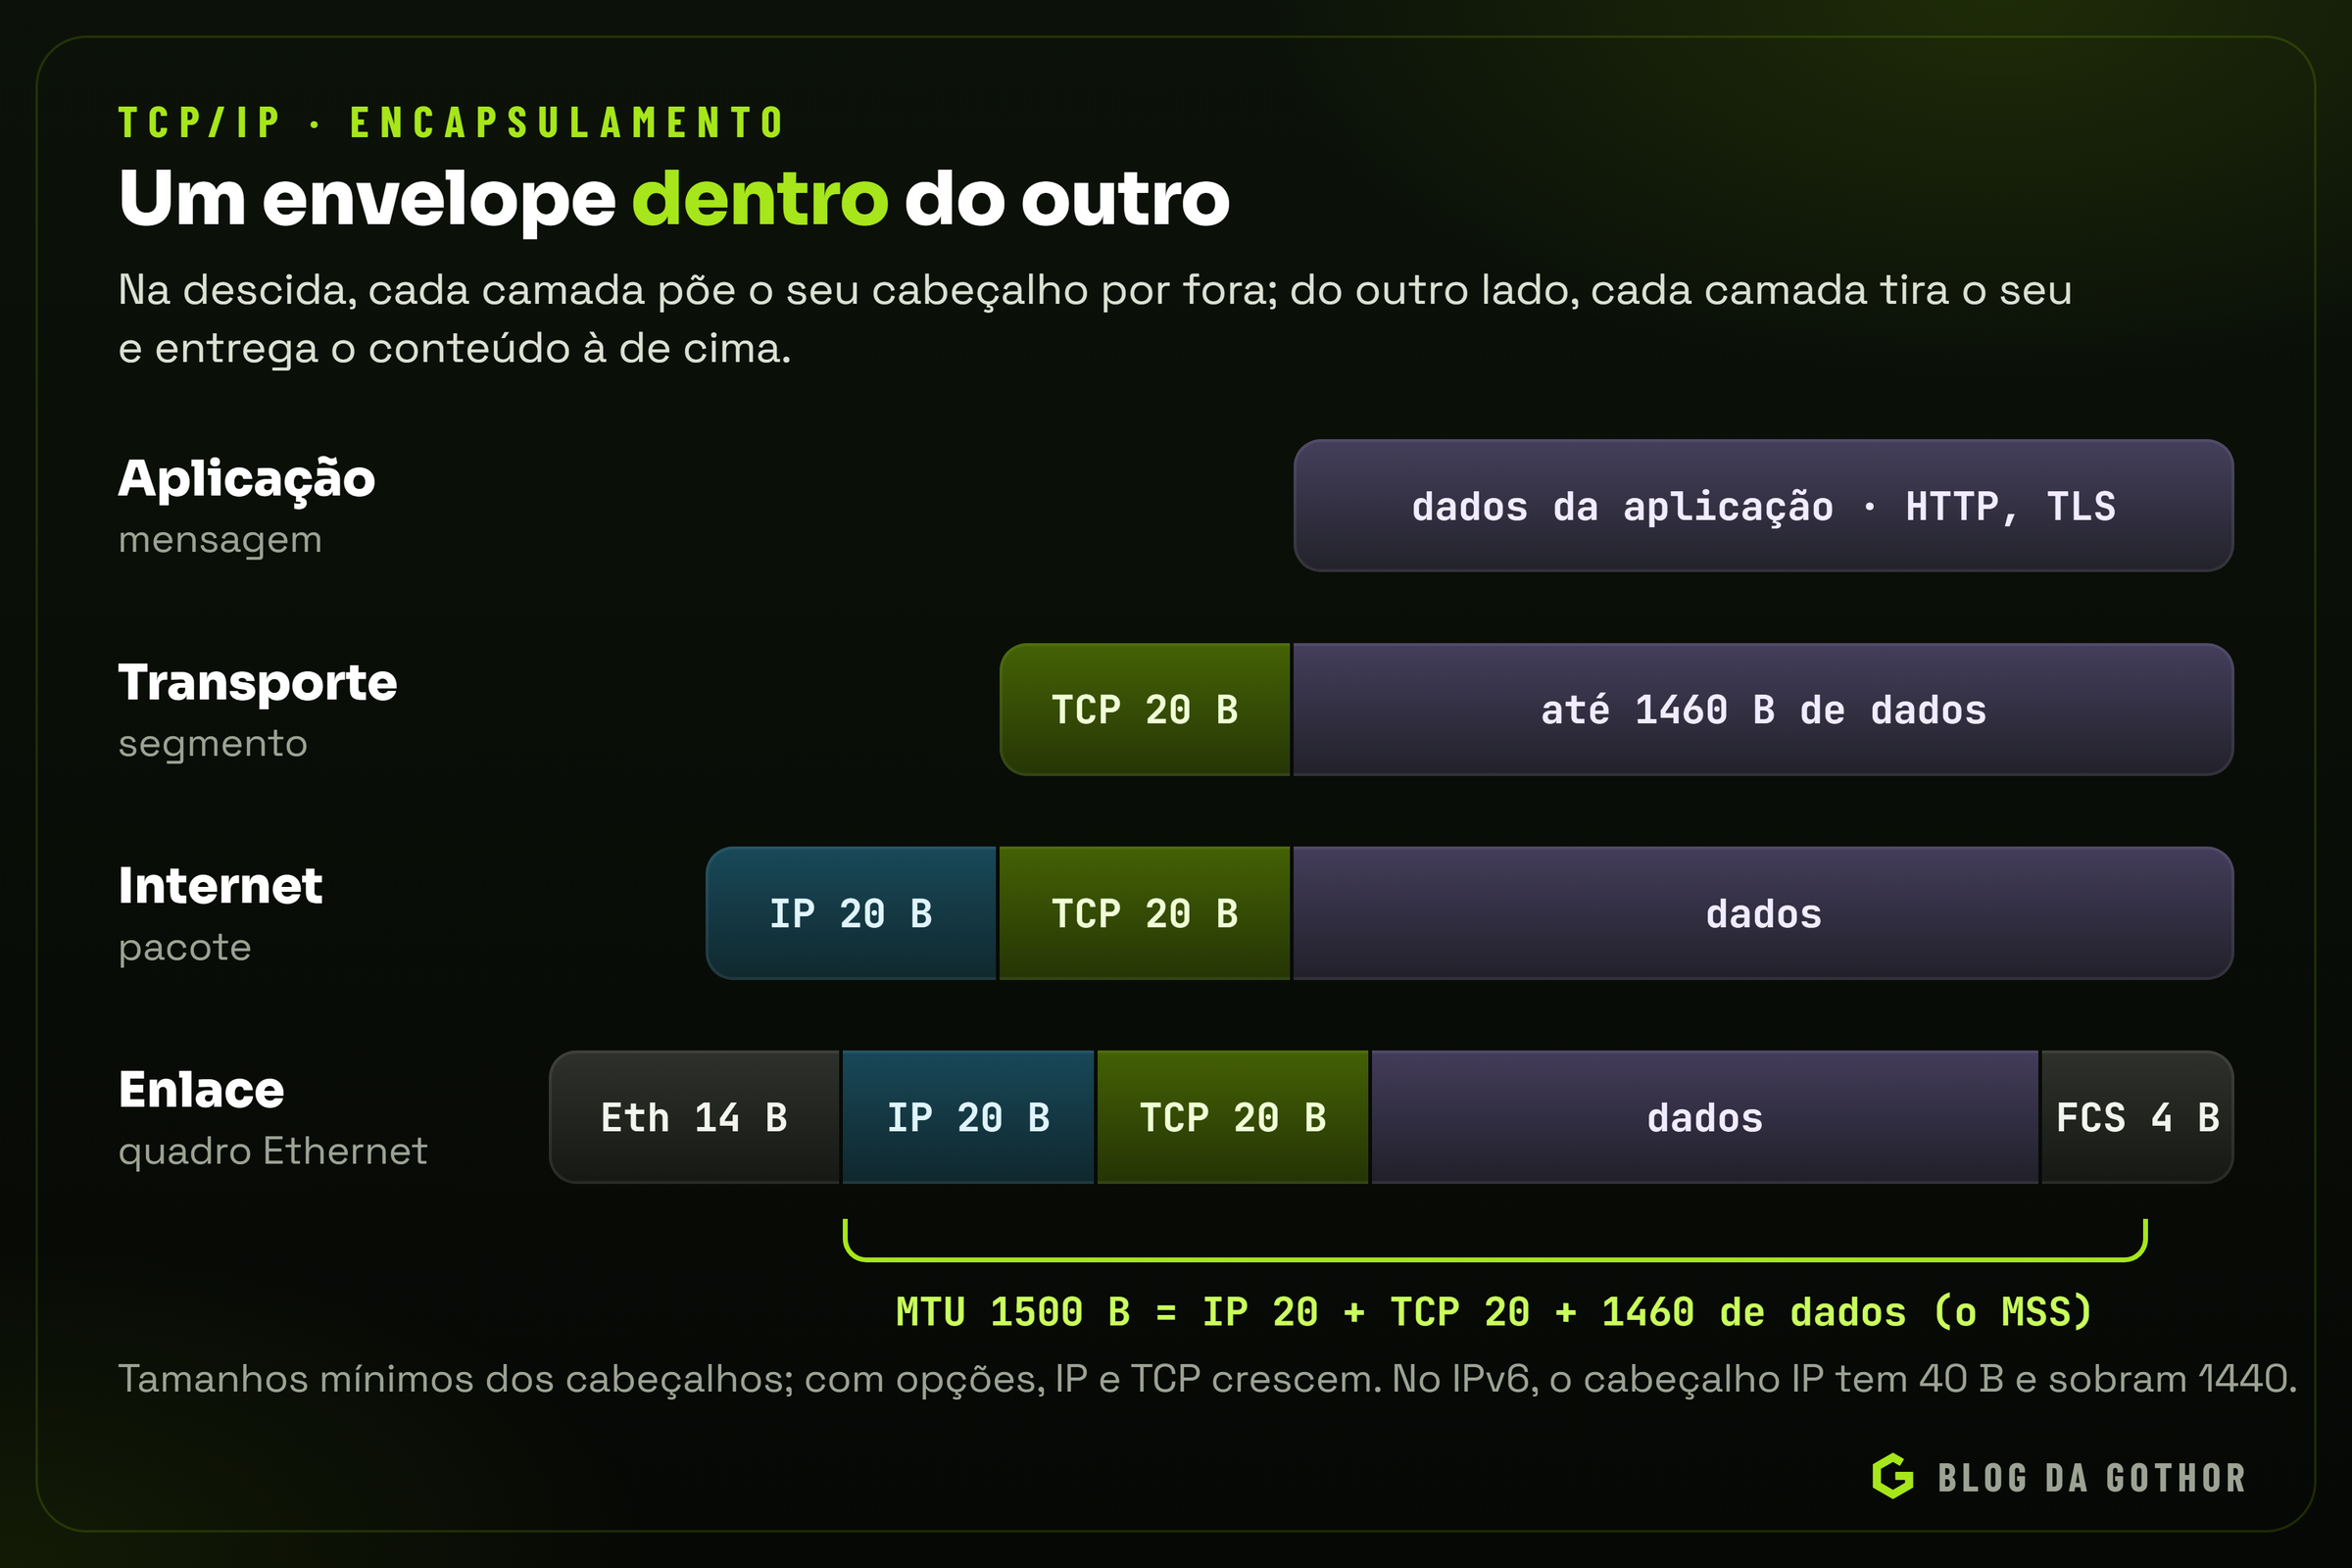
Os números ajudam a entender o custo desse empilhamento. Numa rede Ethernet, o pacote IP cabe num quadro de até 1500 bytes, o chamado MTU (Maximum Transmission Unit). O cabeçalho IPv4 ocupa pelo menos 20 bytes, e o do TCP, outros 20. Sobram 1460 bytes de dados por segmento, o valor que o TCP anuncia como MSS (Maximum Segment Size) quando abre a conexão. Com o IPv6, cujo cabeçalho tem 40 bytes, sobram 1440. Um arquivo de 1 MB, portanto, viaja em cerca de 700 segmentos, cada um com os seus cabeçalhos e a sua confirmação.
O encapsulamento também explica por que cada equipamento só olha o que precisa. Um switch olha o quadro e escolhe a porta física; um roteador abre o quadro, lê o cabeçalho IP, escolhe o próximo salto e monta um quadro novo para a próxima rede. O TCP e a aplicação atravessam o caminho sem que nenhum roteador precise entendê-los.
E o modelo OSI?
O modelo OSI, de sete camadas, continua sendo a forma mais comum de ensinar redes. A correspondência com o TCP/IP é aproximada:
| Modelo OSI | TCP/IP | Exemplos |
|---|---|---|
| 7 Aplicação, 6 Apresentação, 5 Sessão | Aplicação | HTTP, DNS, SMTP, TLS |
| 4 Transporte | Transporte | TCP, UDP |
| 3 Rede | Internet | IP, ICMP |
| 2 Enlace, 1 Física | Enlace | Ethernet, Wi-Fi, fibra |
O OSI foi desenhado primeiro no papel, e os protocolos vieram depois; o TCP/IP fez o caminho inverso, e por isso as fronteiras dele são mais práticas do que rígidas. No dia a dia, "problema de camada 3" quer dizer endereços e roteamento; "camada 4", porta e conexão; "camada 7", a aplicação.
O IP por dentro
O IP tem uma tarefa só: levar um pacote de um endereço a outro. Ele não sabe o que há dentro do pacote, não abre conexões, não confirma o recebimento e não reenvia nada. Cada pacote, que o IP chama de datagrama, é independente: dois pacotes da mesma conversa podem seguir caminhos diferentes e chegar em ordem trocada. Essa simplicidade é proposital. O IP precisa rodar em todos os roteadores do mundo, e quanto menos ele promete, mais fácil é cumprir.
O cabeçalho IPv4
Todo pacote IPv4 começa com um cabeçalho de 20 bytes, que pode crescer até 60 com opções. Os campos mais importantes no dia a dia:
- Versão: 4, no IPv4.
- Tamanho total: o tamanho do pacote inteiro, cabeçalho incluído, até 65.535 bytes.
- Identificação, flags e deslocamento: os campos da fragmentação, explicada abaixo. Uma das flags é o DF (Don't Fragment), que proíbe fragmentar o pacote no caminho.
- TTL (Time to Live): um contador que cada roteador diminui em um. Quando chega a zero, o pacote é descartado e o roteador avisa a origem com uma mensagem ICMP. O TTL existe para que um pacote preso num laço de roteamento não circule para sempre.
- Protocolo: o que vai dentro: 6 para o TCP, 17 para o UDP, 1 para o ICMP.
- Soma de verificação do cabeçalho: confere só o cabeçalho, não os dados. Como o TTL muda a cada salto, cada roteador recalcula essa soma.
- Endereço de origem e endereço de destino, de 32 bits cada.
- DSCP e ECN: marcações de prioridade e de aviso de congestionamento, usadas em redes que diferenciam tráfego.
Endereços IPv4, máscaras e o fim das classes
Um endereço IPv4 tem 32 bits, escritos como quatro números de 0 a 255 separados por pontos, como 192.168.0.10. São cerca de 4,3 bilhões de combinações, um número que parecia enorme nos anos 1970 e que se mostrou pequeno para um mundo com bilhões de celulares, computadores e servidores.
Todo endereço tem duas partes: a rede e o computador dentro dela. Quem diz onde termina uma e começa a outra é a máscara, hoje escrita quase sempre na notação CIDR. 192.168.0.10/24 quer dizer que os primeiros 24 bits identificam a rede (192.168.0.0) e os 8 restantes identificam o computador, o que permite 254 endereços utilizáveis, já que o primeiro identifica a própria rede e o último é o endereço de broadcast. Uma /16 tem 65.534 endereços; uma /30, só dois, o suficiente para ligar dois roteadores.
Na especificação original, a divisão era fixa, por classes (A, B e C, com 8, 16 e 24 bits de rede), e desperdiçava endereços: quem precisava de 300 recebia uma classe B, com 65 mil. Desde 1993, com o CIDR (Classless Inter-Domain Routing), a fronteira pode cair em qualquer bit, e as classes ficaram só nos livros.
Alguns blocos têm uso reservado e aparecem o tempo todo:
- Endereços privados (RFC 1918):
10.0.0.0/8,172.16.0.0/12e192.168.0.0/16. Podem ser usados livremente dentro de qualquer rede, mas não são roteados na internet. A rede da sua empresa quase certamente usa um deles. - Loopback:
127.0.0.0/8, quase sempre127.0.0.1. É o próprio computador falando consigo mesmo, sem passar por nenhuma placa de rede.
Como um computador sabe para onde mandar
Para cada pacote, o computador faz uma pergunta simples: o destino está na minha rede? Se a parte de rede do destino é igual à sua, ele entrega diretamente. Se não, entrega ao gateway padrão, o roteador da rede, que se encarrega do resto. É por isso que três informações bastam para um computador funcionar numa rede IPv4: o próprio endereço, a máscara e o gateway, além do endereço de um servidor de DNS. Na maioria das redes, quem entrega tudo isso automaticamente é o DHCP.
Para entregar um pacote dentro da rede local, falta um detalhe: o endereço IP diz quem é o destino, mas a placa de rede só sabe enviar quadros para endereços físicos. Quem faz a tradução é o ARP (Address Resolution Protocol): o computador pergunta para a rede inteira "quem tem o IP 192.168.0.1?", e o dono responde com o seu endereço MAC. A resposta fica guardada numa tabela, o cache ARP, por alguns minutos. O sentido é sempre esse, do IP para o MAC; e o ARP só existe no IPv4. No IPv6, a mesma tarefa é feita pelo protocolo de descoberta de vizinhos.
Fragmentação e o MTU do caminho
Cada rede do caminho tem o seu MTU, e nem todas aceitam 1500 bytes. Túneis de VPN, por exemplo, acrescentam os próprios cabeçalhos e deixam menos espaço para o pacote de dentro. Quando um pacote é maior do que o MTU do próximo trecho, há duas saídas.
A primeira é a fragmentação: o roteador corta o pacote em pedaços, que só o destino final remonta; se um único fragmento se perder, o pacote inteiro está perdido. Por isso, é evitada.
A segunda é a descoberta do MTU do caminho (Path MTU Discovery). A origem envia os pacotes com a flag DF, que proíbe a fragmentação. Se um roteador do caminho não consegue passar o pacote, ele o descarta e devolve uma mensagem ICMP dizendo "fragmentação necessária", com o MTU que aceita. A origem reduz o tamanho e tenta de novo. É um mecanismo elegante, com um ponto fraco famoso: se algum firewall no meio do caminho bloqueia todo o ICMP, a mensagem nunca chega, a origem continua mandando pacotes grandes demais, e eles somem sem explicação. O sintoma é inconfundível depois que se conhece: a conexão abre, as mensagens pequenas passam, e a transferência trava assim que aparece o primeiro pacote grande. Voltaremos a ele nos erros comuns.
ICMP: o protocolo das mensagens de erro
O ICMP (Internet Control Message Protocol) é o canal de avisos do IP. Quando um roteador descarta um pacote porque o TTL acabou, porque o destino é inalcançável ou porque o pacote é grande demais, ele avisa a origem com uma mensagem ICMP. Duas ferramentas que todo mundo usa são feitas de ICMP: o ping, que envia um pedido de eco e espera a resposta, e o traceroute, que explora o TTL de propósito, como veremos adiante.
Bloquear todo o ICMP "por segurança" é um erro comum. Algumas mensagens, como a de "fragmentação necessária", são indispensáveis para a rede funcionar. O que faz sentido é filtrar com critério, e não apagar o canal de erros inteiro.
O caminho de um pacote: o roteamento
Entre o seu computador e um servidor do outro lado do país há, tipicamente, de dez a vinte roteadores. Nenhum deles conhece o caminho inteiro. Cada um sabe apenas para qual vizinho mandar o pacote para que ele chegue mais perto do destino, e esse é todo o segredo do roteamento: decisões locais, salto a salto.
Cada roteador tem uma tabela de rotas, uma lista de prefixos de rede com o próximo salto de cada um. Para decidir, ele procura a rota mais específica que contém o destino, a regra do prefixo mais longo. Se a tabela tem uma rota para 10.0.0.0/8 e outra para 10.20.0.0/16, um pacote para 10.20.5.7 segue a segunda, porque ela descreve o destino com mais precisão. Quase toda tabela termina com a rota padrão, 0.0.0.0/0, que vale para qualquer destino sem rota melhor: é o "não sei, manda para cima".
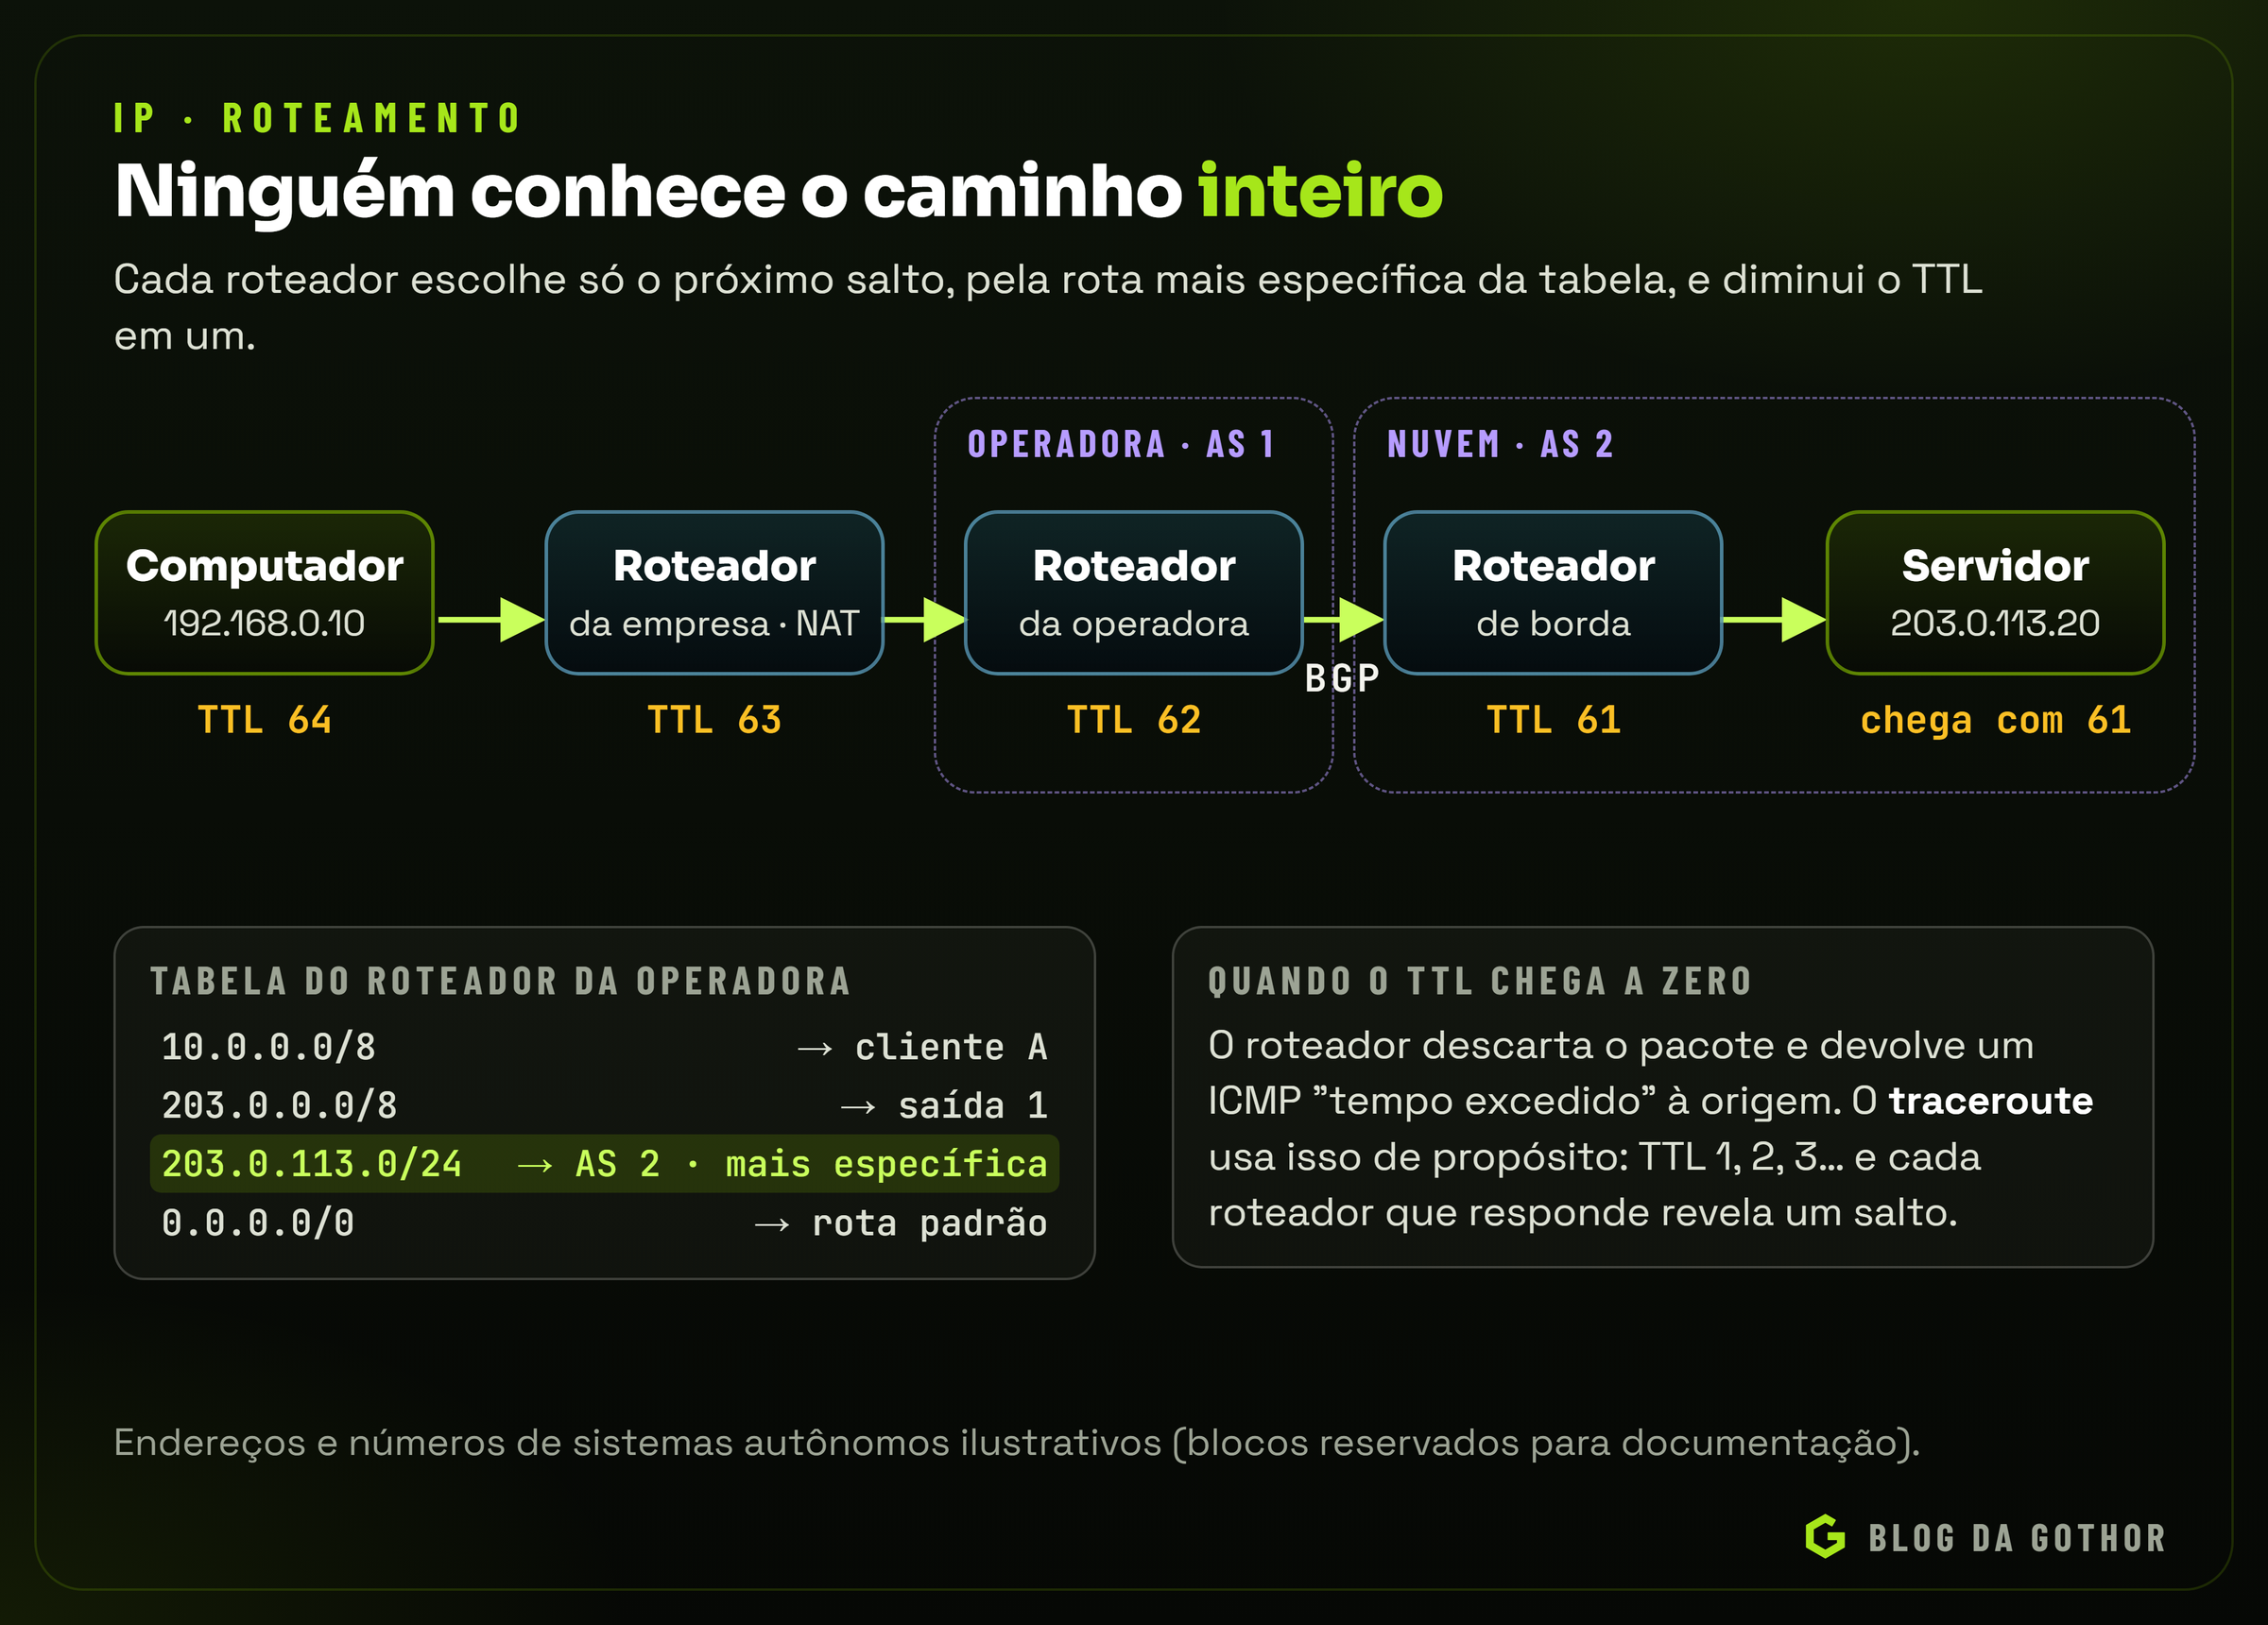
As tabelas não são escritas à mão, salvo em redes pequenas. Dentro de uma organização, protocolos como o OSPF fazem os roteadores trocarem informações e calcularem os melhores caminhos sozinhos. Entre organizações, a internet é dividida em sistemas autônomos, redes sob uma mesma administração, como uma operadora, um provedor de nuvem ou uma grande empresa, cada um com um número próprio. Os sistemas autônomos anunciam uns aos outros quais prefixos alcançam usando o BGP (Border Gateway Protocol). Quando um sistema autônomo anuncia por engano um prefixo que não é seu, o tráfego de outras empresas pode ser desviado para lá em minutos, a origem de alguns dos maiores incidentes da internet.
O traceroute: o TTL usado de propósito
O traceroute (no Windows, tracert) é uma aplicação engenhosa do TTL. Ele envia um primeiro pacote com TTL 1: o primeiro roteador o descarta e responde com um ICMP "tempo excedido", revelando o próprio endereço. Depois, um pacote com TTL 2, que morre no segundo roteador, e assim por diante, até chegar ao destino. Cada linha da saída é um salto, com o tempo de ida e volta até ele.
Duas leituras evitam conclusões erradas: asteriscos numa linha só querem dizer que aquele roteador não responde ao traceroute, e um tempo alto num salto do meio, seguido de tempos normais, só indica que ele demora para responder, não para encaminhar. O que importa é o ponto a partir do qual tudo piora.
O IPv6
O IPv4 se esgotou. Os registros regionais de endereços distribuíram os últimos blocos livres na década de 2010, e desde então endereços IPv4 são revendidos, compartilhados por NAT e economizados de todas as formas possíveis. O IPv6 é a resposta de longo prazo, e já carrega uma parte grande do tráfego da internet, principalmente nas redes móveis.
O que muda:
- Endereços de 128 bits. São 2 elevado a 128 combinações, cerca de 340 undecilhões, um número tão grande que uma rede local comum recebe um bloco
/64, com mais endereços do que a internet IPv4 inteira. Os endereços são escritos em oito grupos hexadecimais separados por dois-pontos, como2001:db8:0:0:0:0:0:1, que pode ser abreviado como2001:db8::1. - Configuração automática. Um computador pode montar o próprio endereço a partir do prefixo anunciado pelo roteador, sem servidor DHCP. O mecanismo se chama SLAAC.
- Descoberta de vizinhos no lugar do ARP, feita com mensagens ICMPv6. Por isso, bloquear o ICMPv6 quebra uma rede IPv6 de forma ainda mais grave do que bloquear o ICMP quebra uma rede IPv4.
- Sem fragmentação no caminho. Só a origem pode fragmentar; os roteadores descartam o pacote grande demais e avisam por ICMPv6. A descoberta do MTU do caminho deixa de ser opcional.
Um mito comum diz que o IPv6 "tem criptografia nativa". A história é outra: as primeiras especificações exigiam que toda implementação de IPv6 suportasse o IPsec, mas suportar não é usar, e a exigência foi rebaixada a recomendação em 2011. Na prática, o tráfego IPv6 é cifrado exatamente como o IPv4: pelo TLS, na aplicação, ou por uma VPN.
A maioria das redes funciona em pilha dupla, com um endereço IPv4 e um IPv6 em cada computador. Navegadores e sistemas usam o Happy Eyeballs: tentam o IPv6 e, se ele demorar alguns milissegundos, tentam o IPv4 em paralelo e ficam com o primeiro que responder. Isso esconde muitos problemas de IPv6, mas não todos: um serviço que não responde pelo IPv6 pode continuar funcionando para quem usa o navegador e falhar para programas que não fazem essa tentativa paralela, como veremos nos erros comuns.
Portas, sockets e a tradução de endereços
O IP leva um pacote até um computador. Mas um computador roda dezenas de programas ao mesmo tempo, e o pacote precisa chegar ao programa certo. Quem resolve isso são as portas, números de 16 bits, de 0 a 65.535, que fazem parte dos cabeçalhos do TCP e do UDP.
Os servidores escutam em portas conhecidas: 80 para o HTTP, 443 para o HTTPS, 53 para o DNS, 25 para o SMTP entre servidores de e-mail, 22 para o SSH, 5432 para o PostgreSQL, 1521 para o Oracle. A IANA, que administra esses números, divide a faixa em três partes: as portas conhecidas, de 0 a 1023; as registradas, de 1024 a 49.151, que aplicações podem reservar; e as dinâmicas ou efêmeras, de 49.152 a 65.535, que o sistema operacional sorteia para o lado do cliente de cada conexão.
Uma conexão TCP é identificada por cinco informações: o protocolo, o endereço e a porta de origem, e o endereço e a porta de destino. É por isso que um servidor web atende milhares de clientes na mesma porta 443 ao mesmo tempo: cada cliente usa um endereço ou uma porta de origem diferente, e cada combinação é uma conexão separada. Do lado do programa, cada uma dessas pontas é um socket, a interface criada no BSD em 1983.
Um detalhe que causa muita confusão: um servidor pode escutar num endereço específico ou em todos. Escutar em 127.0.0.1 quer dizer aceitar conexões apenas do próprio computador. Escutar em 0.0.0.0 quer dizer aceitar em todas as interfaces IPv4, e :: faz o mesmo no IPv6. Um serviço que "funciona no servidor e não funciona de fora" muitas vezes está, simplesmente, escutando só no loopback.
NAT: muitos computadores atrás de um endereço
A rede da sua empresa usa endereços privados, que não circulam na internet. Mesmo assim, todos os computadores navegam. Quem faz essa mágica é o NAT (Network Address Translation), quase sempre na variante que também traduz portas.
Quando um computador interno abre uma conexão para fora, o roteador troca o endereço de origem privado pelo endereço público dele e, se preciso, troca também a porta de origem. Ele anota a troca numa tabela. Quando a resposta chega, o roteador consulta a tabela, desfaz a troca e entrega o pacote ao computador certo. Para o servidor do outro lado, todos os computadores da empresa parecem um só.
O NAT tem consequências que vale conhecer:
- Conexões de fora para dentro não funcionam sozinhas. O roteador só sabe para onde mandar uma resposta se a conversa começou de dentro. Para expor um serviço interno, é preciso configurar um redirecionamento de porta.
- As entradas da tabela expiram. Uma conexão parada por muito tempo pode ser esquecida pelo NAT ou por um firewall no caminho, e o próximo pacote não chega a lugar nenhum. É a origem clássica das conexões que "caem sozinhas" depois de alguns minutos ociosas.
- O endereço de origem muda. Quem recebe a conexão vê o endereço do NAT, não o do computador original. Isso afeta registros de acesso, listas de bloqueio e qualquer controle baseado em endereço.
- NAT não é firewall. É comum ouvir que o NAT "protege" a rede, porque esconde os endereços internos. O efeito de bloquear conexões de fora é um subproduto, não uma política de segurança. Quem decide o que entra e o que sai é o firewall, e as duas coisas precisam ser pensadas separadamente.
Com o esgotamento do IPv4, as operadoras passaram a usar o CGNAT, um NAT dentro da própria operadora: vários clientes compartilham um mesmo endereço público, e o roteador da casa ou da empresa recebe um endereço da faixa 100.64.0.0/10. Atrás de um CGNAT, nem o redirecionamento de porta funciona; as saídas são um endereço público fixo, o IPv6 ou um túnel aberto de dentro para fora.
O UDP: o mínimo necessário
O UDP (User Datagram Protocol), definido na RFC 768 em 1980, é o protocolo de transporte mais simples possível. O cabeçalho tem só 8 bytes: a porta de origem, a porta de destino, o tamanho e uma soma de verificação. Não há conexão, não há confirmação, não há reenvio, não há ordem, não há controle de fluxo. O UDP pega uma mensagem, coloca num pacote IP e manda.
Parece pouco, mas é exatamente o que muitas aplicações querem:
- DNS: uma pergunta e uma resposta, cada uma num pacote. Abrir uma conexão TCP para isso custaria mais do que a própria consulta. Se a resposta não vier, o cliente pergunta de novo.
- Voz, vídeo ao vivo e jogos: um pedaço de áudio que chega atrasado não serve para mais nada. É melhor perder um pacote e seguir em frente do que parar a conversa esperando um reenvio.
- VPNs modernas, como o WireGuard: o túnel leva pacotes IP inteiros, e as conexões TCP de dentro do túnel já cuidam da própria confiabilidade. Fazer o túnel também confiável duplicaria o trabalho e criaria efeitos ruins de retransmissão em cima de retransmissão.
- QUIC e HTTP/3: protocolos que preferem implementar a própria confiabilidade, do jeito deles, por cima do UDP.
Quem usa UDP assume a responsabilidade pelo que o protocolo não faz. Se a aplicação precisa de ordem, ela numera as mensagens. Se precisa de entrega, ela confirma e reenvia. E, principalmente, se envia muito, ela precisa se controlar, porque o UDP não tem nenhum freio contra congestionamento.
O TCP por dentro
O TCP oferece aos programas algo bem diferente do que o IP entrega: um fluxo de bytes confiável, ordenado e com controle de fluxo, entre duas pontas. O programa escreve bytes de um lado e lê os mesmos bytes, na mesma ordem, do outro, sem saber que eles foram cortados em segmentos, que alguns se perderam e foram reenviados, ou que chegaram fora de ordem e foram reorganizados.
Uma consequência pega muita gente: o TCP não preserva mensagens. Se um programa escreve "pedido 1" e depois "pedido 2", o outro lado pode ler "pedido 1pedido 2" de uma vez, ou "ped" numa leitura e o resto na seguinte. Cada protocolo de aplicação precisa dizer onde uma mensagem termina: o HTTP usa cabeçalhos e o tamanho do corpo; outros, um separador ou um prefixo com o tamanho.
O cabeçalho do TCP
O cabeçalho do TCP tem 20 bytes, mais opções. Os campos principais:
- Porta de origem e porta de destino.
- Número de sequência: a posição, no fluxo de bytes, do primeiro byte de dados do segmento.
- Número de confirmação (ACK): o próximo byte que o receptor espera. Confirmar o byte 5001 quer dizer "recebi tudo até o 5000".
- Flags: SYN abre a conexão, ACK indica que o número de confirmação vale, FIN encerra o envio, RST derruba a conexão na hora, PSH pede para entregar logo à aplicação; ECE e CWR participam do aviso de congestionamento.
- Janela: quantos bytes o receptor ainda aceita, a base do controle de fluxo.
- Soma de verificação, que cobre o cabeçalho e os dados.
- Opções: o MSS, a escala da janela, os carimbos de tempo e as confirmações seletivas, todas negociadas na abertura da conexão.
A abertura: o aperto de mão em três tempos
Antes de trocar dados, os dois lados combinam a conversa. O processo é o famoso three-way handshake:
- O cliente envia um segmento com a flag SYN e um número de sequência inicial escolhido por ele.
- O servidor responde com SYN e ACK: confirma o número do cliente e informa o seu próprio número inicial.
- O cliente confirma o número do servidor com um ACK. A partir daí, a conexão está estabelecida e os dados podem fluir.
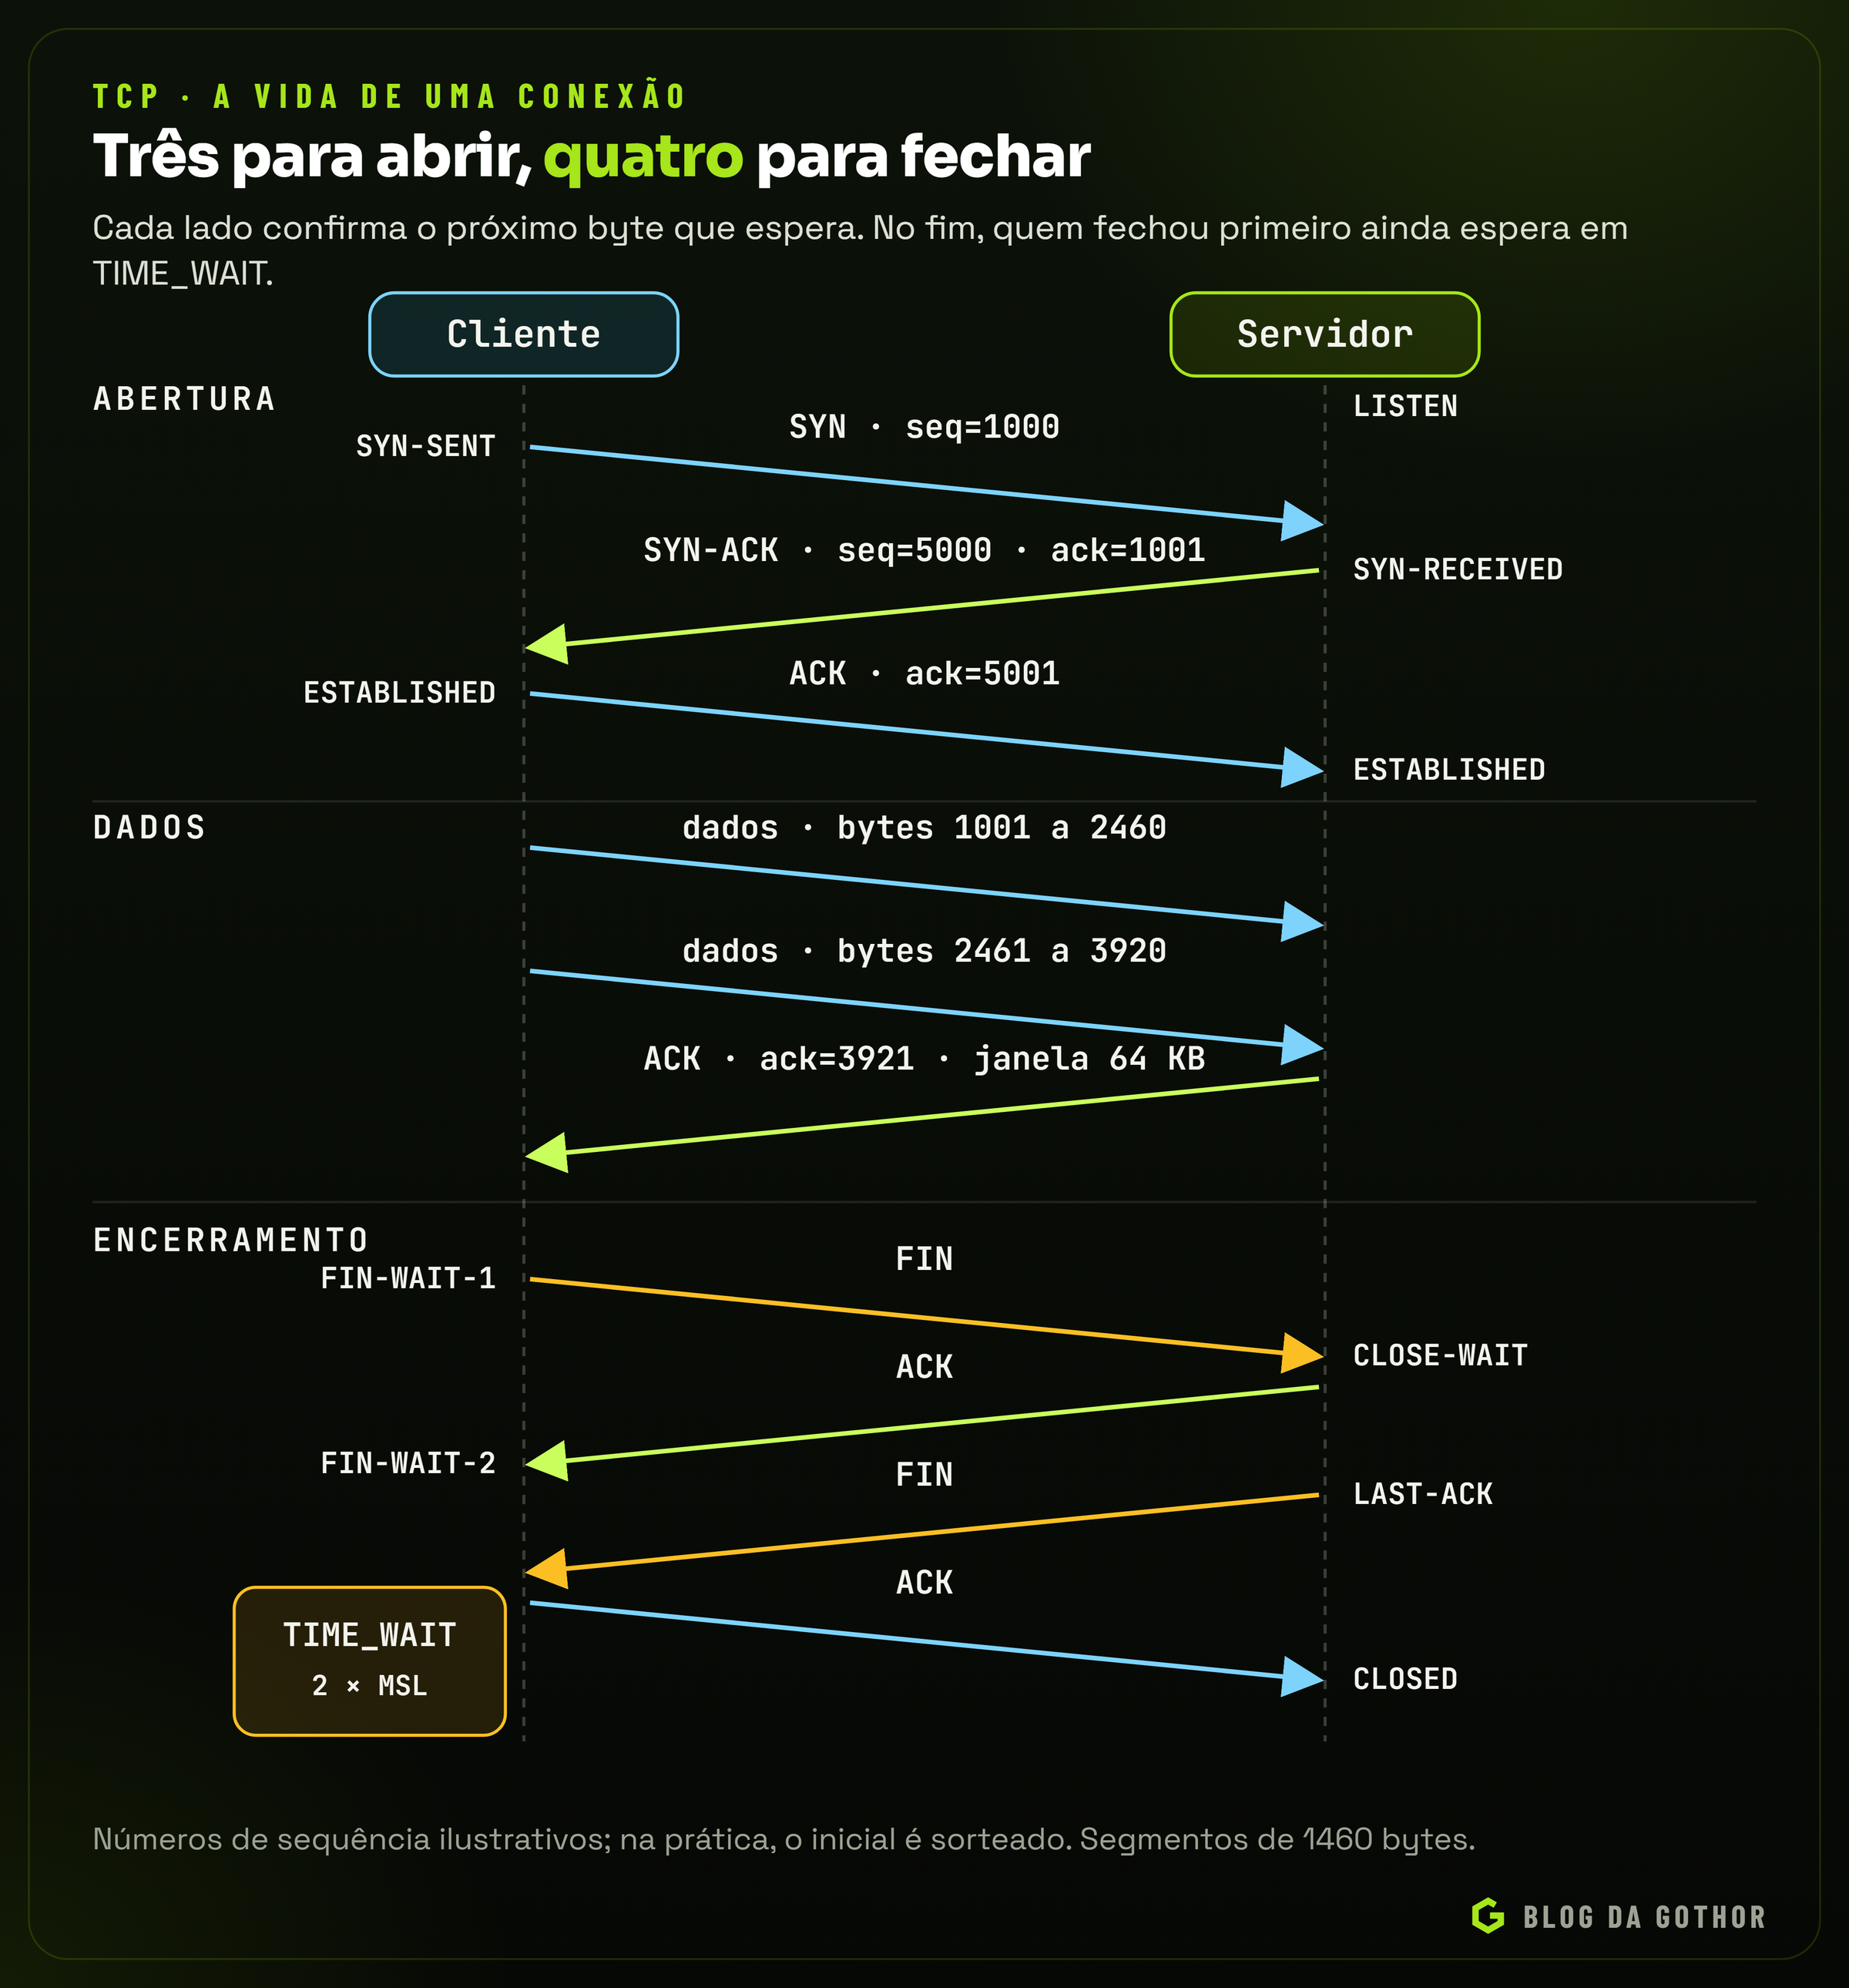
Os números de sequência iniciais não começam em zero: se fossem previsíveis, alguém de fora poderia forjar segmentos de uma conexão alheia. Desde a RFC 6528, eles são calculados de forma pseudoaleatória.
Nessa troca, os dois lados também negociam as opções: o MSS que cada um aceita, se vão usar a escala da janela, os carimbos de tempo e as confirmações seletivas. O handshake custa uma viagem de ida e volta antes do primeiro byte de dados, e é por isso que conexões novas são caras em redes com latência alta. Uma conexão do Brasil com um servidor nos Estados Unidos leva perto de 150 milissegundos por ida e volta; abrir a conexão TCP e depois negociar o TLS consome algumas dessas viagens antes de qualquer resposta. Reaproveitar conexões abertas, o que o HTTP faz com o keep-alive e os pools de conexão, economiza esse tempo em cada requisição.
As filas do servidor e a inundação de SYN
Do lado do servidor, o handshake passa por duas filas, e conhecê-las explica um tipo de lentidão que não aparece em nenhum registro da aplicação. Quando um SYN chega, o sistema operacional guarda a conexão meio aberta numa primeira fila e responde com o SYN-ACK. Quando o ACK final chega, a conexão está estabelecida e passa para uma segunda fila, a das conexões prontas para serem aceitas, onde espera até a aplicação chamar accept(). No Linux, o número que o programa passa à chamada listen(), o backlog, define o tamanho dessa segunda fila, limitado pelo valor de net.core.somaxconn, que passou de 128 para 4.096 por padrão no Linux 5.4. A primeira fila tem o seu próprio limite, o tcp_max_syn_backlog.
Se a aplicação demora a aceitar conexões, porque está sobrecarregada ou travada, a fila de prontas enche. A partir daí, novas conexões podem receber uma recusa ou ter o pacote simplesmente ignorado, para que uma nova tentativa do cliente funcione depois. No segundo caso, quem está do lado de fora vê uma conexão que leva um segundo ou mais para abrir, o tempo de o cliente reenviar o SYN, sem nenhum erro registrado na aplicação. Quando as conexões a um servidor ficam lentas para abrir mas rápidas depois de abertas, a fila de aceitação é uma suspeita natural.
A primeira fila é o alvo de um ataque clássico, a inundação de SYN, descrita na RFC 4987, de 2007. O atacante envia uma rajada de SYNs com endereços de origem falsos; o servidor guarda cada conexão meio aberta e responde a endereços que nunca vão confirmar, até a fila encher e não sobrar espaço para os clientes legítimos. A defesa mais conhecida são os SYN cookies: em vez de guardar estado, o servidor codifica as informações da conexão no próprio número de sequência do SYN-ACK. Se o ACK final chegar com o número certo, o servidor reconstrói a conexão a partir dele; se não chegar, nada foi gasto.
O truque tem um custo, porque cabe pouca informação num número de sequência. O MSS fica restrito a alguns valores predefinidos, e outras opções negociadas no SYN, como a escala da janela, podem se perder, o que a própria RFC aponta como o preço mais alto, por limitar o desempenho em caminhos rápidos. Por isso o Linux usa os cookies só como reserva: com o padrão tcp_syncookies = 1, eles entram em ação apenas quando a fila de conexões meio abertas transborda, e a documentação do kernel avisa que não devem ser usados para atender um volume legítimo alto de conexões.
TCP Fast Open: dados já no SYN
O handshake custa uma ida e volta inteira antes do primeiro byte de dados, e em conexões curtas, repetidas para o mesmo servidor, esse custo domina. O TCP Fast Open, publicado em dezembro de 2014 como experimental na RFC 7413, propõe pular essa espera nas conexões seguintes. Na primeira conexão, o cliente pede ao servidor um cookie, uma etiqueta ligada ao endereço IP do cliente, e o guarda. Nas próximas, envia o SYN já com o cookie e os primeiros dados, e o servidor, se o cookie for válido, entrega esses dados à aplicação antes mesmo de o handshake terminar. A economia é de até uma ida e volta.
Há dois poréns. O primeiro é que os dados do SYN podem, em situações raras, chegar duas vezes à aplicação, por isso a RFC recomenda usá-lo só quando a repetição é inofensiva, como numa requisição de leitura, e nunca, por exemplo, num POST sem proteção contra duplicidade. O segundo é que alguns equipamentos no caminho descartam pacotes com opções desconhecidas ou SYNs com dados, e o cliente precisa voltar ao handshake comum. No Linux, o recurso vem ligado só para o lado do cliente por padrão; o lado do servidor depende de configuração. Na prática, a mesma ideia ganhou mais espaço com o TLS 1.3 e o QUIC, que levam os dados no primeiro pacote ao retomar uma sessão.
Números de sequência, confirmações e reenvios
Depois da abertura, cada byte enviado tem um número. O receptor confirma sempre o próximo byte que espera, e essa confirmação é cumulativa: "estou esperando o byte 8001" quer dizer que tudo até o 8000 chegou. O remetente não espera a confirmação de cada segmento para enviar o próximo; ele mantém vários segmentos "em voo" ao mesmo tempo, até o limite da janela, e é isso que permite usar bem um caminho com muita capacidade.
Quando um segmento se perde, o TCP percebe de duas formas:
- Tempo esgotado. Para cada envio, o remetente liga um cronômetro, o RTO (retransmission timeout), calculado a partir do tempo de ida e volta medido ao longo da conexão, com uma margem para a variação. Se a confirmação não chega a tempo, o segmento é reenviado e o próximo prazo dobra. Pela RFC 6298, o RTO inicial é de um segundo e o mínimo recomendado também é de um segundo, embora muitos sistemas usem valores menores.
- Confirmações duplicadas. Se o segmento 3 se perdeu mas o 4, o 5 e o 6 chegaram, o receptor responde a cada um deles repetindo "ainda espero o 3". Três confirmações duplicadas são um sinal forte de perda, e o remetente reenvia o segmento na hora, sem esperar o cronômetro. É a retransmissão rápida.
A confirmação cumulativa tem uma limitação: ela diz o que falta, mas não diz o que chegou depois do buraco. Com as confirmações seletivas (SACK, RFC 2018), o receptor informa também os blocos que já recebeu fora de ordem, e o remetente reenvia só o que realmente faltou. Praticamente todos os sistemas atuais usam SACK.
Controle de fluxo: a janela do receptor
O receptor guarda os dados num espaço de memória, o buffer, até a aplicação ler. Se o remetente mandasse mais rápido do que a aplicação consegue ler, o buffer transbordaria. Para evitar isso, cada confirmação traz o campo janela: quantos bytes ainda cabem no buffer do receptor. O remetente nunca mantém em voo mais do que essa janela. Se a aplicação do outro lado para de ler, a janela vai a zero e o remetente para de enviar, testando de tempos em tempos se ela abriu.
O campo da janela tem 16 bits, o que a limitaria a 64 KB, pouco num caminho rápido e longo. A conta que manda é o produto banda-atraso: para usar um link de 100 Mbit/s com 50 milissegundos de ida e volta, é preciso manter cerca de 625 KB em voo. Com 64 KB, a conexão ficaria limitada a pouco mais de 10 Mbit/s, por mais rápido que fosse o link. A solução é a opção de escala da janela (RFC 7323), negociada na abertura, que multiplica o valor por uma potência de dois e permite janelas de até 1 GB. Os sistemas atuais ajustam o tamanho do buffer sozinhos, conforme a conexão.
O encerramento e o TIME_WAIT
Uma conexão TCP tem dois sentidos, e cada um é fechado separadamente. Quem termina de enviar manda um FIN; o outro lado confirma com um ACK e pode continuar enviando o que tiver. Quando ele também termina, manda o seu FIN, que é confirmado. São quatro segmentos, às vezes três, quando um FIN vai junto com uma confirmação.
O lado que fechou primeiro não esquece a conexão na hora. Ele fica no estado TIME_WAIT por duas vezes o tempo máximo de vida de um segmento, de um a quatro minutos: 60 segundos no Linux, até 240 no Windows, conforme a configuração. A espera tem dois motivos: garantir que a última confirmação chegou (se ela se perder, o outro lado reenvia o FIN e precisa de resposta) e impedir que segmentos atrasados de uma conexão antiga sejam confundidos com os de uma conexão nova com os mesmos endereços e portas.
O TIME_WAIT é normal e saudável, mas aparece em incidentes. Um programa que abre e fecha milhares de conexões curtas para o mesmo servidor, em vez de reaproveitá-las, pode acumular tantas em TIME_WAIT que esgota as portas efêmeras: novas conexões passam a falhar com erros de "endereço em uso" ou de tempo esgotado. A correção quase nunca é mexer no TIME_WAIT, e sim reaproveitar conexões.
Existe também o encerramento abrupto, o RST, enviado quando chega um segmento para uma porta sem ninguém escutando, quando a aplicação fecha com dados não lidos ou quando um firewall derruba a conversa. Do lado da aplicação, o RST aparece como "conexão recusada", se veio em resposta ao SYN, ou como "conexão redefinida pelo par" (connection reset by peer), se veio no meio da conversa.
Os estados de uma conexão
O TCP descreve a vida de uma conexão como uma máquina de estados, e ferramentas como o ss e o netstat mostram esses estados. Os que aparecem no dia a dia:
| Estado | O que quer dizer |
|---|---|
LISTEN | um servidor esperando conexões numa porta |
SYN-SENT | o cliente mandou o SYN e espera a resposta |
SYN-RECEIVED | o servidor respondeu ao SYN e espera a confirmação |
ESTABLISHED | conexão aberta, dados fluindo |
FIN-WAIT-1 e FIN-WAIT-2 | este lado mandou o FIN e espera o encerramento do outro |
CLOSE-WAIT | o outro lado fechou; falta a aplicação daqui fechar |
TIME-WAIT | o encerramento terminou; esperando segmentos atrasados |
Dois padrões merecem atenção: muitas conexões em SYN-SENT indicam um destino que não responde ou um firewall descartando pacotes; muitas em CLOSE-WAIT quase sempre indicam um erro de programação, um socket que a aplicação nunca fechou.
Nagle, confirmações atrasadas e as conexões ociosas
Dois mecanismos antigos, criados para economizar a rede, ainda causam lentidões misteriosas. O algoritmo de Nagle segura pedaços pequenos enquanto houver dados sem confirmação em voo, para juntá-los num segmento só; as confirmações atrasadas fazem o receptor esperar um pouco antes de confirmar, para aproveitar uma resposta. Separados, os dois são razoáveis. Juntos, numa aplicação que envia uma requisição em duas escritas pequenas, um espera o outro, e cada requisição ganha de dezenas a centenas de milissegundos de atraso. Aplicações interativas costumam desligar o Nagle com a opção TCP_NODELAY, e muitas bibliotecas de HTTP e de bancos de dados já fazem isso por padrão.
Por fim, as conexões ociosas. O TCP não manda nada quando ninguém tem o que dizer, e uma conexão pode ficar aberta por horas sem tráfego. O problema é que NATs, firewalls e balanceadores no caminho esquecem conexões paradas depois de um tempo, que vai de alguns minutos a algumas horas. Para manter a conexão viva, existem os keepalives: pacotes pequenos enviados periodicamente. O keepalive do próprio TCP vem desligado ou com intervalos de horas por padrão, e por isso muitos protocolos de aplicação, como os bancos de dados e os WebSockets, implementam o seu próprio, com intervalos de segundos ou minutos.
Controle de congestionamento: dividir a estrada
A janela do receptor protege o receptor. Mas e a rede no meio? Se todos os computadores mandassem dados tão rápido quanto os receptores aceitam, os roteadores do caminho, com filas finitas, começariam a descartar pacotes, os remetentes reenviariam, e a rede ficaria cheia de reenvios em vez de dados novos.
Isso não é hipótese. Em outubro de 1986, a internet viveu o primeiro de uma série de colapsos por congestionamento: entre o Laboratório Lawrence Berkeley e a Universidade da Califórnia em Berkeley, a cerca de 400 metros um do outro, a vazão caiu de 32 kbit/s para 40 bit/s, quase mil vezes menos. Van Jacobson analisou o problema e, em 1988, propôs os mecanismos que até hoje formam a base do controle de congestionamento do TCP.
A ideia central é uma segunda janela, a janela de congestionamento (cwnd), que o remetente calcula sozinho a partir do que observa. Em cada momento, ele mantém em voo o menor dos dois valores: a janela do receptor ou a de congestionamento. A rede não avisa explicitamente que está cheia; o sinal clássico é a perda de pacotes.
O algoritmo tradicional, descrito na RFC 5681, tem quatro peças:
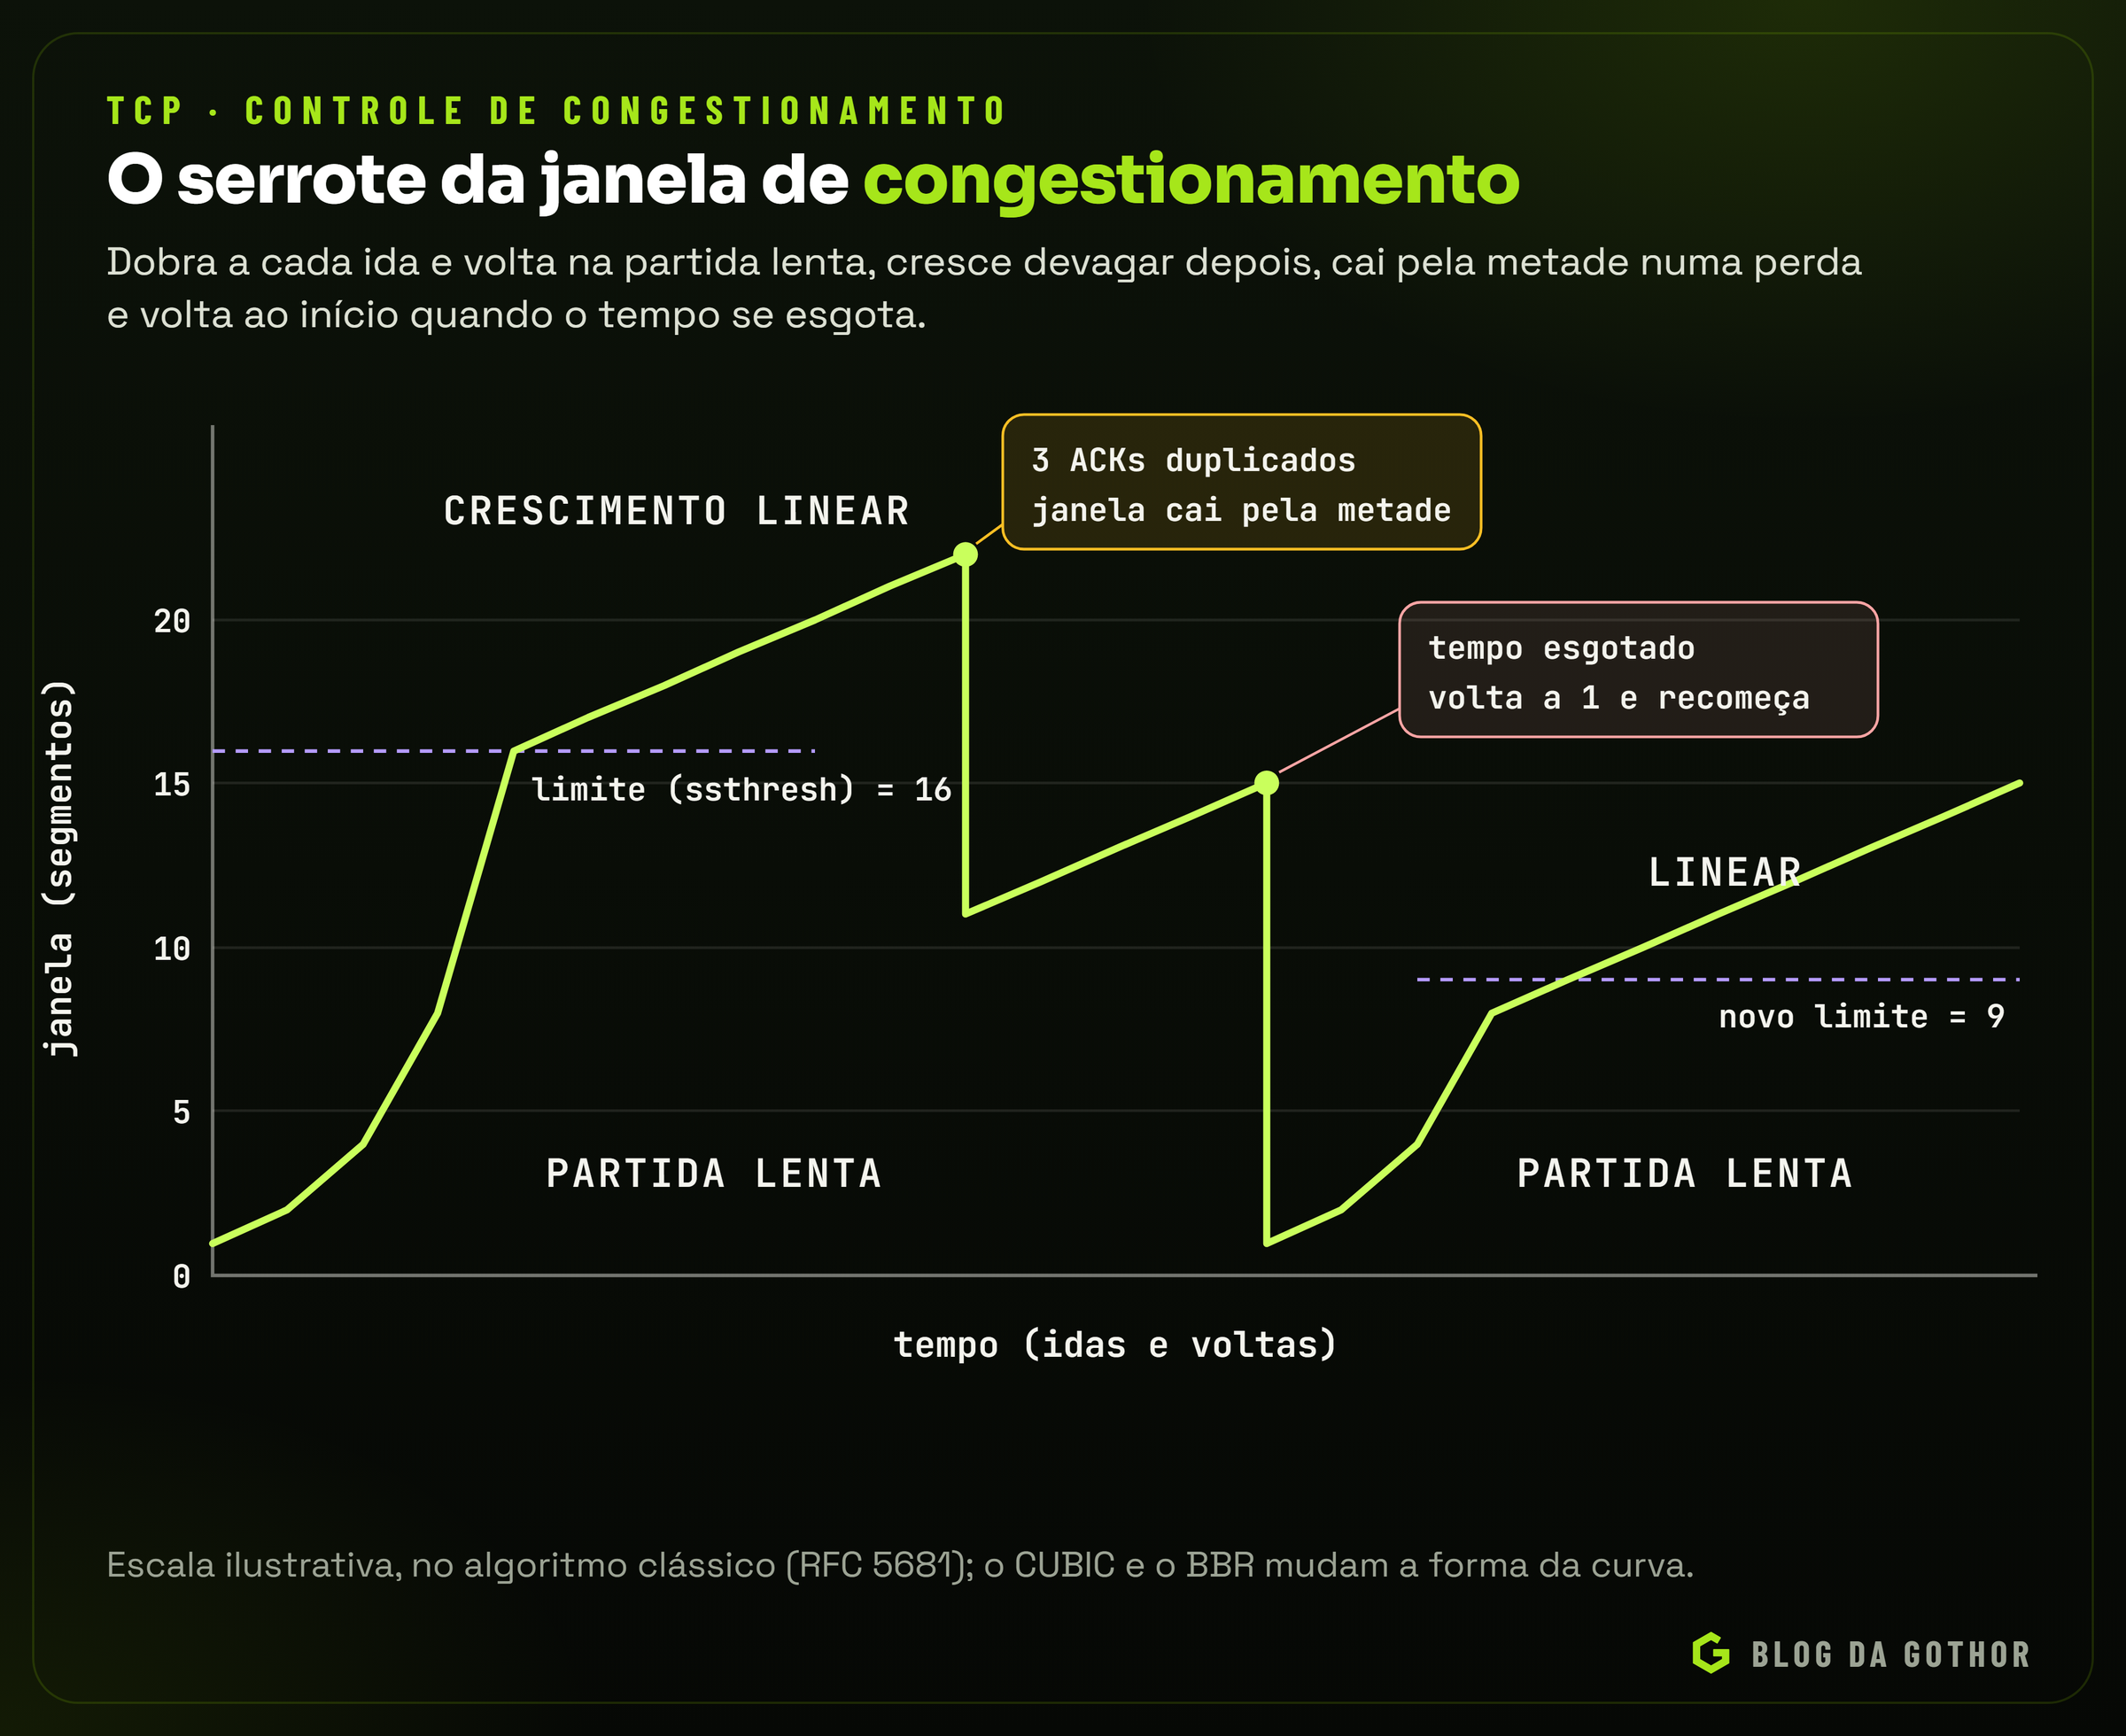
- Partida lenta (slow start). Uma conexão nova não sabe quanta capacidade o caminho tem. Ela começa com uma janela pequena, hoje de cerca de dez segmentos, e a aumenta a cada confirmação, o que, na prática, dobra a janela a cada ida e volta. O nome engana: o crescimento é exponencial. Ele continua até ocorrer uma perda ou até a janela atingir um limite, o ssthresh.
- Prevenção de congestionamento. Passado o limite, o crescimento fica linear: cerca de um segmento a mais por ida e volta. É a fase de sondagem cuidadosa.
- Reação à perda. Uma perda percebida por três confirmações duplicadas indica congestionamento moderado: a janela cai pela metade e a conexão segue. Uma perda percebida por tempo esgotado indica algo pior, e a janela volta ao mínimo, recomeçando a partida lenta.
Esse padrão, de crescer devagar e cortar pela metade, se chama AIMD (aumento aditivo, diminuição multiplicativa), e faz várias conexões no mesmo gargalo convergirem para uma divisão justa. No gráfico, forma um serrote característico.
CUBIC, BBR e o sinal de congestionamento
O AIMD clássico tem dificuldade em redes muito rápidas e longas: crescer um segmento por ida e volta, depois de cortar uma janela enorme pela metade, pode levar minutos. Por isso, os sistemas atuais usam variações:
- CUBIC. O algoritmo padrão do Linux desde 2006 e, hoje, também do Windows e do macOS. Em vez de crescer linearmente, a janela segue uma curva cúbica em função do tempo desde a última perda: volta rápido para perto do valor anterior, avança com cuidado naquela região e acelera se não encontrar problema. Foi publicado como padrão da IETF na RFC 9438, em 2023.
- BBR. Criado pelo Google, abandona a perda como sinal principal. Ele mede continuamente a maior vazão entregue e o menor tempo de ida e volta, monta um modelo do gargalo e envia nesse ritmo. Funciona bem em caminhos com perdas aleatórias, como redes sem fio, e é usado em grande escala por serviços como o YouTube.
- ECN (Explicit Congestion Notification, RFC 3168). Em vez de descartar pacotes, um roteador congestionado pode marcar os pacotes, e o receptor repassa a marca ao remetente, que reduz o ritmo como se tivesse havido uma perda, mas sem perder nada. O suporte cresceu muito nos últimos anos.
Filas grandes demais e redes sem fio
Dois problemas modernos mostram os limites do modelo baseado em perdas. O primeiro é o bufferbloat: equipamentos com filas enormes, criadas para "nunca perder pacotes", fazem o TCP encher essas filas antes de perceber qualquer perda. A vazão não melhora, mas a latência sobe muito, e é por isso que uma chamada de vídeo trava quando alguém da mesma rede começa um download grande. Gerenciadores de fila como o CoDel e o FQ-CoDel, presentes em roteadores modernos, atacam o problema descartando ou marcando pacotes antes que a fila cresça demais.
O segundo são as redes sem fio. Num cabo, quase toda perda vem de congestionamento. No Wi-Fi e no celular, pacotes se perdem por interferência, distância e mudança de antena, e o TCP clássico interpreta isso como congestionamento, reduzindo a velocidade sem necessidade. As próprias camadas de rádio reenviam boa parte dos quadros perdidos para esconder o problema do TCP, e algoritmos como o BBR sofrem menos com ele.
Os padrões que o sistema operacional escolhe
O TCP descrito nas RFCs deixa muitas escolhas para cada implementação, e os valores padrão do sistema operacional explicam comportamentos que parecem aleatórios. No Linux, eles ficam em /proc/sys/net, lidos e alterados com o sysctl, e a documentação do kernel descreve cada um. Alguns que aparecem com frequência em diagnósticos:
| Ajuste no Linux | Padrão | O que controla |
|---|---|---|
net.ipv4.ip_local_port_range | 32768 a 60999 | as portas efêmeras usadas pelo lado do cliente |
net.ipv4.tcp_keepalive_time | 2 horas | quanto tempo parada a conexão espera até o primeiro keepalive |
net.ipv4.tcp_keepalive_intvl e tcp_keepalive_probes | 75 segundos e 9 | o intervalo entre as sondas e quantas sem resposta derrubam a conexão |
net.ipv4.tcp_fin_timeout | 60 segundos | quanto tempo uma conexão órfã fica em FIN-WAIT-2 |
net.ipv4.tcp_tw_reuse | 2 | reaproveitar portas em TIME-WAIT para conexões novas, só no loopback |
net.ipv4.tcp_congestion_control | definido na configuração do kernel, normalmente cubic | o algoritmo de controle de congestionamento |
A primeira linha guarda uma surpresa. A faixa efêmera do Linux, de 32768 a 60999, não coincide com a recomendada pela IANA, de 49152 a 65535, que o Windows adota desde o Vista e o Windows Server 2008 (antes, o Windows usava de 1025 a 5000). Uma regra de firewall que libera "as portas dinâmicas" pela faixa de um sistema pode não cobrir as conexões do outro, e esse tipo de falha só aparece com alguns clientes. E são cerca de 28 mil portas por combinação de endereço e porta de destino, um número que um programa que abre e fecha conexões curtas sem reaproveitá-las esgota mais rápido do que parece.
A segunda e a terceira linhas confirmam o que vimos sobre conexões ociosas: com os padrões, uma conexão parada só manda o primeiro keepalive depois de duas horas, e só é dada como morta depois de mais nove sondas, uma a cada 75 segundos, cerca de onze minutos. Muito acima do tempo em que um firewall ou um NAT esquece uma conexão parada. Por isso a aplicação que depende de conexões longas deve ligar o keepalive no próprio socket com intervalos curtos, ou usar o keepalive do seu protocolo.
A quarta linha desfaz uma confusão frequente: o tcp_fin_timeout não controla o TIME-WAIT; ele limita o FIN-WAIT-2 de conexões que a aplicação já abandonou. E a documentação do kernel pede que o tcp_tw_reuse não seja alterado sem orientação especializada, mais um motivo para tratar o acúmulo de TIME-WAIT reaproveitando conexões, e não mexendo no kernel.
Para ver como o TCP está se comportando numa conexão específica, o ss -ti mostra as informações internas de cada uma: o algoritmo de congestionamento em uso, a escala da janela, o tempo de ida e volta medido e a sua variação, o prazo de reenvio, o MSS, a janela de congestionamento e o limite da partida lenta. É a forma mais direta de conferir, por exemplo, se uma transferência lenta está limitada pela janela do receptor, por perdas que derrubam a janela de congestionamento ou simplesmente por um RTT alto.
Além do TCP: o QUIC
O TCP tem limitações difíceis de corrigir: ele vive dentro do sistema operacional, e a rede está cheia de equipamentos que inspecionam os cabeçalhos dele, o que torna arriscado mudar o formato. É a chamada ossificação.
A resposta mais importante é o QUIC, criado no Google e padronizado pela IETF em 2021, na RFC 9000. Ele roda sobre o UDP, o que o deixa passar pelos equipamentos existentes, e implementa por cima tudo o que o TCP faz e mais:
- Criptografia embutida. O TLS 1.3 faz parte do protocolo, e quase todo o cabeçalho viaja cifrado, o que impede que equipamentos do caminho dependam dele.
- Abertura mais rápida. A conexão e a criptografia são negociadas juntas, numa só ida e volta, e em reconexões a um servidor conhecido os dados podem ir já no primeiro pacote.
- Vários fluxos independentes. No TCP, um segmento perdido trava todo o fluxo até o reenvio, inclusive dados de outras requisições que já tinham chegado; é o bloqueio na cabeça da fila. No QUIC, cada fluxo é independente, e uma perda só atrasa o fluxo afetado.
- Migração de conexão. A conexão é identificada por um número próprio, não pelo endereço e pela porta. Um celular que troca o Wi-Fi pelo 4G mantém a conexão aberta.
O HTTP/3 é o HTTP sobre o QUIC, e já é usado por boa parte dos grandes sites.
Ferramentas para investigar
Quase todo problema de rede pode ser cercado com meia dúzia de ferramentas que já vêm no sistema operacional.
| Pergunta | Linux | Windows |
|---|---|---|
| Qual o meu endereço e o meu gateway? | ip addr e ip route | ipconfig /all |
| O destino responde? | ping | ping |
| Por onde passa o caminho? | traceroute ou mtr | tracert ou pathping |
| A porta está aberta? | nc -vz servidor 443 | Test-NetConnection servidor -Port 443 |
| Quem escuta e quais conexões existem? | ss -tulpn e ss -tan | netstat -ano ou Get-NetTCPConnection |
| O que realmente passa no fio? | tcpdump | Wireshark |
| E a aplicação, o que vê? | curl -v | curl -v |
Algumas dicas de leitura:
- **
ss -tulpn** lista as portas em escuta, com o endereço e o processo. Uma linha127.0.0.1:5432diz que o banco aceita só conexões locais;0.0.0.0:5432, que aceita de qualquer interface IPv4;[::]:443, que escuta no IPv6. - **
Test-NetConnection**, no Windows, testa uma porta TCP e mostra se a conexão abriu, o endereço usado e a interface de saída. - **
curl -v** mostra a resolução do nome, o endereço e a porta da conexão, a negociação do TLS e os cabeçalhos, tudo numa tela. - **
tcpdump -n -i any port 443** mostra os pacotes de verdade. Ver os SYN saindo sem nenhum SYN-ACK voltando, por exemplo, prova que o problema está no caminho ou no destino, e não na aplicação.
Lendo uma captura
Uma captura assusta na primeira vez, mas cada linha segue o mesmo formato, e depois de conhecer os campos ela vira a ferramenta mais honesta do diagnóstico: mostra o que de fato passou pelo fio. Uma conexão HTTPS, encurtada e com endereços de exemplo:
$ sudo tcpdump -n -i any 'tcp port 443 and host 203.0.113.10'
IP 192.168.0.20.51544 > 203.0.113.10.443: Flags [S], seq 3121839411, win 64240, options [mss 1460,sackOK,TS val 1 ecr 0,nop,wscale 7], length 0
IP 203.0.113.10.443 > 192.168.0.20.51544: Flags [S.], seq 2876405120, ack 3121839412, win 65160, options [mss 1460,sackOK,TS val 9 ecr 1,nop,wscale 7], length 0
IP 192.168.0.20.51544 > 203.0.113.10.443: Flags [.], ack 1, win 502, length 0
IP 192.168.0.20.51544 > 203.0.113.10.443: Flags [P.], seq 1:518, ack 1, win 502, length 517
IP 203.0.113.10.443 > 192.168.0.20.51544: Flags [.], ack 518, win 507, length 0
IP 192.168.0.20.51544 > 203.0.113.10.443: Flags [F.], seq 2300, ack 5120, win 501, length 0
Cada linha traz a origem e o destino, com a porta depois do último ponto, as flags, os números de sequência e de confirmação, a janela, as opções e o tamanho dos dados. Nas flags, S é SYN, F é FIN, P é PSH, R é RST e o ponto indica que o ACK está ligado; [S.] é, portanto, o SYN-ACK. As três primeiras linhas são o aperto de mão: o SYN do cliente, a resposta do servidor confirmando o número do cliente mais um e o ACK final. Nas opções do SYN aparece a negociação descrita antes: MSS de 1460, confirmações seletivas (sackOK), carimbos de tempo (TS) e escala da janela (wscale 7).
Dois detalhes evitam leituras erradas. Depois do primeiro pacote de cada sentido, o tcpdump passa a mostrar os números de sequência relativos, contando a partir do inicial, por isso a terceira linha diz ack 1; a opção -S mostra os números absolutos. E o campo win é o valor cru do cabeçalho, sem a escala aplicada: com wscale 7, o win 502 vale 502 vezes 128, cerca de 64 KB. A quarta linha é o primeiro envio de dados, os bytes de 1 a 517 (o ClientHello do TLS), e a quinta é o servidor confirmando que espera o byte 518.
Com essa leitura, os padrões de falha saltam aos olhos. Vários [S] seguidos, sem [S.] de volta, com intervalos que dobram, são o cliente reenviando o SYN para um destino que não responde. Um [S] respondido por [R.] é a porta fechada, a "conexão recusada". Os mesmos seq aparecendo duas vezes são retransmissões, e uma janela que chega a win 0 é o receptor pedindo para parar, porque a aplicação dele não está lendo.
Um diagnóstico passo a passo
Um sistema na loja não consegue falar com uma API. Uma sequência que resolve a maioria dos casos, de baixo para cima:
- O computador tem rede?
ipconfigouip addr: um endereço da faixa da empresa e um gateway. Um endereço169.254.x.xindica que o DHCP falhou. - O nome resolve?
nslookup api.exemplo.com.br. Se não resolve, o problema é de DNS, e nada abaixo adianta. - O destino responde?
ping. Uma resposta prova que o caminho existe; a falta de resposta não prova nada, porque muitos servidores bloqueiam o ping. - A porta abre?
Test-NetConnection api.exemplo.com.br -Port 443ounc -vz. Uma recusa imediata diz que o servidor está alcançável mas ninguém escuta naquela porta; um tempo esgotado sugere um firewall descartando os pacotes no caminho. - Onde o caminho para?
tracertoutraceroute, comparando com outro computador que funciona. - A aplicação conversa?
curl -v https://api.exemplo.com.br/saude. Aqui aparecem os problemas de certificado, de TLS e de resposta do servidor. - Ainda sem resposta? Capturar os pacotes com
tcpdumpou Wireshark dos dois lados, se possível, e ver exatamente qual pacote sai e não chega.
Erros comuns
- Confundir "recusada" com "tempo esgotado". Connection refused quer dizer que um RST voltou: o destino existe e respondeu, mas nada escuta na porta, ou o serviço caiu. Timed out quer dizer que nada voltou: um firewall descartou os pacotes, a rota está errada ou o destino está desligado. São problemas diferentes, investigados em lugares diferentes.
- Serviço escutando só no loopback, ou só no IPv4. O serviço funciona em
localhostdentro do servidor e não responde de fora. Ou funciona por IPv4 e falha para quem chega por IPv6, porque o nome publica um endereço IPv6 que o serviço não atende. - **
localhostque não é o que parece.** Em muitos sistemas,localhostresolve primeiro para::1, o loopback do IPv6. Se o serviço escuta só em127.0.0.1, o cliente tenta o IPv6, falha ou espera, e só então tenta o IPv4. O resultado é uma lentidão inexplicável em cada conexão. Usar127.0.0.1explicitamente, ou fazer o serviço escutar nos dois, resolve. - Bloquear todo o ICMP. Quebra a descoberta do MTU do caminho e cria o "buraco negro": conexões que abrem e travam assim que passa um pacote grande, típico de VPNs e túneis. A correção é liberar as mensagens de "fragmentação necessária" ou ajustar o MSS no túnel.
- Conexões ociosas derrubadas pelo caminho. Um pool de conexões com o banco de dados que, depois de um período parado, entrega à aplicação uma conexão que o firewall já esqueceu. A primeira consulta trava ou falha. Keepalives com intervalo menor que o tempo do firewall, ou validação da conexão antes do uso, resolvem.
- Ler do socket como se fossem mensagens. Esperar que cada leitura traga exatamente uma mensagem funciona nos testes, com mensagens pequenas, e falha em produção, com mensagens grandes ou rede lenta. É preciso delimitar as mensagens no protocolo da aplicação.
Como usamos o TCP/IP na Gothor
A Gothor aplica os conceitos deste artigo de forma conservadora: cada serviço expõe à internet só o que precisa, o IPv4 e o IPv6 recebem o mesmo cuidado, e o diagnóstico de um problema de rede segue o caminho das camadas, do endereço à aplicação, com medições em vez de tentativas.
Resumo
- O TCP/IP é uma família de protocolos em camadas, com o IP no meio, como a cintura de uma ampulheta: tudo embaixo carrega pacotes IP, e tudo em cima os usa.
- O IP entrega pacotes de melhor esforço, salto a salto, sem garantias. Endereços, máscaras, gateway, ARP e ICMP são as peças do dia a dia, e a descoberta do MTU do caminho depende de o ICMP passar.
- O IPv6 resolve o esgotamento de endereços, troca o ARP pela descoberta de vizinhos e convive com o IPv4 em pilha dupla.
- Portas levam os dados ao programa certo; o NAT não é firewall. O UDP entrega mensagens soltas e é a base do DNS, da voz, das VPNs modernas e do QUIC.
- O TCP entrega um fluxo de bytes confiável e ordenado: abre em três tempos, numera e confirma cada byte, reenvia o que se perde, respeita a janela do receptor, fecha em quatro tempos e espera em TIME_WAIT.
- O controle de congestionamento divide a capacidade do caminho entre as conexões, da partida lenta clássica ao CUBIC e ao BBR.
- O QUIC reúne transporte e criptografia sobre o UDP e é a base do HTTP/3.
- Para diagnosticar, suba as camadas: endereço, nome, caminho, porta, aplicação, e capture os pacotes quando restar dúvida.
Para ir além
- RFC 791, a especificação do IPv4, e RFC 8200, a do IPv6.
- RFC 9293, a especificação atual do TCP, e RFC 768, a do UDP.
- RFC 1122, os requisitos para computadores conectados à internet.
- RFC 5681, sobre o controle de congestionamento, RFC 9438, sobre o CUBIC, e RFC 3168, sobre o ECN.
- RFC 6298, sobre o tempo de reenvio, RFC 7323, sobre a escala da janela, e RFC 2018, sobre as confirmações seletivas.
- RFC 1918, os endereços privados, e RFC 6335, as faixas de portas.
- RFC 4987, sobre a inundação de SYN e os SYN cookies, e RFC 7413, o TCP Fast Open.
- Parâmetros de rede do kernel Linux, as páginas de manual do `listen`, do `ss` e do `tcpdump`, e a faixa de portas dinâmicas do Windows.
- RFC 9000, o QUIC, e RFC 8305, o Happy Eyeballs.
- A Protocol for Packet Network Intercommunication, o artigo de Vinton Cerf e Robert Kahn, de 1974.
- Congestion Avoidance and Control, o artigo de Van Jacobson, de 1988.
- A história da família de protocolos da internet, na Wikipedia, e o guia de conceitos de IP do Oracle Solaris.
Este post foi escrito com a ajuda da Juniper, a assistente de IA da Gothor, e revisado pela nossa equipe antes de ir ao ar.