Python por dentro: a linguagem de sintaxe enxuta que domina dados, IA e automação
Como o Python executa o seu código, por que tudo nele é objeto, o que é o GIL, como funcionam asyncio, pacotes, desempenho e segurança, e onde a linguagem brilha. Uma imersão com exemplos, erros comuns e o papel, pequeno e honesto, que o Python tem na Gothor.
Um analista que cruza duas planilhas de vendas em poucas linhas. Um pesquisador que treina um modelo de linguagem. Um técnico que automatiza a renomeação de mil arquivos. Uma startup que sobe a primeira API num fim de semana. É bem provável que os quatro estejam usando a mesma linguagem: Python. Ela aparece há anos no topo dos rankings de popularidade e se tornou a língua franca da ciência de dados e da inteligência artificial.
O motivo mais citado é a sintaxe: código em Python costuma se ler quase como uma descrição em inglês do que ele faz. Mas há muito mais por baixo, e entender o que acontece quando um script roda explica tanto as forças quanto as limitações famosas da linguagem, como a lentidão em laços pesados e o GIL. Este artigo percorre a história, o interpretador, o sistema de importação, o modelo de objetos, texto, números e datas, a concorrência, o desempenho, a depuração, o ecossistema de pacotes, a segurança, os testes e as práticas que evitam os erros mais comuns, com um exemplo completo de automação de escritório no caminho. No fim, contamos com franqueza onde o Python aparece na Gothor.
O que é Python
Python é uma linguagem de programação de alto nível, dinâmica, de tipagem forte e multiparadigma, com uma biblioteca padrão tão extensa que a comunidade a descreve como "com baterias incluídas". Algumas dessas palavras merecem explicação:
- Dinâmica: os tipos são verificados durante a execução. Uma variável é só um nome que aponta para um objeto, e pode apontar para um número agora e para um texto depois.
- Tipagem forte: ao contrário do JavaScript, o Python não converte tipos por conta própria.
'1' + 1não vira'11'nem2: gera um erro de tipo. - Multiparadigma: dá para escrever de forma procedural, orientada a objetos ou funcional, e a maioria dos programas mistura os três.
- Indentação com significado: os blocos são definidos pelo recuo das linhas, e não por chaves. Isso obriga todo código a ter a mesma forma visual.
Também é bom separar a linguagem da implementação. A linguagem é definida pela documentação de referência e pelas PEPs (Python Enhancement Proposals), os documentos em que cada mudança é proposta e discutida. A implementação de referência, usada pela imensa maioria das pessoas, é o CPython, escrito em C. Existem outras, cada uma com um propósito:
| Implementação | Escrita em | Para quê |
|---|---|---|
| CPython | C | a de referência, a que vem do python.org e das distribuições Linux |
| PyPy | RPython, um subconjunto do próprio Python | compilação em tempo de execução (JIT), muito mais rápida em laços de Python puro |
| MicroPython | C | microcontroladores, com poucos kilobytes de memória |
| Pyodide | CPython compilado para WebAssembly | rodar Python no navegador |
Quando este artigo fala de interpretador, bytecode ou GIL, fala do CPython.
Uma história curta
No fim de 1989, Guido van Rossum, programador do instituto de pesquisa CWI, na Holanda, começou a escrever uma linguagem de script como passatempo de fim de ano. Ele queria algo tão fácil de ler quanto a linguagem ABC, com a qual tinha trabalhado, mas capaz de conversar com o sistema operacional e de ser estendida em C. O nome veio do grupo de humor britânico Monty Python, e não da cobra. A primeira versão pública saiu em fevereiro de 1991.
O Python 2.0, de 2000, trouxe as list comprehensions e um coletor de lixo para referências circulares. O Python 3.0, de 2008, foi uma ruptura deliberada: corrigiu decisões antigas, como separar texto Unicode (str) de bytes, e quebrou a compatibilidade. A transição levou mais de uma década, e o Python 2 só foi oficialmente aposentado em 1º de janeiro de 2020.
Em 2018, Guido deixou o posto de "ditador benevolente vitalício", e a linguagem passou a ser governada por um Conselho Diretor eleito pelos desenvolvedores principais. Desde a versão 3.9, sai uma versão nova por ano, em outubro. As recentes atacaram o ponto fraco histórico, o desempenho:
- 3.11 (2022): o projeto Faster CPython deixou o interpretador, em média, cerca de 25% mais rápido que o 3.10.
- 3.13 (2024): uma versão experimental sem o GIL, a free-threaded, e um compilador JIT experimental.
- 3.14 (2025): a versão sem GIL passou a ser oficialmente suportada, ainda como uma compilação opcional, e a linguagem ganhou as template strings.
- 3.15 (2026): lançada em 9 de outubro de 2026, trouxe as importações preguiçosas explícitas, o tipo embutido
frozendict, o UTF-8 como codificação padrão em qualquer sistema e um perfilador por amostragem na biblioteca padrão.
A transição para o Python 3 demorou porque um programa só podia migrar depois de todas as suas bibliotecas; desde então, as mudanças incompatíveis são raras e anunciadas com anos de antecedência.
Como a linguagem evolui: PEPs, conselho e calendário
Toda mudança relevante começa como uma PEP, um documento público com o problema, a proposta e as alternativas, discutido em fóruns abertos e decidido pelo Conselho Diretor, de cinco membros. Algumas PEPs são famosas por si: a PEP 8 traz as convenções de estilo do código, e a PEP 20 é o Zen do Python, os dezenove aforismos de Tim Peters que resumem a cultura da linguagem.
O calendário anual, definido pela PEP 602, deixou a evolução previsível: cada versão recebe correções por cerca de cinco anos, e uma empresa sabe com antecedência quando cada uma deixa de ser mantida. Algumas versões marcaram o Python moderno:
| Versão | Ano | O que trouxe de mais visível |
|---|---|---|
| 3.6 | 2016 | f-strings, como f'{nome} deve {valor}' |
| 3.7 | 2018 | a ordem de inserção dos dicionários passou a ser garantida; dataclasses |
| 3.8 | 2019 | o operador de atribuição em expressões, := |
| 3.9 | 2020 | o novo analisador PEG; list[int] sem importar nada; o módulo zoneinfo |
| 3.10 | 2021 | match; tipos com `int \ |
| 3.11 | 2022 | Faster CPython; grupos de exceções; TaskGroup; tomllib |
| 3.12 | 2023 | sintaxe nova para genéricos; f-strings mais flexíveis; objetos imortais |
| 3.13 | 2024 | novo terminal interativo; free-threaded e JIT experimentais |
| 3.14 | 2025 | free-threaded suportado; template strings; vários interpretadores na biblioteca padrão |
| 3.15 | 2026 | lazy import; frozendict; UTF-8 como codificação padrão; o pacote profiling |
Como o Python executa o seu código
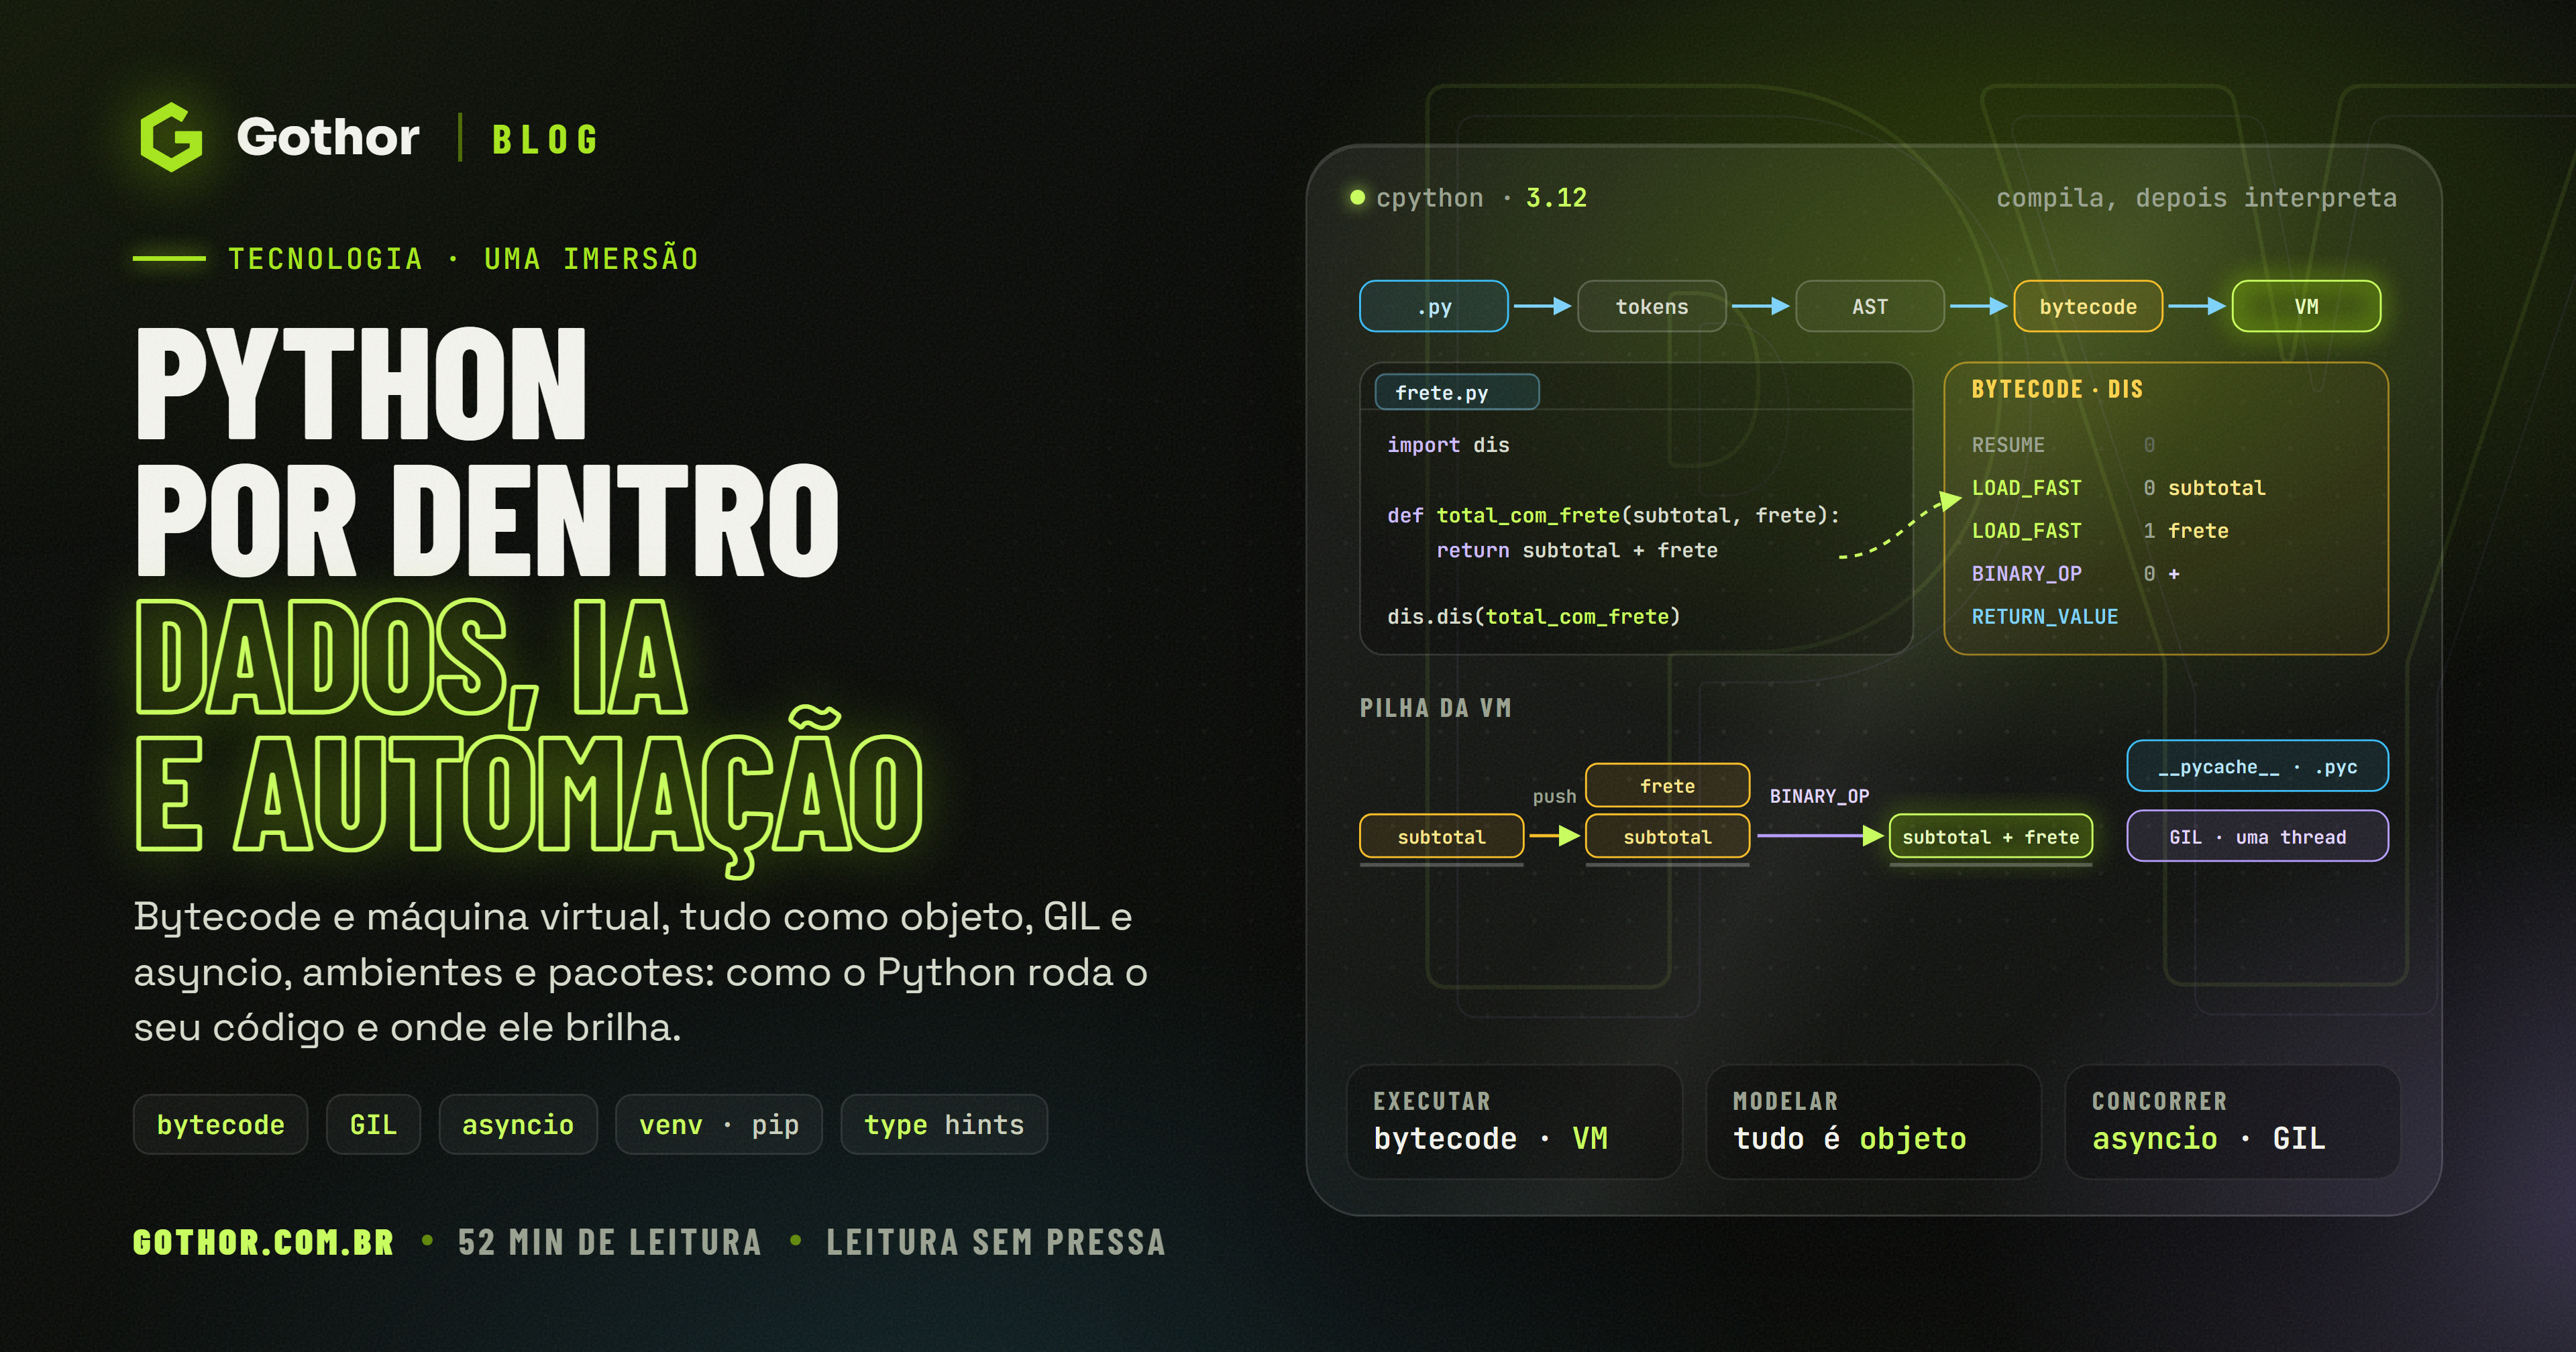
É comum ouvir que o Python é "interpretado", em oposição a linguagens "compiladas". A verdade fica no meio: o CPython compila o código-fonte para um formato intermediário, o bytecode, e depois interpreta esse bytecode numa máquina virtual.
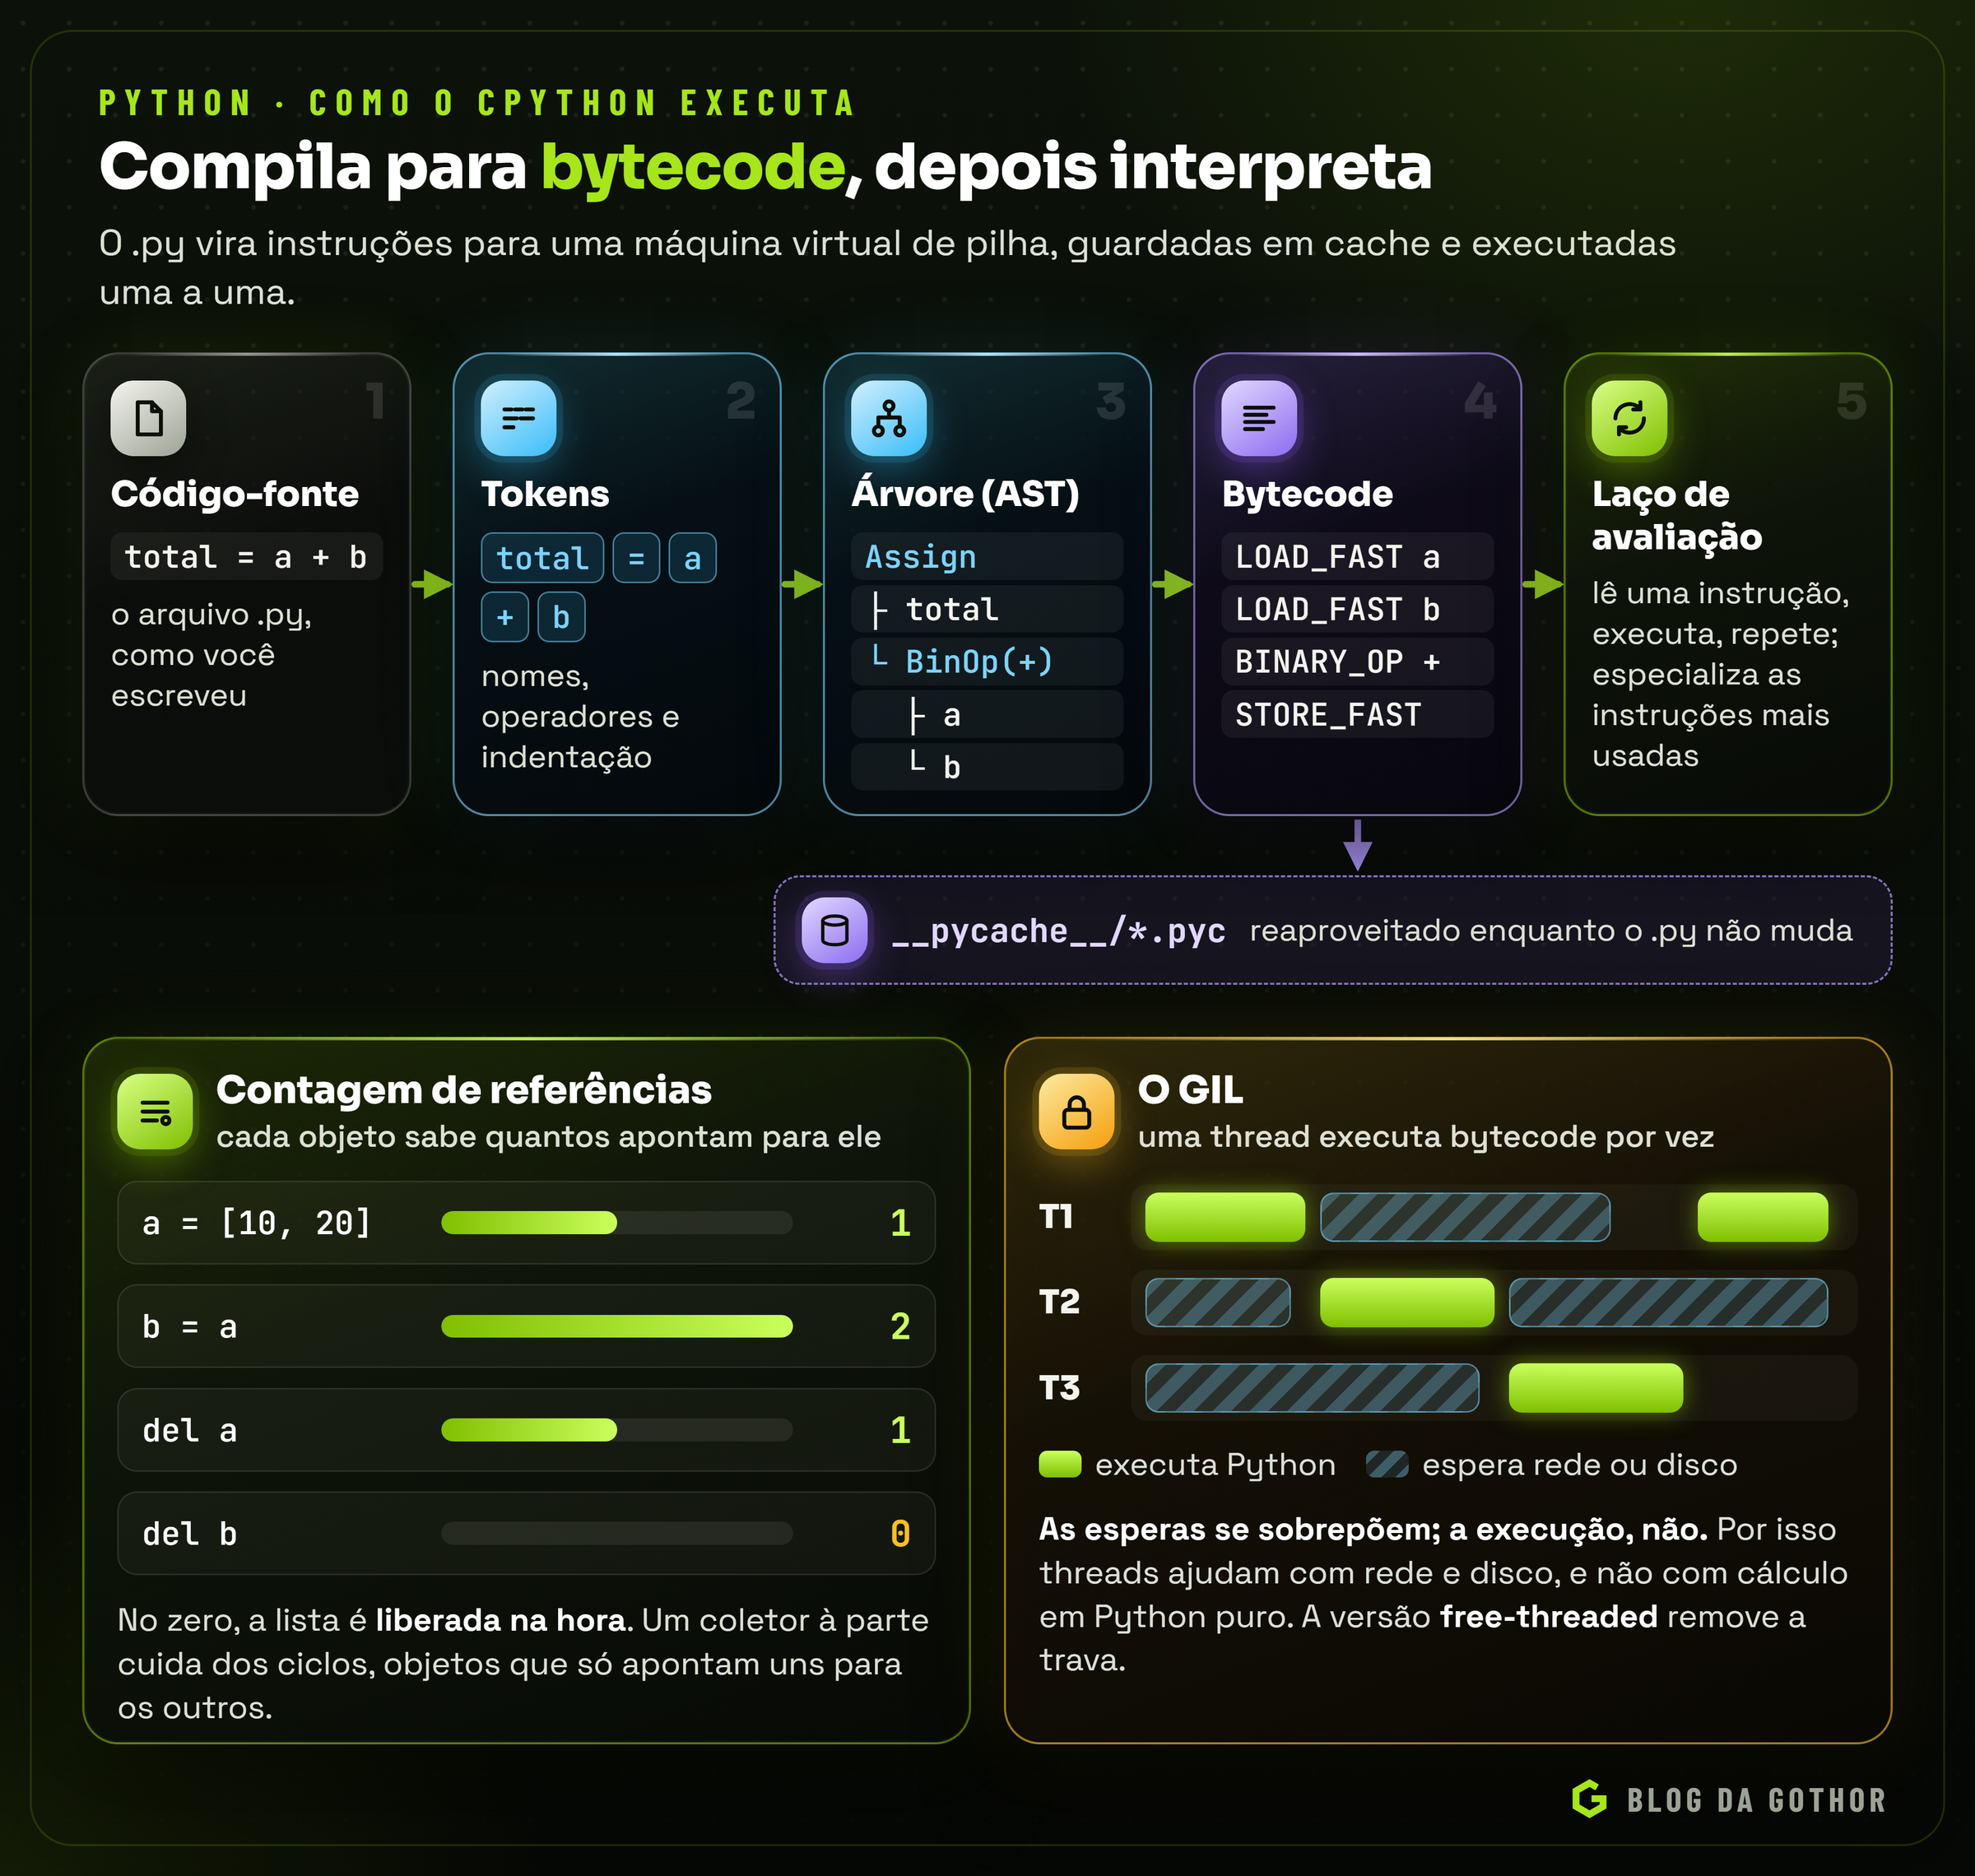
As etapas são estas:
- Tokenização: o texto vira uma sequência de símbolos (nomes, números, operadores, indentação).
- Análise sintática: um analisador do tipo PEG, usado desde a versão 3.9, monta a árvore sintática abstrata (AST).
- Compilação: a árvore vira objetos de código com o bytecode, instruções simples para uma máquina virtual de pilha.
- Cache: o bytecode dos módulos importados é gravado em arquivos
.pycna pasta__pycache__, para não ser compilado de novo enquanto o fonte não mudar. - Execução: o laço de avaliação, o coração do CPython, lê uma instrução por vez e a executa.
Dá para ver o bytecode com o módulo dis, da biblioteca padrão:
import dis

def total_com_frete(subtotal, frete):
    return subtotal + frete

dis.dis(total_com_frete)
# saída no Python 3.12, resumida:
#   RESUME        0
#   LOAD_FAST     0 (subtotal)
#   LOAD_FAST     1 (frete)
#   BINARY_OP     0 (+)
#   RETURN_VALUE
O nome exato das instruções muda entre versões, mas a ideia não: os valores são empilhados, a operação desempilha, calcula e empilha o resultado. Desde a 3.11, o interpretador é especializado e adaptativo: quando percebe que uma instrução genérica, como a soma, sempre recebe dois inteiros, troca-a por uma versão especializada e mais rápida.
Esse desenho explica a fama de lentidão. Cada operação passa pelo laço de avaliação, que precisa descobrir o tipo dos operandos em tempo de execução. Um laço em Python puro que soma milhões de números faz milhões de rodadas desse ciclo. É por isso que bibliotecas como o NumPy fazem o trabalho pesado em C: o Python só coordena, e o laço de verdade roda em código nativo.
Um detalhe do desenho tem efeito prático. Cada chamada de função cria um quadro (frame), com as variáveis locais num vetor, acessadas por posição, com LOAD_FAST. As globais ficam em dicionários, consultados pelo nome, com LOAD_GLOBAL. Por isso um laço quente dentro de uma função roda mais rápido que o mesmo laço solto no nível do módulo, e o primeiro conselho de desempenho em scripts é colocar o código numa função principal().
O interpretador adaptativo e o JIT
Na especialização da 3.11, descrita na PEP 659, o interpretador observa os tipos que de fato passam por cada instrução e a reescreve no lugar por uma variante especializada, com um pequeno cache embutido: um LOAD_ATTR que sempre lê o mesmo atributo da mesma classe vai direto à posição certa, sem procurar pelo nome. Se chegar um tipo diferente, a instrução volta à forma genérica. Nenhum código precisa mudar para aproveitar.
O passo seguinte é o compilador JIT, experimental desde a 3.13 e desligado por padrão. Ele usa a técnica de copy-and-patch: modelos de código de máquina já compilados para cada instrução são copiados e remendados com os valores concretos, sem precisar de um compilador completo em tempo de execução. Os ganhos ainda dependem muito do programa; o interesse está na base que ele cria para otimizações futuras.
O sistema de importação
Um import parece uma declaração passiva, mas é uma operação de execução, com etapas bem definidas:
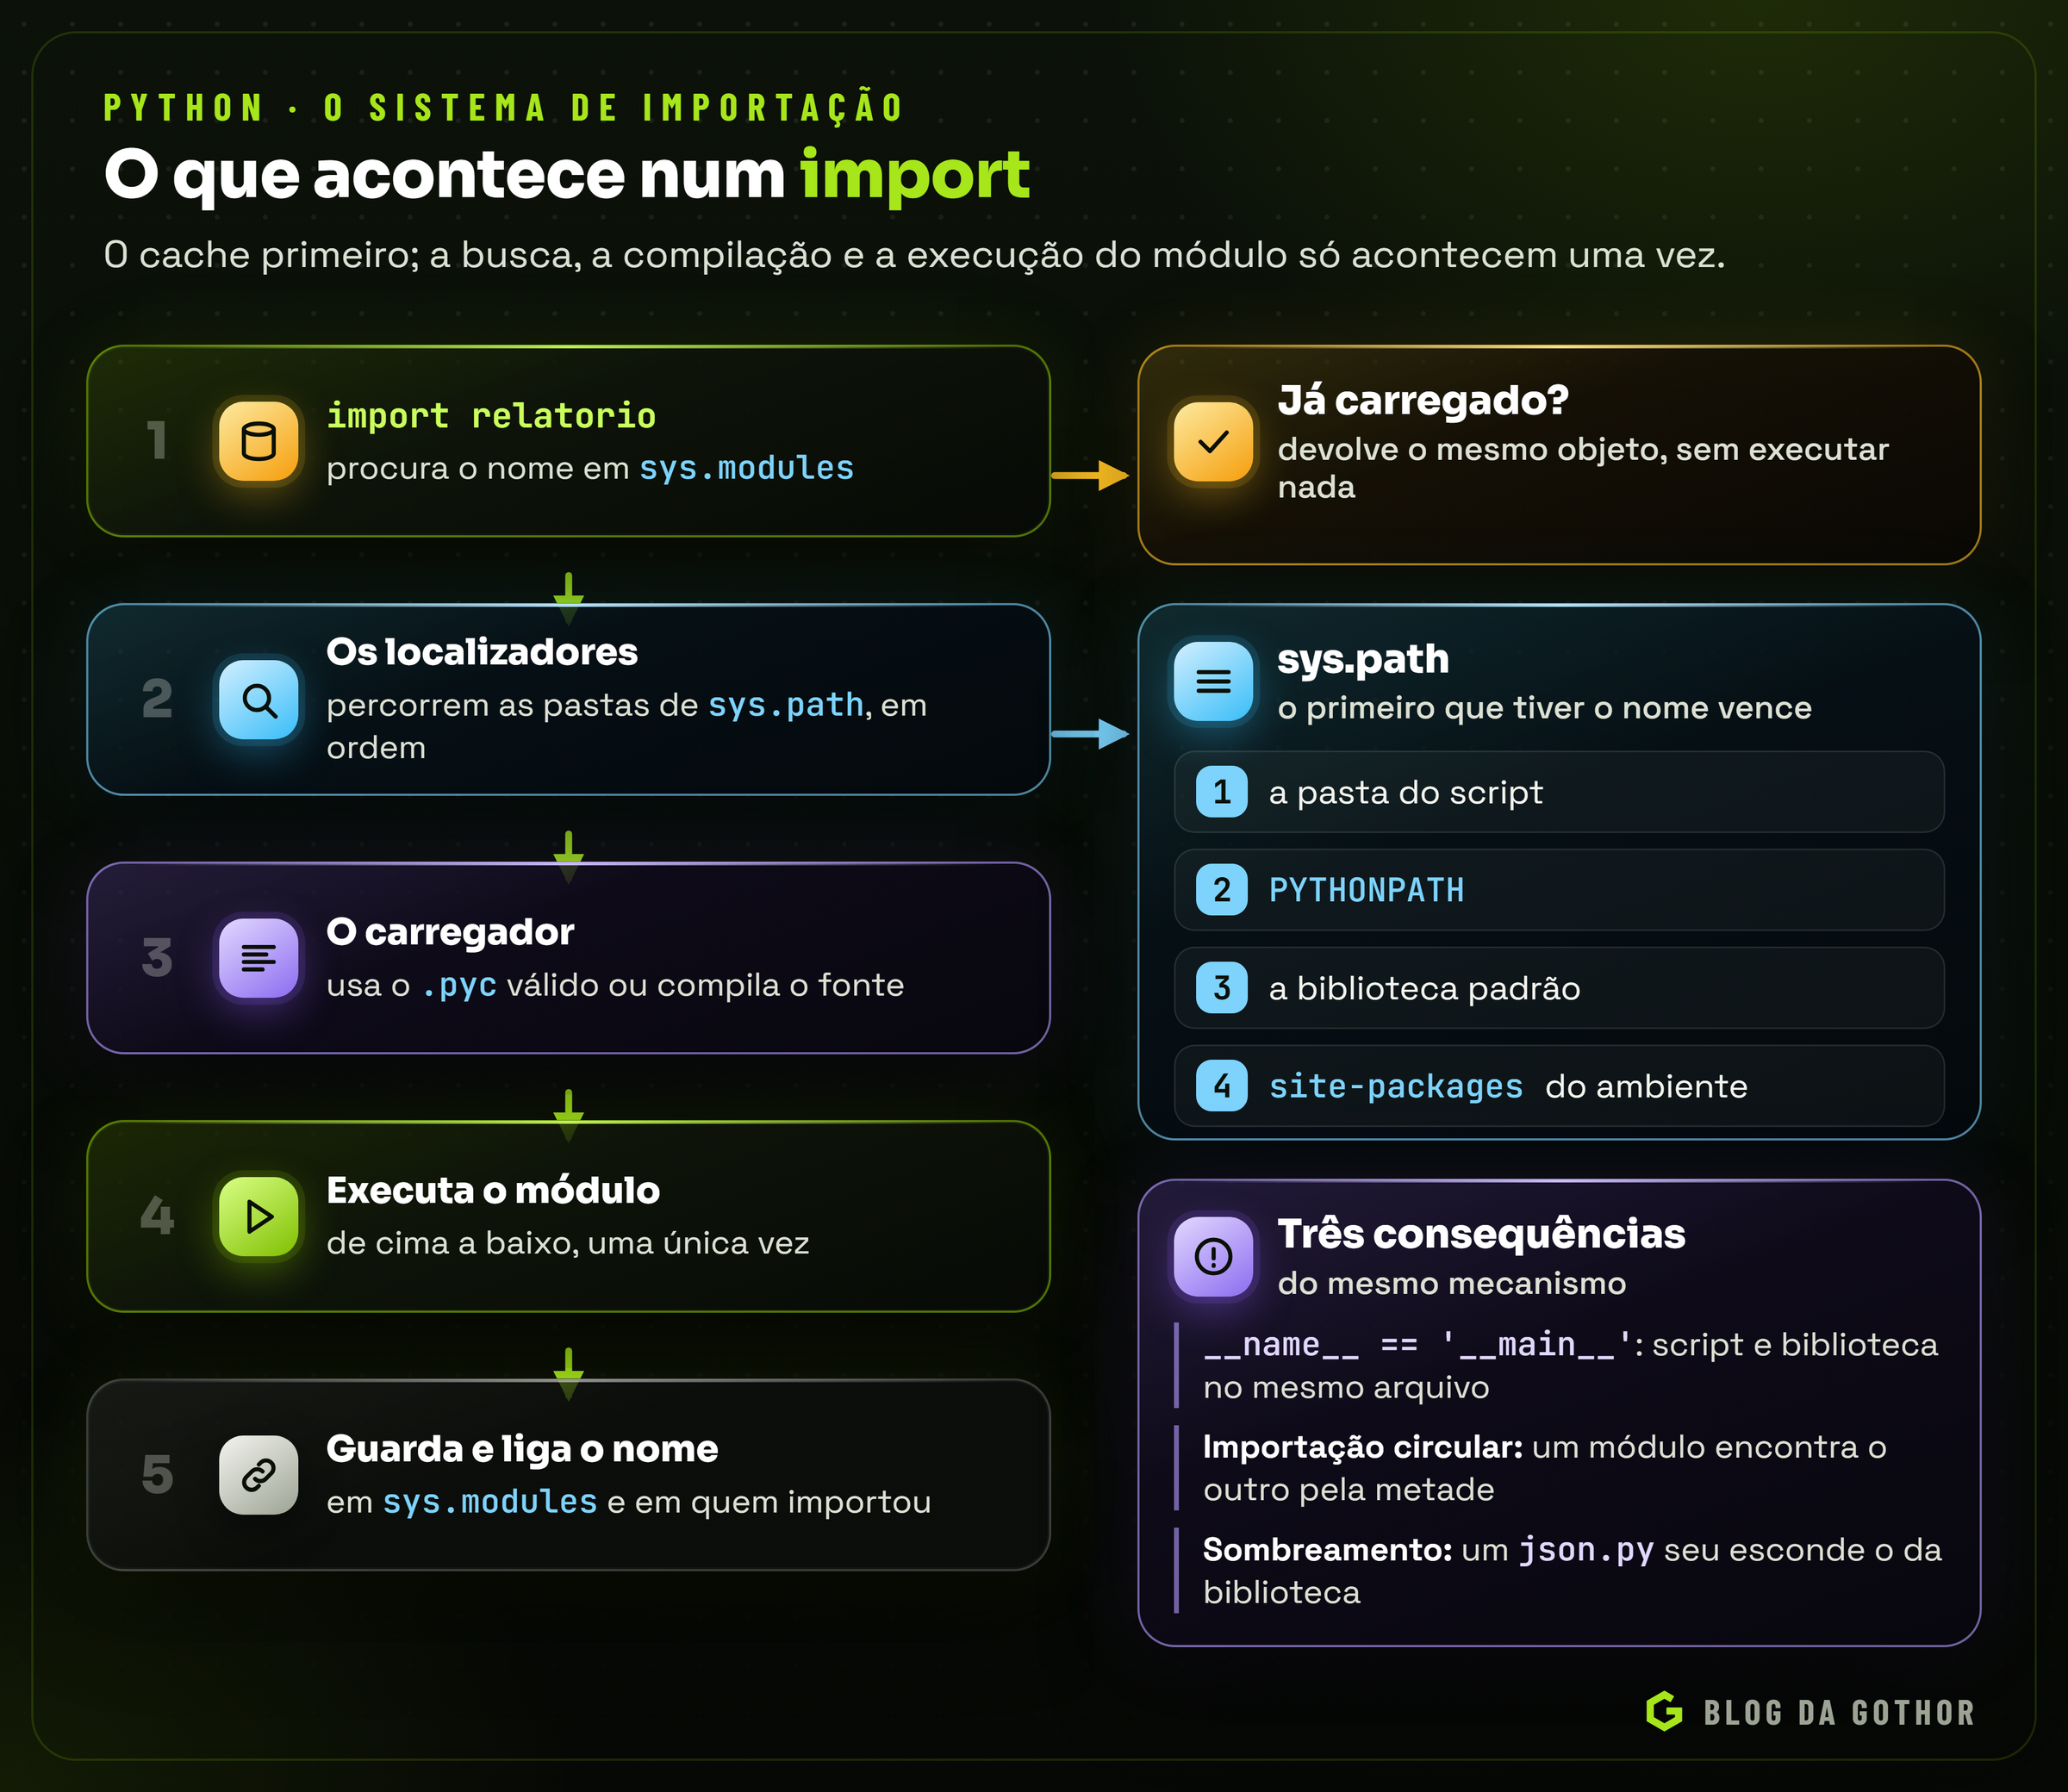
- O Python procura o nome em **
sys.modules**, o dicionário dos módulos já carregados. Se achar, entrega o mesmo objeto, sem fazer mais nada. - Se não achar, consulta os localizadores (finders), que percorrem as pastas de **
sys.path**: a pasta do script, as da variávelPYTHONPATH, a biblioteca padrão e o diretório de pacotes instalados, osite-packages. - Achado o arquivo, um carregador (loader) verifica se há um
.pycválido em__pycache__; se não houver, compila o fonte. - O módulo é executado de cima a baixo, uma única vez, e o objeto resultante é guardado em
sys.modules. - Por fim, o nome é ligado no espaço de nomes de quem importou.
# relatorio.py
print('carregando relatorio')
TAXA = 0.05
import relatorio # imprime "carregando relatorio"
import relatorio # não imprime de novo: o módulo já está em sys.modules
import sys
'relatorio' in sys.modules # TrueDesse funcionamento saem três consequências práticas. A primeira é o idioma if __name__ == '__main__':: a variável __name__ vale '__main__' quando o arquivo é executado diretamente e o nome do módulo quando é importado, o que permite que um arquivo seja ao mesmo tempo script e biblioteca. A segunda são as importações circulares: se a.py e b.py se importam no topo, um encontra o outro pela metade, ainda em execução, e falha com um nome que "não existe"; a correção é mover o que é comum para um terceiro módulo. A terceira é o sombreamento: um arquivo seu chamado json.py ou random.py na pasta do script vem antes da biblioteca padrão no sys.path e toma o lugar dela.
Importar só quando for usar
Como cada import executa o módulo, um programa que importa muitas bibliotecas no topo paga o custo de todas na partida, mesmo que use só uma delas naquela execução. Uma ferramenta de linha de comando que importa o pandas por causa de um subcomando raramente usado demora até para mostrar o --help. A 3.15 trouxe uma forma explícita, definida na PEP 810, com a palavra-chave contextual lazy:
lazy import json
lazy from pathlib import Path

print('iniciando...')            # json e pathlib ainda não foram carregados
dados = json.loads('{"a": 1}')   # o json é importado de fato aqui, no primeiro uso
O nome fica disponível desde o início, mas o módulo só é carregado quando alguém o usa. Essa mudança de momento tem duas consequências que convém conhecer. Os efeitos colaterais da importação, como o print do relatorio.py acima, passam a acontecer no primeiro uso, e não na partida. E um erro de importação, como um pacote que não está instalado, também só aparece no primeiro uso, o que pode esconder o problema até o dia em que aquele caminho do código roda. Por isso o lazy só é aceito no nível do módulo: dentro de funções, de classes e de blocos try, ele é um erro de sintaxe. Para descobrir quais importações pesam de verdade, a opção python -X importtime mostra o tempo gasto em cada módulo, e é o ponto de partida antes de marcar qualquer coisa como preguiçosa.
Memória: contagem de referências e coleta de lixo
O CPython gerencia a memória principalmente por contagem de referências: cada objeto sabe quantos nomes e estruturas apontam para ele e é liberado no instante em que a contagem chega a zero. Isso torna a liberação previsível, o que permite, por exemplo, fechar arquivos assim que saem de uso. Para os ciclos (dois objetos que apontam um para o outro e mais ninguém para eles), um coletor de lixo complementar roda de tempos em tempos.
Alguns detalhes completam o quadro:
- Alocador próprio para objetos pequenos. Em vez de pedir cada objeto ao sistema operacional, o CPython usa o pymalloc, que reserva blocos grandes e os reparte entre objetos de até 512 bytes. Por isso um processo Python nem sempre devolve memória ao sistema depois de liberar muitos objetos: os blocos ficam reservados para reuso.
- Objetos reaproveitados. Os inteiros de -5 a 256 são criados uma vez e compartilhados, e muitos textos curtos são "internados", guardados numa tabela única. Por isso
a is bpode darTruepara dois números pequenos eFalsepara dois números grandes de mesmo valor. É um detalhe de implementação, e mais um motivo para comparar valores com==. - Inteiros são objetos completos.
sys.getsizeof(1)dá 28 bytes num sistema de 64 bits, contra 4 ou 8 em C: o inteiro carrega a contagem de referências, o ponteiro para o tipo e os dígitos, sem limite de tamanho. Por isso uma lista de um milhão de números ocupa muito mais memória que um vetor do NumPy, que guarda só os números, lado a lado.
O coletor de ciclos e as gerações
O coletor que recolhe os ciclos se apoia numa observação antiga sobre programas: a maioria dos objetos morre jovem. Por isso, ele divide os objetos que acompanha em três gerações. Todo objeto novo nasce na geração 0, varrida com frequência; quem sobrevive a uma varredura sobe para a geração seguinte, varrida mais raramente, e a geração 2, a dos objetos antigos, é a que menos se varre. Só entram nessa conta os objetos que podem formar ciclos, como listas, dicionários e instâncias de classes; números e textos, que não apontam para outros objetos, ficam de fora, e é por isso que o coletor custa pouco na maior parte dos programas.
A história recente desse coletor mostra como a linguagem evolui com cautela. A 3.14 trocou o desenho por um coletor incremental, com duas gerações e a varredura dos objetos antigos feita aos pedaços, para reduzir as pausas longas em programas com muita memória. Relatos de aumento significativo no uso de memória em produção levaram à reversão dentro da própria série: a partir da 3.14.5, o coletor voltou ao desenho por gerações da 3.13. É um lembrete útil de que mesmo uma correção de versão pode mudar o comportamento de memória de um serviço, e de que vale medir depois de cada atualização.
Para programas que criam processos com fork, como servidores com vários processos de trabalho, o módulo gc oferece o gc.freeze(), da 3.7. Ele move todos os objetos existentes para uma geração permanente, que o coletor ignora daí em diante. Chamado logo antes do fork, evita que o coletor dos processos filhos escreva nesses objetos, e as páginas de memória que eles ocupam continuam compartilhadas com o processo pai, em vez de serem copiadas uma a uma.
O GIL
A contagem de referências tem um custo: se duas threads alterassem o contador do mesmo objeto ao mesmo tempo, ele poderia ficar errado. A solução histórica do CPython é o GIL (global interpreter lock), uma trava que garante que só uma thread execute bytecode Python por vez em cada processo.
Na prática, o GIL não atrapalha programas que esperam entrada e saída (rede, disco, banco), porque a trava é liberada enquanto a thread espera. Também não atrapalha bibliotecas em C, como o NumPy, que liberam a trava durante os cálculos. Ele limita o caso de código Python puro pesado em CPU com várias threads, que não ganha velocidade com mais núcleos. A versão free-threaded, suportada desde a 3.14, remove o GIL à custa de algum desempenho numa única thread e da necessidade de as bibliotecas em C se adaptarem.
Um ponto que costuma confundir: o GIL não torna o seu código seguro entre threads. Ele protege as estruturas internas do interpretador, e não a lógica do programa. Uma operação como contador += 1 é feita em várias instruções de bytecode (ler, somar, gravar), e a troca de thread, que acontece a cada 5 milissegundos por padrão, pode cair no meio. Para estado compartilhado, use threading.Lock ou filas (queue.Queue), que já fazem a sincronização.
A remoção do GIL, proposta na PEP 703, mudou o interpretador em vários pontos: objetos como None e os inteiros pequenos tornaram-se imortais, com uma contagem que nunca muda, e dicionários e listas ganharam travas próprias. A compilação sem GIL é instalada como um interpretador separado, como python3.14t, e, segundo a documentação da 3.14, custa de 5% a 10% em código de uma thread. Há ainda um caminho intermediário, os subinterpretadores, cada um com o seu GIL dentro do mesmo processo, levados à biblioteca padrão na 3.14 com o módulo concurrent.interpreters.
Tudo é objeto
Em Python, números, textos, listas, funções, classes e até módulos são objetos. Todo objeto tem uma identidade (o endereço, visto com id()), um tipo (visto com type()) e um valor. E as variáveis não são caixas que guardam valores: são nomes que apontam para objetos.
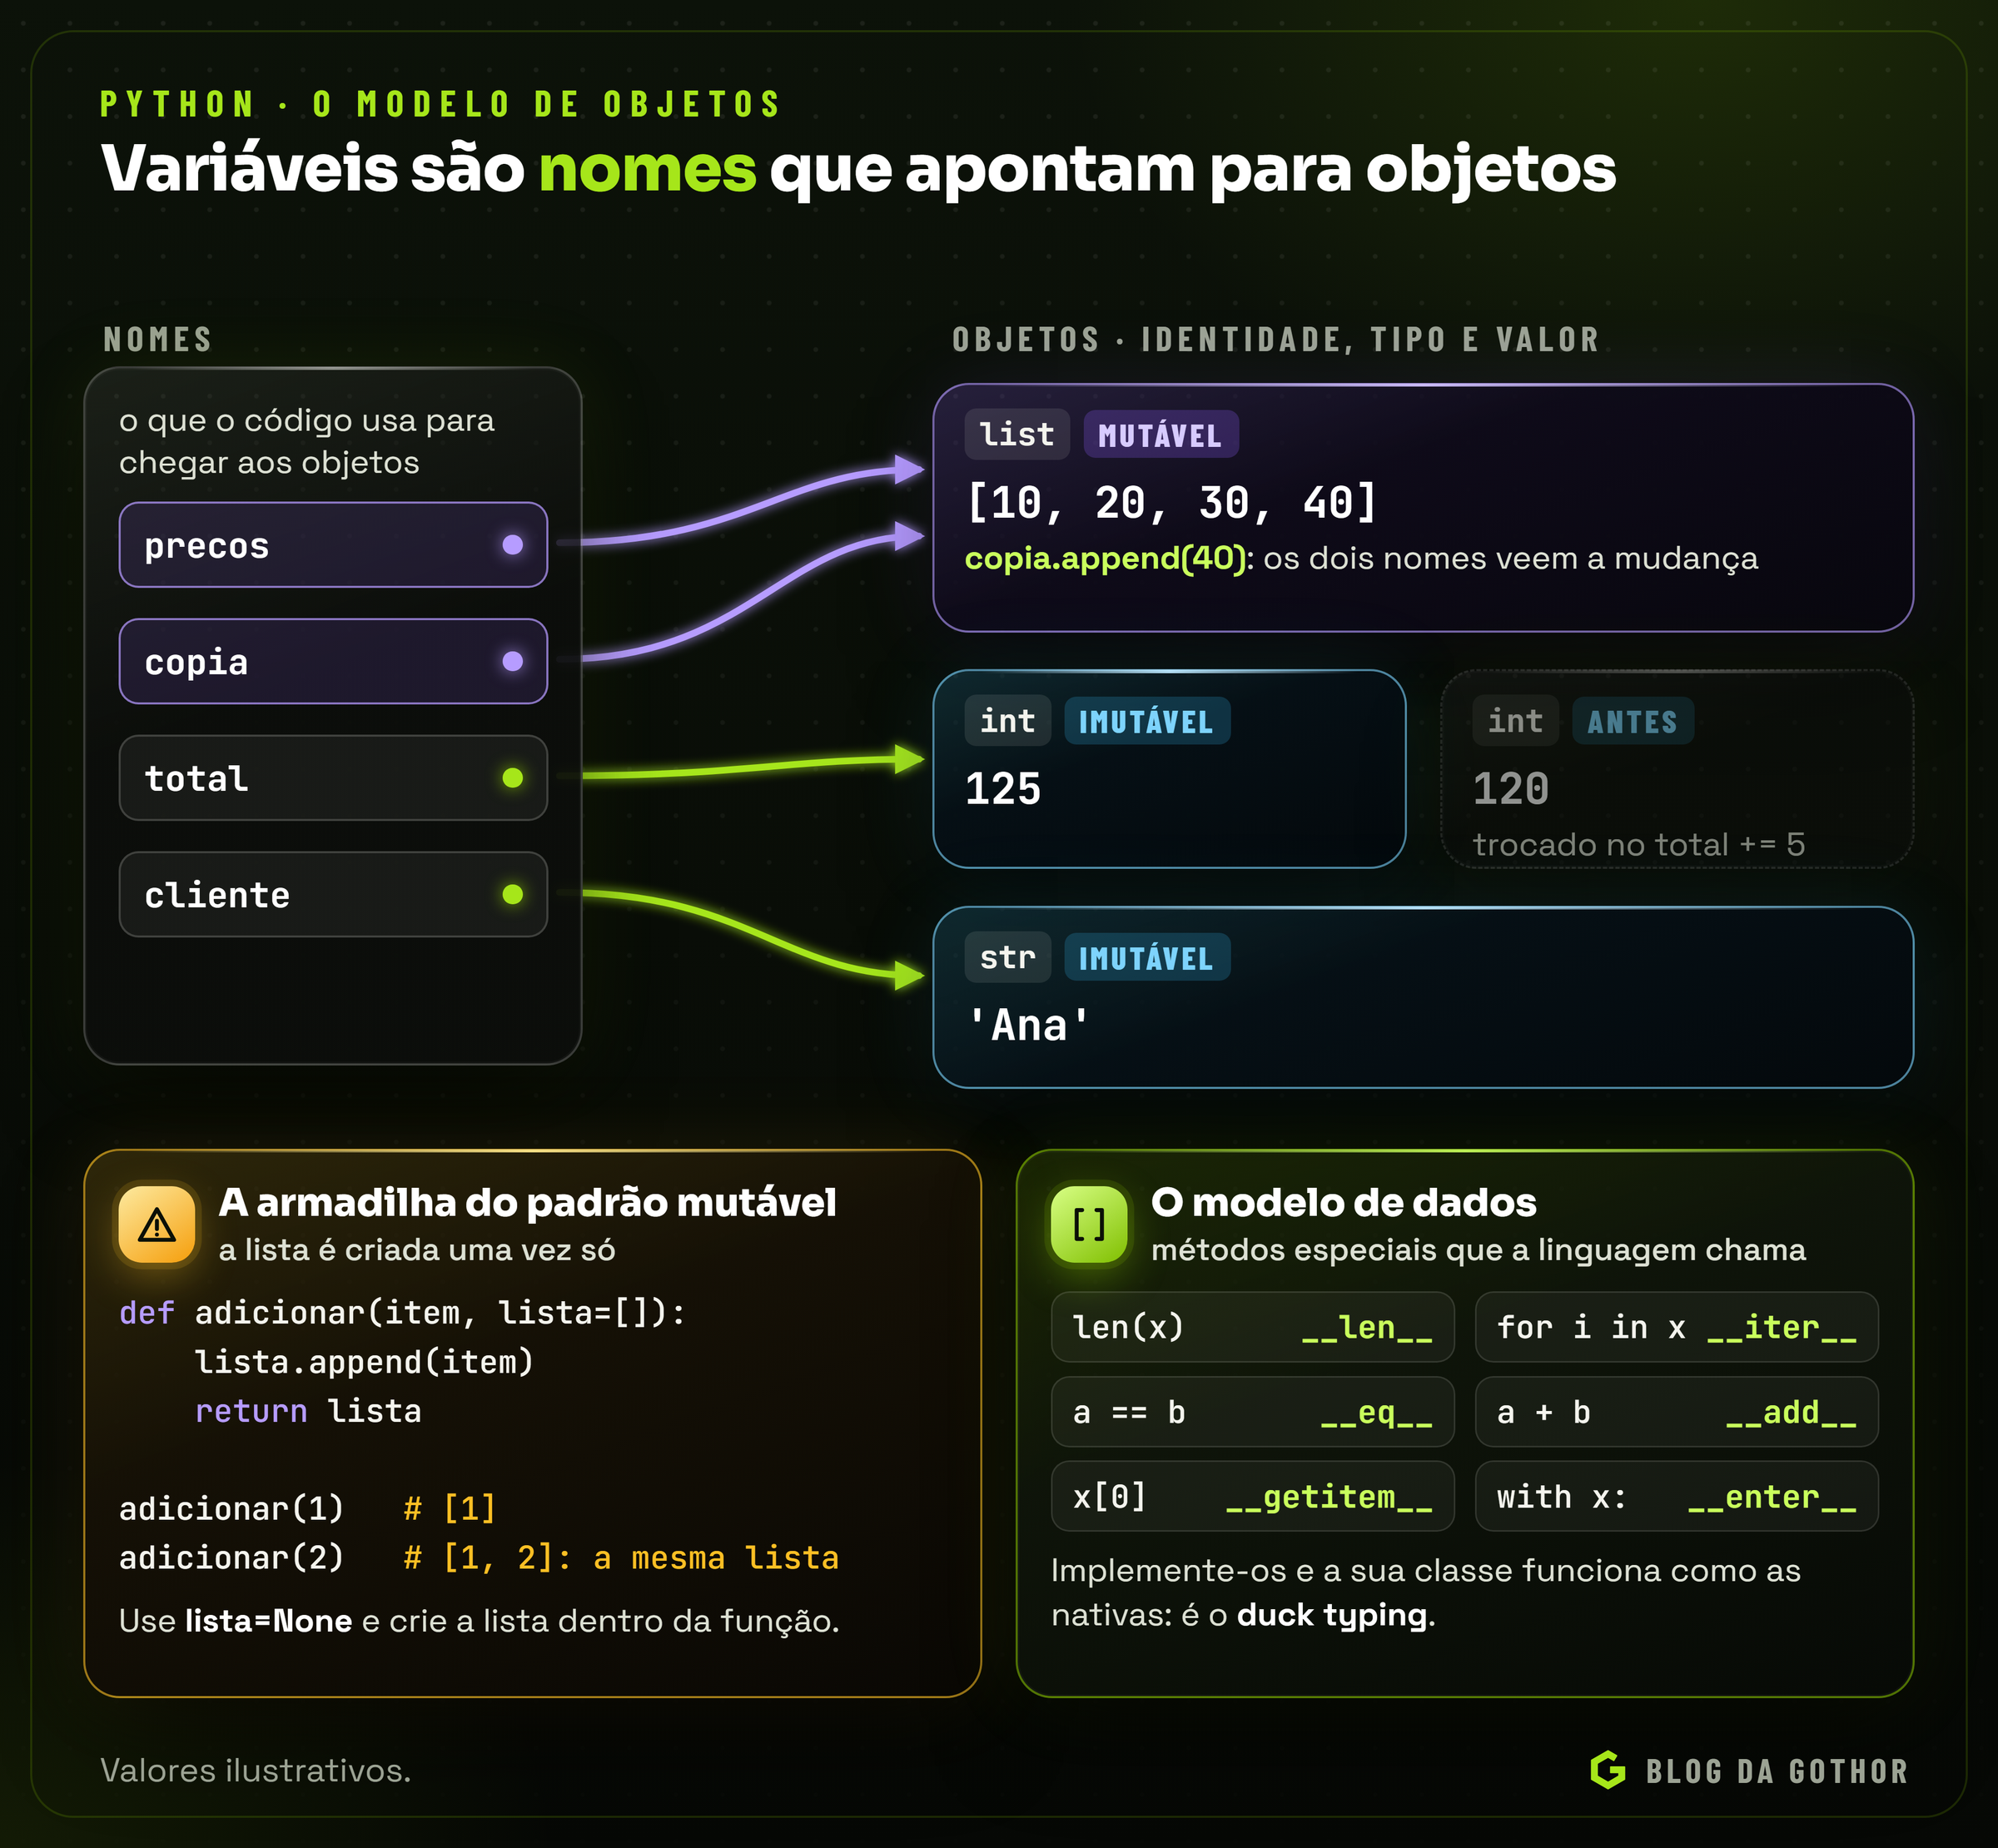
Essa diferença explica o comportamento que mais surpreende iniciantes:
precos = [10, 20, 30]
copia = precos          # não copia: os dois nomes apontam para a mesma lista
copia.append(40)
print(precos)           # [10, 20, 30, 40]

independente = precos.copy()   # ou list(precos), ou precos[:]
Os objetos se dividem em mutáveis (listas, dicionários, conjuntos e a maioria dos objetos de classes) e imutáveis (números, textos, tuplas, frozenset). Uma operação sobre um imutável sempre cria um objeto novo; sobre um mutável, pode alterar o próprio objeto, e todos os nomes que apontam para ele veem a mudança.
Dois operadores de comparação refletem isso: == compara valores e is compara identidade. Use is só para None (if desconto is None), e == para todo o resto. O mesmo vale para argumentos: uma função recebe o objeto, e não uma cópia, e um append numa lista recebida altera a lista de quem chamou.
O modelo de dados e o duck typing
O que torna os objetos do Python tão uniformes é o modelo de dados: a linguagem define métodos especiais, de nomes cercados por dois sublinhados, que qualquer classe pode implementar. Quem implementa __len__ funciona com len(); quem implementa __iter__ funciona num for; quem implementa __eq__ define o que é igualdade; quem implementa __enter__ e __exit__ funciona num with.
class Carrinho:
    def __init__(self):
        self.itens = []

    def __len__(self):
        return len(self.itens)

    def __iter__(self):
        return iter(self.itens)

carrinho = Carrinho()
carrinho.itens.append('arroz')
len(carrinho)            # 1
for item in carrinho:    # funciona como uma lista
    print(item)
Daí vem o duck typing, a filosofia de "se anda como pato e grasna como pato, é um pato": uma função que percorre algo com for aceita qualquer objeto iterável, seja lista, arquivo, gerador ou uma classe sua, sem exigir uma herança específica.
Classes também são objetos
Uma classe é ela mesma um objeto, criado quando o Python executa o bloco class, e o tipo dela é type, a metaclasse padrão. Quando o código lê objeto.atributo, o Python procura primeiro um descritor de dados na classe, como uma property; depois o dicionário da instância, objeto.__dict__; e só então a classe e as classes-base, na ordem da MRO (method resolution order), visível em Classe.__mro__.
class Cliente:
    __slots__ = ('nome', 'limite')     # sem __dict__ por instância: menos memória

    def __init__(self, nome: str, limite: float):
        self.nome = nome
        self.limite = limite

    @property
    def bloqueado(self) -> bool:       # lido como atributo, calculado na hora
        return self.limite <= 0

c = Cliente('Mercado Central', 0)
c.bloqueado      # True, sem parênteses
A property permite começar com um atributo simples e, mais tarde, colocar validação ou cálculo sem mudar quem usa a classe; por isso o Python dispensa os getters e setters de outras linguagens. O __slots__ troca o dicionário de cada instância por espaços fixos, uma economia grande com milhões de objetos.
Escopos, closures e a regra LEGB
Quando um nome é usado, o Python o procura em quatro lugares, nesta ordem: o escopo Local da função, os escopos das funções que a Envolvem, o escopo Global do módulo e o das funções emButidas, como len e print. É a regra LEGB.
Uma função definida dentro de outra lembra as variáveis da função de fora, mesmo depois que ela terminou. Esse par, função mais variáveis lembradas, é uma closure:
def acumulador():
    total = 0
    def somar(valor):
        nonlocal total          # sem isso, total += valor criaria uma variável local
        total += valor
        return total
    return somar

caixa = acumulador()
caixa(10)    # 10
caixa(5)     # 15
Sem nonlocal (ou global, para o módulo), qualquer atribuição dentro de uma função cria uma variável local, e uma leitura anterior do mesmo nome falha com UnboundLocalError.
Dicionários: a estrutura que sustenta a linguagem
O dicionário é a estrutura mais importante do Python: os atributos de um objeto, as variáveis globais e os módulos carregados vivem em dicionários. Por dentro, é uma tabela de dispersão (hash table): a chave passa por uma função de hash, que indica onde guardar e procurar o valor, e a busca leva o mesmo tempo com dez ou dez milhões de chaves. Desde a 3.7, a ordem de inserção é garantida. Duas regras decorrem do desenho:
- As chaves precisam ser hasheáveis. Números, textos e tuplas de imutáveis servem; listas e dicionários, não, porque o valor do hash mudaria se o conteúdo mudasse. Tentar usar uma lista como chave gera
TypeError: unhashable type: 'list'. - Conjuntos usam a mesma ideia.
x in conjuntoé praticamente instantâneo, enquantox in listapercorre a lista inteira: conferir cem mil códigos contra uma lista de cem mil itens pode significar bilhões de comparações.
Texto, números e datas: onde moram os detalhes
Três tipos de dado aparecem em quase todo programa de empresa, e os três escondem detalhes que só se revelam quando algo dá errado: o nome que chega com os acentos trocados, o total que não fecha por um centavo e o horário que muda de dia conforme o servidor.
Texto e bytes
Desde o Python 3, há dois tipos distintos. O str guarda texto: uma sequência de caracteres Unicode, cada um identificado por um número, o ponto de código. O bytes guarda bytes, números de 0 a 255, que é o que de fato trafega pela rede e fica gravado no disco. A ponte entre os dois é uma codificação, como o UTF-8 ou o antigo Latin-1, e as duas direções têm nome: encode transforma texto em bytes, e decode faz o caminho de volta.
nome = 'Cuiabá'
dados = nome.encode('utf-8')     # b'Cuiab\xc3\xa1': o "á" vira dois bytes
len(nome), len(dados)            # (6, 7)
dados.decode('latin-1')          # 'Cuiabá': bytes certos, codificação errada
A última linha mostra a origem do texto embaralhado que todo mundo já viu num relatório: os bytes estão corretos, mas foram lidos com a codificação errada. O Python não adivinha a codificação de um arquivo; quem lê precisa saber como ele foi gravado. Arquivos exportados por sistemas mais antigos ainda chegam com frequência em Latin-1 ou na variante do Windows, a cp1252, e a solução é dizer isso na leitura: open(caminho, encoding='cp1252').
Durante muito tempo, abrir um arquivo sem informar a codificação usava a configuração regional do sistema, o que fazia o mesmo script ler um CSV corretamente no Linux e errado no Windows. Desde a 3.15, com a PEP 686, o padrão é o UTF-8 em qualquer sistema, e o comportamento antigo só volta com PYTHONUTF8=0 ou -X utf8=0. Informar o encoding continua sendo a prática certa, porque deixa explícito o que se espera e funciona igual em qualquer versão.
Por dentro, o CPython guarda cada texto da forma mais compacta possível, desde a 3.3, com a PEP 393: um byte por caractere quando todos cabem no Latin-1, dois quando cabem no plano básico do Unicode e quatro quando há algum caractere além dele, como um emoji. Um único emoji num texto longo multiplica a memória do texto inteiro por quatro, um detalhe que só aparece para quem processa grandes volumes.
Dois cuidados completam o quadro. Um mesmo texto pode ter mais de uma representação: o "á" pode ser um único ponto de código ou um "a" seguido de um acento combinante. As duas formas aparecem iguais na tela, mas são diferentes para o ==, e isso explica nomes de clientes "iguais" que não casam num cruzamento. O módulo unicodedata resolve com unicodedata.normalize('NFC', texto), aplicado aos dois lados antes de comparar. E, para comparar sem diferenciar maiúsculas, o casefold() é mais correto que o lower(), porque trata casos como o "ß" alemão, que vira "ss".
Números: inteiros sem limite, float e Decimal
Os inteiros do Python não transbordam: 2 ** 200 é calculado exatamente, com quantos dígitos forem necessários. O custo aparece na conversão entre número e texto decimal, que fica lenta para números gigantes, e foi isso que motivou uma proteção pouco conhecida. Desde a 3.11, converter um texto decimal com mais de 4.300 dígitos em inteiro, ou o contrário, gera um ValueError. O limite evita que alguém trave um servidor enviando um número enorme num JSON ou num formulário, a falha registrada como CVE-2020-10735, e pode ser ajustado com sys.set_int_max_str_digits(), com a variável PYTHONINTMAXSTRDIGITS ou com a opção -X int_max_str_digits. As conversões em hexadecimal, octal e binário não têm limite.
O float é, na prática, um número de ponto flutuante de 64 bits no padrão IEEE 754, e herda as limitações dele: frações decimais como 0,1 não têm representação exata em binário. A função round arredonda a metade para o número par, o chamado arredondamento bancário: round(0.5) dá 0 e round(2.5) dá 2. E a própria documentação avisa que round(2.675, 2) dá 2.67, e não 2.68, porque o número guardado é um pouco menor que 2,675.
Para dinheiro, o decimal.Decimal faz as contas em base dez, com precisão configurável (28 dígitos significativos no contexto padrão) e o modo de arredondamento que a regra do negócio pedir:
from decimal import Decimal, ROUND_HALF_UP

Decimal(1.1)        # Decimal('1.100000000000000088817841970012523233890533447265625')
Decimal('1.1')      # Decimal('1.1'): crie a partir de texto, nunca de float

preco = Decimal('7.325')
preco.quantize(Decimal('0.01'))                          # Decimal('7.32'): metade para o par
preco.quantize(Decimal('0.01'), rounding=ROUND_HALF_UP)  # Decimal('7.33'): a metade sobe
As duas armadilhas estão no exemplo. Um Decimal criado a partir de um float herda o erro binário do float, com todos os dígitos dele; o certo é criá-lo a partir de texto ou de inteiros. E o arredondamento padrão do Decimal também é o da metade para o par: quando a regra pede que a metade suba, ela precisa ser dita no quantize, de preferência num único lugar do código. Para frações exatas, como um terço, o módulo fractions guarda numerador e denominador e nunca arredonda.
Datas e fusos horários
Um datetime pode ser ingênuo (naive), sem fuso, ou consciente (aware), com fuso. A documentação descreve bem a diferença: o consciente representa um instante específico, que não está aberto a interpretação; o ingênuo não tem informação suficiente para se situar em relação a outros. Somar e comparar horários ingênuos que vieram de servidores em fusos diferentes produz erros silenciosos, e comparar a ordem de um ingênuo com um consciente gera um TypeError.
from datetime import datetime, UTC
from zoneinfo import ZoneInfo

agora = datetime.now(UTC)                              # consciente, em UTC
local = agora.astimezone(ZoneInfo('America/Cuiaba'))   # o mesmo instante, no horário local
vencimento = datetime(2026, 11, 3, 18, 0, tzinfo=ZoneInfo('America/Sao_Paulo'))
vencimento - agora                                     # timedelta exato, mesmo entre fusos
O módulo zoneinfo, da 3.9, usa a base de fusos da IANA, a mesma dos sistemas operacionais, com as regras de horário de verão de cada região e o histórico delas. O Windows não traz essa base, e nele o zoneinfo recorre ao pacote tzdata, do PyPI, que deve ser declarado como dependência em projetos que rodam em mais de um sistema. O apelido datetime.UTC chegou na 3.11, e o antigo datetime.utcnow() foi declarado obsoleto na 3.12, justamente porque devolvia um horário em UTC sem dizer que era UTC, um objeto ingênuo. A regra prática é a mesma de bancos de dados e APIs: guardar e calcular em UTC, converter para o fuso local só na exibição e trocar datas entre sistemas no formato ISO 8601, com o deslocamento explícito, como 2026-11-03T18:00:00-03:00.
A sintaxe que faz a fama
Alguns recursos aparecem em praticamente todo código Python moderno:
pedidos = [
    {'cliente': 'Ana', 'total': 120.0, 'pago': True},
    {'cliente': 'Bruno', 'total': 80.0, 'pago': False},
]

# compreensões: listas, dicionários e conjuntos numa linha legível
pendentes = [p['cliente'] for p in pedidos if not p['pago']]
totais = {p['cliente']: p['total'] for p in pedidos}

# desempacotamento e f-strings
primeiro, *resto = pedidos
print(f"{primeiro['cliente']} comprou R$ {primeiro['total']:.2f}")

# gerenciadores de contexto: o arquivo fecha sozinho, mesmo com erro
with open('relatorio.csv', encoding='utf-8') as arquivo:
    linhas = arquivo.readlines()

# geradores: produzem um item por vez, sem carregar tudo na memória
def linhas_grandes(caminho):
    with open(caminho, encoding='utf-8') as f:
        for linha in f:
            yield linha.rstrip()
Os geradores merecem destaque: com yield, uma função passa a produzir valores sob demanda, o que permite processar arquivos de gigabytes linha a linha. Os decoradores, escritos com @ acima de uma função, a envolvem com comportamento extra, como registro, cache ou controle de acesso. E o match, desde a 3.10, faz correspondência de padrões estruturais, útil para tratar mensagens de formatos diferentes.
Iteradores e geradores por dentro
O for do Python chama iter() no objeto para obter um iterador e, depois, next() repetidamente, até que o iterador sinalize o fim com a exceção StopIteration. Um gerador é a forma mais fácil de escrever um iterador. Cada yield entrega um valor e congela a função, com as variáveis locais e a posição; o próximo next() retoma de onde parou. Encadear geradores cria uma linha de montagem em que cada item passa por todas as etapas antes de o próximo ser lido, com uso de memória constante, seja o arquivo de mil ou de cem milhões de linhas:
import csv
from decimal import Decimal

def ler(caminho):
    with open(caminho, encoding='utf-8', newline='') as f:
        yield from csv.DictReader(f, delimiter=';')

def vencidos(linhas, hoje):
    for linha in linhas:
        if linha['vencimento'] < hoje and linha['pago'] == 'N':
            yield linha

def valores(linhas):
    for linha in linhas:
        yield Decimal(linha['valor'].replace(',', '.'))

total = sum(valores(vencidos(ler('titulos.csv'), '2026-10-20')))
A comparação de datas como texto funciona porque o formato ISO (AAAA-MM-DD) ordena na mesma ordem do calendário. O módulo itertools completa o repertório, com peças como batched, da 3.12, que divide em lotes de tamanho fixo.
Decoradores na prática
Um decorador é só uma função que recebe uma função e devolve outra: @decorador acima de def f equivale a f = decorador(f). Um exemplo útil em integrações é repetir uma chamada de rede que falhou, com espera crescente:
import functools
import time

def tentar_de_novo(vezes=3, espera=1.0, excecoes=(ConnectionError, TimeoutError)):
    def decorador(funcao):
        @functools.wraps(funcao)          # preserva o nome e a documentação da original
        def envoltorio(*args, **kwargs):
            for tentativa in range(1, vezes + 1):
                try:
                    return funcao(*args, **kwargs)
                except excecoes:
                    if tentativa == vezes:
                        raise
                    time.sleep(espera * 2 ** (tentativa - 1))   # 1 s, 2 s, 4 s...
        return envoltorio
    return decorador

@tentar_de_novo(vezes=4)
def buscar_cotacao(moeda: str) -> float:
    ...
Na biblioteca padrão, functools.cache guarda o resultado de chamadas anteriores e contextlib.contextmanager transforma um gerador num gerenciador de contexto para o with.
Correspondência de padrões com match
O match, definido na PEP 634 e disponível desde a 3.10, não é o switch de outras linguagens. Ele compara a forma de um dado, desmonta-o e dá nome às partes, tudo no mesmo passo. É útil sobretudo para tratar mensagens e eventos que chegam em formatos diferentes, como as notificações de um sistema de pagamentos:
def tratar(evento: dict) -> str:
    match evento:
        case {'tipo': 'pagamento', 'valor': int(valor), 'titulo': titulo} if valor > 0:
            return f'baixar o título {titulo}'
        case {'tipo': 'estorno', 'titulo': titulo}:
            return f'reabrir o título {titulo}'
        case {'tipo': 'pagamento'}:
            return 'pagamento sem valor válido: revisar'
        case {'tipo': str(tipo)}:
            return f'evento desconhecido: {tipo}'
        case _:
            return 'mensagem fora do formato'
Os casos são testados de cima para baixo, e o primeiro que combina vence. O padrão de dicionário aceita chaves a mais, então a ordem importa: o caso mais específico vem antes do mais genérico. O int(valor) é um padrão de classe: confere o tipo com isinstance e captura o valor. O if depois do padrão é uma guarda, avaliada só quando a forma combina. E o _ é o curinga, que aceita qualquer coisa e não guarda nada.
A armadilha clássica está nos nomes soltos. Em case PAGO:, o Python não compara o valor com uma constante chamada PAGO: ele captura o valor num nome novo, e o caso combina sempre. Quando há outros casos depois dele, o próprio compilador recusa o código com um erro de sintaxe, o que ajuda a perceber o engano. Para comparar com uma constante, ela precisa ter um ponto no nome, como Situacao.PAGO, de um Enum, ou ser escrita como literal.
Exceções: é mais fácil pedir perdão
Em Python, os erros são exceções, objetos que sobem pela pilha de chamadas até alguém tratá-los com try e except. A cultura da linguagem tem até um nome para o estilo preferido: EAFP, "é mais fácil pedir perdão do que permissão". Em vez de verificar antes se algo vai dar certo, tenta-se a operação e trata-se a falha:
from decimal import Decimal, InvalidOperation

def ler_valor(texto: str) -> Decimal | None:
    try:
        return Decimal(texto.replace(',', '.'))
    except InvalidOperation:
        return None          # trata só o erro esperado; qualquer outro continua subindo
O estilo contrário, verificar antes, sofre de condições de corrida: entre conferir se um arquivo existe e abri-lo, alguém pode apagá-lo. Dois cuidados valem sempre: capturar só as exceções que você sabe tratar e, ao relançar com outra exceção, usar raise NovaExcecao(...) from erro, que preserva a causa original no rastreamento.
Desde a 3.11, há também os grupos de exceções: quando várias tarefas paralelas falham ao mesmo tempo, o ExceptionGroup carrega todas as falhas juntas, e a sintaxe except* trata cada tipo separadamente.
Tipos opcionais: type hints
O Python continua dinâmico, mas desde a versão 3.5 aceita anotações de tipo, as type hints:
from dataclasses import dataclass

@dataclass
class Item:
    produto: str
    quantidade: int
    preco: float

def total(itens: list[Item], frete: float = 0.0) -> float:
    return sum(i.quantidade * i.preco for i in itens) + frete
O ponto essencial é que o interpretador não confere as anotações. Elas servem a ferramentas externas, como o mypy e o Pyright, que verificam o código sem executá-lo, e ao editor, que passa a autocompletar com precisão. É a mesma ideia do TypeScript, com uma diferença: em Python, a verificação é sempre um passo à parte. Para dados que vêm de fora, a validação em execução fica com bibliotecas como o Pydantic, que usa as próprias anotações para validar e converter os dados.
Tipagem gradual e estrutural
O sistema de tipos do Python é gradual: dá para anotar só uma parte do código, e o que não tem anotação é tratado como Any, o tipo que aceita tudo, o que permite adotar tipos aos poucos, módulo por módulo. O módulo typing cobre os casos do dia a dia:
from typing import Literal, Protocol, TypedDict

class Notificador(Protocol):            # tipagem estrutural: basta ter o método
    def enviar(self, destino: str, texto: str) -> None: ...

class Email:                            # não herda de Notificador e mesmo assim serve
    def enviar(self, destino: str, texto: str) -> None:
        ...

def avisar_vencimento(canal: Notificador, cliente: str) -> None:
    canal.enviar(cliente, 'O seu título vence amanhã.')

Situacao = Literal['aberto', 'pago', 'cancelado']

class Titulo(TypedDict):                # o formato de um dicionário vindo de JSON
    numero: str
    valor: float
    situacao: Situacao

def primeiro[T](itens: list[T]) -> T:  # genéricos com a sintaxe da 3.12
    return itens[0]
O Protocol é o duck typing levado aos tipos: qualquer classe com um método enviar dessa assinatura é aceita, sem herança. O Literal faz o verificador apontar um 'pag' digitado errado.
Validação na fronteira com o Pydantic
As anotações descrevem o que o código espera, mas não garantem o que chega de fora: um arquivo, uma requisição HTTP, uma linha de planilha. Nessa fronteira, entra a validação em tempo de execução:
from datetime import date
from decimal import Decimal
from pydantic import BaseModel, Field, ValidationError

class Pagamento(BaseModel):
    titulo: str = Field(min_length=1)
    valor: Decimal = Field(gt=0)
    data: date

try:
    p = Pagamento.model_validate({'titulo': '123', 'valor': '89.90', 'data': '2026-10-20'})
    p.valor     # Decimal('89.90'), já convertido
    p.data      # datetime.date(2026, 10, 20)
except ValidationError as erro:
    print(erro)  # diz qual campo falhou e por quê
O padrão recomendado é validar uma vez, na entrada, e daí para dentro trabalhar só com objetos já tipados e confiáveis. A versão 2 do Pydantic tem o núcleo escrito em Rust, mais um exemplo do Python como interface sobre código nativo rápido.
Concorrência: threads, processos e asyncio
Com o GIL em mente, a escolha da ferramenta de concorrência fica clara:
| Situação | Ferramenta | Por quê |
|---|---|---|
| Muita espera de rede ou disco | asyncio ou threads | o GIL é liberado durante a espera |
| Milhares de conexões simultâneas | asyncio | uma thread atende todas, sem o custo de uma thread por conexão |
| Cálculo pesado em Python puro | multiprocessing ou ProcessPoolExecutor | cada processo tem o seu próprio interpretador e GIL |
| Cálculo numérico | NumPy, Polars e afins | o trabalho roda em código nativo, fora do GIL |
O asyncio é o modelo assíncrono da biblioteca padrão e funciona de forma muito parecida com o event loop do JavaScript: uma única thread, um laço de eventos e corrotinas, funções declaradas com async def que cedem a vez com await sempre que vão esperar algo.
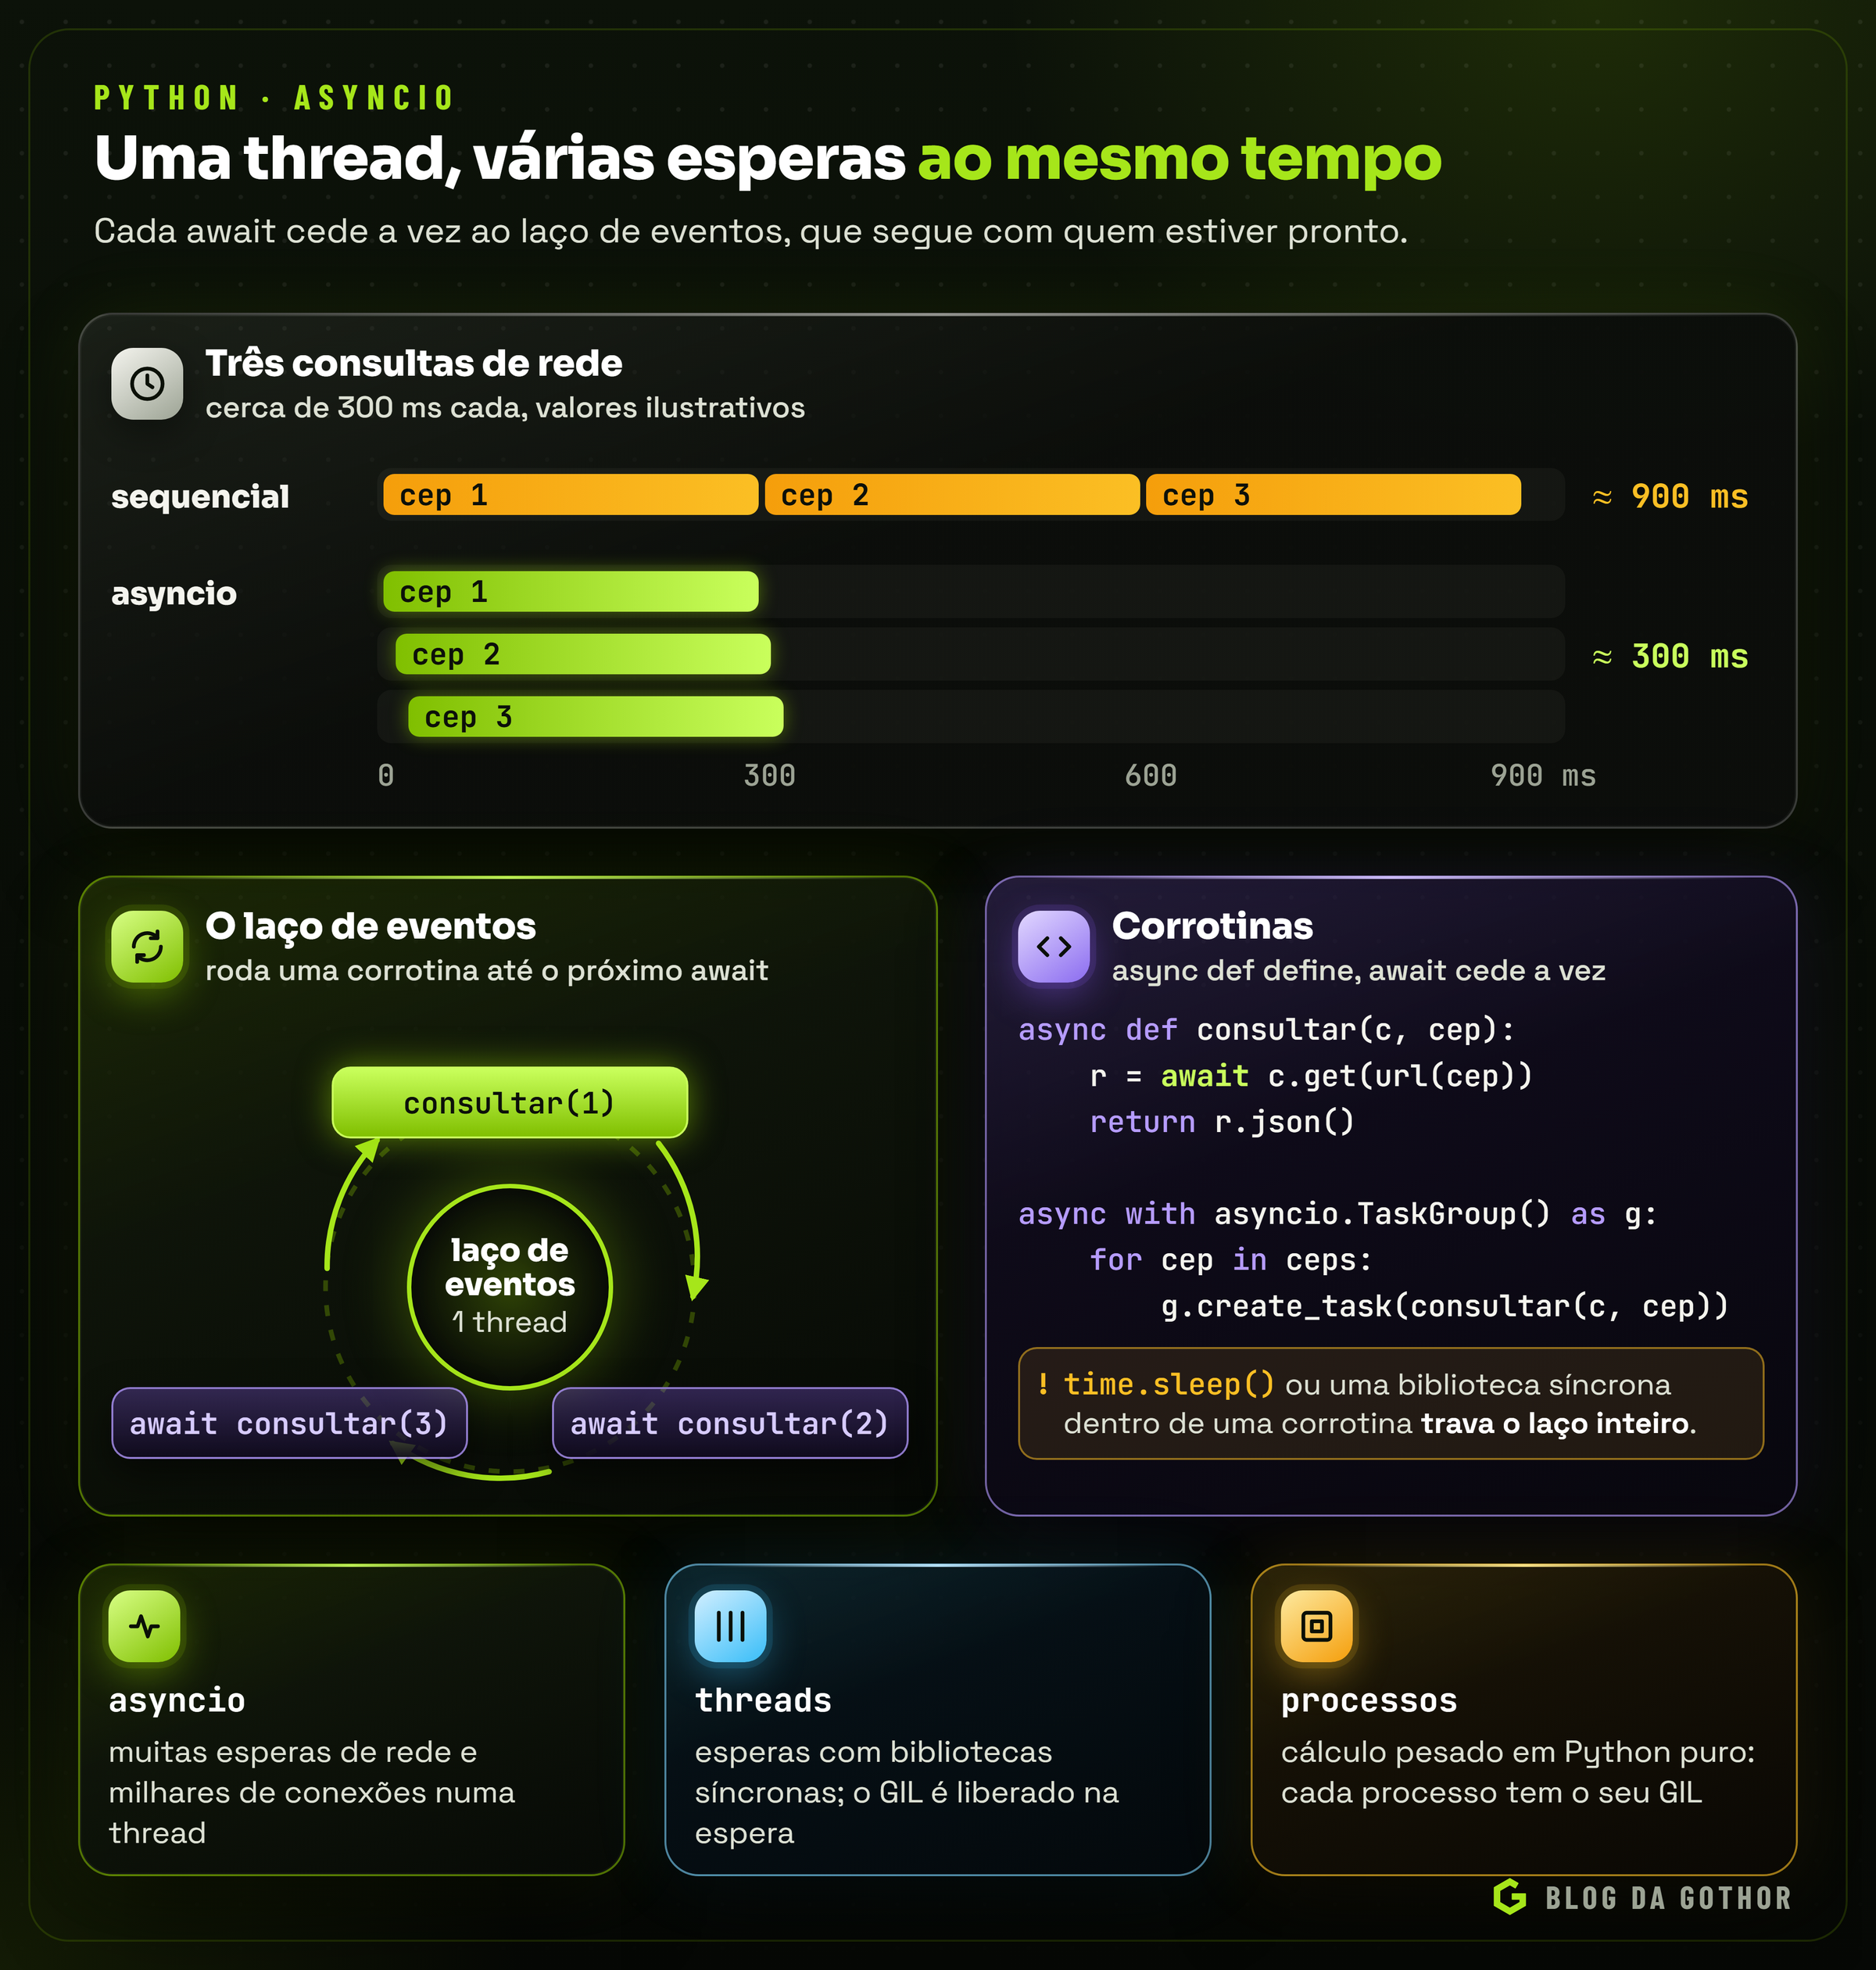
import asyncio
import httpx   # cliente HTTP com suporte a async, instalado à parte

async def consultar(cliente: httpx.AsyncClient, cep: str) -> dict:
    resposta = await cliente.get(f'https://api.exemplo.com.br/cep/{cep}')
    resposta.raise_for_status()
    return resposta.json()

async def principal():
    async with httpx.AsyncClient(timeout=10) as cliente:
        async with asyncio.TaskGroup() as grupo:
            tarefas = [grupo.create_task(consultar(cliente, c))
                       for c in ['78000000', '01000000', '20000000']]
    return [t.result() for t in tarefas]

asyncio.run(principal())
As três consultas esperam a rede ao mesmo tempo, e o tempo total fica próximo do da mais lenta, e não da soma das três. O TaskGroup, da versão 3.11, garante que, se uma tarefa falhar, as outras sejam canceladas e o erro chegue a quem chamou. O cuidado principal é o mesmo do JavaScript: uma chamada bloqueante dentro de uma corrotina, como um time.sleep ou uma biblioteca de rede síncrona, trava o laço inteiro.
Threads e processos na prática
Nem todo programa precisa do asyncio. Quando o código já usa bibliotecas síncronas e só quer fazer várias esperas ao mesmo tempo, um ThreadPoolExecutor, do módulo concurrent.futures, resolve em poucas linhas. Para cálculo pesado em Python puro, a mesma interface funciona com processos, cada um com o seu interpretador e o seu GIL, e os núcleos trabalham de fato em paralelo:
from concurrent.futures import ProcessPoolExecutor

def pontuar(cliente: dict) -> float:
    ...   # cálculo demorado em Python puro

if __name__ == '__main__':
    clientes = carregar_clientes()
    with ProcessPoolExecutor() as executor:
        notas = list(executor.map(pontuar, clientes, chunksize=500))
O if __name__ == '__main__': aqui é obrigatório: no Windows e no macOS, os processos filhos importam o módulo principal e, sem a proteção, tentariam criar os seus próprios filhos. E os argumentos e resultados viajam entre processos serializados: se cada tarefa é curta e os dados são grandes, a cópia custa mais que o cálculo, e o chunksize agrupa tarefas para reduzir essas viagens.
Os cuidados com o asyncio
O asyncio facilita fazer muitas coisas ao mesmo tempo, e por isso mesmo exige alguns limites:
limite = asyncio.Semaphore(10)          # no máximo 10 consultas simultâneas

async def consultar_com_limite(cliente, cep):
    async with limite:
        async with asyncio.timeout(5):  # desiste depois de 5 segundos (3.11+)
            return await consultar(cliente, cep)

async def importar():
    # código síncrono e demorado vai para uma thread, sem travar o laço
dados = await asyncio.to_thread(ler_planilha_grande, 'vendas.xlsx')- Limite a concorrência. Mil requisições de uma vez podem derrubar o serviço do outro lado; um
Semaphoredeixa passar só algumas por vez. - Toda espera precisa de prazo. Uma conexão que nunca responde segura a corrotina para sempre; o
asyncio.timeoutcancela a espera. - Mande o que bloqueia para fora do laço. O
asyncio.to_threadroda uma função síncrona numa thread e devolve algo que pode ser aguardado.
Desempenho: medir antes, otimizar depois
A fama de linguagem lenta é merecida para um tipo de código, o laço longo em Python puro, e enganosa para quase todo o resto. Na maioria dos programas reais, o tempo vai para esperar rede, disco e banco, ou para dentro de bibliotecas nativas. Por isso a primeira regra é medir.
O módulo timeit compara trechos pequenos, repetindo cada um muitas vezes:
python -m timeit -s "codigos = list(range(100_000))" "99_999 in codigos"
python -m timeit -s "codigos = set(range(100_000))"  "99_999 in codigos"
A primeira linha percorre a lista; a segunda consulta a tabela de dispersão, e a diferença costuma ser de milhares de vezes. Para programas inteiros, o cProfile mostra quanto tempo cada função consumiu, e o py-spy observa um processo em execução sem alterá-lo nem reiniciá-lo.
Na 3.15, as ferramentas de perfil ganharam um pacote próprio na biblioteca padrão, o profiling, da PEP 799. O profiling.tracing é o perfilador determinístico de sempre, que registra cada chamada de função e continua disponível com o nome antigo, cProfile. A novidade é o profiling.sampling, apelidado de Tachyon: em vez de registrar cada chamada, ele tira amostras da pilha do programa a frequências de até um milhão por segundo, com custo quase nulo para o programa observado. A diferença importa: o perfilador determinístico deixa o programa mais lento enquanto mede e pode distorcer o resultado em código com muitas chamadas pequenas, e a amostragem mostra o retrato do programa como ele roda de verdade. O antigo módulo profile, escrito em Python puro, foi declarado obsoleto e deve sair na 3.17.
Medido o gargalo, as opções seguem uma ordem de custo e benefício:
| Estratégia | Quando ajuda | Custo |
|---|---|---|
| Algoritmo e estrutura de dados certos | quase sempre: conjunto em vez de lista, dicionário em vez de busca linear | nenhum, só atenção |
| Funções embutidas e biblioteca padrão | sum, sorted, max, collections.Counter, todas em C | nenhum |
| Cache de resultados | cálculos repetidos com os mesmos argumentos | memória |
| Vetorização com NumPy, pandas ou Polars | operações sobre muitos números ou linhas | aprender a pensar em colunas |
| PyPy, Cython, mypyc | laços inevitáveis em Python | compatibilidade e etapa de compilação |
| Extensão em Rust ou C | o núcleo crítico de uma biblioteca | outra linguagem no projeto |
A vetorização merece um exemplo, porque é a otimização que mais transforma programas de dados:
import numpy as np

precos = np.random.default_rng(1).uniform(1, 100, 10_000_000)

# Python puro: o laço de avaliação roda dez milhões de vezes
total = 0.0
for p in precos.tolist():
    total += p * 1.1

# NumPy: um único laço em C sobre memória contígua
total = (precos * 1.1).sum()
As duas versões calculam a mesma coisa, mas a segunda costuma ser dezenas de vezes mais rápida, porque cada número não precisa virar um objeto Python nem passar pelo laço de avaliação.
Quando nada disso basta, o caminho moderno é escrever o núcleo crítico em Rust e expô-lo ao Python com o PyO3. É assim que nasceram o Polars, o Ruff, o uv e o núcleo do Pydantic.
Depurar sem adivinhar
Quando um script se comporta de forma inesperada, a tentação é espalhar print pelo código e rodar de novo. O Python oferece ferramentas melhores, e algumas delas funcionam até num processo que já está rodando em produção.
- **
breakpoint(), da 3.7, para a execução naquele ponto e abre o **pdb, o depurador da biblioteca padrão. Nele dá para ver variáveis, avançar linha a linha (n), entrar numa função (s), mostrar a pilha (w) e continuar (c). A variável de ambientePYTHONBREAKPOINTtroca o pdb por outro depurador, e com o valor0desliga todas as chamadas de uma vez, uma proteção contra obreakpoint()esquecido no código. - **
python -m pdb -p PID**, desde a 3.14, conecta o depurador a um processo Python em execução, sem pará-lo nem reiniciá-lo, pela interface de depuração externa da PEP 768. Onde isso não deve ser possível, a variávelPYTHON_DISABLE_REMOTE_DEBUGe a opção-X disable-remote-debugdesligam o recurso. - **
python -m asyncio ps PID** e **python -m asyncio pstree PID**, também da 3.14, mostram as tarefas de um programa asyncio em execução e quem espera quem. É o caminho para achar a corrotina presa num serviço que "parou de responder" sem dar erro. - **
faulthandler** imprime o rastreamento de todas as threads quando o processo sofre uma falha fatal, como um acesso inválido à memória dentro de uma extensão em C, caso em que o rastreamento normal do Python nem chega a aparecer. Liga-se compython -X faulthandler, e ofaulthandler.dump_traceback_laterimprime a pilha depois de um tempo limite, útil para descobrir onde um programa travou. - **
tracemalloc**, da 3.4, registra onde cada bloco de memória foi alocado. Duas fotografias comparadas mostram as linhas que mais acumularam memória entre elas, o caminho mais curto para um vazamento:
import tracemalloc

tracemalloc.start()
antes = tracemalloc.take_snapshot()
processar_lote()                         # a rotina suspeita
depois = tracemalloc.take_snapshot()
for linha in depois.compare_to(antes, 'lineno')[:5]:
    print(linha)                         # as cinco linhas que mais cresceram
Um vazamento em Python quase nunca é memória perdida, no sentido de C: é um objeto que continua alcançável sem que ninguém precise dele, como um cache em dicionário que só cresce ou uma lista global que recebe um item a cada requisição. O tracemalloc aponta a linha que alocou, e a correção costuma ser dar um limite ao cache, como o maxsize do functools.lru_cache, ou um ciclo de vida à estrutura.
Pacotes, ambientes e o ecossistema
Parte do sucesso do Python vem do PyPI (Python Package Index), o repositório público com centenas de milhares de pacotes. E boa parte da frustração de quem começa vem de instalá-los no lugar errado.
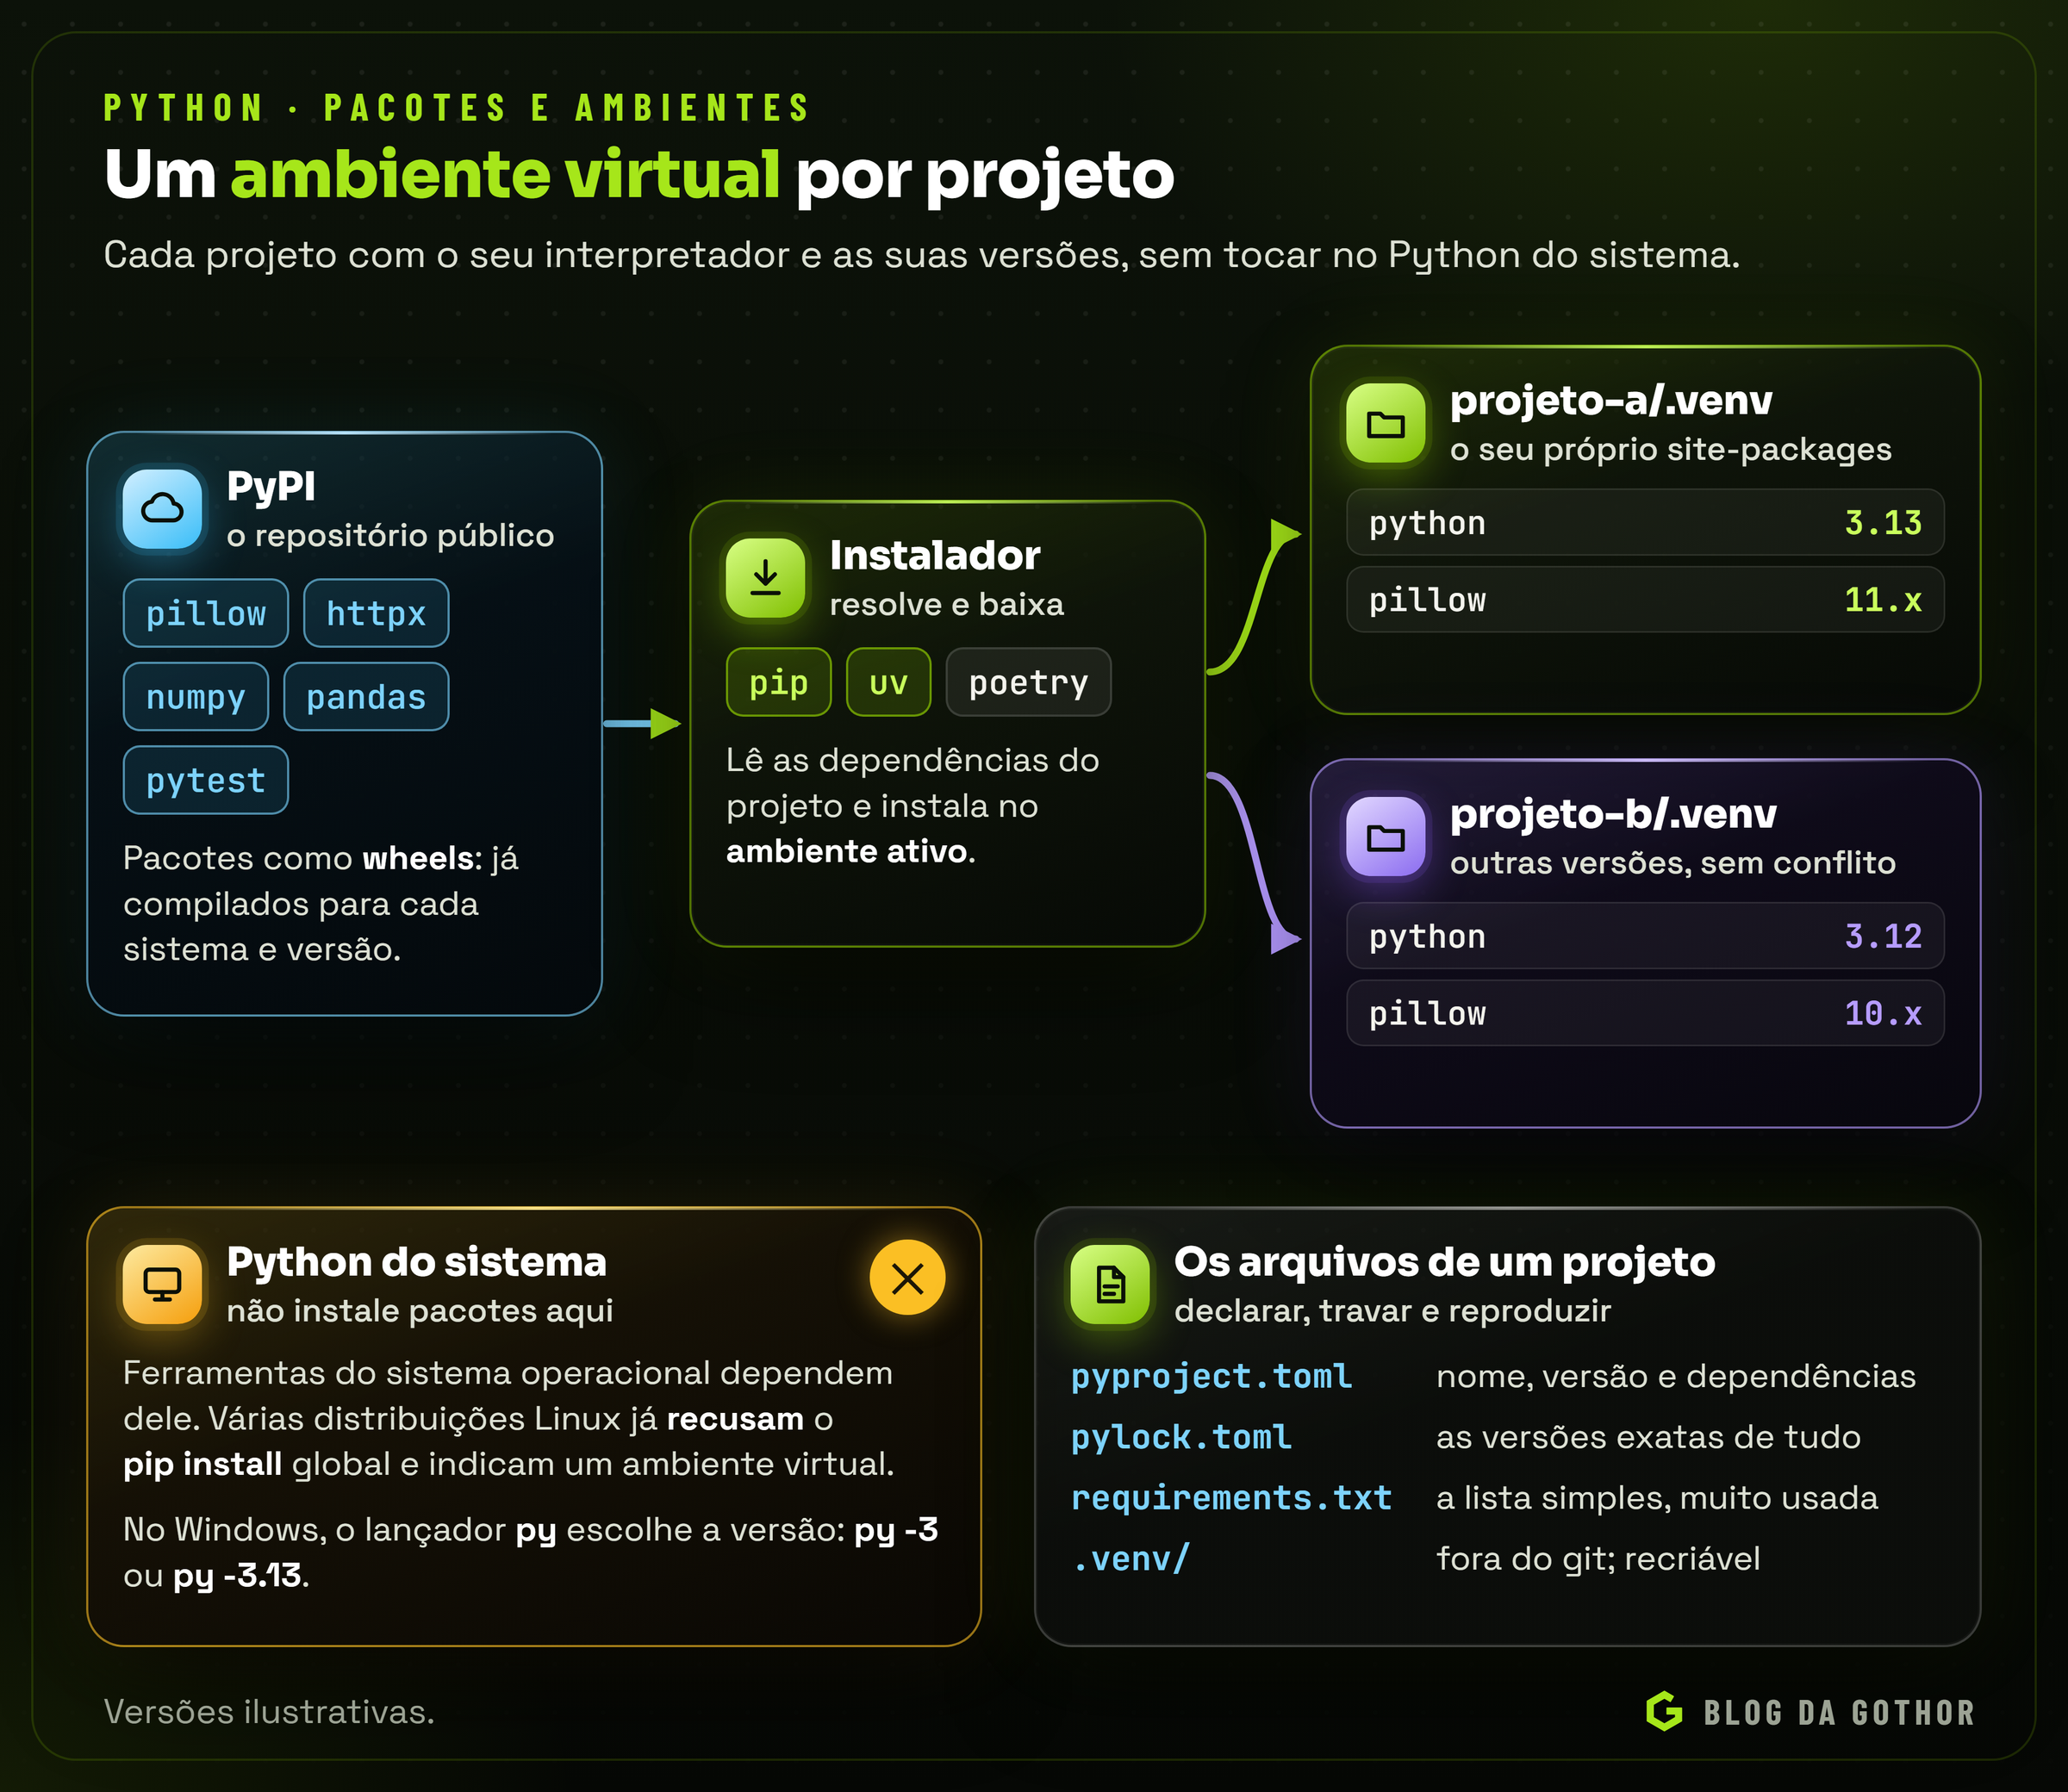
A regra de ouro é: um ambiente virtual por projeto. Um ambiente virtual, criado com o módulo venv da biblioteca padrão, é uma pasta com um interpretador e um diretório de pacotes próprios. Assim, o projeto A pode usar uma versão de uma biblioteca e o projeto B outra, sem conflito, e nada é instalado no Python do sistema:
python -m venv .venv
source .venv/bin/activate          # no Windows: .venv\Scripts\activate
python -m pip install pillow httpx
python -m pip freeze > requirements.txt
Algumas peças completam o quadro:
- pyproject.toml: o arquivo padrão de configuração de um projeto, com nome, versão, dependências e configuração das ferramentas.
- Wheels: pacotes já compilados para cada sistema e versão do Python, que instalam sem precisar de compilador.
- uv: um gerenciador de pacotes e ambientes escrito em Rust, muito mais rápido que o pip, que vem se tornando popular. Poetry e Hatch são alternativas, e o conda é comum em ciência de dados.
- Lockfiles: arquivos com as versões exatas de cada dependência, para builds reproduzíveis. Em 2025, a comunidade aprovou um formato padrão, o
pylock.toml.
Em várias distribuições Linux, o Python do sistema hoje se recusa a instalar pacotes globalmente com pip, justamente para empurrar todo mundo para os ambientes virtuais. No Windows, o lançador py escolhe a versão instalada (py -3, py -3.13).
O que acontece num pip install
Instalar um pacote envolve mais etapas do que parece:
- Resolver as versões. O instalador procura uma combinação de versões que satisfaça as restrições de todas as dependências, diretas e indiretas. Quando duas bibliotecas exigem versões incompatíveis de uma terceira, aparece o erro de conflito.
- Escolher o arquivo. Um wheel tem no nome as etiquetas de compatibilidade, como
cp312(CPython 3.12) emanylinux_2_17_x86_64(Linux de 64 bits). Sem wheel compatível, o instalador baixa o código-fonte e tenta compilá-lo, a origem de muitos erros de instalação no Windows. - Instalar. O wheel é um arquivo zip, descompactado no
site-packagesdo ambiente, com os executáveis declarados pelo pacote, como o comandopytest.
O uv faz as mesmas etapas em paralelo, com cache compartilhado entre projetos, e ainda instala as versões do Python. Um projeto pequeno se declara assim:
[project]
name = "conciliador"
version = "1.4.0"
requires-python = ">=3.12"
dependencies = ["pandas>=2.2", "openpyxl>=3.1"]

[project.scripts]
conciliar = "conciliador.cli:principal"   # cria o comando "conciliar"
As dependências usam limites mínimos, e as versões exatas ficam no lockfile; o project.scripts transforma uma função num comando de terminal.
Scripts de um arquivo, com as dependências dentro
Muitos scripts de empresa vivem sozinhos: um arquivo .py que alguém roda toda semana. Criar um projeto inteiro, com pyproject.toml e ambiente virtual, para um arquivo só parece exagero, e o resultado comum é um script que funciona apenas na máquina de quem o escreveu, porque ninguém sabe o que precisa ser instalado. A PEP 723, aprovada em janeiro de 2024 e hoje mantida como especificação de empacotamento, resolve isso com um bloco de comentários em TOML no próprio script:
# /// script
# requires-python = ">=3.12"
# dependencies = [
#   "pandas>=2.2",
#   "openpyxl>=3.1",
# ]
# ///

import pandas as pd

...
Para o interpretador, o bloco é só um comentário. As ferramentas compatíveis o leem: o uv run relatorio.py, por exemplo, cria automaticamente um ambiente com essas dependências e executa o script nele, e o uv add --script acrescenta dependências ao bloco. O script passa a carregar a própria receita, e qualquer pessoa da equipe consegue rodá-lo sem perguntar o que instalar.
Segurança
A facilidade do Python também facilita alguns erros de segurança. Os mais comuns têm correção simples:
- **Nunca use
picklecom dados de fora.** Opickleserializa objetos Python arbitrários, e desserializar um arquivo malicioso pode executar qualquer código. Para trocar dados com o mundo, use JSON ou outro formato que só descreve dados. - **
evaleexeccom texto do usuário executam código do usuário.** Para converter texto em número ou em estruturas simples, useint(),Decimal()ouast.literal_eval, que só aceita literais. - SQL sempre com parâmetros. Montar a consulta com f-string abre espaço para injeção de SQL; o driver do banco escapa os valores quando eles vão separados.
- Subprocessos sem shell.
subprocess.runcom uma lista de argumentos passa cada um literalmente ao programa; comshell=Truee texto montado, um nome de arquivo malicioso vira um comando. - **Tokens e senhas com
secrets, não comrandom.** Orandomé previsível por desenho; osecretsusa a fonte criptográfica do sistema. - Arquivos compactados com filtro. Um
.tarcom caminhos../../pode gravar fora da pasta de destino; o filtro'data'dotarfile, padrão desde a 3.14, bloqueia esses casos.
# SQL: o valor vai separado da consulta
cursor.execute('SELECT nome FROM clientes WHERE cnpj = ?', (cnpj,))

# subprocesso: lista de argumentos, sem shell
subprocess.run(['pg_dump', '--dbname', banco, '--file', destino], check=True)
Há também a cadeia de suprimentos. O PyPI já recebeu pacotes maliciosos com nomes parecidos com os de bibliotecas populares, apostando num erro de digitação (typosquatting). As defesas são conferir o nome antes de adicionar uma dependência, travar as versões com os hashes de cada arquivo e rodar o pip-audit na integração contínua para achar versões com vulnerabilidades conhecidas. E senhas e chaves de API vêm de variáveis de ambiente ou de um cofre, nunca do código nem dos registros.
Template strings: o texto e os valores separados
As f-strings resolvem tudo na hora: f'... {nome}' vira um str pronto, e quem recebe esse texto não tem mais como saber qual parte foi escrita pelo programador e qual veio do usuário. É exatamente isso que torna perigoso montar SQL ou HTML com elas. A 3.14 trouxe as template strings, da PEP 750: com o prefixo t no lugar do f, a expressão não vira texto, e sim um objeto Template, do módulo string.templatelib, que guarda separadamente as partes fixas e os valores interpolados.
from html import escape
from string.templatelib import Interpolation, Template
def html_seguro(modelo: Template) -> str:
partes = []
for parte in modelo:
if isinstance(parte, Interpolation):
partes.append(escape(str(parte.value))) # só os valores são escapados
else:
partes.append(parte) # o texto fixo é do programador
return ''.join(partes)
nome = '<script>alert(1)</script>'
html_seguro(t'<p>Olá, {nome}</p>') # '<p>Olá, <script>alert(1)</script></p>'A sintaxe é a mesma das f-strings, mas quem decide o que fazer com cada valor é a função que recebe o modelo. Com isso, uma biblioteca de banco de dados pode aceitar um Template e enviar cada valor como parâmetro, e uma de HTML pode escapar cada valor, com a mesma comodidade de escrita das f-strings e sem a porta para injeção. A adoção depende das bibliotecas, e até lá os parâmetros separados do exemplo de SQL continuam sendo o caminho.
Onde o Python brilha
- Dados: NumPy para matrizes e cálculo numérico, pandas e Polars para tabelas, Matplotlib para gráficos e o Jupyter para cadernos interativos que misturam código, resultados e texto.
- Inteligência artificial: PyTorch, TensorFlow, JAX, scikit-learn e as bibliotecas da Hugging Face. A pesquisa em IA é escrita quase toda em Python, e os modelos costumam ser publicados primeiro para ele.
- Web e APIs: Django, com tudo incluído; Flask, minimalista; e FastAPI, que usa as anotações de tipo para validar requisições e gerar a documentação da API.
- Automação e scripts: manipular arquivos, planilhas, imagens e PDFs, chamar APIs, agendar rotinas. A biblioteca padrão já cobre boa parte disso.
- Ensino: a sintaxe enxuta faz do Python a primeira linguagem de muitos cursos.
Um padrão atravessa todas essas áreas: Python como cola. A parte pesada (álgebra linear, redes neurais, decodificação de imagens) roda em C, C++, Fortran ou Rust, e o Python oferece uma interface agradável por cima. É por isso que uma linguagem considerada lenta domina justamente as áreas que mais exigem desempenho.
Python no dia a dia de uma empresa
Longe da pesquisa em IA, o uso mais comum do Python numa empresa é o mais discreto: tirar do caminho as tarefas repetitivas feitas toda semana com planilhas, como neste exemplo que qualquer financeiro reconhece.
Um exemplo passo a passo: conciliar o extrato com os títulos
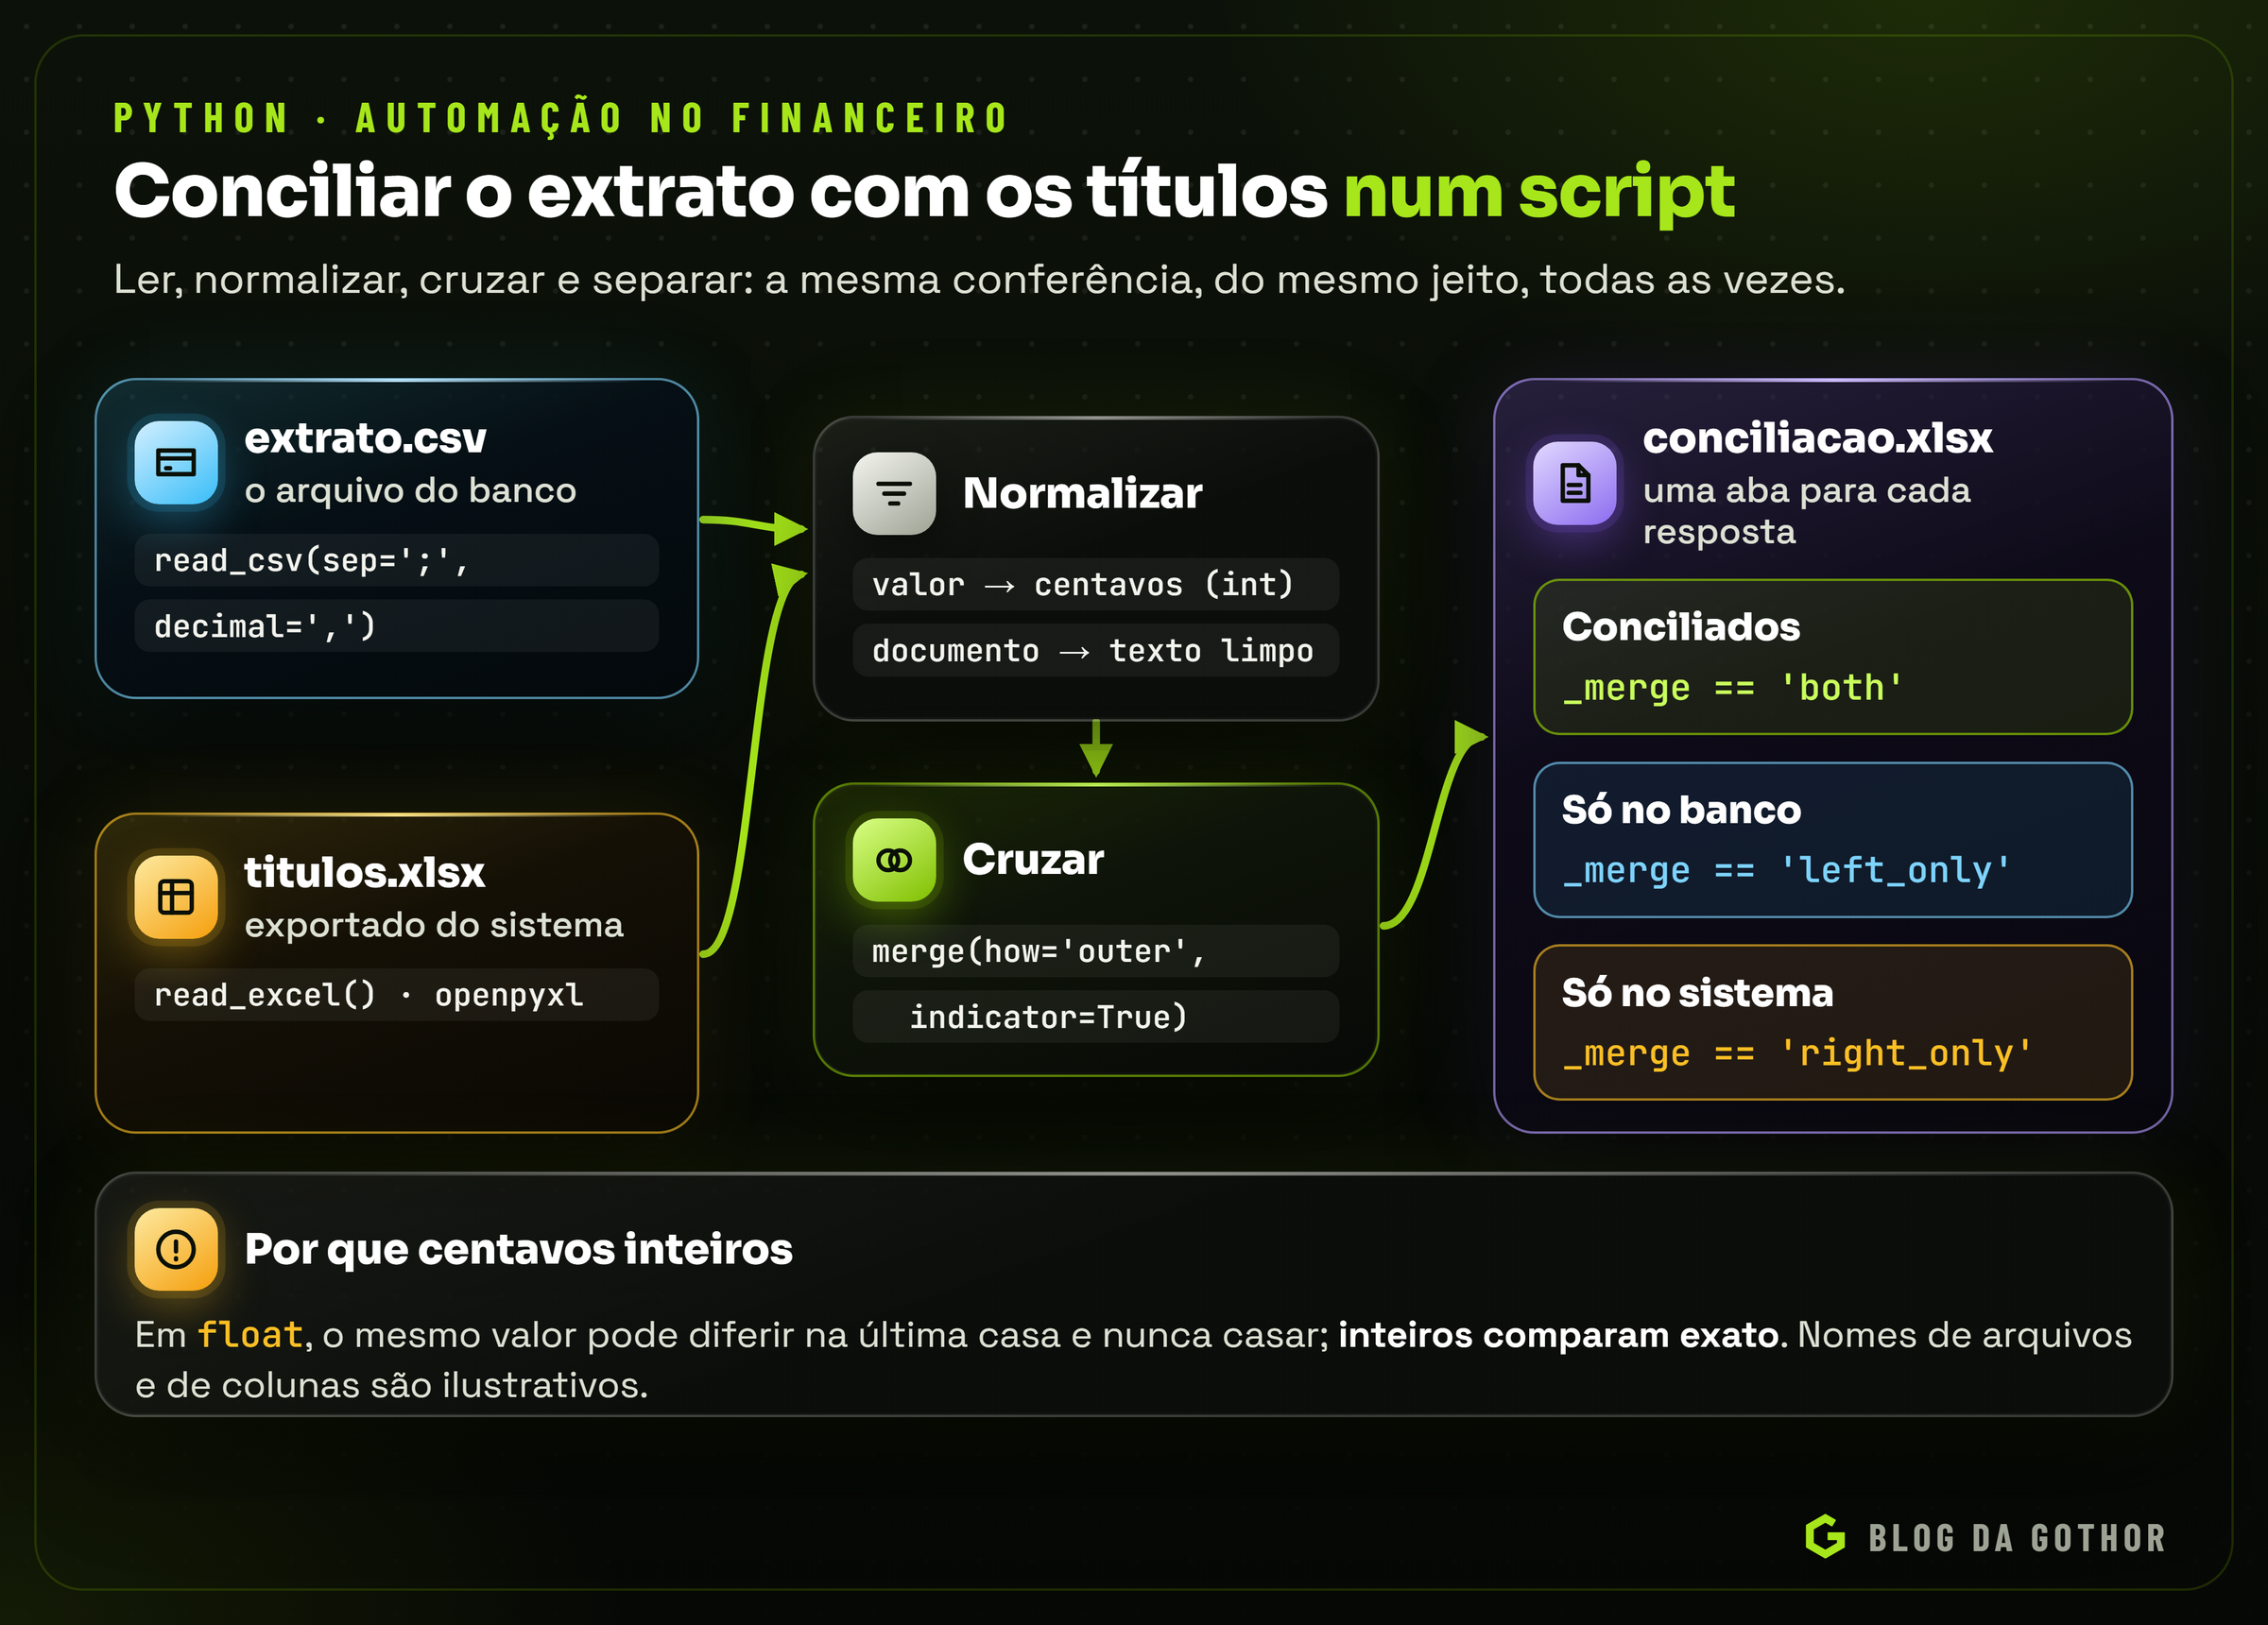
O banco entrega o extrato em CSV, o sistema de gestão exporta os títulos a receber em Excel, e alguém precisa descobrir quais pagamentos casam com quais títulos, o que entrou no banco sem título e o que o sistema espera sem ter aparecido no banco.
import pandas as pd

# 1. ler as duas fontes, cada uma no seu formato
extrato = pd.read_csv('extrato.csv', sep=';', decimal=',', encoding='utf-8',
                      parse_dates=['data'], dayfirst=True)
titulos = pd.read_excel('titulos_a_receber.xlsx')     # usa o openpyxl por baixo

# 2. normalizar: dinheiro em centavos inteiros, documento como texto limpo
for tabela in (extrato, titulos):
    tabela['centavos'] = (tabela['valor'] * 100).round().astype(int)
    tabela['documento'] = tabela['documento'].astype(str).str.strip()

# 3. cruzar pelas duas chaves, mantendo o que sobrou dos dois lados
cruzado = extrato.merge(titulos, on=['documento', 'centavos'],
                        how='outer', indicator=True, suffixes=('_banco', '_sistema'))

# 4. separar o resultado
conciliados = cruzado[cruzado['_merge'] == 'both']
so_no_banco = cruzado[cruzado['_merge'] == 'left_only']
so_no_sistema = cruzado[cruzado['_merge'] == 'right_only']

# 5. gravar uma planilha com uma aba para cada grupo
with pd.ExcelWriter('conciliacao.xlsx') as planilha:
    conciliados.to_excel(planilha, sheet_name='Conciliados', index=False)
    so_no_banco.to_excel(planilha, sheet_name='Só no banco', index=False)
    so_no_sistema.to_excel(planilha, sheet_name='Só no sistema', index=False)
O que cada passo resolve:
- Ler cada fonte no seu formato. O extrato brasileiro costuma vir com ponto e vírgula como separador, vírgula decimal e o dia primeiro nas datas; dizer isso ao pandas evita que 03/04 vire 4 de março.
- Normalizar antes de comparar. Valores em
floatpodem diferir na última casa; centavos inteiros eliminam o problema. Documentos de planilhas chegam ora como número, ora como texto com espaços; padronizar evita falsos desencontros. - **Cruzar com
how='outer'.** A junção externa mantém as linhas sem par dos dois lados, e oindicator=Truecria a coluna_merge, que diz de onde cada linha veio. - Separar e gravar os três resultados, que são exatamente as três perguntas do problema, numa planilha comum que qualquer pessoa abre e confere.
Um script assim substitui horas de procura manual e faz a mesma conferência do mesmo jeito todas as vezes. Na vida real, ele cresce com casos que só os dados revelam, como pagamentos em duplicidade e tarifas descontadas do valor, e cada caso vira uma regra explícita e testável no código.
O mesmo raciocínio vale para relatórios recorrentes agendados pelo cron ou pelo Agendador de Tarefas do Windows, para integrações entre sistemas por API e para arquivos tratados em lote com pathlib e shutil. E um script que roda toda semana é um sistema, mesmo que tenha trinta linhas: merece controle de versão, dependências declaradas, registro do que fez e erros tratados de forma explícita.
Testes: a rede de proteção do script
O script de conciliação tem uma regra crítica escondida numa linha: a conversão dos valores em centavos. Se alguém mexer nela daqui a seis meses, para tratar um formato novo de extrato, como saber que os formatos antigos continuam funcionando? A resposta é um teste automatizado, e o padrão de fato da comunidade para isso é o pytest.
O primeiro passo é tirar a regra de dentro do fluxo e dar a ela um nome, numa função que se possa testar sozinha:
# conciliacao.py
from decimal import Decimal, InvalidOperation, ROUND_HALF_UP

def para_centavos(texto: str) -> int:
    """Converte '1.234,56' em 123456."""
    try:
        valor = Decimal(texto.strip().replace('.', '').replace(',', '.'))
    except InvalidOperation:
        raise ValueError(f'valor inválido: {texto!r}') from None
    return int((valor * 100).quantize(Decimal('1'), rounding=ROUND_HALF_UP))
O pytest tira a cerimônia da escrita dos testes. Um teste é uma função cujo nome começa com test_, num arquivo que também começa com test_, e a verificação é o assert comum da linguagem:
# test_conciliacao.py
import pytest
from conciliacao import para_centavos

@pytest.mark.parametrize('texto, esperado', [
    ('10,50', 1050),
    ('1.234,56', 123456),
    ('0,1', 10),
    (' 89,90 ', 8990),
])
def test_para_centavos(texto, esperado):
    assert para_centavos(texto) == esperado

def test_valor_invalido():
    with pytest.raises(ValueError, match='valor inválido'):
        para_centavos('dez reais')

@pytest.fixture
def extrato(tmp_path):
    caminho = tmp_path / 'extrato.csv'
    caminho.write_text('data;documento;valor\n20/10/2026;123;89,90\n', encoding='utf-8')
    return caminho

def test_le_o_extrato(extrato):
    ...   # chama a leitura com um arquivo pequeno e conhecido
Três recursos fazem a diferença nesse exemplo:
- **O
assertreescrito.** Antes de executar os módulos de teste, o pytest reescreve cadaassertno momento da importação, por um gancho do sistema de importação visto no começo deste artigo. Quando um teste falha, a mensagem mostra os valores dos dois lados da comparação, sem nenhum método especial de verificação. - A parametrização. O
parametrizeroda o mesmo teste para cada linha da tabela, e cada linha aparece como um teste separado no relatório. Um formato novo de extrato vira uma linha nova, e os casos antigos continuam sendo conferidos a cada execução. - As fixtures. Uma fixture é uma função que prepara o que o teste precisa, e o teste a pede pelo nome do argumento. O
tmp_path, uma fixture que já vem com o pytest, entrega uma pasta temporária nova para cada teste, e o exemplo a usa para criar um extrato pequeno e conhecido. Uma fixture que usayieldno lugar dereturnexecuta a limpeza depois doyield, quando o teste termina, e oscopedefine quanto tempo ela vive: por teste, por módulo ou pela sessão inteira, o que permite, por exemplo, abrir uma conexão de banco de testes uma vez só. As fixtures comuns a vários arquivos ficam numconftest.py, que o pytest encontra sozinho.
O pytest.raises com match completa o quadro: confere que a exceção certa foi lançada e que a mensagem contém o texto esperado, procurado como expressão regular. Um bom conjunto de testes para um script como esse não precisa ser grande. Os casos que já deram problema e os que a regra de negócio descreve costumam bastar, e cada erro encontrado em produção vira um caso novo na tabela, para nunca mais voltar.
Python e as outras linguagens
Nenhuma linguagem é a melhor para tudo. Uma comparação com as que aparecem com mais frequência ao lado do Python ajuda a escolher:
| Aspecto | Python | JavaScript e TypeScript | Go | Rust |
|---|---|---|---|---|
| Tipagem | dinâmica e forte, com anotações opcionais | dinâmica e fraca; estática com TypeScript | estática | estática e rigorosa |
| Execução | bytecode numa máquina virtual | compilação em tempo de execução nos motores | binário nativo | binário nativo |
| Concorrência | asyncio, threads limitadas pelo GIL, processos | event loop numa thread | goroutines leves | threads e async sem coletor de lixo |
| Ponto forte | dados, IA, automação, prototipação | web, do navegador ao servidor | serviços de rede simples e rápidos | desempenho e segurança de memória |
Na prática, é comum que um mesmo sistema use várias: Python para a análise e os modelos, TypeScript para a interface e as APIs, Rust ou Go para o serviço que precisa de cada milissegundo. A pergunta útil não é "qual linguagem é melhor", e sim "qual ecossistema já resolve bem este problema".
Erros comuns
- Argumento padrão mutável. Em
def adicionar(item, lista=[]), a lista é criada uma vez, quando a função é definida, e compartilhada entre todas as chamadas. Uselista=Nonee crie a lista dentro da função. - Achar que atribuir é copiar.
b = afaz dois nomes apontarem para o mesmo objeto. Para listas e dicionários aninhados, usecopy.deepcopy. - **Dinheiro em
float.**0.1 + 0.2também dá0.30000000000000004em Python. Usedecimal.Decimalou centavos inteiros. - **
except:sem tipo.** Captura tudo, até o Ctrl+C, e esconde erros. Capture as exceções que você sabe tratar. - Instalar pacotes no Python do sistema em vez de num ambiente virtual.
- Bloquear o laço do asyncio com chamadas síncronas dentro de corrotinas.
- Laços pesados em Python puro sobre milhões de itens, quando uma operação vetorizada do NumPy ou do pandas resolveria em código nativo.
- **Abrir arquivos sem
encoding.** Até a 3.14, o padrão dependia do sistema, e no Windows um CSV com acentos podia ser lido errado; desde a 3.15, o padrão é UTF-8, o que também pode estragar a leitura de um arquivo gravado emcp1252. Informe sempre a codificação do arquivo. - **
Decimalcriado a partir defloat.**Decimal(0.1)carrega o erro binário dofloat. Crie a partir de texto,Decimal('0.1'), e defina o arredondamento comquantize. - **Nome solto num
case.**case PAGO:captura o valor em vez de compará-lo. Use constantes com ponto no nome, comoSituacao.PAGO, ou literais. - Closures em laços que "lembram" o último valor. Em
[lambda: i for i in range(3)], as três funções devolvem2, porque a closure guarda a variável, e não o valor do momento. Fixe o valor com um argumento padrão:lambda i=i: i. - Alterar uma lista enquanto a percorre. Remover itens dentro de um
forsobre a mesma lista faz o laço pular elementos, porque os índices mudam debaixo dele. Monte uma lista nova com uma compreensão ou percorra uma cópia. - Datas sem fuso. Um
datetime.now()sem fuso é ambíguo quando o servidor está em outro fuso. Usedatetime.now(ZoneInfo('America/Cuiaba'))ou trabalhe em UTC e converta só na exibição.
Boas práticas
- Siga a PEP 8, as convenções de estilo da comunidade, e deixe um formatador e um analisador automáticos cuidarem disso. O Ruff faz os dois e é muito rápido.
- Use type hints em funções públicas e confira com mypy ou Pyright na integração contínua.
- Um ambiente virtual por projeto, dependências declaradas no
pyproject.tomle versões travadas num lockfile. - Escreva testes com o pytest, o padrão de fato da comunidade.
- Prefira a biblioteca padrão quando ela resolve:
pathlibpara caminhos,datetimecom fuso para datas,csv,json,loggingesubprocesscobrem muita coisa. - Valide dados externos com esquemas, como os do Pydantic, em vez de confiar no formato.
- Meça antes de otimizar: o
cProfilemostra onde o tempo é gasto, e a resposta raramente é a que você imagina. - Use o
loggingem vez deprintem qualquer coisa que rode sem ninguém olhando: ele registra a hora, o nível e o rastreamento completo de um erro. - Leia o Zen do Python, digitando
import thisno terminal: "legibilidade conta" e "explícito é melhor que implícito" resumem bem a cultura da linguagem.
Perguntas frequentes
O Python é lento demais para produção? Para a maioria das aplicações, não. Ele é lento em laços longos de Python puro, e para esses casos existem a vetorização, os processos e as extensões nativas. O que costuma limitar um sistema é o banco de dados, a rede e o desenho, e não a linguagem.
Qual versão usar? A mais nova que as suas dependências suportam. Uma regra prática é adotar a versão de outubro alguns meses depois, quando as bibliotecas principais já publicaram wheels para ela.
Preciso usar type hints? Um script de vinte linhas vive bem sem eles. Em projetos que crescem, as anotações pagam o investimento rapidamente: o editor passa a ajudar de verdade, e o verificador encontra erros antes de o código rodar.
Python serve para aplicativos de celular e de computador? Serve, com projetos como o Kivy e o BeeWare, mas não é onde ele é mais forte: para apps, Flutter, Swift e Kotlin costumam ser escolhas mais naturais.
Python substitui o Excel? Substitui as tarefas repetitivas feitas no Excel, não o Excel. A combinação mais produtiva costuma ser o Python fazendo a leitura, o cruzamento e a limpeza, e entregando o resultado numa planilha que a equipe já sabe usar, como no exemplo da conciliação.
Como usamos Python na Gothor
Na Gothor, o Python aparece onde ele é mais forte: scripts de automação e de tratamento de dados e de imagens, em que a biblioteca padrão e o ecossistema resolvem em poucas linhas o que levaria muito mais em outra linguagem. As práticas deste artigo valem aí também: scripts pequenos e legíveis, que usam o que a biblioteca padrão já oferece antes de buscar uma dependência nova.
Resumo
- Python é dinâmico, de tipagem forte, multiparadigma e com uma biblioteca padrão extensa; o CPython é a implementação de referência.
- O CPython compila o código para bytecode, guarda em
.pyce o executa num laço de avaliação com especialização adaptativa; umimportexecuta cada módulo uma única vez. - A memória é gerenciada por contagem de referências, com um coletor para ciclos; o GIL deixa uma thread executar bytecode por vez, não protege a lógica do programa, e a versão free-threaded o remove.
- Tudo é objeto, e variáveis são nomes que apontam para objetos; o modelo de dados permite que classes próprias funcionem com
len,forewith. - Texto é
stre bytes sãobytes, com a codificação como ponte; dinheiro vai emDecimalcriado a partir de texto, e datas são guardadas em UTC, com fuso. - Type hints não são conferidas em execução; mypy e Pyright verificam, e o Pydantic valida dados externos na fronteira.
- Use asyncio ou threads para esperas de entrada e saída, processos para CPU em Python puro e bibliotecas nativas para cálculo numérico, sempre com limites e prazos.
- Meça antes de otimizar: estrutura de dados certa e vetorização resolvem a maior parte dos problemas de desempenho;
breakpoint(),tracemalloce os perfiladores mostram o que acontece em vez de deixar adivinhar. - Testes com o pytest, com parametrização e fixtures, protegem as regras de um script contra mudanças futuras.
- Um ambiente virtual por projeto, dependências no
pyproject.tomle versões travadas com hash evitam a maior parte dos problemas de instalação e de cadeia de suprimentos. pickle,eval, SQL montado com texto eshell=Truesão as portas mais comuns para falhas de segurança.
Para ir além
- Documentação oficial do Python, o ponto de partida do item no Wisdom, e o tutorial oficial em português.
- O modelo de dados, o sistema de importação e o módulo dis, na referência da linguagem.
- asyncio, concurrent.futures e o texto oficial sobre Python sem GIL.
- Documentação de empacotamento do Python e o módulo venv.
- PEP 8, as convenções de estilo, PEP 20, o Zen do Python, e o índice das PEPs.
- Novidades de cada versão, com as notas da 3.14 e da 3.15.
- PEP 634, a correspondência de padrões, PEP 750, as template strings, PEP 810, as importações preguiçosas e PEP 723, os metadados dentro do script.
- Os módulos decimal, datetime, zoneinfo, gc e tracemalloc, na documentação oficial.
- Documentação do pytest, do pandas e do Pydantic.
- Documentação do Pillow, a biblioteca de imagens mais usada em Python.
- Documentação do mypy e do uv.
Este post foi escrito com a ajuda da Juniper, a assistente de IA da Gothor, e revisado pela nossa equipe antes de ir ao ar.