HTTP por dentro: o protocolo que faz a web conversar
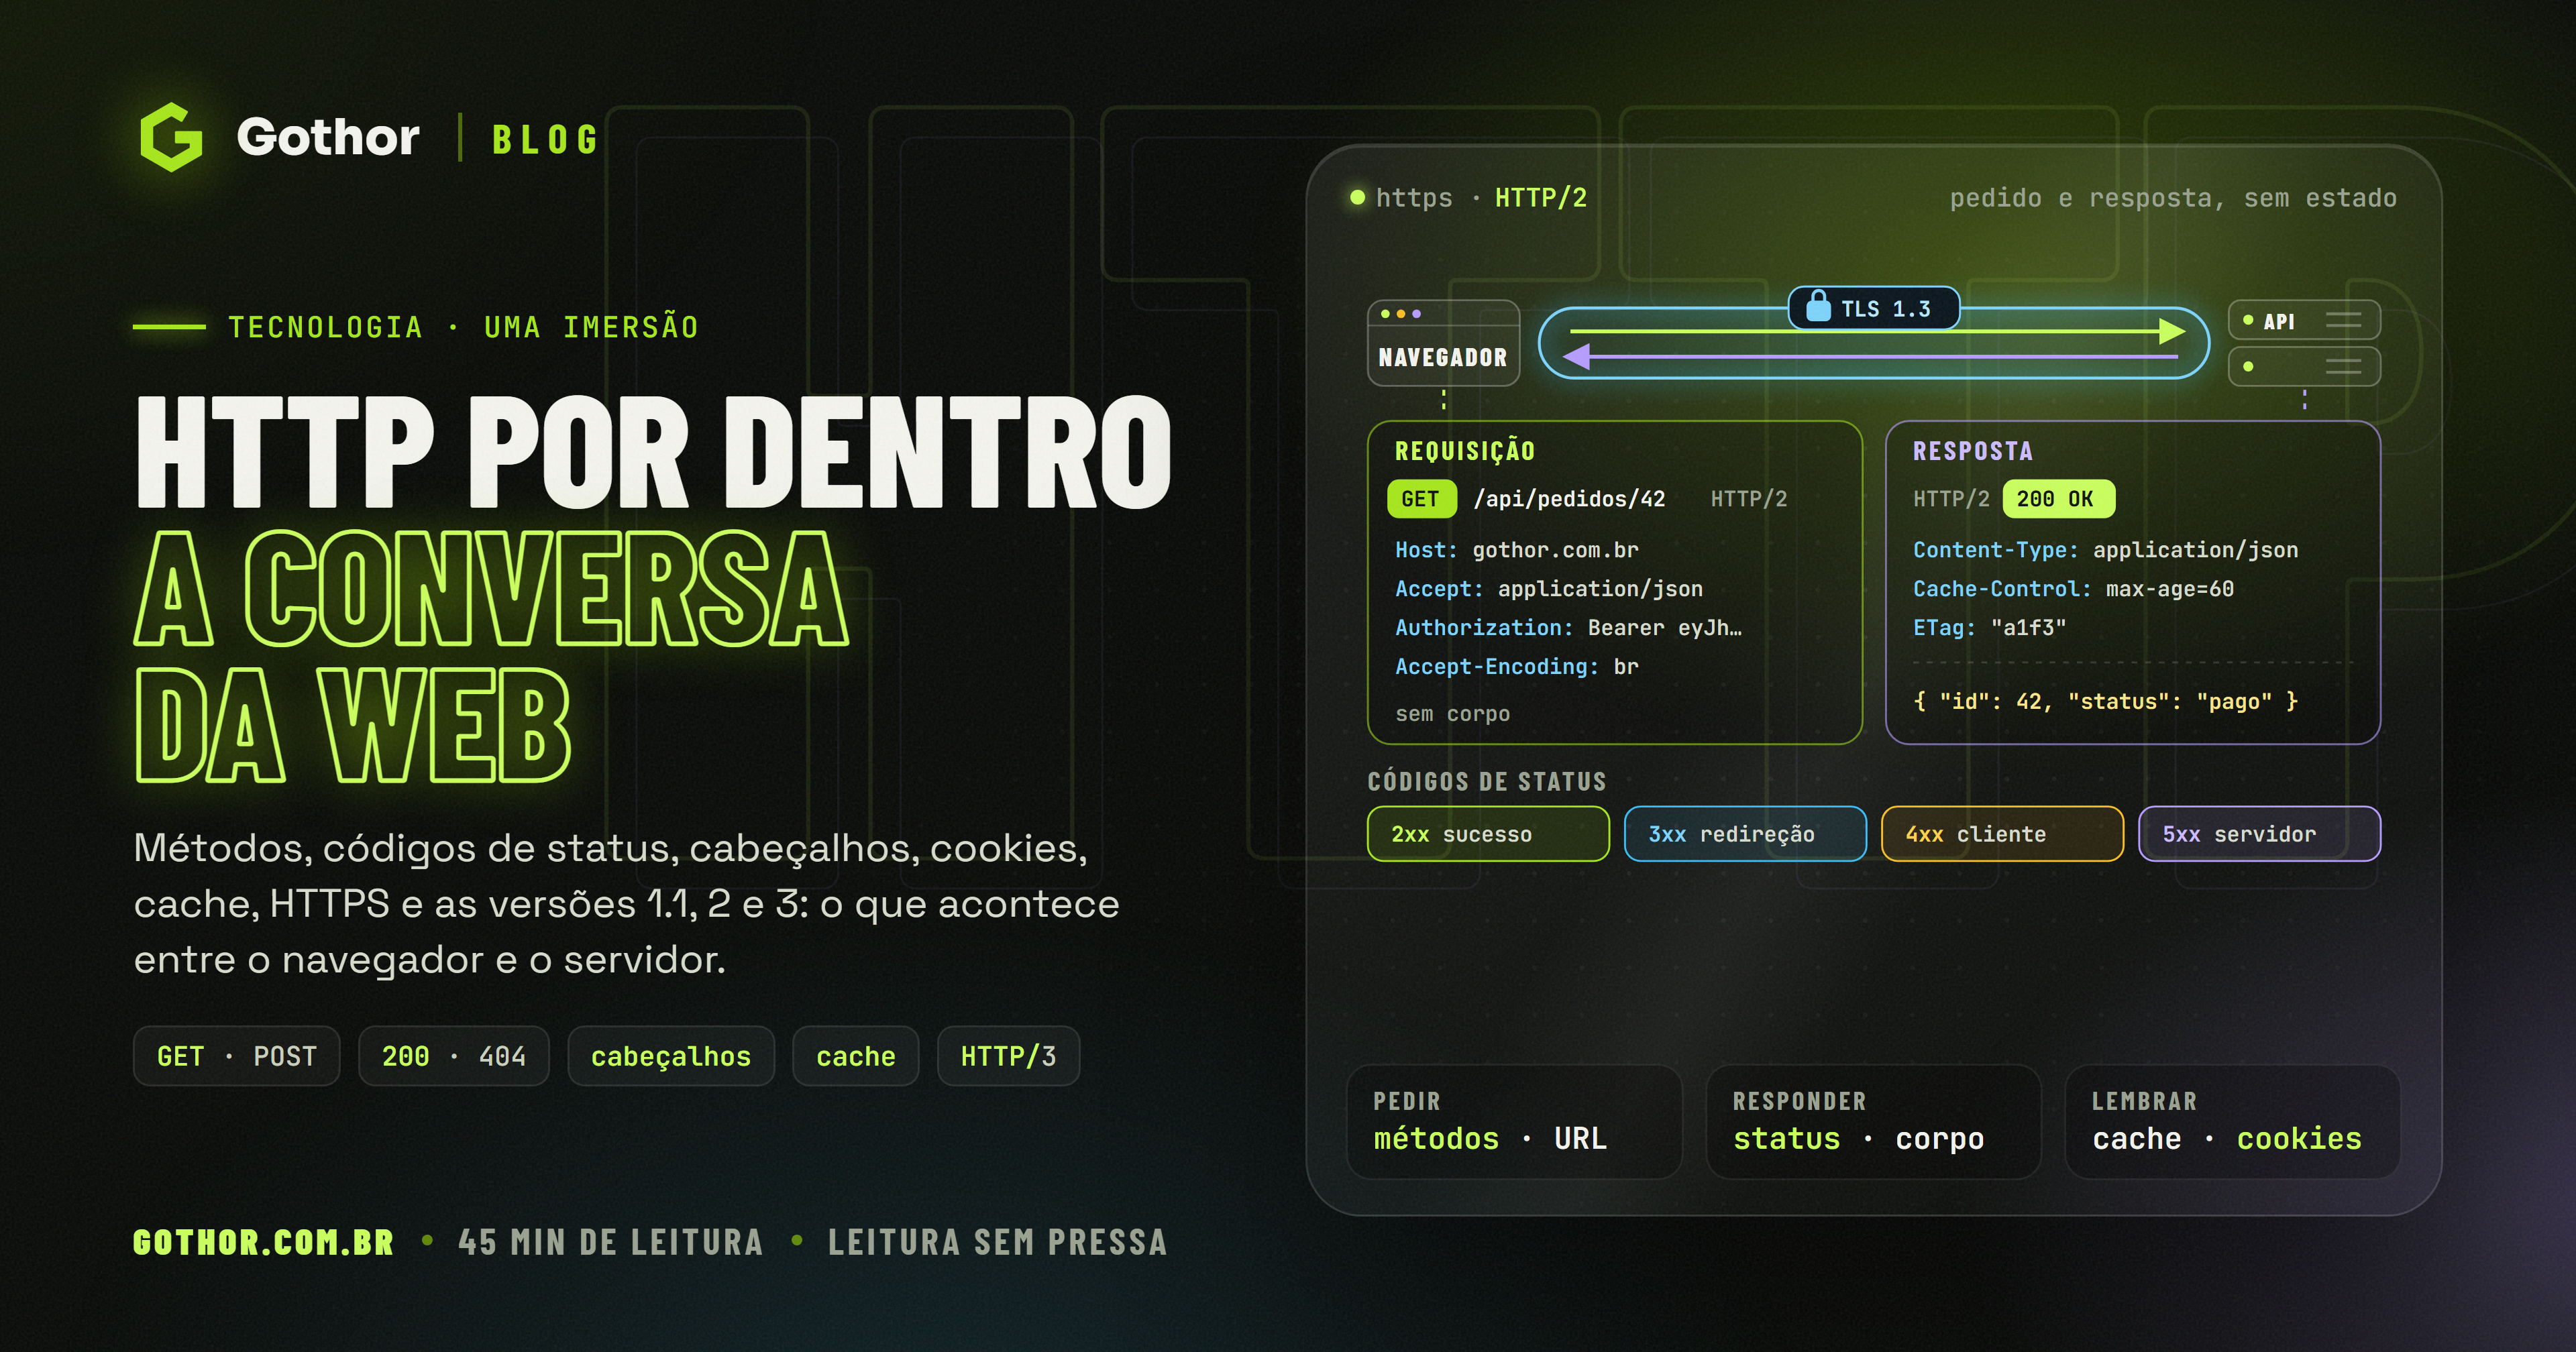
Uma imersão no protocolo da web, de dentro para fora. Métodos, códigos de status, cabeçalhos, cookies, cache, HTTPS, respostas em fluxo e as versões 1.1, 2 e 3, com exemplos, erros comuns e o jeito como usamos HTTP na Gothor.
Cada vez que você abre uma página, o navegador faz dezenas de pedidos: o HTML, as folhas de estilo, os scripts, as imagens, as fontes, os dados que aparecem na tela. Cada vez que um aplicativo de celular mostra o saldo de uma conta ou um sistema de gestão consulta um pedido, acontece a mesma coisa. Quase todos esses pedidos falam a mesma língua: o HTTP.
Por estar em todo lugar, o HTTP costuma ser tratado como um detalhe que "simplesmente funciona", até o dia em que uma API responde 200 com um erro no corpo, um cache entrega dados velhos ou o navegador bloqueia uma chamada por CORS. Este artigo explica o protocolo de dentro para fora: o caminho de uma requisição pela rede, o formato das mensagens, o que significam os métodos, os códigos e os cabeçalhos, como funcionam a autenticação, o cache e o HTTPS, o que mudou nas versões 2 e 3, como o servidor envia respostas em fluxo e como diagnosticar os problemas que aparecem no dia a dia.
O que é o HTTP
O HTTP, Hypertext Transfer Protocol, é um protocolo de aplicação no modelo cliente e servidor. O cliente, que pode ser um navegador, um aplicativo ou um script, envia uma requisição pedindo uma ação sobre um recurso, identificado por uma URL. O servidor processa e devolve uma resposta, com um código que diz o que aconteceu e, quase sempre, um conteúdo.
Três características definem o protocolo:
- Sem estado. Cada requisição é independente e carrega tudo o que o servidor precisa para entendê-la. O servidor não "lembra" da requisição anterior. A sensação de continuidade, como estar logado num site, é construída por cima, com cookies e tokens.
- Extensível por cabeçalhos. Cliente e servidor trocam metadados em pares de nome e valor. Cache, autenticação, compressão, negociação de idioma e de formato e políticas de segurança são todos cabeçalhos.
- Semântica separada do transporte. O que um
GETou um404significam é o mesmo em todas as versões. O que muda entre HTTP/1.1, HTTP/2 e HTTP/3 é como os bytes viajam pela rede.
O HTTP não se preocupa com a entrega dos pacotes: ele roda sobre um protocolo de transporte, tradicionalmente o TCP, e, no caso do HTTPS, sobre uma camada de criptografia, o TLS. Essa separação em camadas é o que permitiu ao protocolo mudar tanto por baixo sem mudar nada para quem escreve uma aplicação.
Uma história curta
Entre 1989 e 1991, no CERN, Tim Berners-Lee criou as três peças da web: o HTML para os documentos, as URLs para endereçá-los e o HTTP para buscá-los. A primeira versão, depois chamada de HTTP/0.9, era quase só uma linha: GET /pagina, e o servidor devolvia o HTML e fechava a conexão. Não havia cabeçalhos, códigos de status nem outro tipo de conteúdo.
O HTTP/1.0, descrito em 1996, trouxe o formato que conhecemos: a versão na requisição, os códigos de status, os cabeçalhos e o Content-Type, que permitiu transferir imagens e qualquer outro tipo de arquivo. O HTTP/1.1, publicado em 1997 e revisado em 1999, consolidou a web por quase duas décadas. Ele tornou o cabeçalho Host obrigatório, o que permitiu hospedar vários sites no mesmo endereço IP, manteve as conexões abertas entre requisições, trouxe a transferência em partes (chunked) e um modelo de cache muito mais completo.
Em 2000, a tese de doutorado de Roy Fielding, um dos autores da especificação, descreveu o estilo arquitetural REST, que influenciou a forma de projetar APIs até hoje. Em 2009, o Google começou a experimentar o SPDY, um protocolo binário e multiplexado para acelerar o carregamento das páginas; ele virou a base do HTTP/2, padronizado em 2015. Na sequência, o Google criou o QUIC, um transporte novo sobre UDP, que deu origem ao HTTP/3, publicado em 2022. No mesmo ano, as especificações foram reorganizadas: a RFC 9110 define a semântica comum a todas as versões, e documentos separados cuidam do cache e de cada versão.
Vale notar o que não mudou em mais de trinta anos. A requisição de 1991 tinha um método e um caminho, e a de hoje também. Toda a evolução aconteceu por acréscimo: cabeçalhos novos que os programas antigos simplesmente ignoram, códigos novos que caem na classe genérica, transportes novos negociados sem que a aplicação perceba. Essa compatibilidade para trás é a razão pela qual um servidor escrito há vinte anos ainda conversa com um navegador lançado neste mês, e é uma lição de projeto que vale para qualquer API: acrescentar é barato, mudar o significado do que já existe custa caro.
O caminho de uma requisição, do clique à resposta
Antes de a primeira linha do HTTP sair, a rede precisa fazer uma série de preparativos. Entender essa sequência é o que separa "a página está lenta" de "a página espera 300 milissegundos pelo DNS".
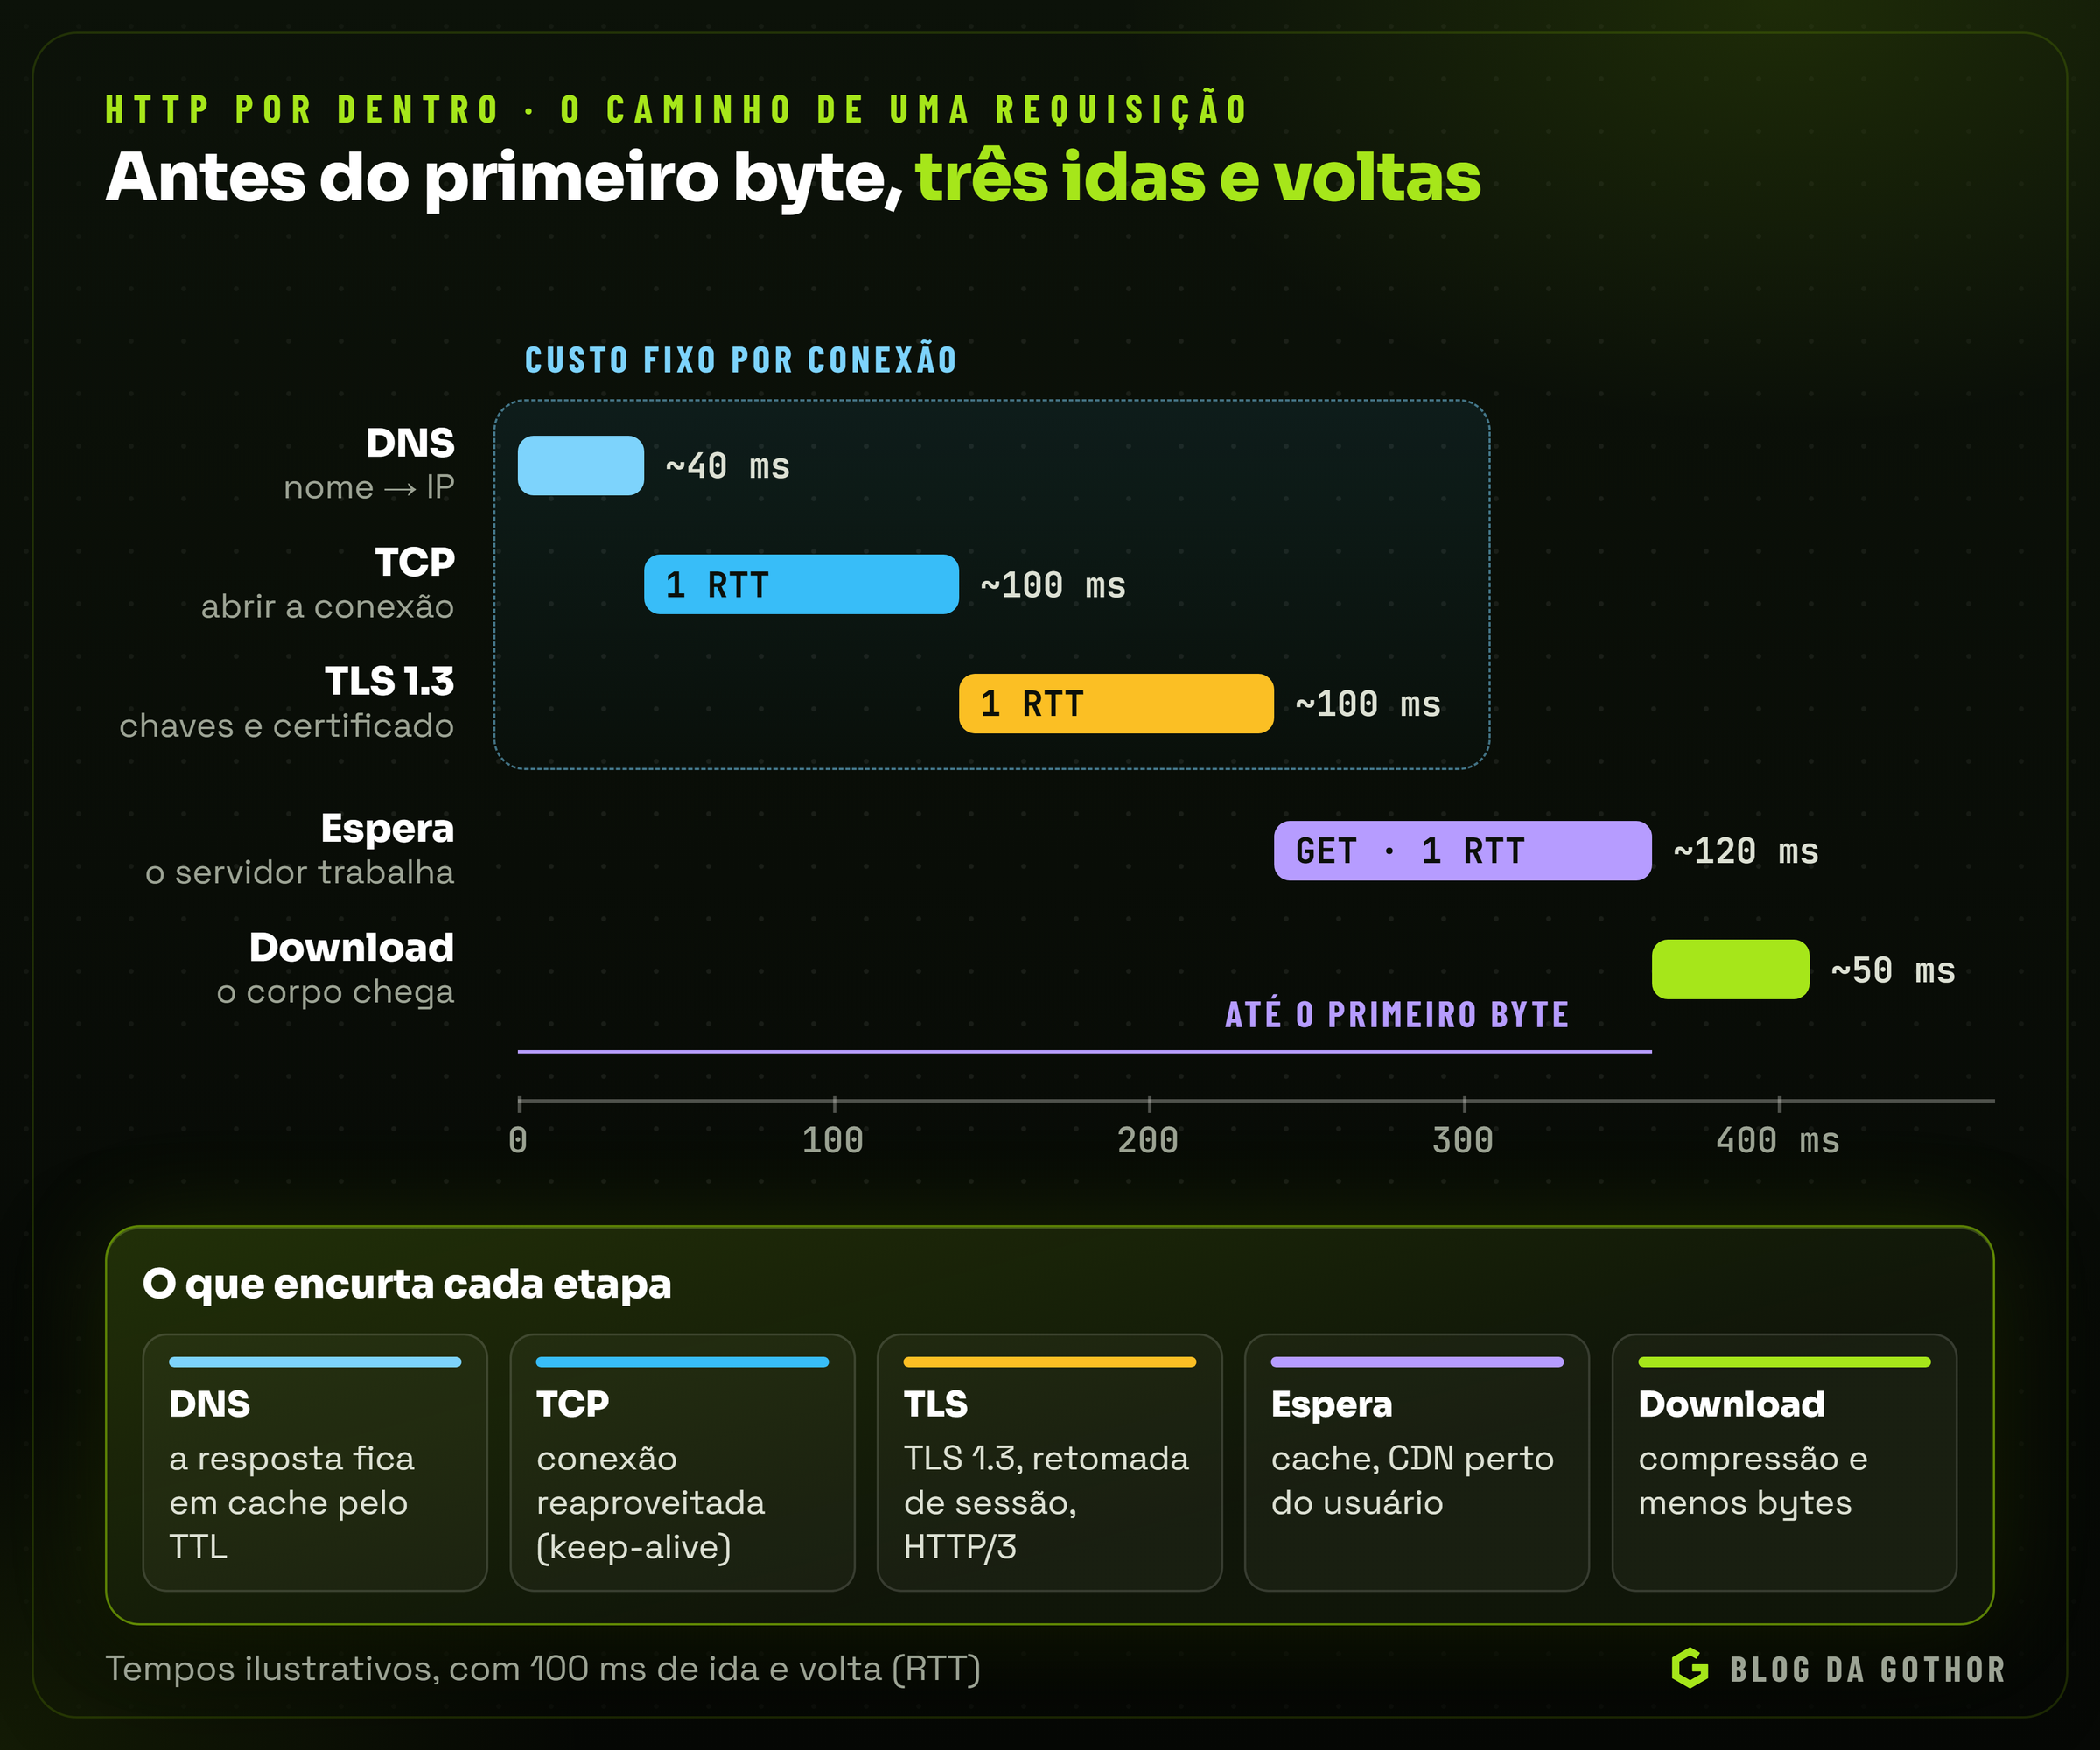
- Resolução de nome (DNS). O navegador precisa transformar
loja.exemplo.com.brnum endereço IP. Ele consulta o próprio cache, o do sistema operacional e, se nada tiver a resposta, um servidor DNS, que pode precisar perguntar a outros. A resposta vem com um prazo de validade, o TTL, e fica guardada. - Conexão TCP. Com o IP em mãos, o cliente abre uma conexão com o servidor na porta 443. O TCP gasta uma ida e volta inteira (o round trip time, ou RTT) só para combinar o início da conversa.
- Negociação TLS. No HTTPS, mais uma ida e volta no TLS 1.3 para combinar as chaves e conferir o certificado, como veremos adiante.
- Envio da requisição e espera. A requisição sai, o servidor processa e começa a responder. O intervalo entre o envio e a chegada do primeiro byte da resposta se chama TTFB (time to first byte) e mede, na prática, o trabalho do servidor somado a uma ida e volta.
- Download do corpo. Os bytes da resposta chegam, num ritmo que depende do tamanho, da compressão e da banda disponível.
O ponto central é que as três primeiras etapas são custo fixo por conexão, e são medidas em idas e voltas, não em bytes. Uma conexão de São Paulo a um servidor nos Estados Unidos tem um RTT na casa de 100 a 150 milissegundos. Três idas e voltas antes do primeiro byte já passam de 300 milissegundos, mesmo que o servidor responda instantaneamente e a resposta tenha só um quilobyte. Por isso quase todas as otimizações do protocolo atacam as idas e voltas: o cache de DNS evita a primeira etapa, a reutilização de conexões evita a segunda e a terceira, o TLS 1.3 encurtou a terceira, o HTTP/3 junta a segunda com a terceira e as CDNs aproximam o servidor do usuário, reduzindo o próprio RTT.
Para uma empresa, isso explica um fenômeno comum: o sistema que é rápido no escritório, perto do servidor, e lento na filial do interior, com um link de latência alta. Banda maior não resolve; menos idas e voltas, sim.
Anatomia de uma mensagem
Toda mensagem HTTP tem quatro partes, sempre na mesma ordem: a linha inicial, os cabeçalhos, uma linha em branco e, opcionalmente, o corpo.
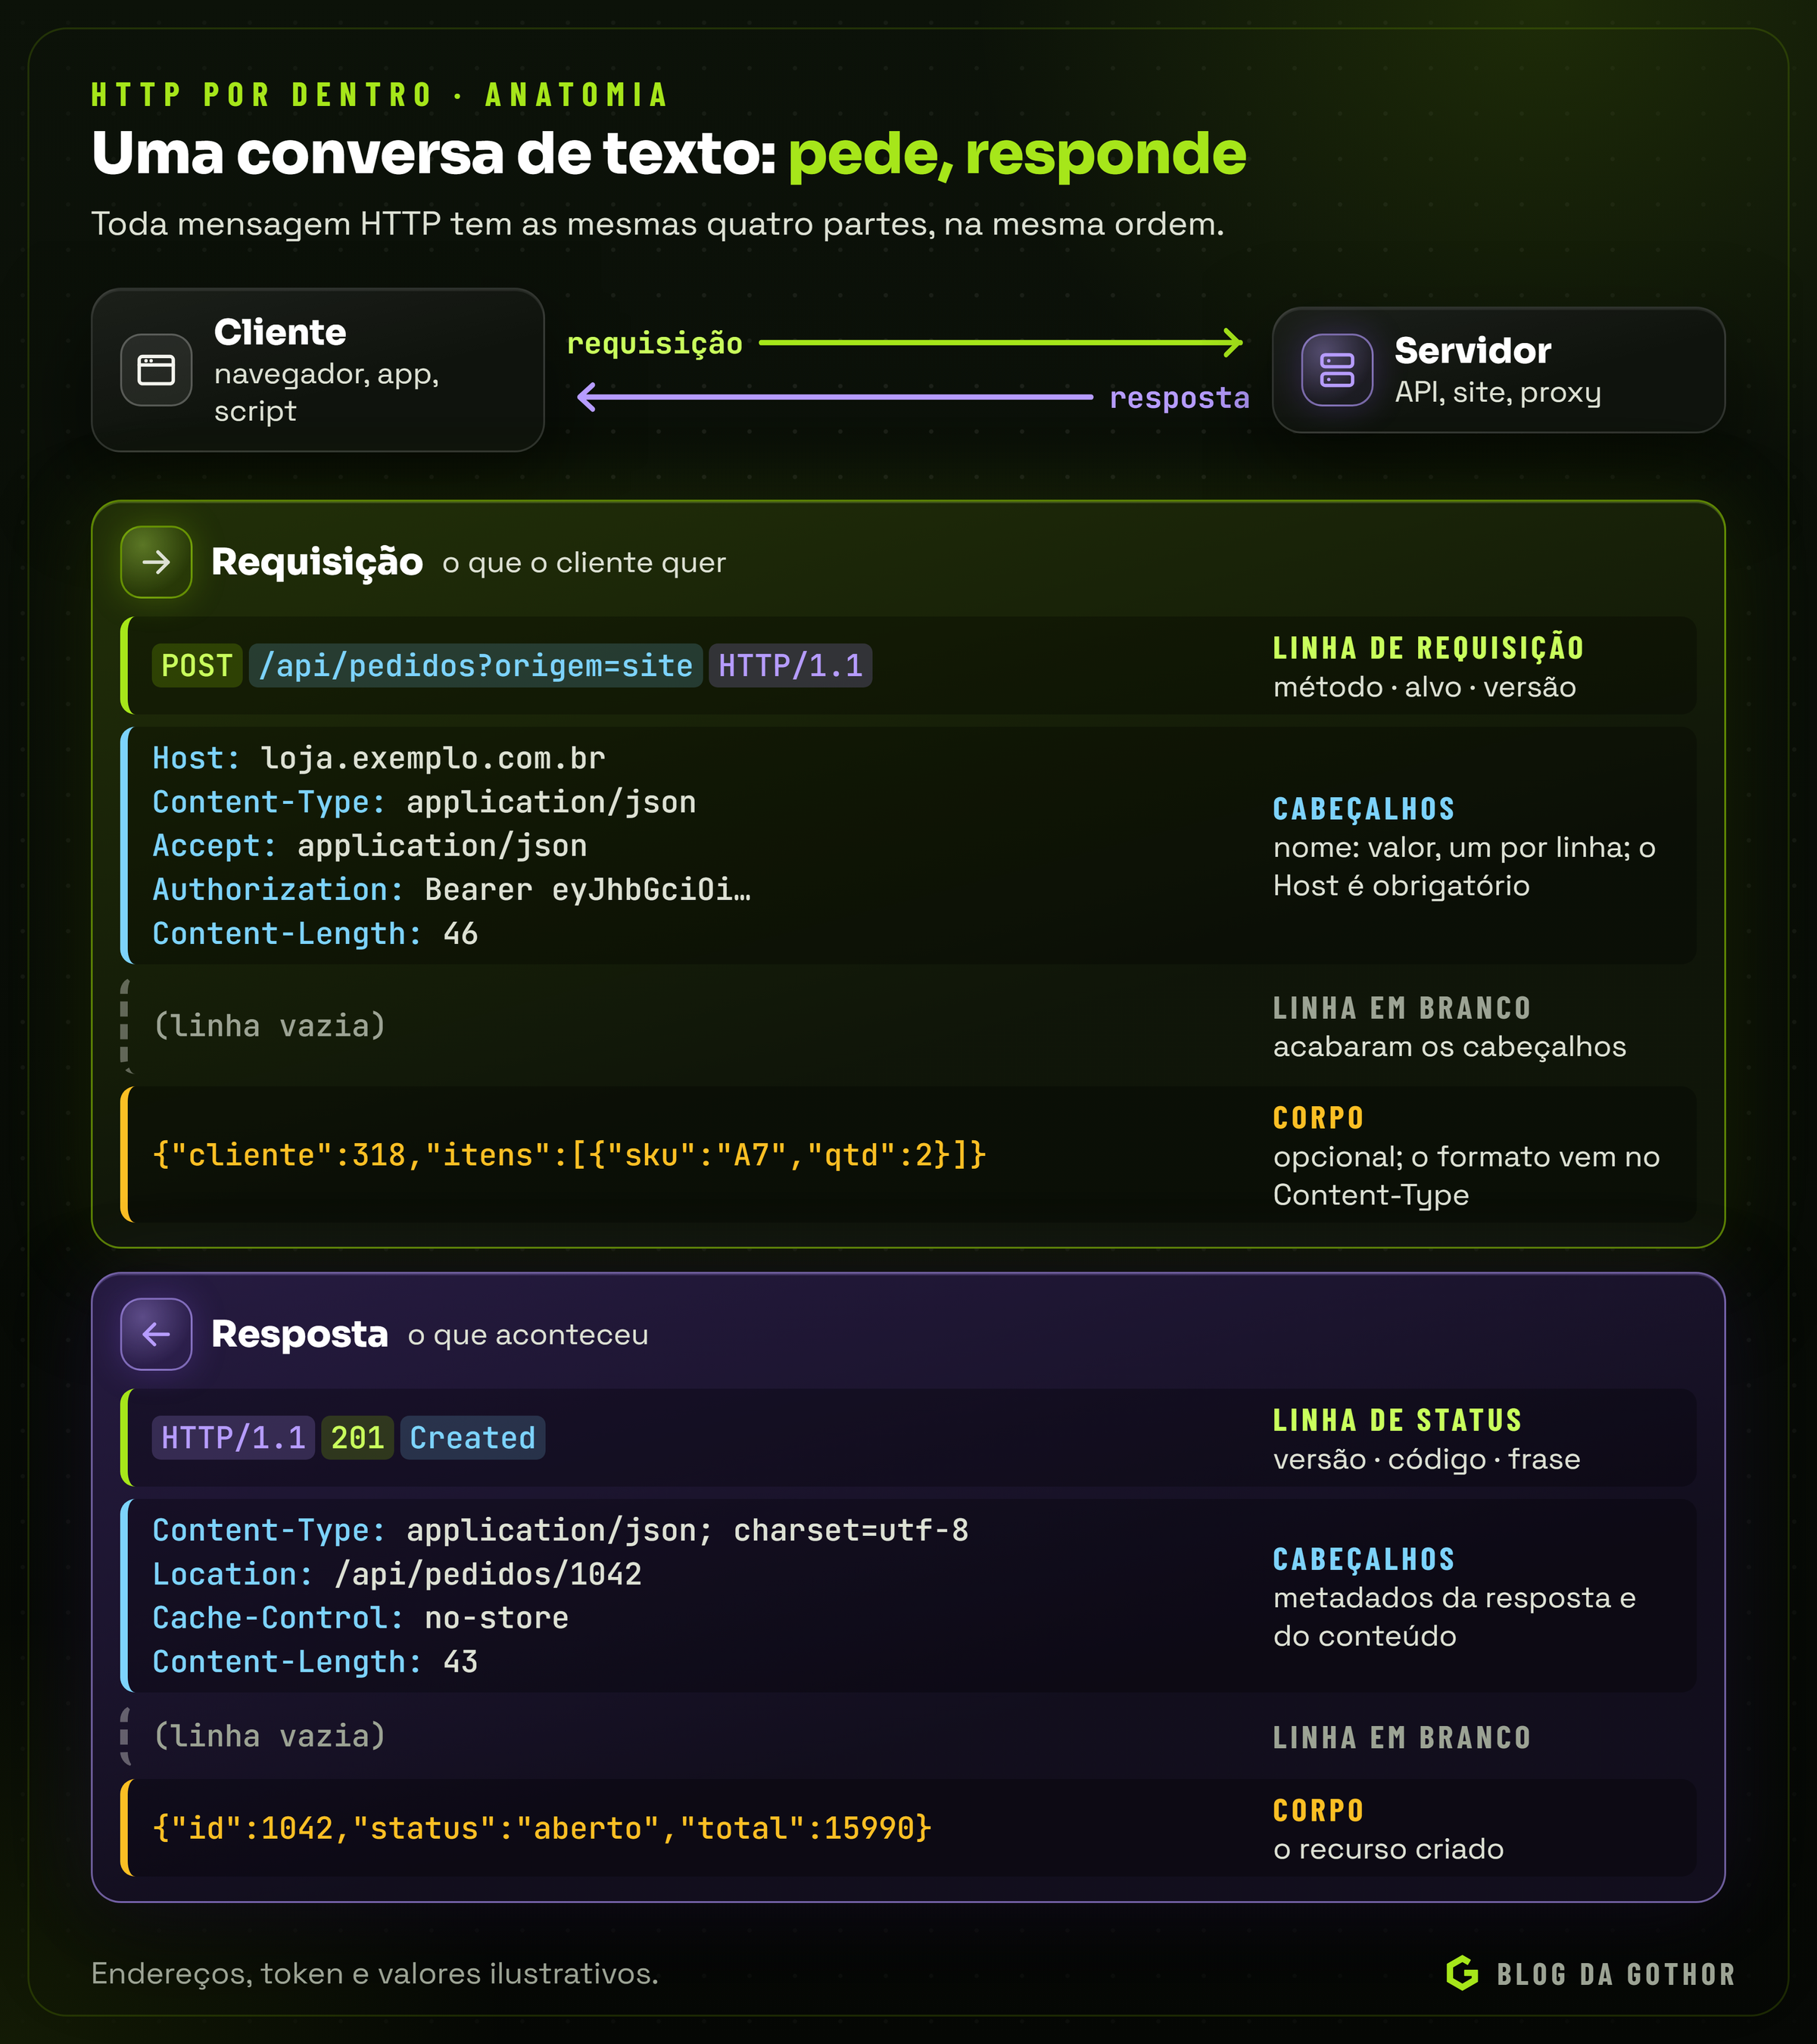
Na requisição, a linha inicial tem o método, o alvo e a versão. Na resposta, tem a versão, o código de status e uma frase curta, que é só para humanos: os programas olham o número. Os cabeçalhos vêm um por linha, no formato Nome: valor, e os nomes não diferenciam maiúsculas de minúsculas. A linha em branco marca o fim dos cabeçalhos. O corpo, quando existe, tem o tamanho informado pelo Content-Length ou é enviado em partes.
O jeito mais rápido de ver isso ao vivo é o curl com a opção -v, que mostra a conversa inteira. Uma saída típica, encurtada e com um endereço ilustrativo:
$ curl -v https://api.exemplo.com.br/produtos/42
> GET /produtos/42 HTTP/2
> Host: api.exemplo.com.br
> User-Agent: curl/8.9.1
> Accept: */*
>
< HTTP/2 200
< content-type: application/json; charset=utf-8
< cache-control: max-age=60
< etag: "a1f3"
<
{"id":42,"nome":"Café torrado 500 g","preco":2490}
As linhas com > são o que o cliente enviou; as com <, o que o servidor respondeu. No navegador, a aba Rede das ferramentas de desenvolvedor mostra o mesmo.
A URL, peça por peça
O recurso é identificado por uma URL, e cada parte dela tem um papel:
| Parte | Exemplo | Papel |
|---|---|---|
| Esquema | https | o protocolo, e com ele a porta padrão (443) |
| Host | loja.exemplo.com.br | o servidor, que vai no cabeçalho Host |
| Porta | :8443 | só aparece quando não é a padrão |
| Caminho | /api/pedidos/1042 | o recurso dentro do servidor |
| Consulta | ?status=aberto&pagina=2 | parâmetros, normalmente filtros e paginação |
| Fragmento | #itens | uma posição dentro do documento; nunca é enviado ao servidor |
Caracteres especiais precisam ser codificados com porcentagem: um espaço vira %20, um "ç" vira %C3%A7. Em JavaScript, encodeURIComponent faz isso para cada valor.
O corpo: tamanho, formato e compressão
O receptor precisa saber onde o corpo termina, porque na mesma conexão pode vir outra mensagem logo depois. Há duas formas de dizer isso. A mais simples é o Content-Length, com o número exato de bytes. Quando o servidor ainda não sabe o tamanho, porque está gerando a resposta aos poucos, o HTTP/1.1 usa a transferência em partes: o cabeçalho Transfer-Encoding: chunked avisa que o corpo virá em pedaços, cada um precedido do seu tamanho em hexadecimal, e um pedaço de tamanho zero marca o fim. No HTTP/2 e no HTTP/3, o próprio protocolo marca o fim de cada fluxo, e o chunked deixa de existir.
O formato do corpo é declarado no Content-Type, e três aparecem o tempo todo:
| Formato | Uso típico | Como o corpo se parece |
|---|---|---|
application/json | APIs | {"cliente":1042,"itens":3} |
application/x-www-form-urlencoded | formulários HTML simples, logins OAuth | usuario=ana&lembrar=1, com a mesma codificação da URL |
multipart/form-data | envio de arquivos | partes separadas por uma fronteira, cada uma com os seus próprios cabeçalhos |
Para textos, o charset=utf-8 no Content-Type evita o clássico "ç" no lugar do "ç": sem ele, o cliente pode adivinhar a codificação errada.
A compressão reduz o tamanho do corpo e é negociada. O cliente diz o que sabe descomprimir no Accept-Encoding, e o servidor informa o que usou no Content-Encoding. O gzip é aceito em todo lugar; o Brotli (br), criado pelo Google, comprime textos da web cerca de 15% a 25% melhor; e o zstd já é aceito pelo Chrome e pelo Firefox. HTML, CSS, JavaScript e JSON costumam encolher para um quinto ou menos. Imagens em JPEG, PNG ou WebP e vídeos já são comprimidos pelo próprio formato, e comprimi-los de novo só gasta processador.
Faixas: baixar só um pedaço
Um cliente pode pedir só uma parte de um recurso com o cabeçalho Range, por exemplo Range: bytes=0-1048575 para o primeiro megabyte. Se o servidor aceita faixas, o que ele anuncia com Accept-Ranges: bytes, responde 206 Partial Content com o pedaço e um Content-Range dizendo onde ele se encaixa no todo. É assim que um download interrompido continua de onde parou e que um player de vídeo pula para o meio do filme sem baixar o começo. Uma faixa fora do tamanho do arquivo recebe 416 Range Not Satisfiable.
Métodos: o verbo da requisição
O método diz o que o cliente quer fazer com o recurso. Mais do que nomes, cada método carrega garantias que clientes, proxies e caches levam em conta.
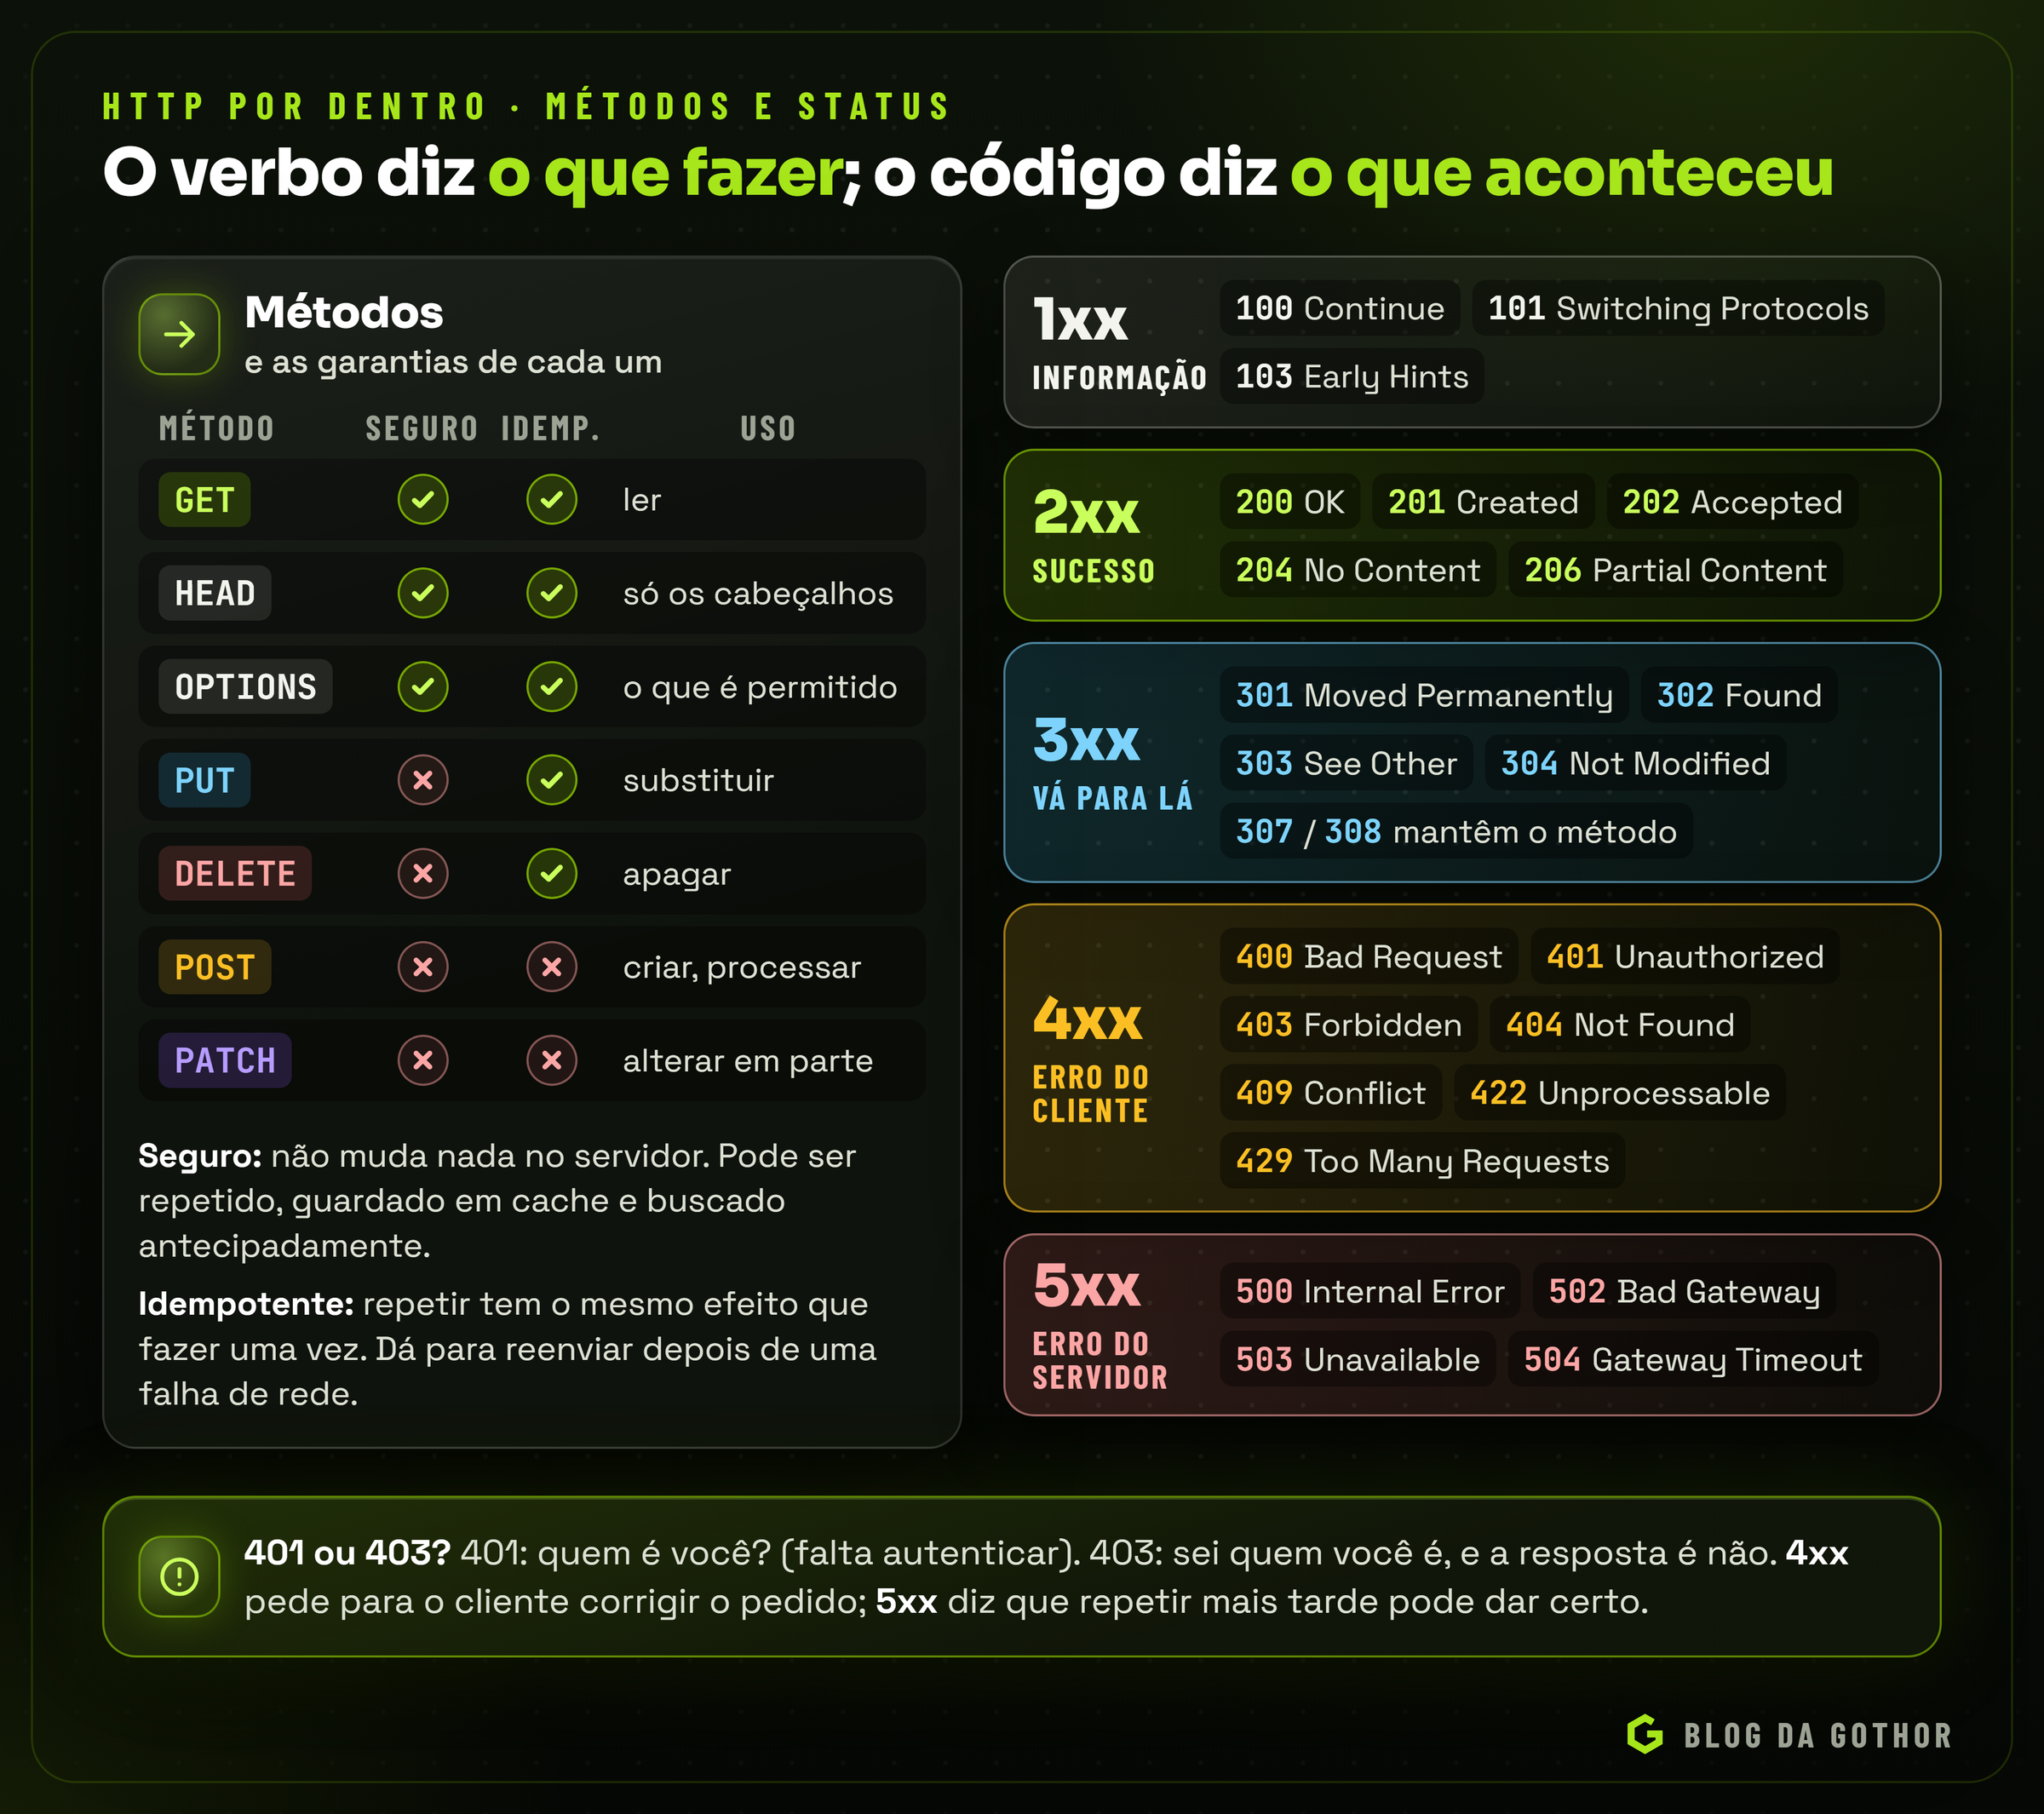
Duas propriedades importam:
- Um método seguro não altera nada no servidor.
GET,HEADeOPTIONSsão seguros, por isso podem ser repetidos à vontade, guardados em cache e até buscados antecipadamente pelo navegador. - Um método idempotente pode ser repetido com o mesmo efeito de uma execução só.
PUTeDELETEsão idempotentes: substituir um recurso pelo mesmo conteúdo duas vezes, ou apagar o que já foi apagado, deixa o servidor no mesmo estado.POSTePATCH, em geral, não são.
A idempotência tem uma consequência prática enorme: quando a rede falha no meio de uma requisição, o cliente não sabe se o servidor a recebeu. Um PUT pode ser reenviado sem medo. Um POST que cria um pagamento, não: reenviá-lo pode cobrar duas vezes. Por isso APIs de pagamento costumam aceitar uma chave de idempotência, um identificador único gerado pelo cliente e enviado num cabeçalho (o nome mais comum é Idempotency-Key). O servidor guarda as chaves já processadas e, se receber a mesma de novo, devolve o resultado da primeira vez em vez de executar outra.
Algumas regras de uso evitam confusão:
GETbusca e não deve ter efeitos colaterais. Um link "apagar" que faz umGETpode ser disparado por um robô de busca ou pela pré-busca do navegador.POSTcria um recurso subordinado ou executa um processamento. A resposta de criação costuma ser201 Created, com o endereço do novo recurso no cabeçalhoLocation.PUTsubstitui o recurso inteiro pelo que foi enviado;PATCHaltera só uma parte.GETcom corpo não tem significado definido, e muitos servidores e proxies descartam o corpo. Filtros vão na consulta da URL.
Os métodos menos lembrados
Além dos cinco mais conhecidos, três métodos aparecem com frequência, ainda que ninguém os escreva à mão:
- **
HEAD** pede só os cabeçalhos de umGET, sem o corpo. Serve para saber o tamanho de um arquivo antes de baixá-lo, conferir se um link ainda existe ou ver a data de modificação. Ocurl -Ifaz exatamente isso. - **
OPTIONS** pergunta quais métodos e cabeçalhos um recurso aceita. O navegador o usa sozinho na comprovação do CORS, assunto de uma seção adiante. - **
CONNECT** pede a um proxy que abra um túnel até outro servidor. É o que acontece quando uma rede corporativa obriga o navegador a passar por um proxy: o navegador enviaCONNECT loja.exemplo.com.br:443, o proxy abre o túnel e, dali em diante, o TLS passa por dentro dele sem que o proxy enxergue o conteúdo.
Escrever sem atropelar: requisições condicionais
Imagine duas pessoas abrindo o mesmo cadastro de cliente ao mesmo tempo. A primeira muda o telefone e salva; a segunda, que ainda via a versão antiga, muda o e-mail e salva logo depois, mandando o cadastro inteiro com um PUT. O telefone novo some sem que ninguém perceba. É a atualização perdida, um defeito clássico de sistemas com várias pessoas editando os mesmos dados.
O HTTP tem uma solução embutida, a mesma peça que o cache usa: o ETag. Ao ler o cadastro, o cliente recebe a versão, por exemplo ETag: "v14". Ao salvar, envia If-Match: "v14", que significa "só aplique se o cadastro ainda estiver na versão que eu li". Se outra pessoa salvou antes, a versão já é "v15", e o servidor recusa com 412 Precondition Failed. A tela então pode recarregar os dados e mostrar o que mudou, em vez de apagar o trabalho alheio. Um servidor que quer obrigar os clientes a usar esse cuidado responde 428 Precondition Required quando o If-Match não vem. O nome técnico dessa estratégia é controle de concorrência otimista: ninguém trava o registro enquanto edita, e o conflito só é tratado quando de fato acontece.
Códigos de status: o que aconteceu
O código de status tem três dígitos, e o primeiro diz a classe da resposta. Um cliente que não conhece um código específico deve tratá-lo como o genérico da classe: um 4xx desconhecido vale como 400.
- 1xx, informação. Respostas provisórias, como
101 Switching Protocols, usada ao abrir um WebSocket, e103 Early Hints, que permite ao navegador começar a baixar recursos antes da resposta final. - 2xx, sucesso.
200 OK,201 Created,202 Accepted(recebido, será processado depois) e204 No Content(deu certo e não há corpo). - 3xx, redirecionamento.
301e308dizem que o recurso mudou de endereço para sempre;302e307, que mudou temporariamente. A diferença entre os pares é que307e308garantem que o método e o corpo serão mantidos.303 See Othermanda o cliente buscar outro endereço comGET, o padrão depois de um formulário enviado com sucesso.304 Not Modifiedé a resposta de cache, que veremos adiante. - 4xx, erro do cliente. O pedido tem algum problema, e repeti-lo igual vai dar o mesmo erro.
- 5xx, erro do servidor. O pedido pode estar certo, e o problema é do lado de lá. Repetir mais tarde pode funcionar.
Algumas distinções aparecem o tempo todo em APIs:
| Código | Quando usar |
|---|---|
400 Bad Request | o pedido está malformado ou falhou na validação |
401 Unauthorized | falta autenticar, ou a credencial é inválida |
403 Forbidden | o servidor sabe quem você é, e você não tem permissão |
404 Not Found | o recurso não existe (ou não deve ser revelado) |
409 Conflict | conflito com o estado atual, como um cadastro duplicado |
422 Unprocessable Content | o formato está certo, mas o conteúdo não faz sentido para a regra de negócio |
429 Too Many Requests | limite de requisições atingido; o Retry-After diz quando tentar de novo |
502 Bad Gateway | um proxy recebeu uma resposta inválida do servidor de trás |
503 Service Unavailable | o servidor está sobrecarregado ou em manutenção |
504 Gateway Timeout | um proxy desistiu de esperar o servidor de trás |
Os três últimos são valiosos para investigar problemas: eles quase sempre vêm de um proxy reverso, e não da aplicação, e indicam que o problema está entre as camadas. Um 502 costuma significar que a aplicação caiu ou fechou a conexão; um 504, que ela demorou demais.
O erro mais comum é responder 200 OK com um corpo dizendo que houve erro. Isso quebra caches, monitoramento, tentativas automáticas e qualquer cliente que confie no protocolo. O código diz o que aconteceu; o corpo dá os detalhes. Para os detalhes, existe até um formato padronizado, o Problem Details (RFC 9457), um JSON com campos como type, title, status e detail:
{
  "type": "https://api.exemplo.com.br/erros/limite-de-credito",
  "title": "Limite de crédito insuficiente",
  "status": 422,
  "detail": "O pedido soma R$ 18.400,00 e o limite disponível é de R$ 12.000,00.",
  "instance": "/pedidos/1042"
}
O que fazer com cada classe
Na hora de escrever um cliente, a classe do código já decide boa parte do comportamento:
| Classe | O que o cliente deve fazer |
|---|---|
2xx | usar o corpo; num 202, guardar o identificador e consultar o andamento depois |
3xx | seguir o Location (as bibliotecas fazem isso sozinhas) ou usar a cópia em cache, no 304 |
4xx | não repetir igual: corrigir o pedido, pedir login de novo (401) ou mostrar a mensagem à pessoa |
429 | esperar o tempo do Retry-After antes de tentar outra vez |
5xx | tentar de novo com espera crescente, mas só se a operação for idempotente |
Os redirecionamentos merecem um cuidado extra. O navegador guarda um 301 em cache, às vezes por tempo indeterminado, e um redirecionamento permanente errado continua valendo para quem já visitou a página mesmo depois de corrigido no servidor. Em mudanças de endereço que ainda podem ser revistas, comece com 302 ou 307 e só passe para o permanente quando tiver certeza.
Cabeçalhos: onde mora o trabalho pesado
Os cabeçalhos são a parte mais rica do protocolo. Alguns dos que você mais vai encontrar:
| Cabeçalho | Direção | Para que serve |
|---|---|---|
Host | requisição | qual site, entre os vários de um mesmo servidor |
Content-Type | ambas | o formato do corpo, como application/json ou text/html; charset=utf-8 |
Accept | requisição | os formatos que o cliente aceita |
Accept-Encoding e Content-Encoding | ambas | compressão negociada, como gzip e br |
Authorization | requisição | credenciais, como Bearer seguido de um token |
Cookie e Set-Cookie | ambas | estado guardado pelo navegador |
Cache-Control | ambas | as regras de cache |
ETag e If-None-Match | ambas | a versão de um recurso e a pergunta "mudou?" |
Location | resposta | para onde redirecionar, ou onde está o recurso criado |
Retry-After | resposta | quanto esperar antes de tentar de novo |
Origin | requisição | de que site veio uma requisição do navegador |
Com Accept, Accept-Language e Accept-Encoding, o cliente diz o que prefere e o servidor escolhe a melhor representação do mesmo recurso. Isso se chama negociação de conteúdo. Quando a resposta depende de um desses cabeçalhos, o servidor deve dizer isso no Vary, para que um cache não entregue a versão em inglês a quem pediu português, ou a versão comprimida a quem não sabe descomprimi-la.
Sem estado, mas com memória: cookies e tokens
Se cada requisição é independente, como o servidor sabe que é você? Com algum dado que o cliente envia em toda requisição. Há duas formas principais.
Os cookies são guardados pelo navegador a pedido do servidor, com o cabeçalho Set-Cookie, e reenviados automaticamente em toda requisição para aquele site. Os atributos do cookie são tão importantes quanto o valor:
Set-Cookie: sessao=8f2c...; Path=/; HttpOnly; Secure; SameSite=Lax; Max-Age=2592000HttpOnlyimpede que o JavaScript da página leia o cookie, o que protege a sessão de um script injetado.Securefaz o cookie viajar só por HTTPS.SameSite=Laximpede que o cookie vá junto em requisições disparadas por outros sites, exceto na navegação comum por links. É a principal defesa moderna contra CSRF, o ataque em que outro site faz o navegador da vítima enviar um pedido autenticado.Stricté ainda mais restrito;Nonelibera tudo e exigeSecure.Path,DomaineMax-Agedefinem onde o cookie vale e por quanto tempo.
Os tokens, enviados no cabeçalho Authorization: Bearer ..., são a escolha comum em APIs consumidas por aplicativos e outros servidores. Muitos são JWTs, que carregam dados assinados, como quem é o usuário e quando o token vence. Como o navegador não os envia sozinho, não sofrem com CSRF; em compensação, guardá-los ao alcance do JavaScript os expõe a scripts injetados.
O cabeçalho Authorization e os seus esquemas
O Authorization tem o formato Esquema credenciais, e o esquema diz como ler o resto. Quando falta autenticação, o servidor responde 401 com o cabeçalho WWW-Authenticate, que diz qual esquema ele espera. Dois esquemas dominam:
- **
Basic** leva usuário e senha juntos, separados por dois-pontos e codificados em Base64:Authorization: Basic YW5hOnNlbmhh. Base64 não é criptografia, é só uma forma de escrever bytes como texto, e qualquer um decodifica. Basic só é aceitável dentro do HTTPS, e mesmo assim envia a senha em toda requisição; serve para ferramentas internas e integrações simples. - **
Bearer** leva um token: quem o "porta" tem acesso, sem outra prova. A senha só é usada uma vez, no login, e o token tem prazo de validade.
Por dentro de um JWT
Um JWT (JSON Web Token) são três partes em Base64 URL-safe, separadas por pontos: o cabeçalho, o conteúdo e a assinatura.
eyJhbGciOiJIUzI1NiJ9.eyJlbWFpbCI6ImFuYUBleGVtcGxvLmNvbS5iciIsImV4cCI6MTc5MjAwMDAwMH0.Kx3f...
   cabeçalho             conteúdo (claims)                                              assinatura
{"alg":"HS256"}         {"email":"ana@exemplo.com.br","exp":1792000000}
O cabeçalho diz o algoritmo da assinatura. O conteúdo traz as claims, afirmações como quem é a pessoa (sub ou um e-mail), quando o token vence (exp, em segundos desde 1970) e o que ela pode fazer. A assinatura é calculada sobre as duas primeiras partes com uma chave: no HS256, um segredo compartilhado entre quem emite e quem confere; no RS256 ou no ES256, uma chave privada para assinar e uma pública para conferir, o que permite que muitos serviços validem tokens sem conhecer o segredo.
Três consequências práticas. Primeiro, o conteúdo é legível por qualquer um: a assinatura impede alterações, mas não esconde nada, então nada de senha ou dado sensível ali dentro. Segundo, o servidor valida sem consultar o banco, o que é rápido e escala bem, mas também significa que um token não pode ser "desligado" antes de vencer sem algum mecanismo extra, como uma lista de tokens revogados. Por isso os tokens de acesso costumam durar pouco, e um token de renovação (refresh token), guardado com mais cuidado, permite obter outro sem pedir a senha de novo. Terceiro, quem valida deve fixar o algoritmo aceito: bibliotecas antigas que confiavam no campo alg do próprio token já aceitaram tokens com "alg": "none", sem assinatura nenhuma.
OAuth 2.0: entrar em nome de alguém
Quando um sistema precisa agir numa conta de outro serviço, como publicar numa página do LinkedIn, ele não deve pedir a senha da pessoa. O OAuth 2.0 resolve isso em HTTP puro. No fluxo mais comum, o de código de autorização, o sistema redireciona a pessoa para a tela de login do serviço, ela autoriza o acesso, o serviço a devolve com um código de uso único na URL, e o sistema troca esse código por um token de acesso num POST feito de servidor para servidor, com um corpo application/x-www-form-urlencoded. Em aplicativos que não conseguem guardar segredo, como os de celular, uma extensão chamada PKCE amarra o código a quem o pediu.
Cache: a requisição mais rápida é a que não sai
O cache do HTTP é um dos mecanismos de desempenho mais eficientes que existem, e um dos mais mal configurados. A ideia é simples: guardar uma resposta e reaproveitá-la enquanto ela for válida.
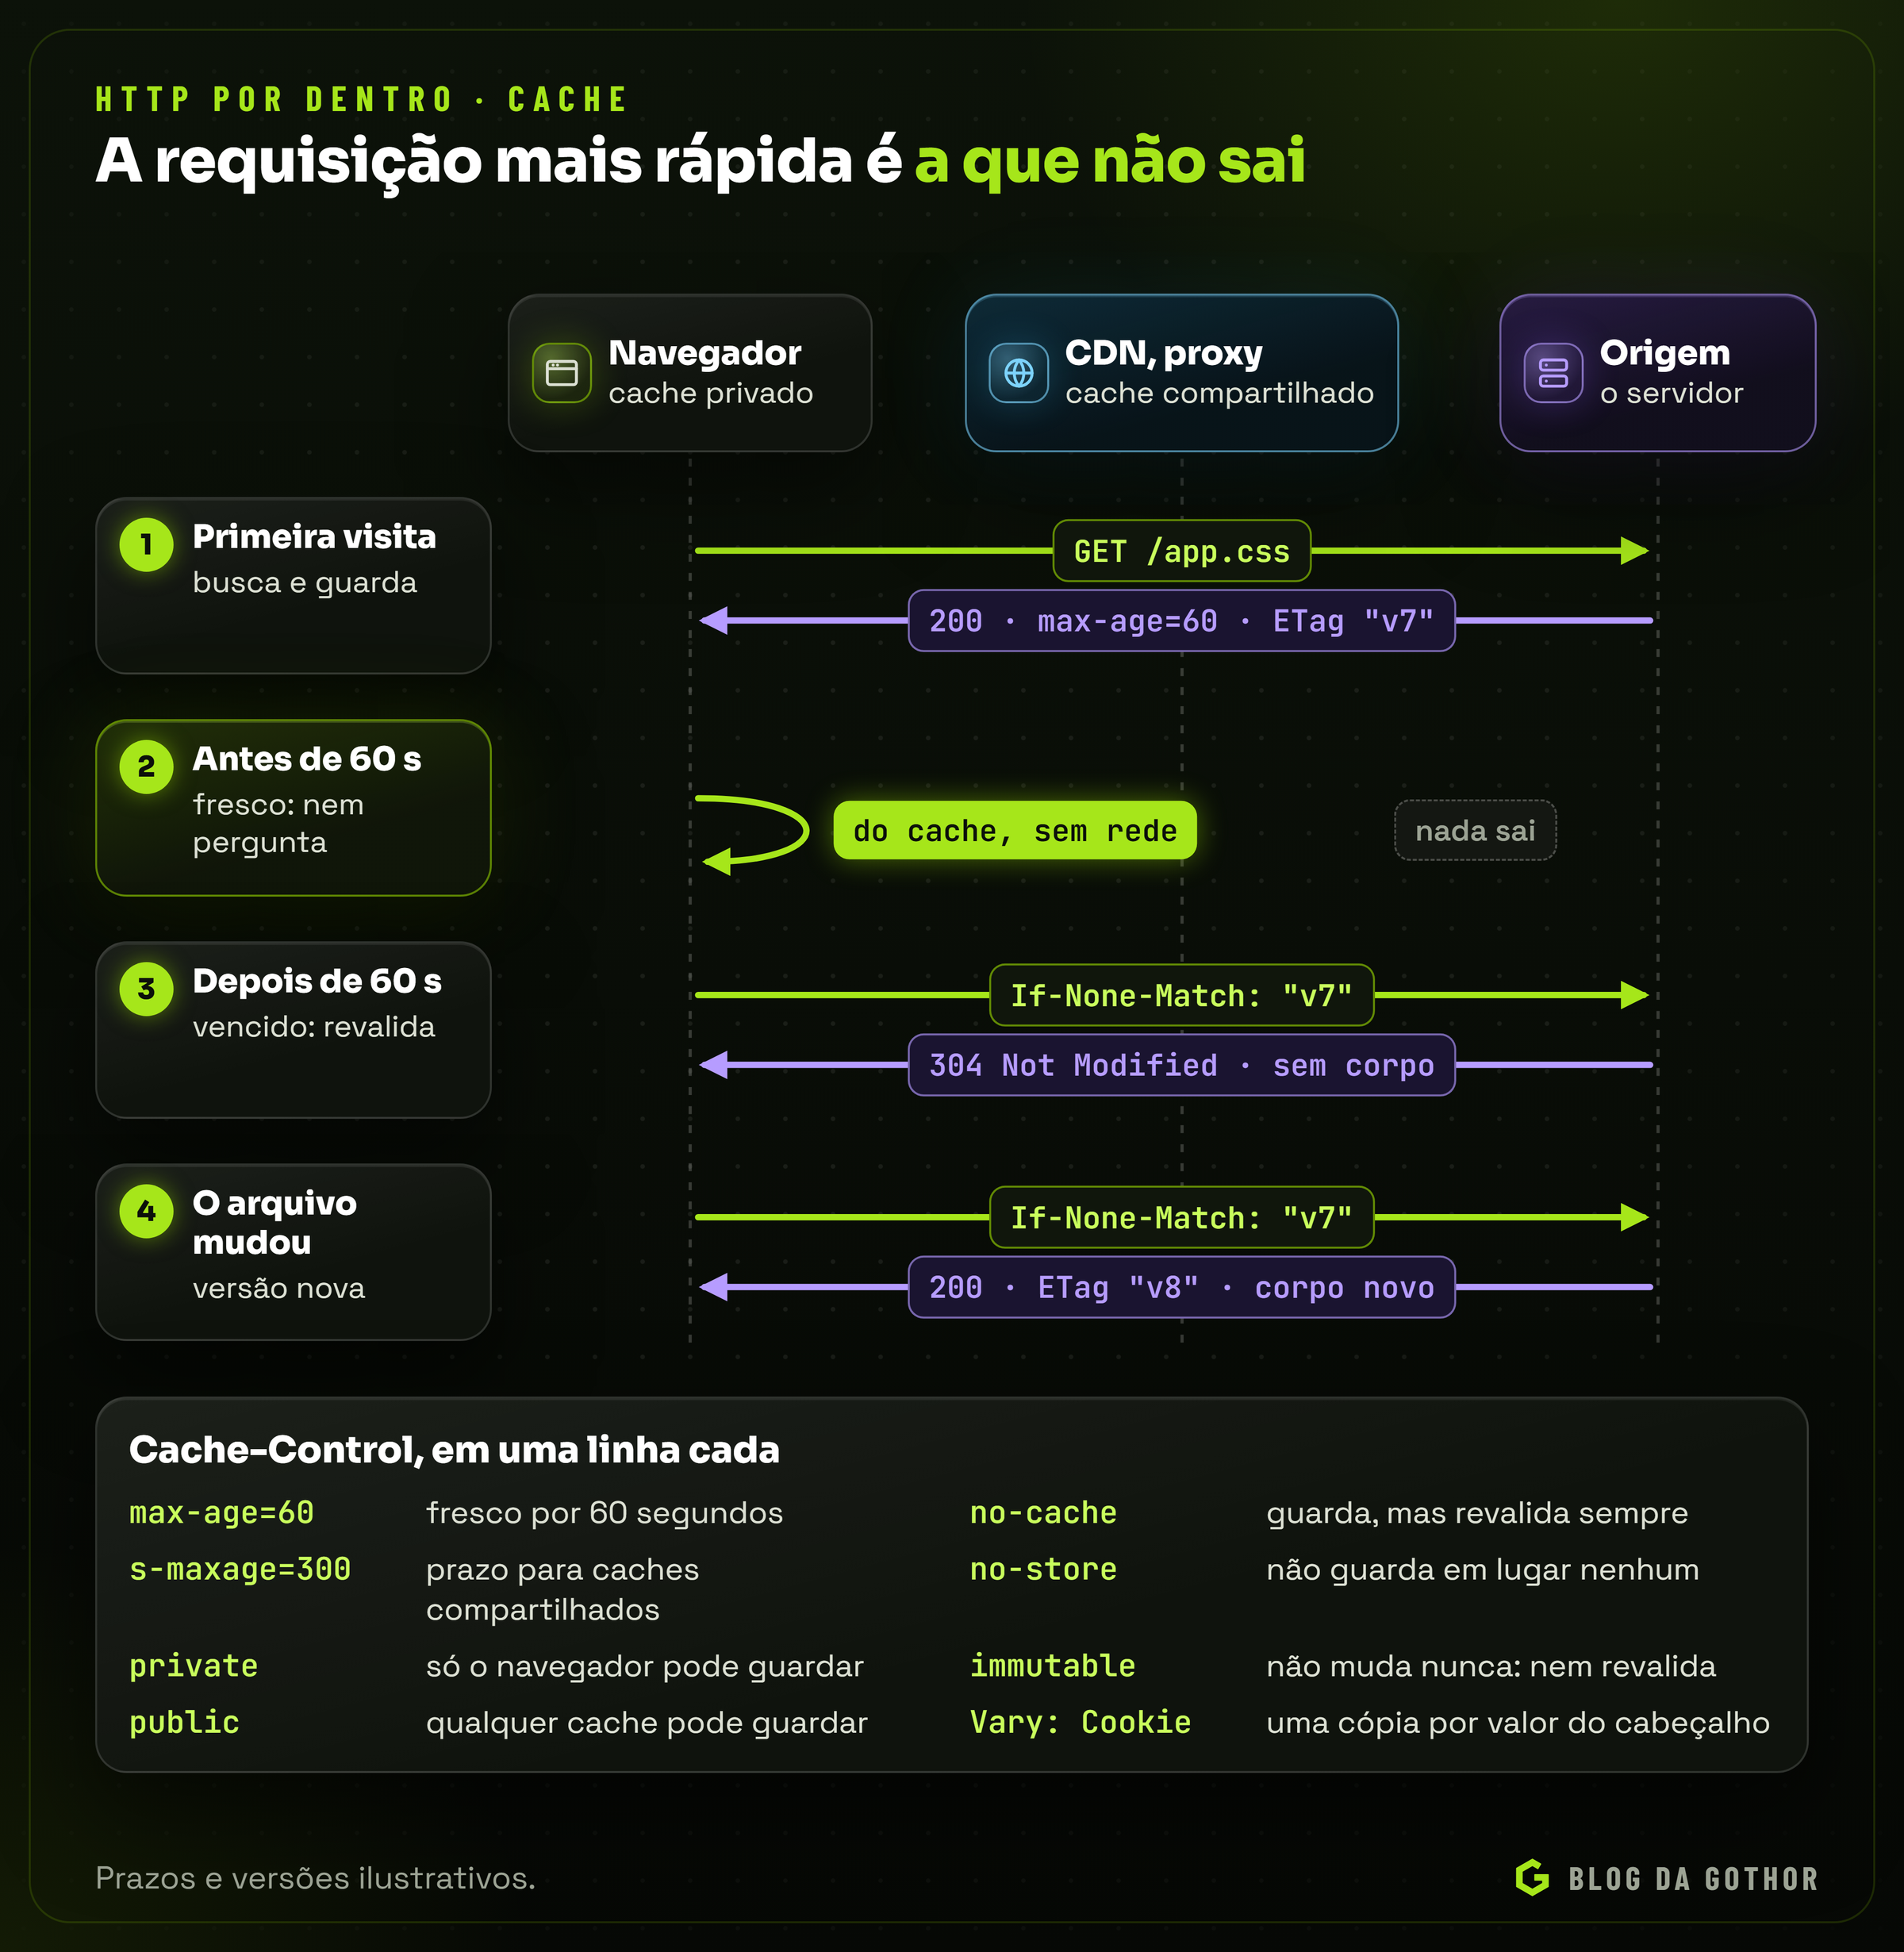
Há dois tipos de cache no caminho: o privado, do navegador, que guarda respostas só para aquele usuário, e os compartilhados, como uma CDN ou um proxy reverso, que servem a mesma cópia para muitos usuários. O servidor controla os dois com o Cache-Control.
O ciclo tem dois momentos:
- Frescor. Com
max-age=60, a resposta é considerada fresca por 60 segundos. Nesse período, o cache a entrega sem perguntar nada ao servidor: nenhuma requisição sai. - Revalidação. Depois disso, a cópia está vencida, mas não é jogada fora. O cache pergunta ao servidor se ela mudou, enviando a versão que tem no
If-None-Match(o valor doETagrecebido) ou a data noIf-Modified-Since. Se nada mudou, o servidor responde304 Not Modified, sem corpo, e o cache renova a cópia. Se mudou, responde200com o conteúdo novo.
As diretivas mais confundidas são no-cache e no-store. **no-cache não significa "não guarde"**: significa "guarde, mas revalide antes de cada uso". Quem não deve ser guardado em lugar nenhum, como uma página com dados pessoais, usa no-store. private restringe o cache ao navegador do usuário, e public permite caches compartilhados.
Uma estratégia muito usada para arquivos estáticos combina as duas pontas. O HTML, que muda a cada publicação, tem cache curto ou revalidação. Os arquivos de CSS e JavaScript recebem um hash do conteúdo no nome, como app.3f9a1c.js, e podem ser guardados por um ano com immutable, porque qualquer mudança gera um nome novo, referenciado pelo HTML novo.
Diretivas para casos reais
Algumas diretivas resolvem situações que aparecem cedo ou tarde:
| Diretiva | O que faz | Quando usar |
|---|---|---|
s-maxage=300 | prazo só para caches compartilhados | a CDN guarda por cinco minutos, o navegador segue o max-age |
stale-while-revalidate=30 | entrega a cópia vencida na hora e revalida em segundo plano | listas e páginas em que meio minuto de atraso é aceitável e a espera não é |
stale-if-error=600 | entrega a cópia vencida se o servidor estiver com erro | manter o site de pé durante uma falha curta da origem |
must-revalidate | proíbe usar a cópia vencida sem revalidar | dados em que uma versão velha causa problema |
Quando o servidor não manda Cache-Control nem Expires, os caches podem aplicar uma regra heurística: se a resposta tem Last-Modified, guardam por uma fração do tempo desde a última modificação, tipicamente 10%. Um arquivo alterado há trinta dias pode ficar três dias em cache sem que ninguém tenha pedido isso. A lição é simples: diga sempre, de forma explícita, o que pode ser guardado e por quanto tempo.
Invalidação e o perigo do cache compartilhado
Uma piada antiga da computação diz que há só duas coisas difíceis: dar nome às coisas e invalidar cache. No HTTP, não existe um comando para apagar a cópia que está no navegador de um usuário; o servidor só controla o que acontece daqui para frente. Por isso o nome com hash é tão eficaz: em vez de invalidar a cópia velha, ele muda o endereço. Nas CDNs, existe a purga, uma chamada à API da própria CDN para descartar um endereço, mas ela não alcança os navegadores.
O cache compartilhado exige um cuidado maior. Uma resposta personalizada, com o nome do usuário ou o carrinho dele, guardada por engano numa CDN, é entregue ao próximo visitante. Toda resposta que depende de quem pediu deve ir com private ou no-store, e o Vary precisa listar os cabeçalhos que mudam a resposta. Há também um ataque com nome próprio, o envenenamento de cache: o atacante descobre um cabeçalho que altera a resposta mas não entra na chave do cache, envia uma requisição maliciosa e faz a CDN guardar a versão adulterada para todos.
As versões: HTTP/1.1, HTTP/2 e HTTP/3
A semântica é a mesma nas três versões. O que mudou foi a forma de transportar as mensagens, sempre com o mesmo objetivo: carregar mais coisas, mais rápido, com menos conexões.
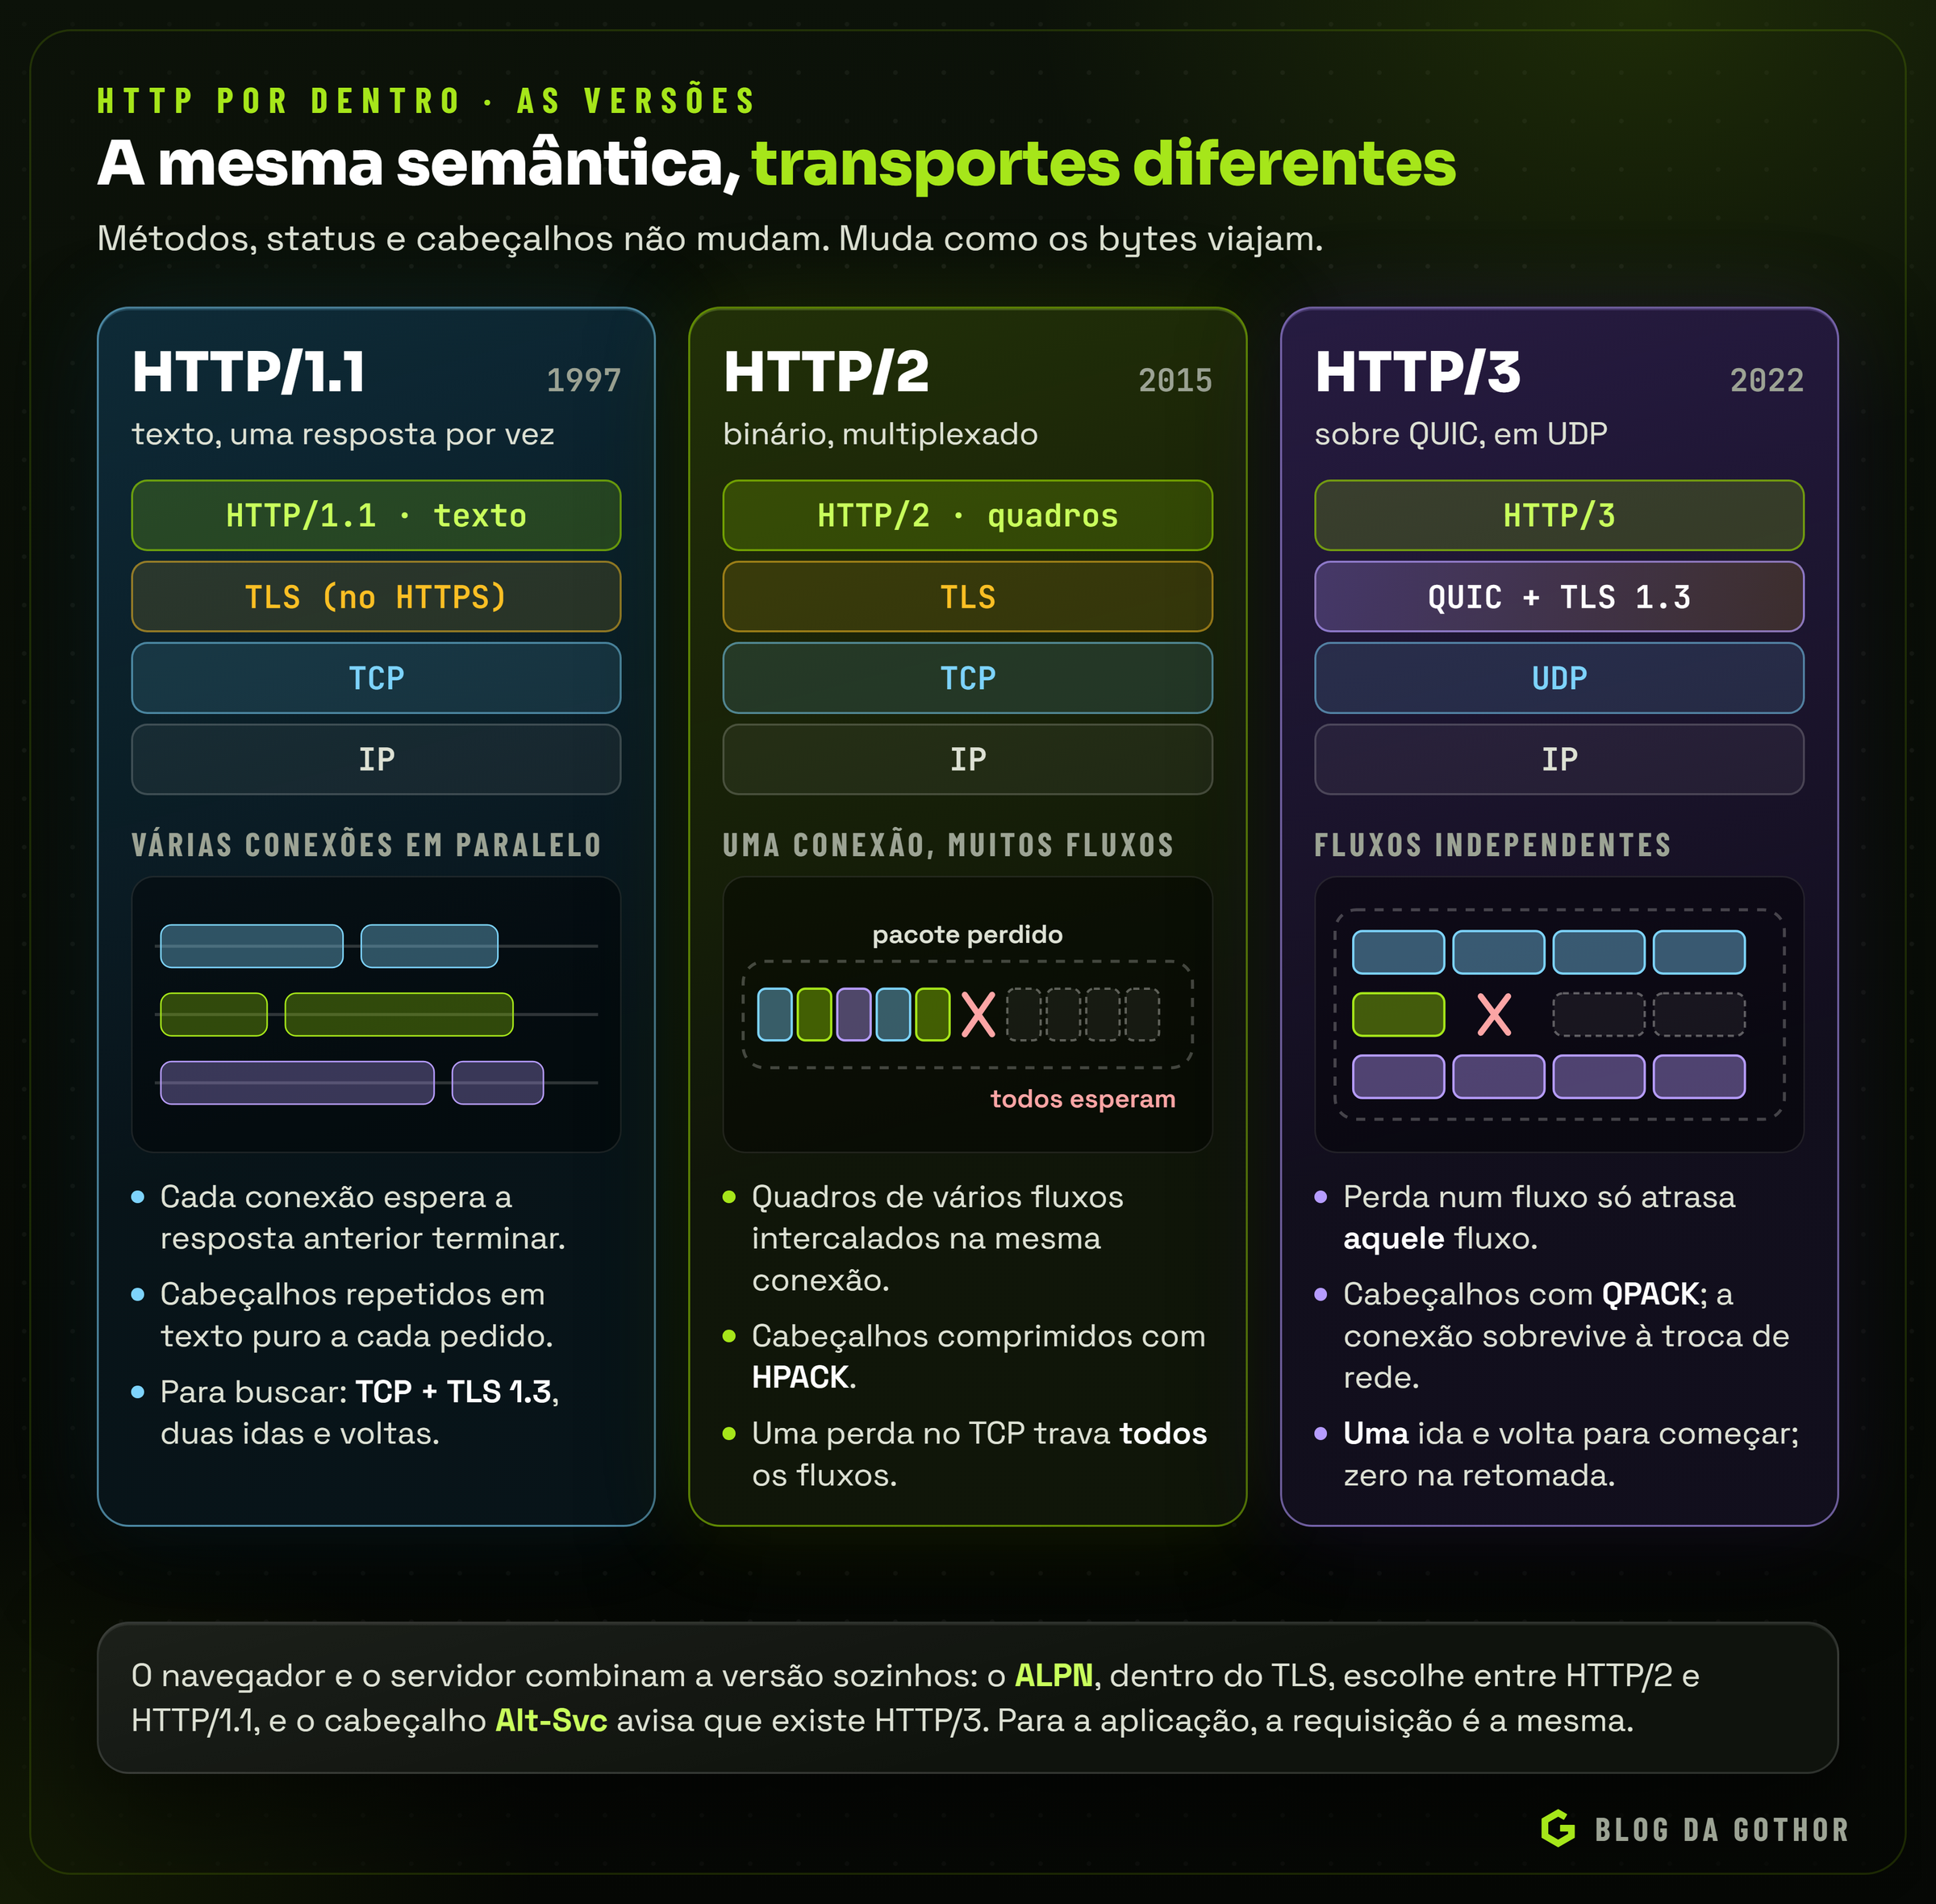
No HTTP/1.1, as mensagens são texto, e cada conexão TCP atende uma requisição por vez: a próxima só começa quando a resposta anterior termina. Para baixar dezenas de arquivos em paralelo, os navegadores abrem algumas conexões simultâneas por site.
O HTTP/2 passou a dividir as mensagens em quadros binários e a intercalar, numa única conexão, os quadros de muitas requisições ao mesmo tempo, cada uma num fluxo. Os cabeçalhos, que se repetem muito, passaram a ser comprimidos com o HPACK. O limite ficou no TCP: ele entrega os bytes em ordem, então um único pacote perdido faz todos os fluxos esperarem a retransmissão.
O HTTP/3 resolve isso trocando o transporte. Ele roda sobre o QUIC, que funciona em UDP e implementa por conta própria a confiabilidade, o controle de congestionamento e a criptografia, com o TLS 1.3 embutido. Cada fluxo é independente: uma perda atrasa só o fluxo afetado. A conexão começa com uma só ida e volta, ou nenhuma, ao retomar uma sessão recente, e sobrevive à troca de rede, como sair do Wi-Fi para o 4G, porque é identificada por um número próprio, e não pelo endereço IP.
Para a aplicação, a versão é quase invisível. O navegador e o servidor negociam o HTTP/2 durante o próprio handshake do TLS, com uma extensão chamada ALPN, e o servidor anuncia o HTTP/3 com o cabeçalho Alt-Svc. Em muitas arquiteturas, o proxy reverso fala HTTP/2 ou HTTP/3 com o navegador e HTTP/1.1 com a aplicação, na rede interna.
O que cada versão ensinou
O HTTP/1.1 tentou resolver a fila de requisições com o pipelining: enviar várias requisições seguidas sem esperar as respostas. A ideia esbarrou numa regra do próprio protocolo, a de que as respostas precisam voltar na mesma ordem. Uma resposta lenta segurava todas as de trás, o chamado bloqueio na cabeça da fila (head-of-line blocking), e proxies mal implementados embaralhavam as respostas. Os navegadores desligaram o recurso, e a solução prática virou abrir até seis conexões por site e espalhar os arquivos por vários domínios, o que multiplicava o custo de conexão descrito no início.
O HTTP/2 resolveu o bloqueio no nível da aplicação. Cada mensagem vira quadros (HEADERS e DATA, entre outros) marcados com o número do fluxo, e o receptor remonta cada mensagem a partir dos quadros dela. A compressão HPACK mantém, nas duas pontas, uma tabela dos cabeçalhos já enviados: o segundo pedido com o mesmo User-Agent e o mesmo cookie manda só uma referência à tabela. O HTTP/2 trouxe também o server push, em que o servidor enviava arquivos antes de o navegador pedir. Na prática, o recurso mandava com frequência o que o navegador já tinha em cache, e os principais navegadores o desligaram; o 103 Early Hints, que só sugere o que baixar, ocupou o lugar.
O HTTP/3 levou a mesma ideia para o transporte, e com ela vieram ajustes: a compressão de cabeçalhos passou a ser o QPACK, adaptada a fluxos que chegam fora de ordem. A retomada de sessão sem nenhuma ida e volta, o 0-RTT, tem um porém de segurança: os dados enviados nesse primeiro pacote podem ser capturados e reenviados por um atacante. Por isso os servidores só devem aceitar em 0-RTT requisições idempotentes, e podem responder 425 Too Early para as demais. O QUIC também tem um custo: implementar o transporte fora do sistema operacional gasta mais processador do que o TCP, que tem décadas de otimização dentro do kernel.
HTTPS: o mesmo HTTP, dentro do TLS
HTTPS não é outro protocolo: é o mesmo HTTP transportado dentro de uma conexão TLS, que oferece três garantias. Confidencialidade: ninguém no caminho lê o conteúdo. Integridade: ninguém altera os dados sem ser percebido. Autenticidade: o cliente tem certeza de que está falando com o servidor certo.
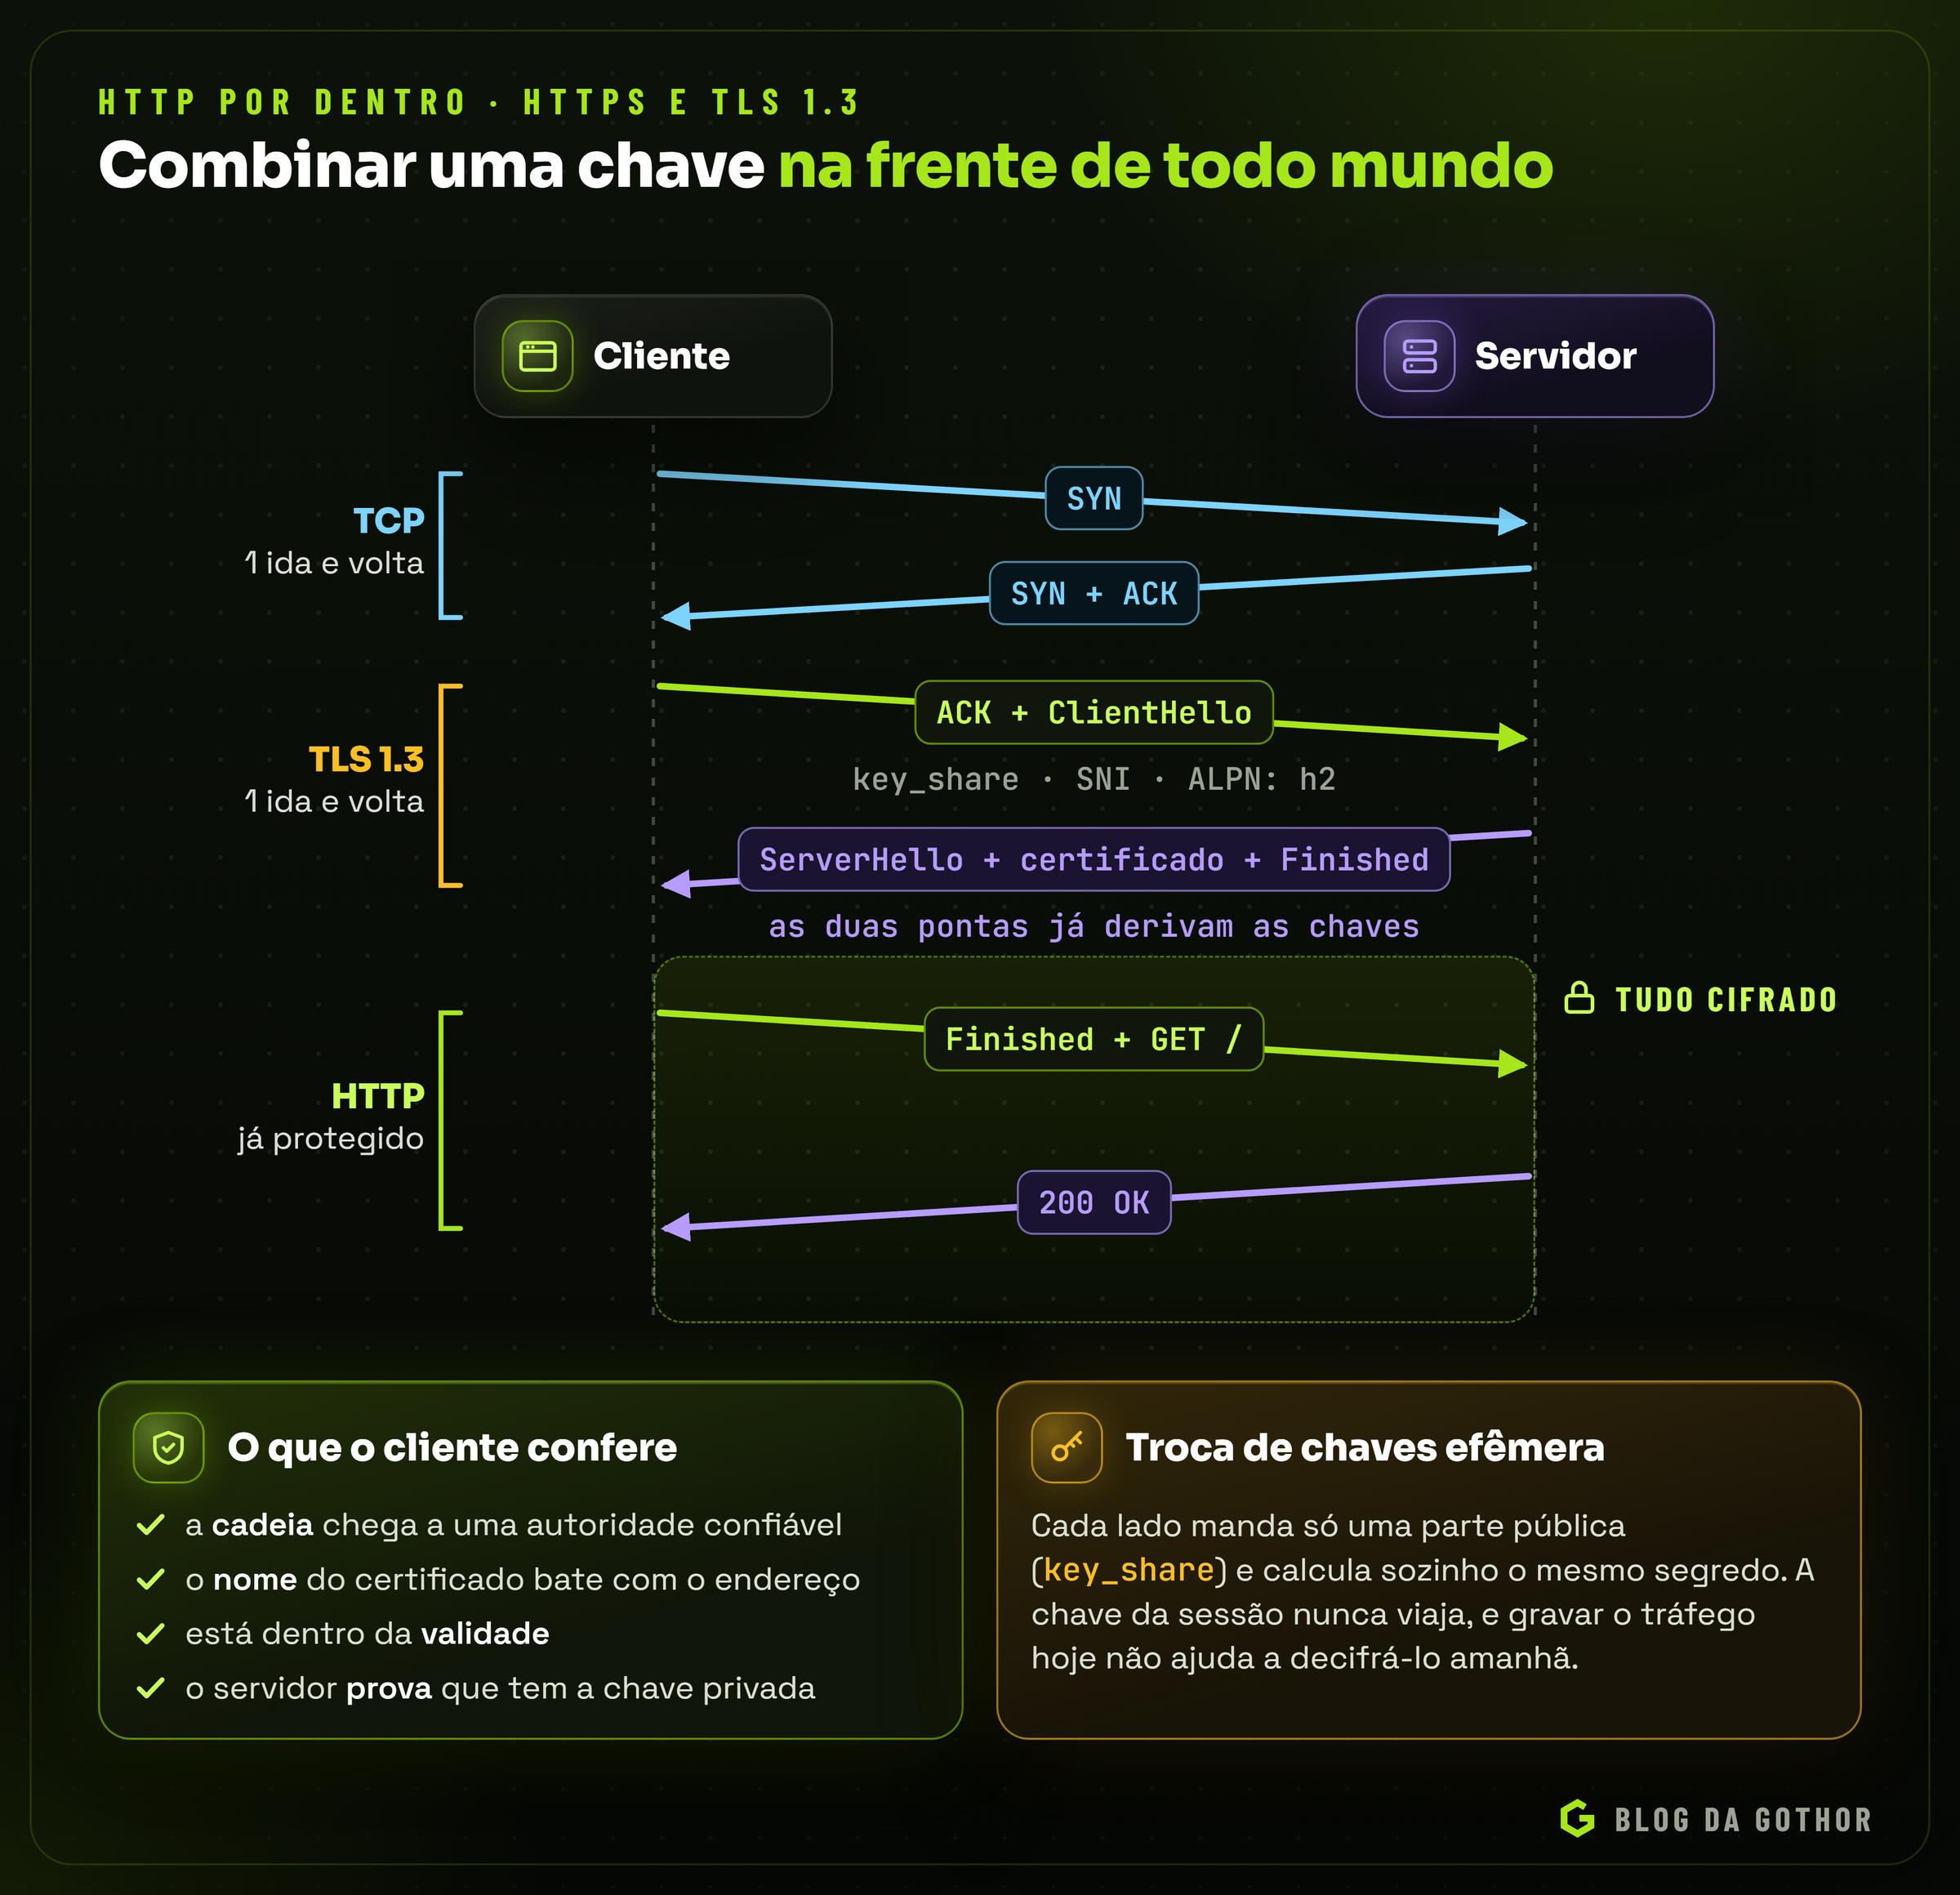
No TLS 1.3, de 2018, o cliente abre a conversa com o ClientHello, que leva as versões e cifras suportadas, a sua parte pública da troca de chaves, o nome do site (a extensão SNI, que permite vários certificados no mesmo IP) e os protocolos que aceita (ALPN). O servidor responde com a sua parte da troca de chaves e, a partir daí, as duas pontas calculam o mesmo segredo sem que ele trafegue pela rede. O certificado do servidor já segue cifrado, junto com a prova de que o servidor tem a chave privada correspondente. Uma ida e volta depois, a requisição HTTP já pode ser enviada.
O certificado liga um nome de domínio a uma chave pública e é assinado por uma autoridade certificadora em que o navegador confia. O cliente confere a cadeia de assinaturas, o nome, a validade e a prova de posse da chave. Desde 2016, a autoridade Let's Encrypt emite certificados gratuitos e automatizados pelo protocolo ACME, e renovar certificados deixou de ser uma tarefa manual. Certificados com validade curta, renovados automaticamente, são hoje o padrão.
Dois cuidados completam o quadro. Um site HTTPS deve redirecionar o HTTP puro com 301 e enviar o cabeçalho Strict-Transport-Security (HSTS), que faz o navegador usar só HTTPS naquele domínio dali em diante, sem nem tentar a versão insegura.
Mesma origem e CORS
Por segurança, o navegador aplica a política de mesma origem: um script de um site, a origem, que é a combinação de esquema, host e porta, não pode ler as respostas de requisições feitas para outra origem. Sem essa regra, qualquer página aberta numa aba poderia ler os seus e-mails em outra.
O CORS (Cross-Origin Resource Sharing) é o mecanismo que permite ao servidor abrir exceções. Quando um script de https://painel.exemplo.com.br chama https://api.exemplo.com.br, o navegador envia o cabeçalho Origin, e só entrega a resposta ao script se o servidor responder com Access-Control-Allow-Origin contendo aquela origem. Para requisições que não são "simples", como um PUT ou um POST com Content-Type: application/json, o navegador antes faz uma requisição de comprovação (preflight), um OPTIONS perguntando o que é permitido.
O ponto que mais gera confusão é este: o CORS é aplicado pelo navegador, e não pelo servidor. Ele não protege a API de chamadas feitas por curl, por outro servidor ou por um script qualquer; protege o usuário de páginas maliciosas. Autenticação e autorização continuam sendo trabalho da API.
Respostas em fluxo: consulta periódica, SSE e WebSocket
O modelo de pedido e resposta tem um limite óbvio: o servidor só fala quando alguém pergunta. Para mostrar uma notificação nova, o andamento de um processamento ou o texto de um assistente de IA sendo escrito palavra por palavra, há três caminhos.
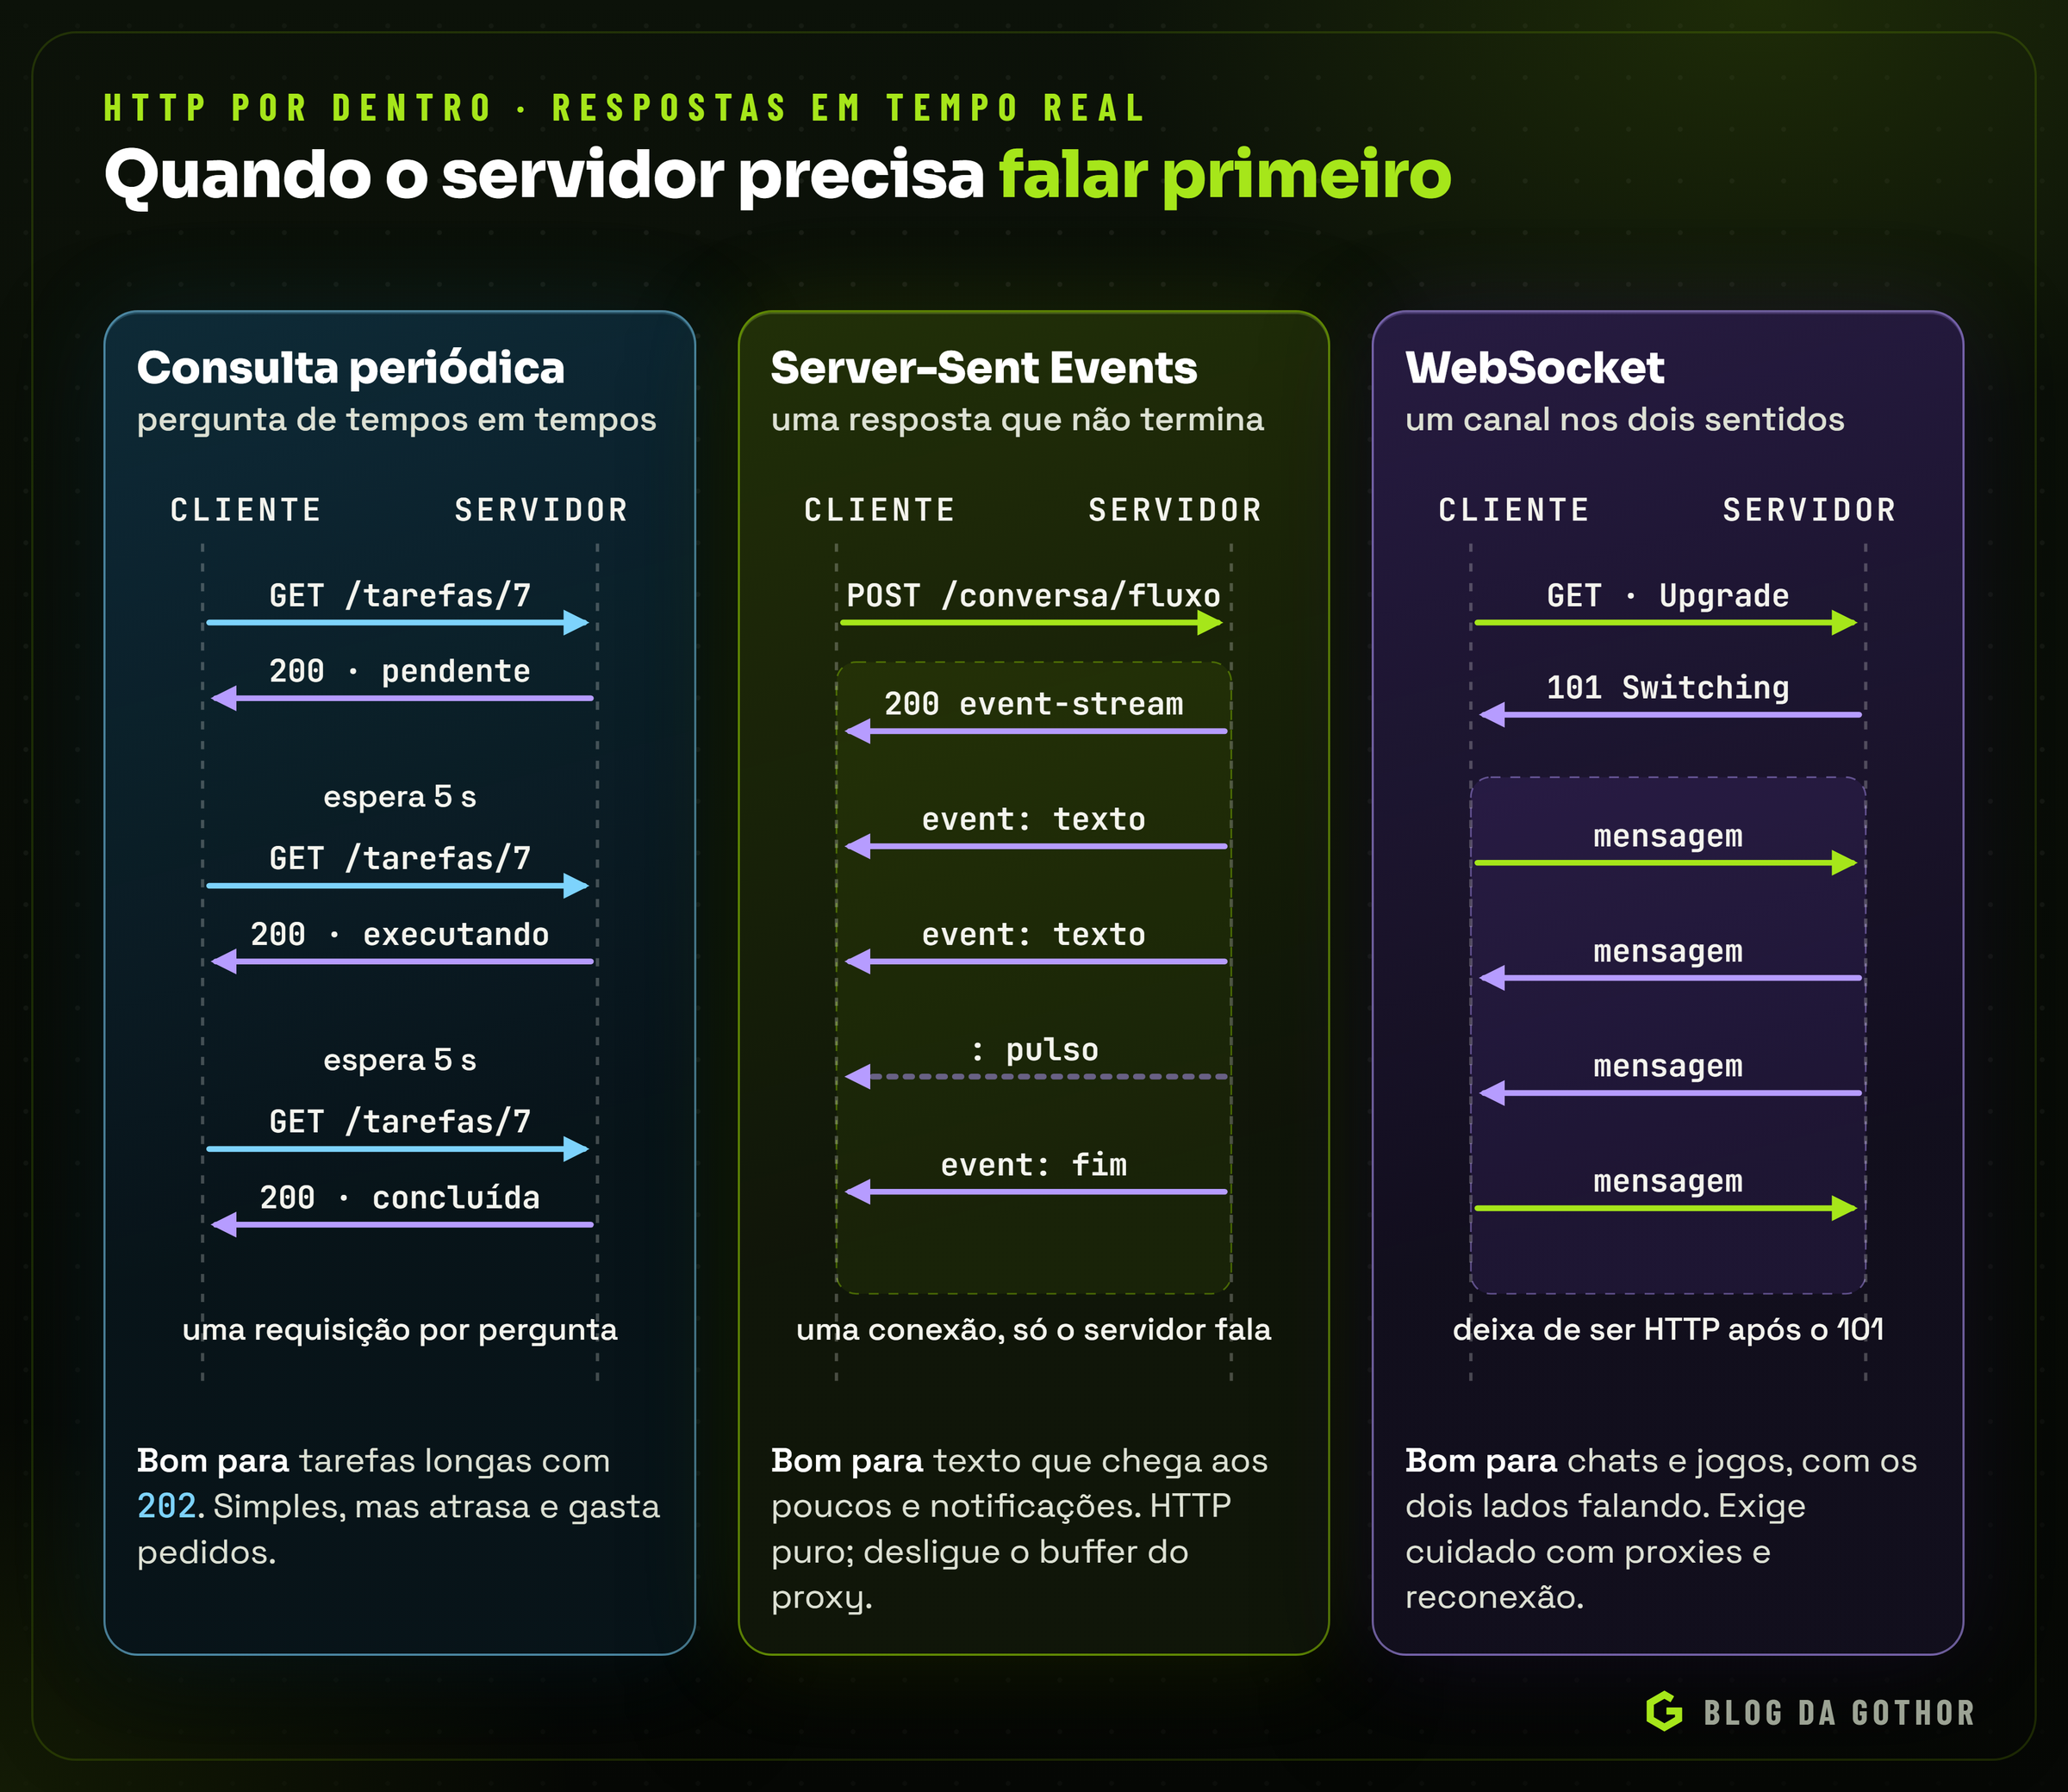
- Consulta periódica (polling). O cliente pergunta a cada poucos segundos: "já terminou?". É simples, funciona com qualquer servidor e combina bem com um
202 Accepted, mas gasta requisições quando nada mudou e chega sempre um pouco atrasada. - Server-Sent Events (SSE). O cliente faz uma requisição comum e o servidor não termina a resposta: vai escrevendo eventos à medida que acontecem, no formato
text/event-stream. Cada evento tem linhas comoevent: textoedata: {...}, e uma linha em branco o encerra. É HTTP puro, passa por proxies e funciona no HTTP/2 sem abrir conexões extras. O objetoEventSourcedo navegador reconecta sozinho e informa o último evento recebido no cabeçalhoLast-Event-ID; como ele só fazGETe não envia cabeçalhos próprios, clientes que precisam dePOSTe deAuthorizationleem o fluxo diretamente. - WebSocket. O cliente pede a troca de protocolo com
Upgrade: websocket, o servidor responde101 Switching Protocolse, a partir daí, a conexão deixa de ser HTTP: vira um canal de mensagens nos dois sentidos. É a escolha para conversas de verdade, como um chat com muitos participantes ou um jogo, e exige mais cuidado com proxies, balanceadores e reconexão.
Para quem só precisa receber atualizações, o SSE costuma ser a opção mais simples. Dois detalhes derrubam a maioria das implementações. Primeiro, os proxies costumam guardar a resposta em buffer antes de repassá-la, e o cliente recebe tudo de uma vez no fim; o servidor ou o proxy precisa desligar esse buffer. Segundo, conexões paradas são fechadas por tempo limite, então o servidor envia de tempos em tempos uma linha de comentário, que começa com dois-pontos, só para manter a conexão viva.
Clientes que aguentam a rede: tempo limite e tentativas
A rede falha, e um cliente HTTP bem escrito parte desse princípio. Três decisões fazem a diferença.
Todo pedido tem tempo limite. Sem ele, uma chamada a um serviço travado espera para sempre, prendendo memória, conexões e, no fim, o próprio serviço que chamou. Em JavaScript, o fetch aceita um sinal de cancelamento, e AbortSignal.timeout(8000) desiste depois de oito segundos. O valor certo depende do que está do outro lado: uma consulta simples merece poucos segundos; a geração de um relatório pesado, minutos, ou então uma tarefa assíncrona com 202.
Tentar de novo, mas com critério. Só faz sentido repetir o que pode ter sido um problema passageiro: falha de conexão, tempo esgotado, 502, 503, 504 e 429. Um 400 ou um 403 vão falhar igual. E só se repete o que é idempotente ou protegido por chave de idempotência. A espera entre as tentativas deve crescer, por exemplo 1, 2 e 4 segundos, com um pequeno sorteio somado, a chamada variação aleatória (jitter). Sem o sorteio, mil clientes que falharam juntos tentam de novo exatamente no mesmo instante e derrubam outra vez o servidor que estava se recuperando. Quando o servidor manda Retry-After, ele manda: espere o que foi pedido.
Reaproveitar conexões. Abrir uma conexão HTTPS custa idas e voltas, como vimos. Clientes que mantêm um conjunto de conexões abertas (keep-alive) e as reaproveitam entre pedidos economizam esse custo a cada chamada. O fetch do Node.js já faz isso por padrão; em outras linguagens, vale conferir se o cliente HTTP é criado uma vez e reutilizado, e não recriado a cada requisição.
O caminho real: proxies, gateways e balanceadores
Raramente o navegador fala direto com a aplicação. No caminho costuma haver uma CDN, um balanceador de carga e um proxy reverso, como o nginx, que recebe as conexões, cuida do TLS, aplica limites, comprime respostas, serve arquivos estáticos e repassa o restante para as aplicações, muitas vezes por HTTP simples numa rede interna.
Isso tem consequências práticas. A aplicação vê o IP do proxy, e não o do usuário; o proxy informa o IP original num cabeçalho como X-Forwarded-For, e a aplicação deve confiar nele só quando vem do proxy, ou qualquer cliente poderá mentir o próprio IP e escapar de um limite de requisições. Os tempos limite também se acumulam: se a aplicação demora mais do que o proxy aceita esperar, o usuário recebe um 504 mesmo que a aplicação termine o trabalho logo depois.
Projetando APIs HTTP
Um bom contrato HTTP é aquele que um cliente consegue usar sem ler o código do servidor. Algumas práticas consolidadas:
- Recursos como substantivos, ações como métodos:
GET /pedidos/1042,POST /pedidos,DELETE /pedidos/1042, em vez de/buscarPedidoe/apagarPedido. Nem toda operação cabe nesse modelo, e tudo bem usarPOSTpara ações, desde que de forma consistente. - Códigos de status corretos e um formato de erro único em toda a API, com uma mensagem útil para quem vai ler.
- Validação na fronteira: tudo o que chega é conferido contra um esquema antes de tocar a regra de negócio, e o erro de validação volta como
400ou422com o campo que falhou. - Paginação em toda listagem que pode crescer, por página ou por cursor, com um limite máximo.
- Idempotência nas operações que criam coisas importantes, com chaves de idempotência.
- Limites de requisição com
429eRetry-After. - Versionamento quando uma mudança vai quebrar clientes, mantendo a versão antiga por um período combinado.
- Tempos limite e tentativas no cliente, com espera crescente e só para o que é idempotente.
- Documentação legível por máquinas, como o OpenAPI.
Erros comuns
- **Responder
200com erro no corpo.** Monitoramento, caches e clientes passam a acreditar que deu tudo certo. - **Ações destrutivas em
GET.** Robôs e pré-buscas disparam links. - **Reenviar
POSTautomaticamente** depois de uma falha de rede, sem chave de idempotência. Pedidos e pagamentos duplicados. - **Confundir
no-cachecomno-store**, ou não definir cache nenhum e deixar cada intermediário decidir. - **Cookies de sessão sem
HttpOnly,SecureeSameSite.** - Achar que o CORS protege a API. Ele protege o usuário no navegador; a autorização é outra conversa.
- Liberar CORS para qualquer origem com credenciais. O navegador nem aceita essa combinação, e tentar contorná-la refletindo qualquer
Originabre a porta para outros sites agirem em nome do usuário. - **Confiar em
X-Forwarded-Forvindo de qualquer lugar.** - Chamadas sem tempo limite. Um serviço lento do outro lado prende conexões até derrubar o seu.
Como usamos HTTP na Gothor
Na Gothor, quase tudo o que roda em servidor conversa por HTTP, e várias decisões do protocolo aparecem no código de forma deliberada.
Um proxy reverso na frente de tudo. Na VPS, o nginx recebe todo o tráfego de gothor.com.br, com certificados do Let's Encrypt emitidos e renovados automaticamente pelo Certbot, e repassa cada caminho para o serviço certo: o painel e a API do CRM, as páginas e a API deste blog, a API do app Tarefas. Os serviços que só o nginx precisa alcançar escutam apenas no endereço local da máquina. Nos repasses, o nginx envia o X-Forwarded-For, e as aplicações em Express e NestJS confiam nesse cabeçalho só quando ele chega do próprio servidor ou da rede interna do Docker, para que os limites por IP enxerguem o visitante, e não o proxy. Uma lição aprendida na prática: todo bloco server do nginx precisa escutar também em IPv6, porque, com o domínio publicado em IPv6, um bloco só com IPv4 faz o visitante que chega por IPv6 cair em outro site da mesma máquina, com o certificado errado.
Cache pensado por tipo de resposta. As páginas deste blog são montadas no servidor, com React e Express, e cada resposta diz como pode ser guardada. O HTML de quem não está logado sai com Cache-Control: public, max-age=60 e Vary: Cookie; com sessão de leitor, sai private, no-cache; páginas que levam um token na URL, como a de redefinir a senha, saem com no-store e Referrer-Policy: no-referrer, para que o token não vaze para outros sites. Os arquivos de CSS e JavaScript têm o hash no nome e ficam um ano em cache, com immutable. As imagens do blog também são imutáveis e saem com Cross-Origin-Resource-Policy: cross-origin, porque as redes sociais e os leitores de e-mail buscam a capa a partir de outros domínios. O feed RSS fica 15 minutos em cache, e o sitemap, uma hora.
Cabeçalhos de segurança em toda resposta. O servidor do blog envia uma Content Security Policy que só permite scripts do próprio site e proíbe que as páginas sejam abertas dentro de um frame de outro site, além de X-Content-Type-Options: nosniff, Referrer-Policy e Permissions-Policy, que desliga câmera, microfone e localização. A API do CRM usa o Helmet, que aplica um conjunto parecido.
Sessão em cookie bem configurado. A sessão dos leitores do blog é um cookie HttpOnly, Secure e SameSite=Lax, restrito ao caminho /blog. Como proteção extra, as rotas públicas da API do blog recusam com 403 as chamadas cujo Origin não seja o do próprio site. Os formulários e as rotas sensíveis têm limites de envio por IP e respondem 429 quando o limite é atingido; o formulário de contato do site, por exemplo, aceita até cinco envios a cada dez minutos por IP. Quem já está logado e abre a página de entrar é redirecionado para a própria conta com 303 See Other.
Validação na fronteira e corpos limitados. Nas APIs em NestJS, o corpo de cada requisição é validado com esquemas do Zod antes de chegar à regra de negócio, e um erro de validação volta como 400 com uma mensagem em português. A API do CRM limita o corpo JSON a 1 MB, o suficiente para um post do blog de até 100 mil caracteres, e comprime as respostas com gzip, porque algumas listagens passam de 15 MB em JSON.
Métodos escolhidos pelo uso. As leituras públicas do blog são GET, porque precisam de cache e de endereços que possam ser compartilhados. Já a maior parte das rotas internas do CRM usa POST com um corpo em JSON, inclusive para consultas com filtros, no estilo de chamada de procedimento. É uma escolha consciente: para um painel interno, com filtros complexos e sem cache compartilhado, a consistência de um único formato pesa mais do que a pureza do modelo REST.
A Juniper responde em fluxo. O juniper-motor, o serviço que conversa com o Gemini, o Claude e o GPT para a Juniper, entrega as respostas por SSE em POST /conversa/fluxo. O texto chega em eventos texto, conforme o modelo escreve; cada consulta ao CRM gera um evento ferramenta, para o aplicativo mostrar o que está acontecendo; e um evento fim fecha a rodada com a resposta inteira e o consumo de tokens. Os erros que dá para saber antes, como corpo inválido (400), conversa inexistente (404) e limite do dia esgotado (429), saem como status HTTP normais, antes de o fluxo começar; o que falha depois vira um evento erro. A resposta sai com Cache-Control: no-cache, no-transform e X-Accel-Buffering: no, e o nginx tem proxy_buffering off, para que o texto não fique preso no proxy. A cada 15 segundos sem eventos, o motor envia o comentário : pulso, que impede o nginx de encerrar a conexão por inatividade. E se o aplicativo fecha a conexão no meio, o motor cancela o pedido ao provedor de IA e para de gastar tokens.
**Trabalho longo vira tarefa, com 202.** O que passa do tempo razoável de uma requisição, como um resumo que consulta o CRM várias vezes, entra por POST /tarefas, que responde 202 Accepted com o identificador da tarefa. O pedido segue pelo Kafka até um trabalhador, e o aplicativo acompanha a situação em GET /tarefas/:id, que passa de pendente a executando e termina em concluida ou falhou. Uma tarefa tem até 600 segundos por padrão; passado o prazo, falha com o código 504. O pedido para esquecer a memória de longo prazo de uma pessoa, DELETE /memoria/eu, também responde 202: o esquecimento acontece logo em seguida, pelo Kafka.
Um token, várias portas. Os aplicativos da Juniper e o painel do CRM falam com o motor usando o mesmo JWT do login do CRM, no Authorization: Bearer, assinado com HS256; o motor confere a assinatura e usa o mesmo token para consultar o CRM em nome da pessoa, com as permissões dela. Sem token, ou com token inválido, a resposta é 401. Cada pessoa tem um limite de requisições por minuto (60, por padrão), que responde 429 com Retry-After, e o nginx do motor limita o tráfego por IP a 10 requisições por segundo, com folga para rajadas curtas. Uma conversa de outra pessoa responde 404, como se não existisse, para não revelar nem que ela existe.
Tempo limite em toda chamada de saída. O servidor das páginas deste blog espera no máximo 8 segundos pela API e guarda por 30 segundos, em memória, as respostas que não dependem de quem está lendo. A integração do CRM com o GoPay espera até 120 segundos; um tempo esgotado vira 504, e uma falha de conexão vira 502, cada um com uma mensagem clara para a equipe. O token do GoPay é reaproveitado por dez minutos, e várias consultas simultâneas que precisam de um token novo esperam o mesmo pedido de login, em vez de dispararem um login cada uma; se o GoPay responde 401, o CRM descarta o token e tenta uma vez com um novo. As chamadas às redes sociais, no módulo Publicações, esperam até 30 segundos. A conexão com o LinkedIn segue o OAuth 2.0, com a troca do código por um token e a renovação por refresh token, e as imagens sobem com um PUT direto para o endereço de envio que o LinkedIn informa. Depois de enviar uma mídia, o CRM consulta periodicamente o processamento: no Instagram, a cada 3 segundos, por até 20 consultas.
Saúde e erros com o código certo. Cada serviço tem um endereço de saúde barato, que responde com no-store e é usado pelo healthcheck do Docker. Quando a API do CRM está fora do ar, o servidor do blog responde com uma página 503; um post que não existe responde 404 com a página de erro do blog. O servidor das páginas também envia à API um cabeçalho próprio só quando a visita vem de uma pessoa, e não de um robô, para que as leituras de cada post contem apenas visitas reais.
Perguntas frequentes
Como descubro onde está a lentidão de uma requisição? O curl mede cada etapa com a opção -w, por exemplo curl -o /dev/null -s -w "dns %{time_namelookup} conexão %{time_connect} tls %{time_appconnect} primeiro byte %{time_starttransfer} total %{time_total}\n" https://.... Se o tempo até o primeiro byte domina, o problema está no servidor; se o DNS ou a conexão dominam, está na rede. A aba Rede do navegador mostra a mesma divisão, em barras coloridas, ao passar o mouse sobre uma requisição.
401 ou 403? 401 quando o servidor não sabe quem é a pessoa, e um novo login pode resolver. 403 quando sabe, e a resposta é não.
**Posso guardar o token no localStorage?** Pode, mas qualquer script que rode na página consegue lê-lo. Para aplicações web, um cookie HttpOnly, Secure e SameSite é mais seguro; em aplicativos nativos, o armazenamento seguro do sistema operacional cumpre esse papel.
Preciso me preocupar com HTTP/3? Para quem escreve a aplicação, quase nunca: quem negocia a versão são o navegador e o servidor da frente, como a CDN ou o proxy reverso. O ganho aparece sobretudo em redes móveis, com perda de pacotes e troca de rede.
É seguro colocar dados na URL? Não para dados sensíveis. A URL aparece no histórico do navegador, nos registros dos servidores e, sem o devido cuidado, no cabeçalho Referer enviado a outros sites. Senhas, tokens de longa duração e dados pessoais vão no corpo ou nos cabeçalhos.
Resumo
- O HTTP é um protocolo de requisição e resposta, sem estado, extensível por cabeçalhos, com a semântica separada do transporte.
- Antes do primeiro byte vêm o DNS, a conexão TCP e o TLS; quase toda otimização corta idas e voltas.
- Toda mensagem tem linha inicial, cabeçalhos, linha em branco e corpo; o
curl -ve a aba Rede mostram a conversa. - Métodos seguros não alteram nada; idempotentes podem ser repetidos.
POSTrepetido exige chave de idempotência, eIf-Matchevita a atualização perdida. - O código de status diz o que aconteceu; o corpo dá os detalhes. Nunca
200com erro. - Cookies guardam estado com
HttpOnly,SecureeSameSite; tokens vão noAuthorization, e o conteúdo de um JWT é legível por qualquer um. - O cache tem frescor e revalidação;
no-cacherevalida,no-storenão guarda, e arquivos com hash no nome podem ser imutáveis. - HTTP/2 multiplexa numa conexão TCP; HTTP/3 usa o QUIC e torna os fluxos independentes.
- HTTPS é HTTP dentro do TLS; o TLS 1.3 combina as chaves numa ida e volta, e o HSTS impede o retorno ao HTTP puro.
- O CORS protege o usuário no navegador, não a API.
- Para o servidor falar primeiro: consulta periódica, SSE ou WebSocket; SSE pede o buffer do proxy desligado.
- Todo cliente tem tempo limite e só repete, com espera crescente, o que é idempotente.
Para ir além
- HTTP na MDN, a referência mais completa e acessível, em português.
- RFC 9110, a semântica do HTTP, e RFC 9111, o cache.
- RFC 9113, HTTP/2, RFC 9114, HTTP/3 e RFC 9000, QUIC.
- RFC 8446, TLS 1.3 e como funciona o Let's Encrypt.
- RFC 9457, Problem Details para APIs HTTP.
- RFC 7519, JSON Web Token, e RFC 6749, OAuth 2.0.
- Server-Sent Events na MDN e RFC 6455, o protocolo WebSocket.
- CORS na MDN e cookies na MDN.
- Especificação OpenAPI.
- Documentação do curl.
Este post foi escrito com a ajuda da Juniper, a assistente de IA da Gothor, e revisado pela nossa equipe antes de ir ao ar.