SQL por dentro: como os bancos relacionais guardam, consultam e protegem os seus dados
Uma imersão no SQL e nos bancos relacionais, do modelo de tabelas às junções, índices, planos, transações e migrações sem parada, com as diferenças entre PostgreSQL e Oracle e o jeito como usamos SQL na Gothor.
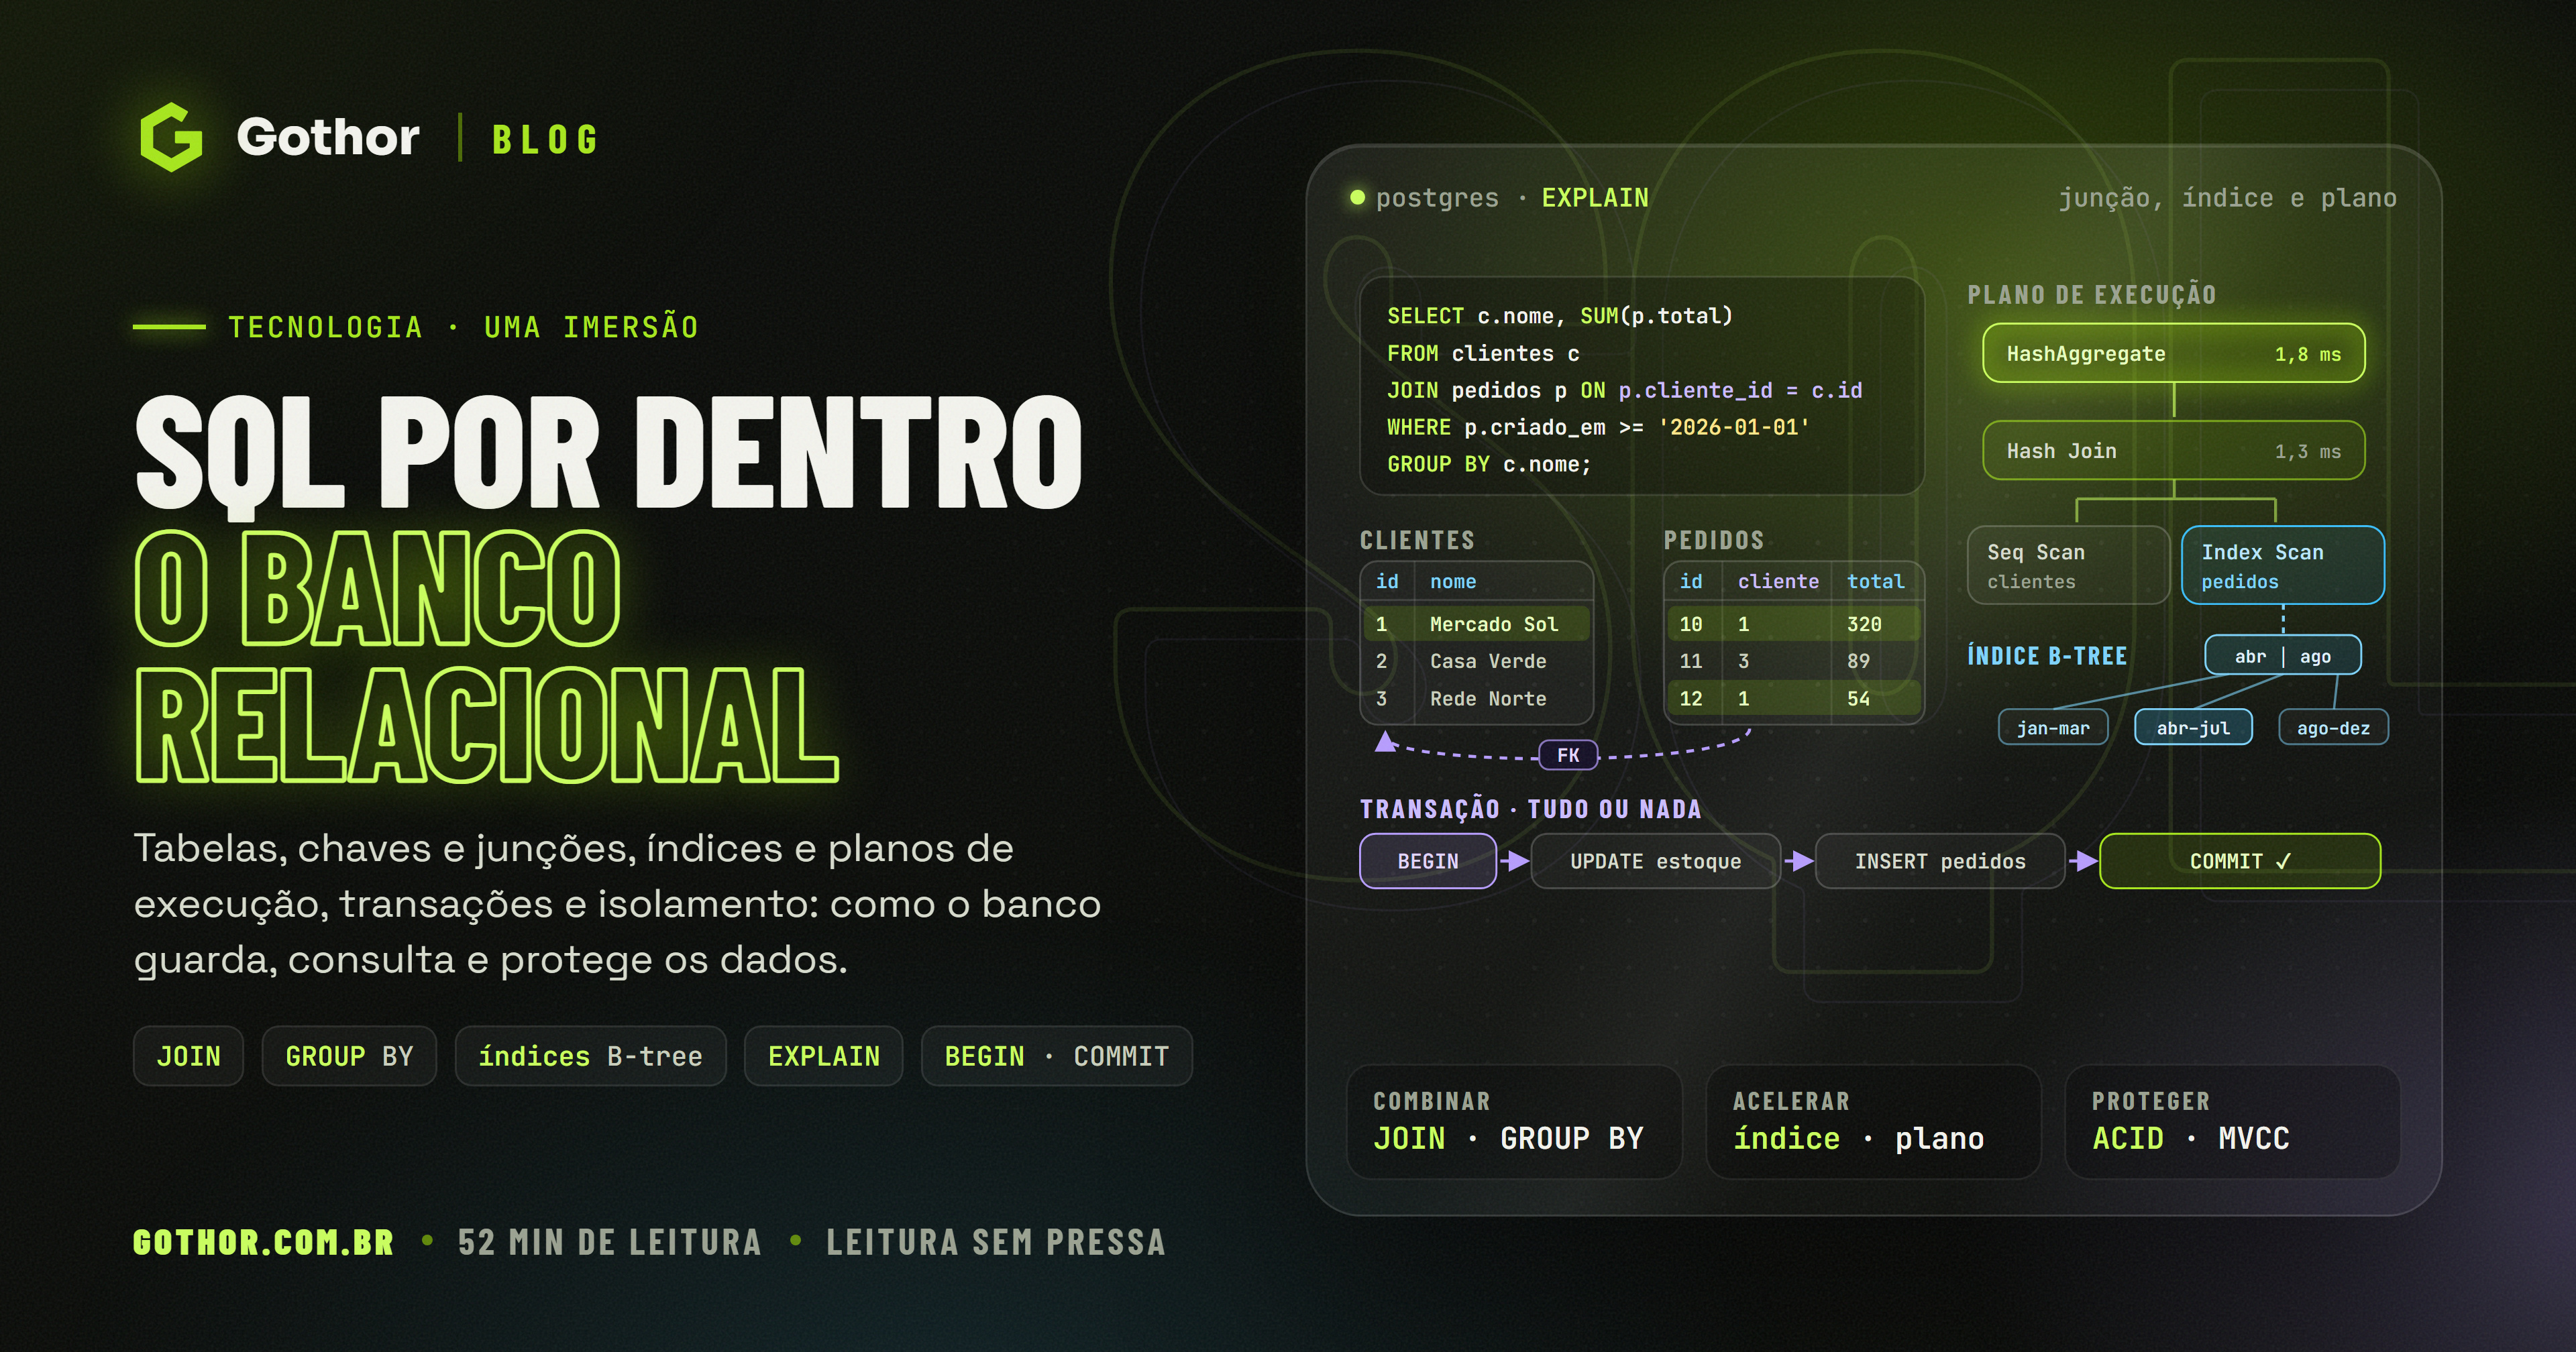
Quase todo sistema de gestão guarda o que importa num banco relacional: clientes, produtos, pedidos, títulos a receber, estoque. E quase toda pergunta que uma empresa faz a esses dados, de "quanto vendemos ontem nesta filial" a "quais clientes têm títulos vencidos há mais de 30 dias", vira, em algum momento, uma consulta em SQL. A linguagem tem mais de cinquenta anos e continua no centro de praticamente toda aplicação que lida com dinheiro, estoque ou cadastro.
Muita gente, porém, aprende SQL como um conjunto de receitas, até a consulta que leva dez segundos sem que ninguém saiba por quê, ou o relatório cujo total não bate com o do financeiro. Este artigo faz o caminho de dentro para fora: o modelo relacional, a anatomia de uma consulta, as armadilhas das junções e do NULL, um relatório real montado passo a passo, o que o banco faz por dentro, índices, planos e transações, como mudar a estrutura sem parar a operação, os erros mais comuns e o jeito como usamos bancos relacionais na Gothor.
O que é SQL
SQL (de Structured Query Language) é a linguagem padrão para definir, consultar e modificar dados em bancos relacionais. A característica mais importante dela é ser declarativa: você descreve o que quer, e não como obter.
SELECT sum(valor_total)
FROM pedidos
WHERE cliente_id = 42;
Não há laço, não há ordem de leitura, não há instrução sobre usar ou não um índice. Quem decide tudo isso é o otimizador do banco, que avalia várias estratégias e escolhe a que estima ser mais barata. Essa separação é o que permite que a mesma consulta continue correta quando a tabela passa de mil para cem milhões de linhas, e é também o motivo de o desempenho depender tanto de coisas que não aparecem no texto, como índices e estatísticas.
Os comandos se dividem em definição da estrutura (CREATE, ALTER, DROP), manipulação dos dados (SELECT, INSERT, UPDATE, DELETE), permissões (GRANT, REVOKE) e transações (BEGIN, COMMIT, ROLLBACK).
A matemática por baixo
O SQL é a forma prática de uma teoria: a álgebra relacional. Nela, uma tabela é um conjunto de linhas, e toda consulta é uma composição de poucas operações que recebem tabelas e devolvem tabelas. A seleção escolhe linhas (o WHERE), a projeção escolhe colunas (a lista do SELECT), a junção combina linhas de duas tabelas, e há ainda a união, a diferença e o agrupamento. Como cada operação devolve uma tabela, o resultado de uma pode alimentar a outra, e é por isso que subconsultas e CTEs se encaixam em qualquer lugar onde caberia uma tabela.
Essa base é o que dá liberdade ao otimizador: expressões equivalentes na álgebra produzem o mesmo resultado, e o banco troca uma pela outra se for mais barata, como filtrar antes de juntar. Uma diferença entre teoria e prática: na álgebra, uma relação não tem linhas repetidas; no SQL, uma tabela pode ter duplicatas, e elas só somem com DISTINCT ou com uma chave.
Uma história curta: de uma ideia matemática a padrão mundial
Em 1970, Edgar F. Codd, pesquisador da IBM, publicou o artigo "A Relational Model of Data for Large Shared Data Banks". Até então, os bancos eram hierárquicos ou em rede: o programa navegava por ponteiros de um registro a outro, e mudar a forma de guardar os dados obrigava a reescrever os programas. Codd propôs representar todos os dados como relações (as tabelas), manipulá-las com operações matemáticas bem definidas e separar a forma lógica dos dados da forma física de armazená-los.
Na IBM, o projeto System R transformou a ideia em software, e em 1974 Donald Chamberlin e Raymond Boyce apresentaram a linguagem SEQUEL, que depois virou SQL por uma questão de marca registrada. A primeira empresa a vender um banco relacional com SQL foi a Relational Software, que lançou o Oracle em 1979 e mais tarde adotou o nome do produto. A IBM lançou o DB2 em 1983.
A linguagem virou padrão da ANSI em 1986 e da ISO em 1987, e cresceu em revisões: o SQL-92 trouxe as junções explícitas; o SQL:1999, as consultas recursivas; o SQL:2003, as funções de janela; e as edições recentes, o suporte a JSON. Nenhum banco implementa o padrão inteiro.
O nome formal do padrão é ISO/IEC 9075, e ele não é um documento só, mas uma coleção de partes: a base da linguagem fica na parte 2, a Foundation, e outras tratam de procedimentos armazenados (SQL/PSM), dados externos (SQL/MED), XML e matrizes multidimensionais. A edição mais recente é a de 2023, o SQL:2023, que trouxe uma parte nova, a 16, para consultas a grafos de propriedades (SQL/PGQ): perguntas do tipo "quem está ligado a quem, por quantos passos", escritas sobre tabelas comuns. Cada edição substitui a anterior, e por isso dizer que um banco "segue o SQL:1999" não tem mais valor oficial; o que importa é quais recursos de cada parte ele implementa. O PostgreSQL, nascido do projeto POSTGRES de Michael Stonebraker em Berkeley, ganhou SQL em 1995 e o nome atual em 1996, e lança uma versão principal por ano.
O SQL também sobreviveu a quem anunciou o fim dele. No fim dos anos 2000, a onda dos bancos NoSQL prometia escala abandonando o modelo relacional e as transações; muitos encontraram o seu lugar, em cache, busca e eventos, mas vários ganharam linguagens parecidas com SQL, e os relacionais incorporaram JSON e replicação. Hoje o SQL está em servidores e, pelo SQLite, em praticamente todo celular.
O modelo relacional: tabelas, chaves e relações
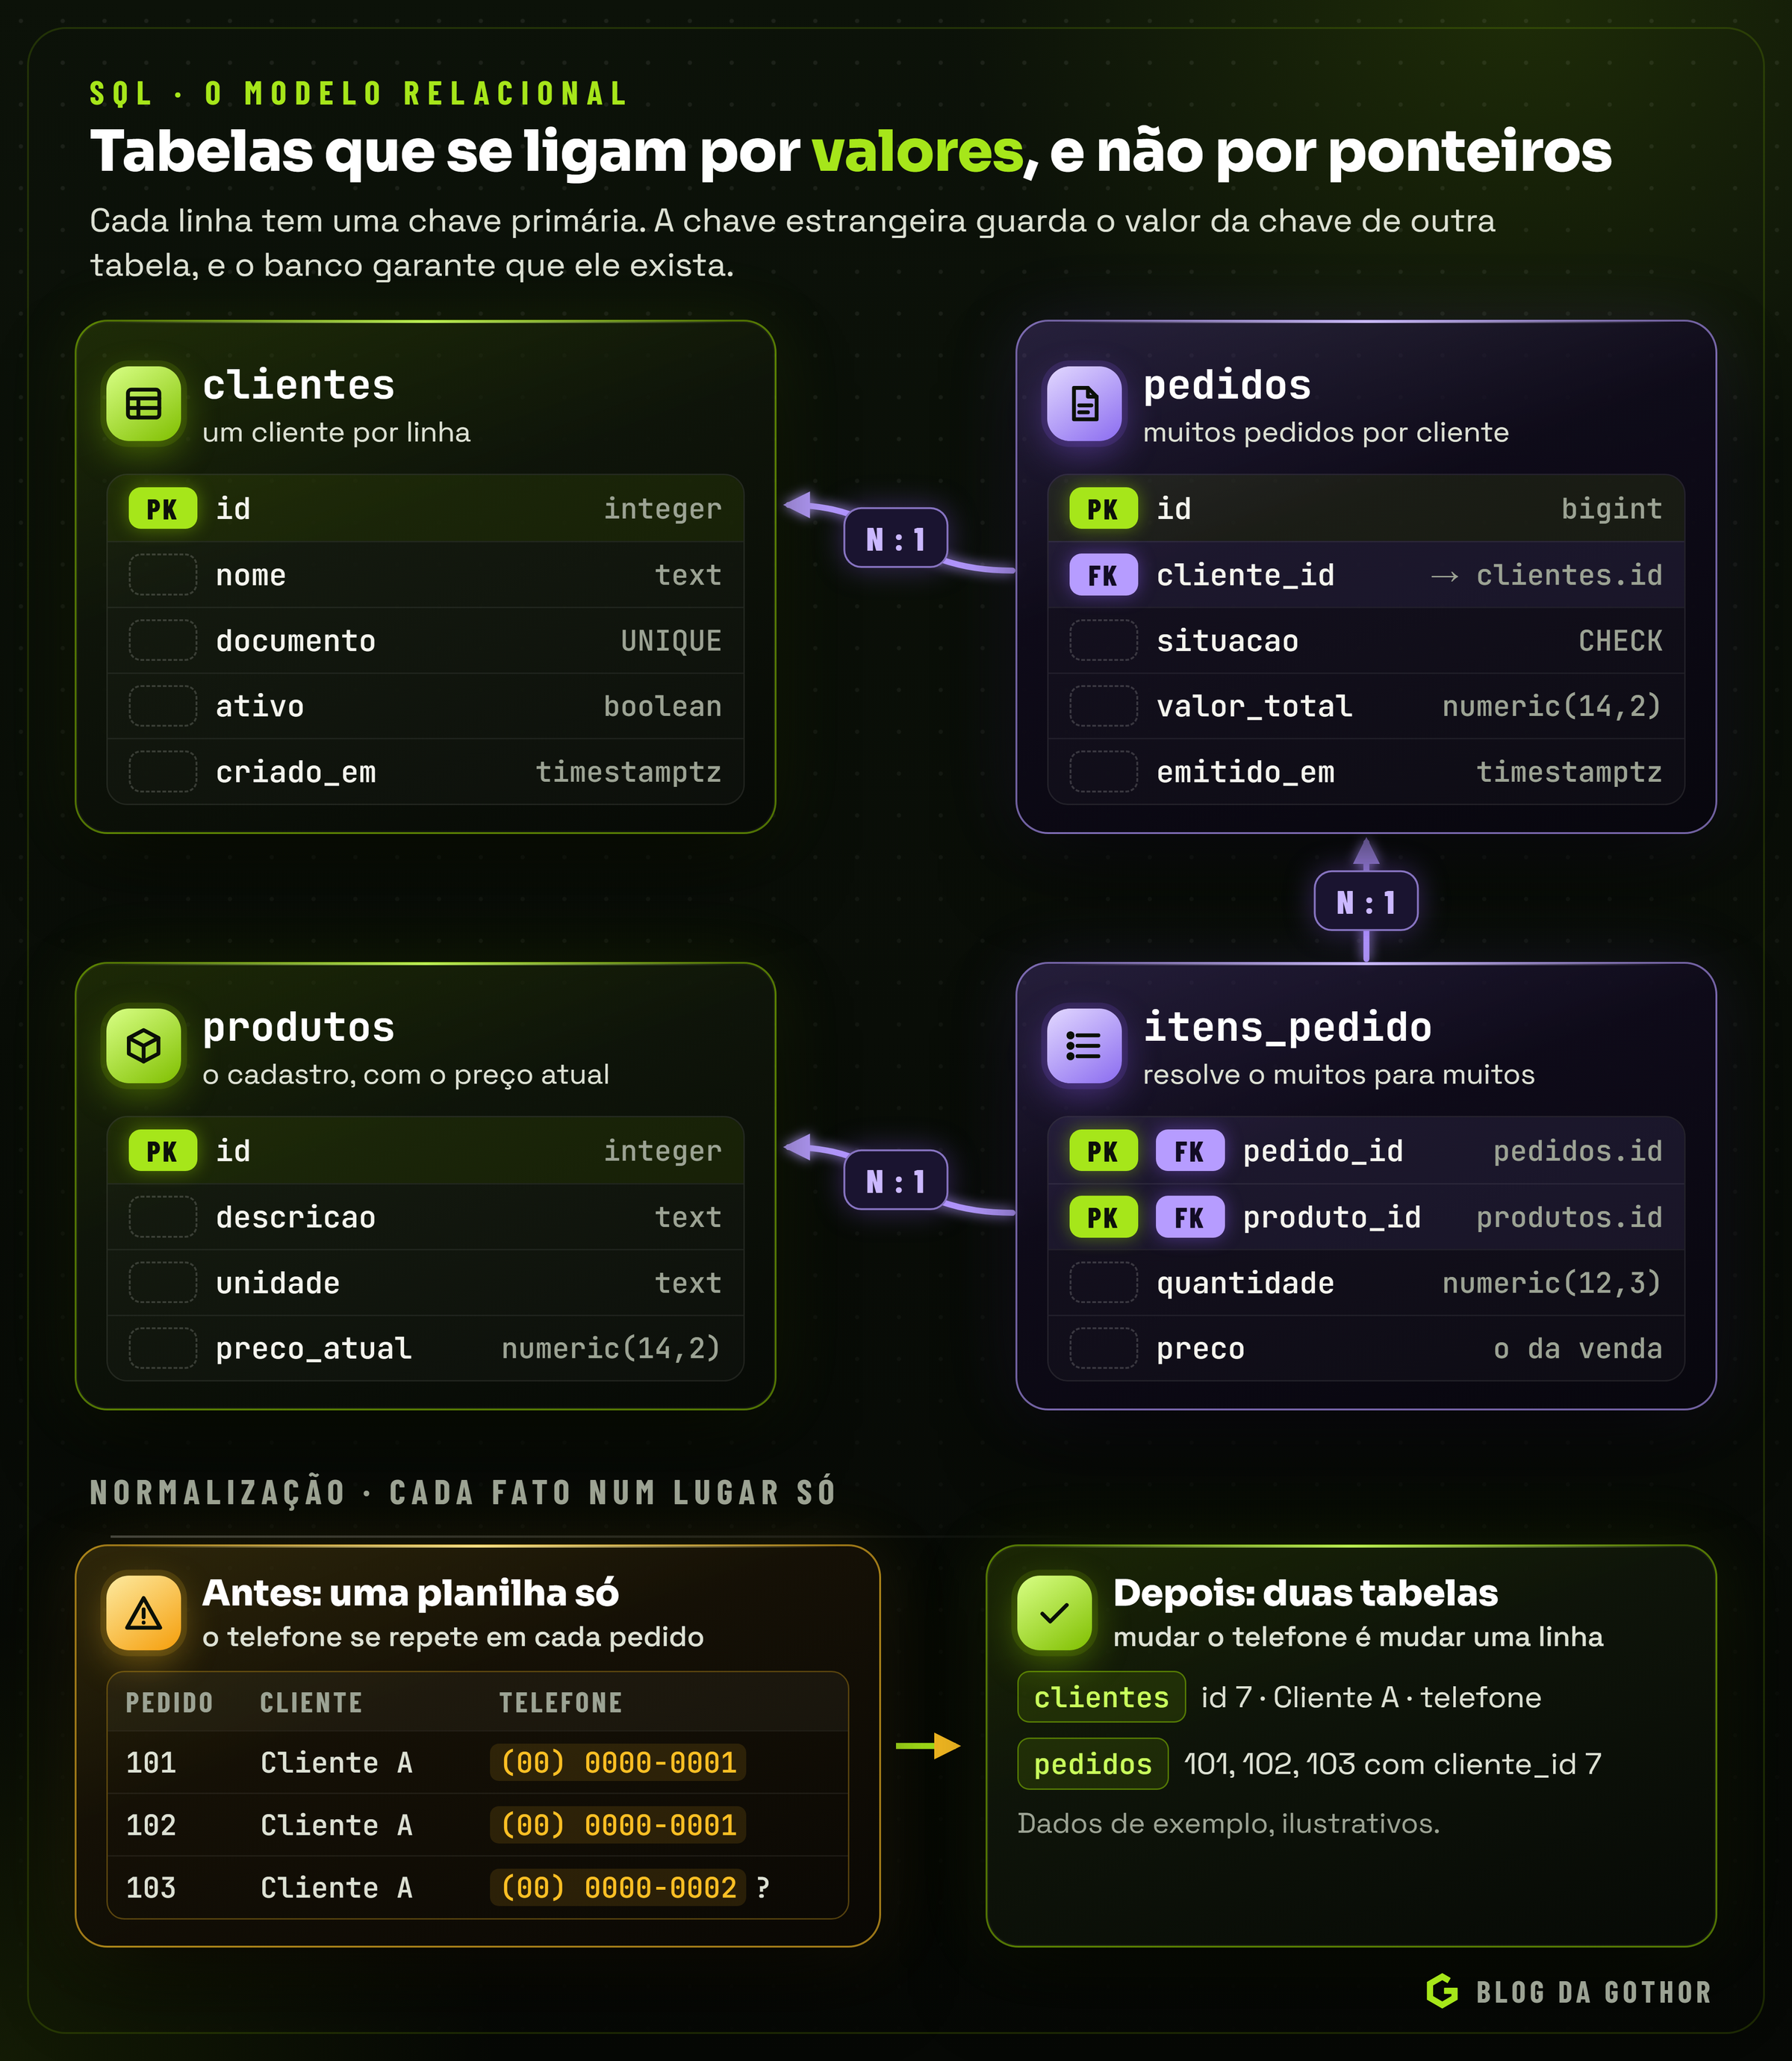
No modelo relacional, os dados vivem em tabelas. Cada tabela representa um tipo de coisa, cada linha é uma ocorrência dessa coisa e cada coluna é um atributo, com um tipo definido. Duas ideias tornam o modelo poderoso: toda linha pode ser identificada de forma única, e as tabelas se relacionam por valores, e não por ponteiros.
Chaves primárias e estrangeiras
A chave primária identifica cada linha: não pode se repetir nem ficar vazia. A chave estrangeira guarda a chave primária de outra tabela e, com isso, cria a relação. O banco garante que ela aponte para algo que existe: não é possível gravar um pedido para um cliente inexistente, nem apagar um cliente que ainda tem pedidos, a menos que você diga o que fazer nesse caso.
CREATE TABLE clientes (
  id          integer GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
  nome        text        NOT NULL,
  documento   varchar(14) NOT NULL UNIQUE,
  criado_em   timestamptz NOT NULL DEFAULT now()
);

CREATE TABLE pedidos (
  id          bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
  cliente_id  integer       NOT NULL REFERENCES clientes (id),
  situacao    text          NOT NULL CHECK (situacao IN ('aberto', 'faturado', 'cancelado')),
  valor_total numeric(14,2) NOT NULL CHECK (valor_total >= 0),
  emitido_em  timestamptz   NOT NULL DEFAULT now()
);

CREATE TABLE itens_pedido (
  pedido_id   bigint        NOT NULL REFERENCES pedidos (id) ON DELETE CASCADE,
  produto_id  integer       NOT NULL REFERENCES produtos (id),
  quantidade  numeric(12,3) NOT NULL CHECK (quantidade > 0),
  preco       numeric(14,2) NOT NULL,
  PRIMARY KEY (pedido_id, produto_id)
);
A chave primária de itens_pedido é composta pelas duas colunas, o que impede o mesmo produto duas vezes no mesmo pedido, e o ON DELETE CASCADE apaga os itens junto com o pedido. Entre clientes e pedidos, a relação é de um para muitos; entre pedidos e produtos, de muitos para muitos, resolvida pela tabela intermediária de itens.
O que acontece quando a linha apontada some é uma decisão de modelagem, e há quatro respostas comuns: recusar a exclusão (o padrão), apagar junto (CASCADE, bom para partes que não existem sem o todo, como itens de um pedido), soltar a ligação (SET NULL, bom quando o registro filho continua fazendo sentido sozinho, como um post cuja categoria foi apagada) e, às vezes, não declarar a chave estrangeira, quando o registro precisa sobreviver ao apagamento do outro por motivo de histórico. A última opção é legítima, mas deve ser uma decisão escrita, e não um esquecimento.
Chave natural ou chave substituta
Uma chave natural é um dado do próprio negócio que já identifica a linha, como o CNPJ de uma empresa. Uma chave substituta é um identificador sem significado, gerado pelo banco, como um número sequencial ou um UUID. A tentação de usar a chave natural é grande, porque ela já existe, mas dados do negócio mudam mais do que parecem: uma empresa troca de CNPJ numa reorganização, um código de produto é reaproveitado, um e-mail é corrigido. Se o dado é chave primária e é referenciado por dez tabelas, mudá-lo vira uma operação delicada.
A prática mais comum é usar uma chave substituta como chave primária e declarar o dado natural como UNIQUE, como no documento do exemplo acima. Assim, o banco continua impedindo duplicatas, e o identificador interno nunca precisa mudar.
Entre as substitutas, há duas famílias. Os números sequenciais (IDENTITY) são pequenos e ordenados, mas revelam volume e exigem o banco para serem gerados. Os UUIDs podem ser gerados em qualquer lugar e não revelam nada, mas ocupam 16 bytes e, na versão 4, são aleatórios: cada inserção cai num ponto qualquer do índice, o que espalha as gravações. A versão 7 dos UUIDs, padronizada em 2024 na RFC 9562, começa com o horário da criação, o que mantém as inserções em ordem e resolve boa parte do problema; o PostgreSQL 18 já a gera nativamente.
Normalização: cada fato em um lugar só
Normalizar é organizar as tabelas para que cada fato seja guardado num único lugar. O exemplo clássico é a planilha em que cada pedido repete o nome e o telefone do cliente: quando o telefone muda, alguém precisa atualizar centenas de linhas e, se esquecer uma, o banco passa a ter duas verdades. Na prática, as três primeiras formas normais dizem: cada coluna guarda um valor só; numa chave composta, toda coluna depende da chave inteira (o nome do produto não mora em itens_pedido); e nenhuma coluna depende de outra que não seja a chave (a cidade depende do CEP, e não do cliente).
Normalizar não é religião: sistemas analíticos muitas vezes desnormalizam de propósito. E há dados que parecem duplicados, mas não são: o preço gravado no item do pedido é o preço daquela venda, que precisa continuar o mesmo depois que a tabela de preços mudar.
Tipos e restrições: o banco como guardião
Escolher bem o tipo de cada coluna evita problemas que nenhum código resolve depois: **dinheiro em numeric**, nunca em ponto flutuante, que acumula diferenças de centavos; **instantes em timestamptz** no PostgreSQL, que guarda o momento exato e converte para o fuso de quem consulta. E as restrições (NOT NULL, UNIQUE, CHECK, FOREIGN KEY) valem para qualquer programa que grave no banco. Uma regra que existe só no código da aplicação vale até o dia em que alguém grava por outro caminho.
Um detalhe sobre UNIQUE e NULL costuma surpreender: no PostgreSQL, uma coluna única que aceita nulos pode ter vários NULL, porque um desconhecido nunca é igual a outro. É o comportamento desejado em casos como "o código externo, quando existir, não pode se repetir"; quando não for, a opção NULLS NOT DISTINCT, desde a versão 15, trata os nulos como iguais.
Restrições que esperam o fim da transação
Por padrão, o PostgreSQL confere cada restrição logo depois de cada comando. Na maior parte do tempo é o que se quer, mas há operações que passam, no meio do caminho, por um estado inválido e terminam num estado válido. O exemplo clássico é trocar a posição de dois itens numa lista ordenada com uma coluna posicao única: o primeiro UPDATE cria uma duplicata que o segundo desfaria, mas o banco recusa o primeiro antes de o segundo chegar. Outro é gravar dois registros que apontam um para o outro, em que qualquer ordem de inserção viola uma chave estrangeira por um instante.
Para esses casos, a restrição pode ser declarada adiável (DEFERRABLE). Com INITIALLY DEFERRED, ela só é conferida no COMMIT; com INITIALLY IMMEDIATE, continua sendo conferida a cada comando, mas uma transação pode adiá-la com SET CONSTRAINTS ... DEFERRED. Só as restrições UNIQUE, PRIMARY KEY, EXCLUDE e as chaves estrangeiras aceitam essa opção; NOT NULL e CHECK são sempre conferidas na hora.
CREATE TABLE etapas (
  id       integer PRIMARY KEY,
  posicao  integer NOT NULL,
  CONSTRAINT etapas_posicao_un UNIQUE (posicao) DEFERRABLE INITIALLY IMMEDIATE
);

BEGIN;
SET CONSTRAINTS etapas_posicao_un DEFERRED;
UPDATE etapas SET posicao = 2 WHERE id = 10;   -- duplicata temporária
UPDATE etapas SET posicao = 1 WHERE id = 11;
COMMIT;                                         -- a unicidade é conferida aqui
Há dois preços. A documentação avisa que uma unicidade adiável pode ser bem mais lenta que a conferida na hora, e uma restrição adiável não pode ser usada como árbitro de um INSERT ... ON CONFLICT: o upsert precisa de uma restrição conferida imediatamente. Por isso, a opção é para as tabelas que precisam dela, e não um padrão.
Na mesma família está a restrição de exclusão (EXCLUDE), uma generalização da unicidade: em vez de "não pode haver duas linhas com o mesmo valor", ela diz "não pode haver duas linhas em que todas estas comparações sejam verdadeiras". Com o operador de sobreposição && sobre intervalos de tempo, ela impede duas reservas da mesma sala no mesmo horário, regra que nenhum UNIQUE expressa. O PostgreSQL 18 levou a ideia para as chaves: PRIMARY KEY e UNIQUE aceitam WITHOUT OVERLAPS na última coluna, e as chaves estrangeiras aceitam PERIOD, o que permite declarar tabelas com histórico de validade, como "o preço deste produto de tal data a tal data", com a integridade garantida pelo banco.
A anatomia de uma consulta
O SELECT engana porque a ordem em que é escrito não é a ordem em que é avaliado. Considere esta consulta, que lista os clientes que mais compraram no mês:
SELECT c.nome,
       count(*)           AS pedidos,
       sum(p.valor_total) AS total
FROM pedidos p
JOIN clientes c ON c.id = p.cliente_id
WHERE p.situacao = 'faturado'
  AND p.emitido_em >= date '2026-10-01'
GROUP BY c.id, c.nome
HAVING sum(p.valor_total) > 1000
ORDER BY total DESC
LIMIT 10;
A ordem lógica
| Etapa | Cláusula | O que faz |
|---|---|---|
| 1 | FROM e JOIN | monta as linhas de origem, combinando as tabelas |
| 2 | WHERE | descarta as linhas que não atendem à condição |
| 3 | GROUP BY | agrupa as linhas restantes |
| 4 | HAVING | descarta grupos inteiros |
| 5 | SELECT | calcula as colunas de saída, incluindo funções de janela |
| 6 | ORDER BY | ordena |
| 7 | LIMIT | corta o resultado |
Essa ordem explica as dúvidas mais comuns: o WHERE não enxerga um apelido criado no SELECT, porque vem antes; um filtro sobre sum(...) vai no HAVING, porque a soma só existe depois do agrupamento; e o ORDER BY pode usar o apelido total, porque vem depois. É a ordem lógica; fisicamente, o otimizador reorganiza o trabalho como quiser, desde que o resultado seja o mesmo.
Junções: combinando linhas, e não conjuntos
A junção combina linhas de duas tabelas pela condição que você informa. É comum vê-la explicada com diagramas de Venn, mas eles enganam, porque sugerem que as tabelas têm "elementos em comum". O que acontece é que cada linha de uma tabela é comparada com as da outra, e cada par que satisfaz a condição vira uma linha do resultado.
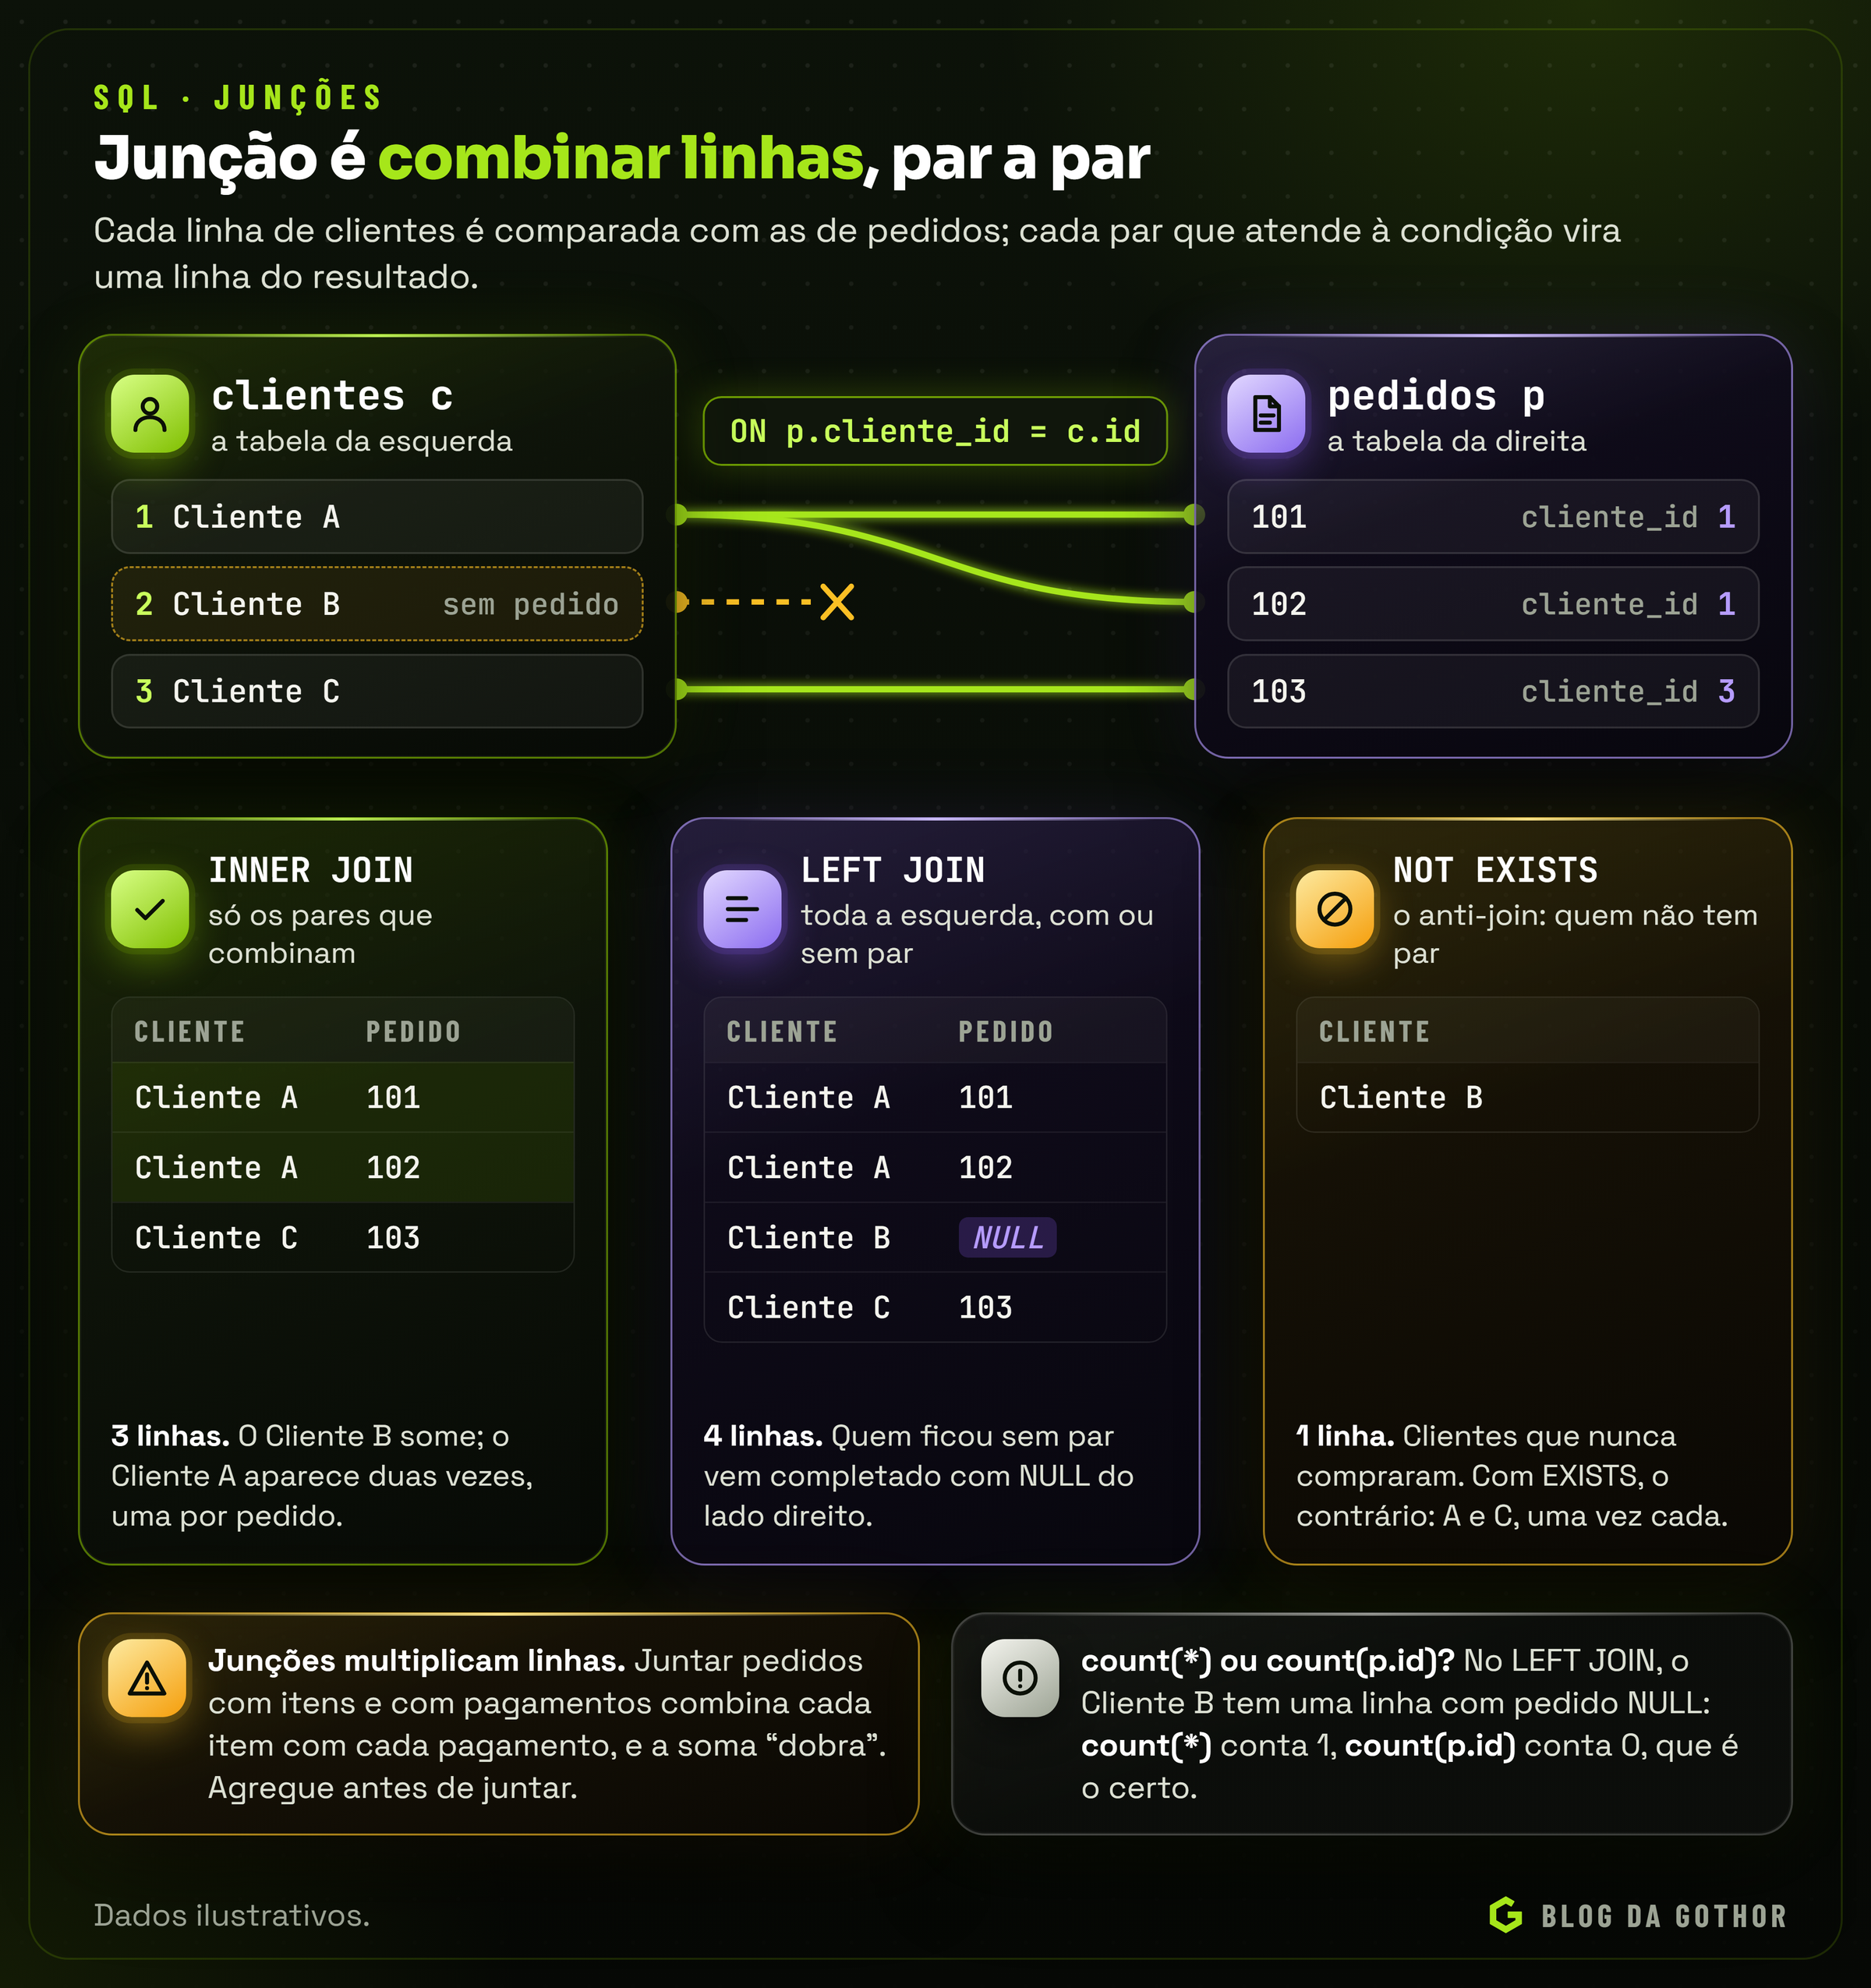
O INNER JOIN devolve só os pares que combinam: um cliente sem pedidos não aparece, e um cliente com três pedidos aparece três vezes. O LEFT JOIN devolve todas as linhas da esquerda e, quando não há par, completa as colunas da direita com NULL. O FULL JOIN faz isso dos dois lados, e o CROSS JOIN gera todas as combinações, útil para montar grades, como todas as lojas com todos os dias do mês.
Dois padrões merecem nome próprio. O anti-join encontra o que não tem par, como clientes que nunca compraram; o semi-join, com EXISTS, encontra o que tem pelo menos um par, sem repetir a linha da esquerda:
SELECT c.id, c.nome
FROM clientes c
WHERE NOT EXISTS (
  SELECT 1 FROM pedidos p WHERE p.cliente_id = c.id
);
O erro mais comum com junções é a multiplicação de linhas. Ao juntar pedidos com itens e, na mesma consulta, com pagamentos, cada item é combinado com cada pagamento do mesmo pedido, e o sum(valor_total) soma o mesmo pedido várias vezes. Quando os números de um relatório "dobram", a primeira suspeita é uma junção que multiplicou linhas. A solução é agregar cada tabela filha separadamente, numa subconsulta ou CTE, antes de juntar.
O filtro no lugar errado de um LEFT JOIN
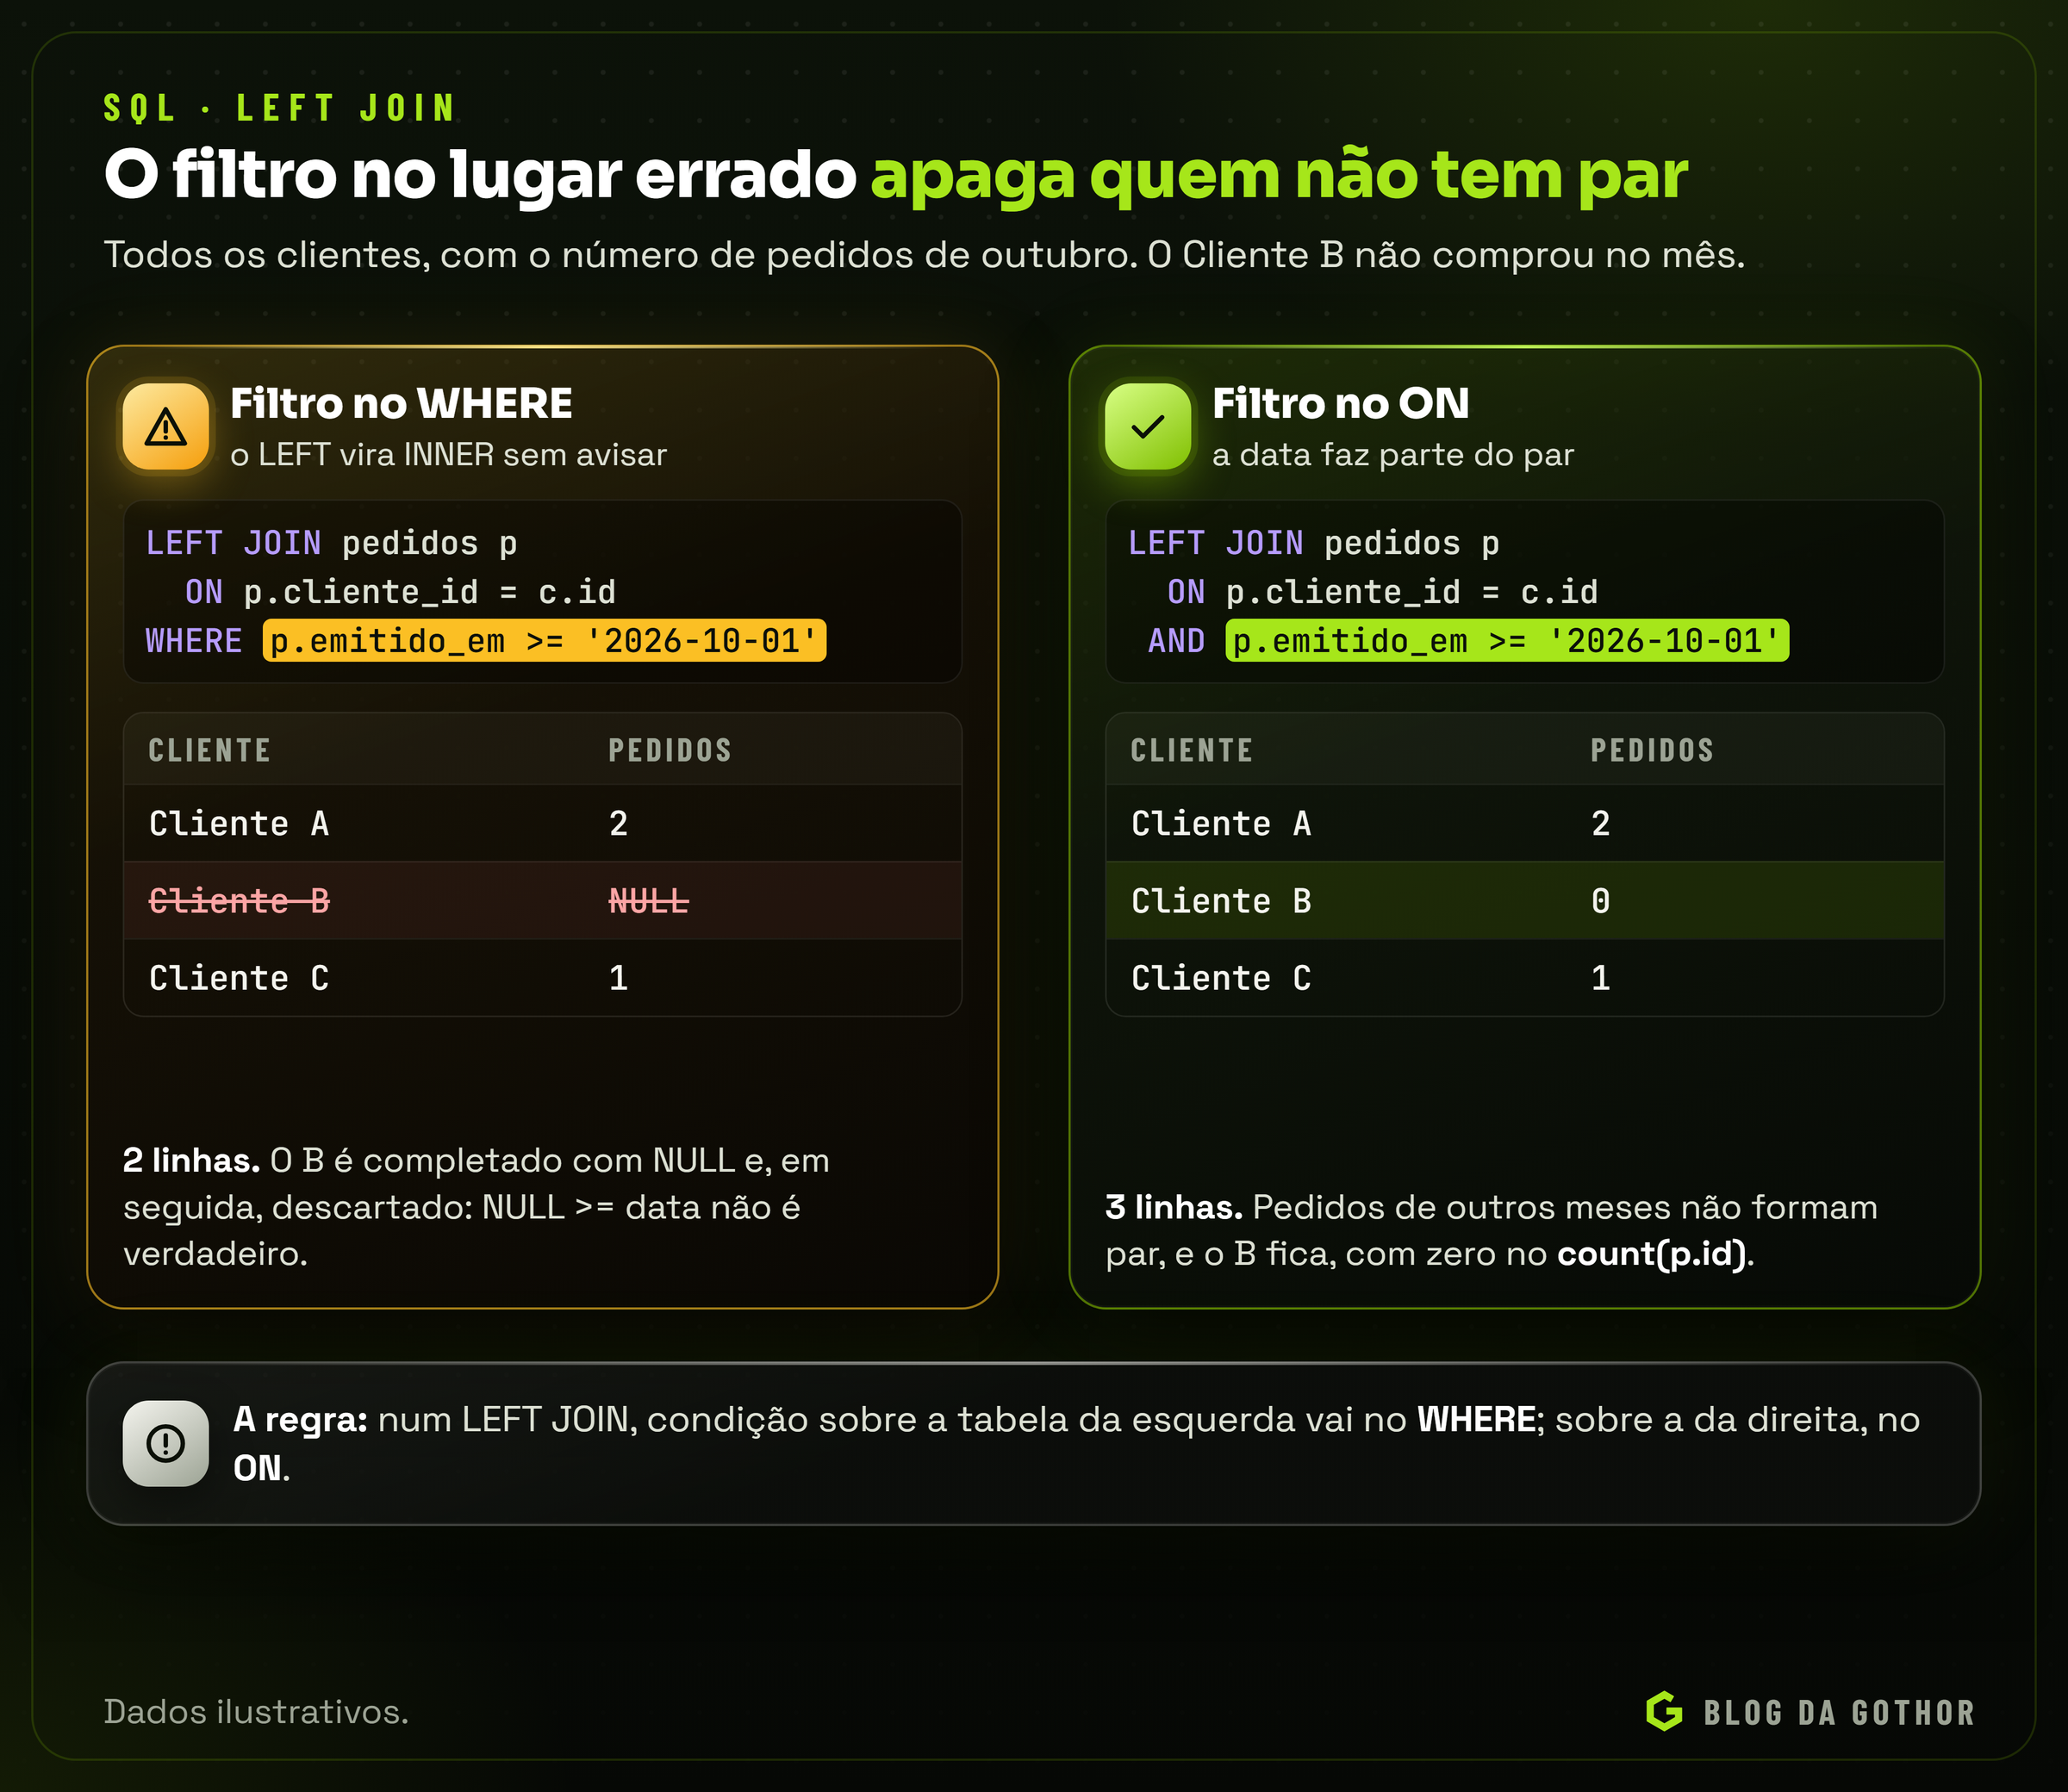
O segundo erro mais comum com junções é silencioso: um LEFT JOIN que, sem ninguém perceber, vira um INNER JOIN. Imagine a lista de todos os clientes com o número de pedidos de outubro, inclusive os que não compraram nada no mês:
-- errado: o cliente sem pedido em outubro some do resultado
SELECT c.nome, count(p.id) AS pedidos
FROM clientes c
LEFT JOIN pedidos p ON p.cliente_id = c.id
WHERE p.emitido_em >= date '2026-10-01'
GROUP BY c.id, c.nome;

-- certo: a condição sobre pedidos fica no ON
SELECT c.nome, count(p.id) AS pedidos
FROM clientes c
LEFT JOIN pedidos p ON p.cliente_id = c.id
                   AND p.emitido_em >= date '2026-10-01'
GROUP BY c.id, c.nome;
Na primeira versão, o LEFT JOIN completa o cliente sem pedidos com NULL em p.emitido_em, e logo depois o WHERE descarta essa linha, porque NULL >= data não é verdadeiro. Na segunda, a data faz parte da condição de junção: os pedidos de outros meses simplesmente não formam par, e o cliente continua no resultado, com zero. Repare também no count(p.id), e não count(*): a linha completada com NULL conta como uma linha, mas não tem p.id, então o cliente sem pedidos aparece com 0, e não com 1. A regra prática: num LEFT JOIN, condições sobre a tabela da esquerda vão no WHERE; sobre a da direita, no ON.
Agregações, FILTER e GROUP BY
As funções de agregação (count, sum, avg, min, max) resumem várias linhas em uma, e o GROUP BY faz isso por grupo. Toda coluna do SELECT fora de uma agregação precisa estar no GROUP BY. Atenção à diferença entre count(*), que conta linhas, e count(coluna), que ignora NULL, como acabamos de ver.
O PostgreSQL aceita a cláusula FILTER, do padrão SQL, que aplica uma condição a uma agregação específica. Ela calcula vários números numa única leitura da tabela, como as vendas de dois meses lado a lado:
SELECT cliente_id,
       sum(valor_total) FILTER (WHERE emitido_em >= date '2026-10-01') AS outubro,
       sum(valor_total) FILTER (WHERE emitido_em <  date '2026-10-01') AS setembro
FROM pedidos
WHERE emitido_em >= date '2026-09-01'
GROUP BY cliente_id;
Subtotais com ROLLUP, CUBE e GROUPING SETS
Todo relatório gerencial acaba pedindo subtotais: as vendas por filial e por mês, o total de cada filial e o total geral. A saída ingênua é escrever três consultas e juntá-las com UNION ALL, o que lê a tabela três vezes e espalha a mesma regra de negócio por três lugares. O padrão SQL resolve isso no próprio GROUP BY, com os conjuntos de agrupamento.
O GROUPING SETS recebe uma lista de agrupamentos, e o banco calcula cada um deles sobre as mesmas linhas filtradas pelo WHERE, devolvendo tudo num resultado só. Um conjunto vazio, (), agrupa todas as linhas numa só e produz o total geral. O ROLLUP (a, b, c) é um atalho para a lista e todos os seus prefixos, (a, b, c), (a, b), (a) e (), que é exatamente a forma de um relatório hierárquico, como filial, mês e total. O CUBE (a, b) gera todas as combinações possíveis, (a, b), (a), (b) e (), útil quando o relatório precisa ser lido nos dois sentidos. No exemplo, a tabela de pedidos tem também uma coluna filial_id:
SELECT filial_id,
       date_trunc('month', emitido_em) AS mes,
       sum(valor_total)                AS vendas,
       grouping(filial_id, date_trunc('month', emitido_em)) AS nivel
FROM pedidos
WHERE situacao = 'faturado'
  AND emitido_em >= date '2026-07-01' AND emitido_em < date '2026-11-01'
GROUP BY ROLLUP (filial_id, date_trunc('month', emitido_em))
ORDER BY filial_id, mes;
Nas linhas de subtotal, as colunas que não fazem parte daquele agrupamento aparecem como NULL: a linha do total da filial 3 tem mes nulo, e a do total geral tem as duas colunas nulas. Isso cria uma ambiguidade quando a própria coluna pode ser nula nos dados, e é para resolvê-la que existe a função grouping, que devolve um número cujos bits indicam quais colunas foram "somadas" naquela linha. A tela pode usar esse número para escrever "Total da filial" e "Total geral" no lugar dos nulos.
Combinar vários itens no mesmo GROUP BY gera o produto entre eles, e esse produto pode repetir agrupamentos; o PostgreSQL 14 aceitou GROUP BY DISTINCT para remover as repetições. O Oracle oferece as mesmas três formas no GROUP BY, e a lógica é idêntica.
Subconsultas, EXISTS e LATERAL
Uma subconsulta é um SELECT dentro de outro, e pode aparecer onde caberia um valor, uma lista ou uma tabela. Quando ela usa colunas da consulta de fora, como o NOT EXISTS acima, é correlacionada: conceitualmente, roda uma vez para cada linha de fora, embora o otimizador quase sempre a transforme numa junção. Para testar existência, EXISTS é a forma mais clara e segura; IN funciona bem com listas e subconsultas que nunca devolvem NULL.
Uma necessidade frequente é "os três últimos pedidos de cada cliente". A função de janela row_number(), que veremos a seguir, resolve; outra saída, muitas vezes mais rápida, é a junção lateral, em que a subconsulta da direita pode usar as colunas da linha da esquerda:
SELECT c.nome, u.id, u.emitido_em, u.valor_total
FROM clientes c
CROSS JOIN LATERAL (
  SELECT p.id, p.emitido_em, p.valor_total
  FROM pedidos p
  WHERE p.cliente_id = c.id
  ORDER BY p.emitido_em DESC
  LIMIT 3
) u;
Com um índice em (cliente_id, emitido_em), cada cliente custa uma descida curta no índice e a leitura de três entradas, em vez da numeração de todos os pedidos da tabela. O Oracle oferece o mesmo recurso, com LATERAL ou CROSS APPLY.
Operações de conjunto
UNION, INTERSECT e EXCEPT combinam os resultados de duas consultas com as mesmas colunas: a união, o que aparece em ambos e o que aparece só no primeiro. O UNION remove duplicatas, o que exige ordenar ou montar uma tabela hash com todo o resultado; o UNION ALL apenas concatena e, quando não há duplicatas a remover, é o certo. No Oracle, o EXCEPT se chama MINUS.
CTEs e funções de janela
Consultas grandes ficam legíveis com CTEs, as cláusulas WITH, que dão nome a etapas intermediárias. Com WITH RECURSIVE, uma CTE se refere a si mesma e resolve hierarquias, como categorias com subcategorias.
As funções de janela são o recurso que mais economiza código e o menos conhecido. Elas calculam um valor sobre linhas relacionadas sem agrupar: cada linha continua no resultado.
SELECT cliente_id, id AS pedido, emitido_em, valor_total,
       row_number() OVER (PARTITION BY cliente_id ORDER BY emitido_em DESC) AS ordem,
       sum(valor_total) OVER (PARTITION BY cliente_id ORDER BY emitido_em)  AS acumulado,
       valor_total - lag(valor_total) OVER (PARTITION BY cliente_id ORDER BY emitido_em) AS variacao
FROM pedidos;
O row_number() numera os pedidos de cada cliente do mais novo para o mais antigo (filtrando ordem = 1, você obtém o último pedido de cada um), o sum(...) OVER dá o acumulado e o lag traz o valor da linha anterior.
Para classificações, há três funções parecidas que diferem no empate. O row_number() dá números distintos mesmo a linhas empatadas, numa ordem arbitrária entre elas; o rank() dá o mesmo número aos empatados e pula os seguintes (1, 2, 2, 4); o dense_rank() também repete, mas não pula (1, 2, 2, 3). Num ranking de vendedores, a escolha muda quem aparece no "top 3", e vale decidir de propósito. O ntile(4) divide cada partição em quatro grupos de tamanho o mais parecido possível, o jeito mais curto de separar clientes em quartis de faturamento.
Molduras: o que cada função de janela enxerga
Toda função de janela trabalha sobre uma moldura (frame), o conjunto de linhas da partição que ela considera para a linha atual. Quando a cláusula OVER tem ORDER BY e não diz nada sobre a moldura, vale o padrão RANGE BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW: do começo da partição até a linha atual e todas as que empatam com ela na ordenação. Sem ORDER BY, todas as linhas são consideradas empatadas, e a moldura é a partição inteira. Essa regra explica dois resultados que surpreendem.
O primeiro é o acumulado que "salta". Se dois pedidos do mesmo cliente têm o mesmo emitido_em, o sum(...) OVER (... ORDER BY emitido_em) mostra o mesmo acumulado nas duas linhas, já somando as duas, porque elas são pares na ordenação. Para um acumulado linha a linha, a moldura precisa contar linhas físicas, e a ordenação precisa de um desempate:
SELECT id, emitido_em, valor_total,
       sum(valor_total) OVER (
         PARTITION BY cliente_id
         ORDER BY emitido_em, id
         ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW
       ) AS acumulado,
       avg(valor_total) OVER (
         PARTITION BY cliente_id
         ORDER BY emitido_em, id
         ROWS BETWEEN 2 PRECEDING AND CURRENT ROW
       ) AS media_dos_ultimos_3
FROM pedidos;
O segundo é o last_value que devolve a própria linha. A documentação do PostgreSQL alerta que first_value, last_value e nth_value só olham para a moldura, e que a moldura padrão termina na linha atual; o "último valor" é, portanto, o da linha atual ou de um empate dela. A correção é estender a moldura até o fim: ROWS BETWEEN UNBOUNDED PRECEDING AND UNBOUNDED FOLLOWING.
Há três modos de moldura. O ROWS conta linhas físicas, como no exemplo da média móvel dos três últimos pedidos. O RANGE trabalha com a diferença de valor na coluna ordenada: RANGE BETWEEN interval '7 days' PRECEDING AND CURRENT ROW pega todos os pedidos dos sete dias anteriores, sejam eles dois ou duzentos, o que é diferente de "as sete linhas anteriores" quando há dias sem venda. O GROUPS conta grupos de empatados. Os deslocamentos no RANGE, o modo GROUPS e a opção EXCLUDE, que tira da moldura a linha atual ou os empates dela, chegaram ao PostgreSQL na versão 11, que passou a implementar todas as opções de moldura do SQL:2011.
Hierarquias com WITH RECURSIVE
Categorias com subcategorias, a estrutura de um produto com seus componentes, o organograma de uma empresa: dados em forma de árvore costumam ser guardados numa tabela só, com uma coluna que aponta para o pai. Perguntar "quais são todos os descendentes da categoria Bebidas" exige percorrer um número desconhecido de níveis, e é para isso que serve a CTE recursiva.
WITH RECURSIVE arvore AS (
  SELECT id, nome, pai_id, 1 AS nivel
  FROM categorias
  WHERE id = 7                       -- a categoria de partida
  UNION ALL
  SELECT c.id, c.nome, c.pai_id, a.nivel + 1
  FROM categorias c
  JOIN arvore a ON c.pai_id = a.id   -- os filhos de quem já está na árvore
)
SELECT * FROM arvore;
Apesar do nome, o banco avalia a consulta em ciclos, e não com recursão. Ele executa a primeira parte, que vira o resultado inicial e também uma tabela de trabalho. Depois, executa a segunda parte com a tabela de trabalho no lugar da autorreferência, acrescenta as linhas novas ao resultado e faz delas a nova tabela de trabalho. O processo para quando uma rodada não produz nenhuma linha. Com UNION em vez de UNION ALL, as linhas repetidas são descartadas a cada rodada.
O risco são os ciclos: se, por um erro de cadastro, uma categoria é mãe da própria avó, a consulta com UNION ALL não termina nunca. Desde a versão 14, o PostgreSQL implementa as cláusulas do padrão para isso. O CYCLE id SET em_ciclo USING caminho acrescenta uma coluna com o caminho percorrido e outra que marca a linha que fechou um ciclo, e a recursão para nela. O SEARCH DEPTH FIRST BY id SET ordem ou SEARCH BREADTH FIRST BY id SET ordem cria uma coluna para ordenar o resultado em profundidade, como num índice de livro, ou nível por nível. Um limite explícito, como WHERE a.nivel < 20 na parte recursiva, é uma proteção barata mesmo com dados confiáveis.
O Oracle oferece a mesma CTE recursiva, com as cláusulas SEARCH e CYCLE, e mantém a sintaxe própria e mais antiga, o CONNECT BY com START WITH e PRIOR, que ainda aparece em muito código. A própria documentação da Oracle descreve a CTE recursiva como mais poderosa, por oferecer as duas ordens de busca e vários ramos recursivos.
CTE: etapa com nome ou barreira para o otimizador
Até a versão 11, o PostgreSQL sempre calculava cada CTE separadamente, antes do resto da consulta, e guardava o resultado. Era uma barreira de otimização: um filtro escrito fora da CTE não chegava à tabela de dentro dela, e uma CTE sobre uma tabela grande podia ler a tabela inteira para depois descartar quase tudo. Muita gente aprendeu a evitar CTEs por desempenho por causa disso.
O PostgreSQL 12 mudou a regra. Uma CTE que não é recursiva, não tem efeitos colaterais e é usada uma única vez passa a ser incorporada à consulta principal, e o otimizador a trata como se fosse uma subconsulta. Quando ela é usada mais de uma vez, continua sendo calculada uma vez só e reaproveitada. As duas decisões podem ser forçadas: WITH t AS MATERIALIZED (...) garante o cálculo separado, útil quando a CTE chama uma função cara que deve rodar uma única vez por linha, e WITH t AS NOT MATERIALIZED (...) pede a incorporação mesmo com várias referências, o que permite aos filtros chegarem aos índices da tabela de base. Ao revisar consultas antigas, vale lembrar que o conselho de "trocar a CTE por subconsulta" perdeu boa parte do sentido.
NULL: a lógica de três valores
NULL não é zero nem texto vazio: significa valor desconhecido, e qualquer comparação com o desconhecido dá desconhecido. O WHERE só mantém as linhas em que a condição é verdadeira, e daí vêm as armadilhas:
WHERE desconto = NULLnunca retorna nada. O certo éWHERE desconto IS NULL.WHERE situacao <> 'cancelado'não retorna as linhas em quesituacaoéNULL.x NOT IN (1, 2, NULL)nunca é verdadeiro. Se a subconsulta de umNOT INpuder devolverNULL, o resultado inteiro fica vazio. UseNOT EXISTS.- As agregações ignoram
NULL: a média de 10, 20 eNULLé 15.
A melhor defesa é declarar NOT NULL em toda coluna que não tem um bom motivo para aceitar o desconhecido, e usar coalesce para trocar NULL por um valor padrão na leitura.
Datas, fusos e agrupamentos por dia
Relatórios por período são a maior fonte de números que "quase batem". Três cuidados resolvem a maior parte deles.
O primeiro é saber o que a coluna guarda. No PostgreSQL, timestamptz guarda um instante (internamente em UTC) e o mostra no fuso da sessão; timestamp sem fuso guarda uma hora de parede, sem dizer de onde. Se a aplicação grava UTC numa coluna sem fuso, cabe a quem consulta dizer isso ao banco antes de converter: data AT TIME ZONE 'UTC' AT TIME ZONE 'America/Cuiaba' interpreta o valor como UTC e o traduz para a hora de Cuiabá. Sem essa conversão, as vendas das 21h às 23h59 de Cuiabá caem no dia seguinte, porque em UTC já é outro dia.
O segundo é filtrar períodos com intervalos semiabertos: emitido_em >= '2026-10-01' AND emitido_em < '2026-11-01'. O BETWEEN '2026-10-01' AND '2026-10-31' parece equivalente, mas para numa meia-noite e perde o último dia inteiro.
O terceiro é lembrar que um GROUP BY por dia só mostra os dias que têm dados. Para um gráfico sem buracos, gera-se a grade de dias e junta-se a ela:
SELECT d::date AS dia, coalesce(sum(p.valor_total), 0) AS vendas
FROM generate_series(date '2026-10-01', date '2026-10-31', interval '1 day') AS d
LEFT JOIN pedidos p
       ON p.emitido_em >= d AND p.emitido_em < d + interval '1 day'
GROUP BY d
ORDER BY d;
Texto: maiúsculas, acentos e ordenação
Comparar e ordenar texto parece trivial até a primeira busca por "joão" que não encontra "João", ou a lista de clientes em que "Álvaro" aparece depois de "Zélia". Quem decide essas coisas é a collation (ordenação, numa tradução livre) da coluna ou da expressão: ela define a ordem das letras, o que é maiúscula e minúscula e como funcionam o ORDER BY, os operadores < e >, funções como lower e upper e as comparações de padrão.
No PostgreSQL, as collations vêm de dois provedores principais. As do libc são as do sistema operacional e mudam conforme a máquina; as do ICU vêm de uma biblioteca de Unicode e não dependem da codificação do banco. Há também a collation C, que ordena pelos bytes, e não pela língua: é rápida e estável entre versões, mas só trata como letras as de A a Z do ASCII, e por isso coloca as palavras com acento depois de todas as outras.
Para buscas sem diferenciar maiúsculas, a saída mais comum é comparar lower(email) = lower(:email) com um índice de expressão sobre lower(email). Desde a versão 12, há outra opção: as collations não determinísticas, que só existem com o ICU e consideram iguais textos com bytes diferentes. Com elas, um UNIQUE passa a impedir "Ana@exemplo.com.br" e "ana@exemplo.com.br" ao mesmo tempo:
CREATE COLLATION sem_caixa (provider = icu, locale = 'und-u-ks-level2', deterministic = false);

CREATE TABLE usuarios (
  id     integer GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
  email  text COLLATE sem_caixa NOT NULL UNIQUE
);
O nível 2 do ICU ignora a caixa, mas ainda distingue acentos; ignorar os dois pede o nível 1. A documentação aponta os custos: comparações mais lentas, índices B-tree que não podem usar a deduplicação e operações de padrão que não funcionam com todas essas collations; o LIKE, por exemplo, só passou a aceitá-las no PostgreSQL 18. A mesma versão trouxe a função casefold, que compara sem diferenciar caixa com mais precisão que o lower em línguas em que uma letra tem mais de uma forma maiúscula ou minúscula.
Um último cuidado: as regras de ordenação vêm de bibliotecas que mudam com o tempo. Uma atualização do sistema operacional para uma versão principal nova, ou um servidor ligado a uma versão nova do ICU, pode mudar a ordem de algumas palavras, e os índices sobre texto criados antes passam a estar fora de ordem para o banco, o que a documentação descreve como uma porta para índices corrompidos. O PostgreSQL guarda a versão de cada collation e avisa quando ela não confere com a da biblioteca; a correção é reconstruir os objetos afetados com REINDEX e só então registrar a versão nova com ALTER COLLATION ... REFRESH VERSION.
Passo a passo: um relatório de contas a receber
A melhor forma de juntar as peças é montar um relatório que todo financeiro conhece: os títulos vencidos e não pagos, por cliente, em faixas de atraso, com a participação de cada cliente no total. O modelo é ilustrativo: uma tabela titulos com cliente_id, valor, vencimento (do tipo date) e pago_em, nula enquanto o título está em aberto.
- Escreva a pergunta em português. "Para cada cliente com títulos vencidos e não pagos: quanto está atrasado até 30 dias, de 31 a 60 e acima de 60, o total e o percentual da carteira vencida." A frase já diz o filtro, o agrupamento e as medidas.
- Isole as linhas de origem numa CTE. Só títulos em aberto e vencidos, já com os dias de atraso calculados. No PostgreSQL, a diferença entre duas datas é um número inteiro de dias.
- Agregue por cliente, com uma coluna por faixa. O
FILTERcalcula as três faixas numa única leitura. - Use uma janela sobre o agregado para o percentual.
sum(sum(valor)) OVER ()soma os totais de todos os clientes, sem precisar de uma segunda consulta. - Confira o plano e crie o índice certo.
WITH vencidos AS (
  SELECT cliente_id, valor, current_date - vencimento AS dias_atraso
  FROM titulos
  WHERE pago_em IS NULL
    AND vencimento < current_date
)
SELECT c.nome,
       sum(v.valor) FILTER (WHERE v.dias_atraso <= 30)             AS ate_30,
       sum(v.valor) FILTER (WHERE v.dias_atraso BETWEEN 31 AND 60) AS de_31_a_60,
       sum(v.valor) FILTER (WHERE v.dias_atraso > 60)              AS acima_de_60,
       sum(v.valor)                                                AS total,
       round(100 * sum(v.valor) / sum(sum(v.valor)) OVER (), 1)    AS percentual
FROM vencidos v
JOIN clientes c ON c.id = v.cliente_id
GROUP BY c.id, c.nome
ORDER BY total DESC
LIMIT 20;
Algumas observações tornam o relatório confiável. O vencimento é do tipo date, sem hora, e por isso a conta de dias não depende de fuso. As faixas não se sobrepõem, e a soma das três colunas confere com o total. E o percentual é calculado antes do LIMIT, então mostra a participação na carteira inteira.
Para o desempenho, a observação decisiva é que, numa carteira real, a imensa maioria dos títulos já foi paga. Um índice parcial, que guarda só as linhas em aberto, é pequeno, barato de manter e exatamente do tamanho da pergunta:
CREATE INDEX titulos_abertos_venc_idx
  ON titulos (vencimento)
  WHERE pago_em IS NULL;
Por fim, o EXPLAIN ANALYZE confirma se o banco usou esse índice e quantas linhas leu para chegar ao resultado. Se a conta de linhas lidas for muito maior que a de títulos vencidos, alguma das etapas anteriores merece revisão.
Modificando dados com segurança
Antes de rodar um UPDATE ou DELETE à mão, confira o WHERE com um SELECT. Melhor ainda: rode a alteração dentro de uma transação, confira o número de linhas afetadas e só então decida entre COMMIT e ROLLBACK. E uma operação muito comum merece cuidado: o upsert: inserir se não existe, atualizar se já existe. Fazer isso na aplicação, com uma leitura seguida de uma gravação, cria uma condição de corrida: duas requisições simultâneas leem "não existe" e as duas tentam inserir. No PostgreSQL, o certo é uma instrução só:
INSERT INTO uso_diario (usuario, dia, tokens)
VALUES ('ana@exemplo.com.br', date '2026-10-26', 1500)
ON CONFLICT (usuario, dia)
DO UPDATE SET tokens = uso_diario.tokens + EXCLUDED.tokens
RETURNING tokens;
O ON CONFLICT usa uma restrição de unicidade para decidir, de forma atômica, entre inserir e atualizar, e EXCLUDED é a linha que se tentou inserir. O Oracle usa o MERGE, do padrão, que o PostgreSQL também tem desde a versão 15. O RETURNING, por sua vez, devolve as linhas afetadas na mesma ida ao banco, o que evita um SELECT logo depois.
Uma variação útil é a atualização condicional, que só grava se o estado ainda for o esperado: UPDATE agenda SET disparado_em = :alvo WHERE id = :id AND (disparado_em IS NULL OR disparado_em < :alvo). Se duas instâncias de um serviço tentarem a mesma operação ao mesmo tempo, só uma delas afeta a linha; a outra recebe "zero linhas" e sabe que não deve continuar. É o equivalente, em SQL, de um "compare e troque".
O que acontece quando a consulta chega ao banco
Entre o texto da consulta e o resultado, o banco passa por quatro etapas, e é na terceira que o desempenho é decidido.
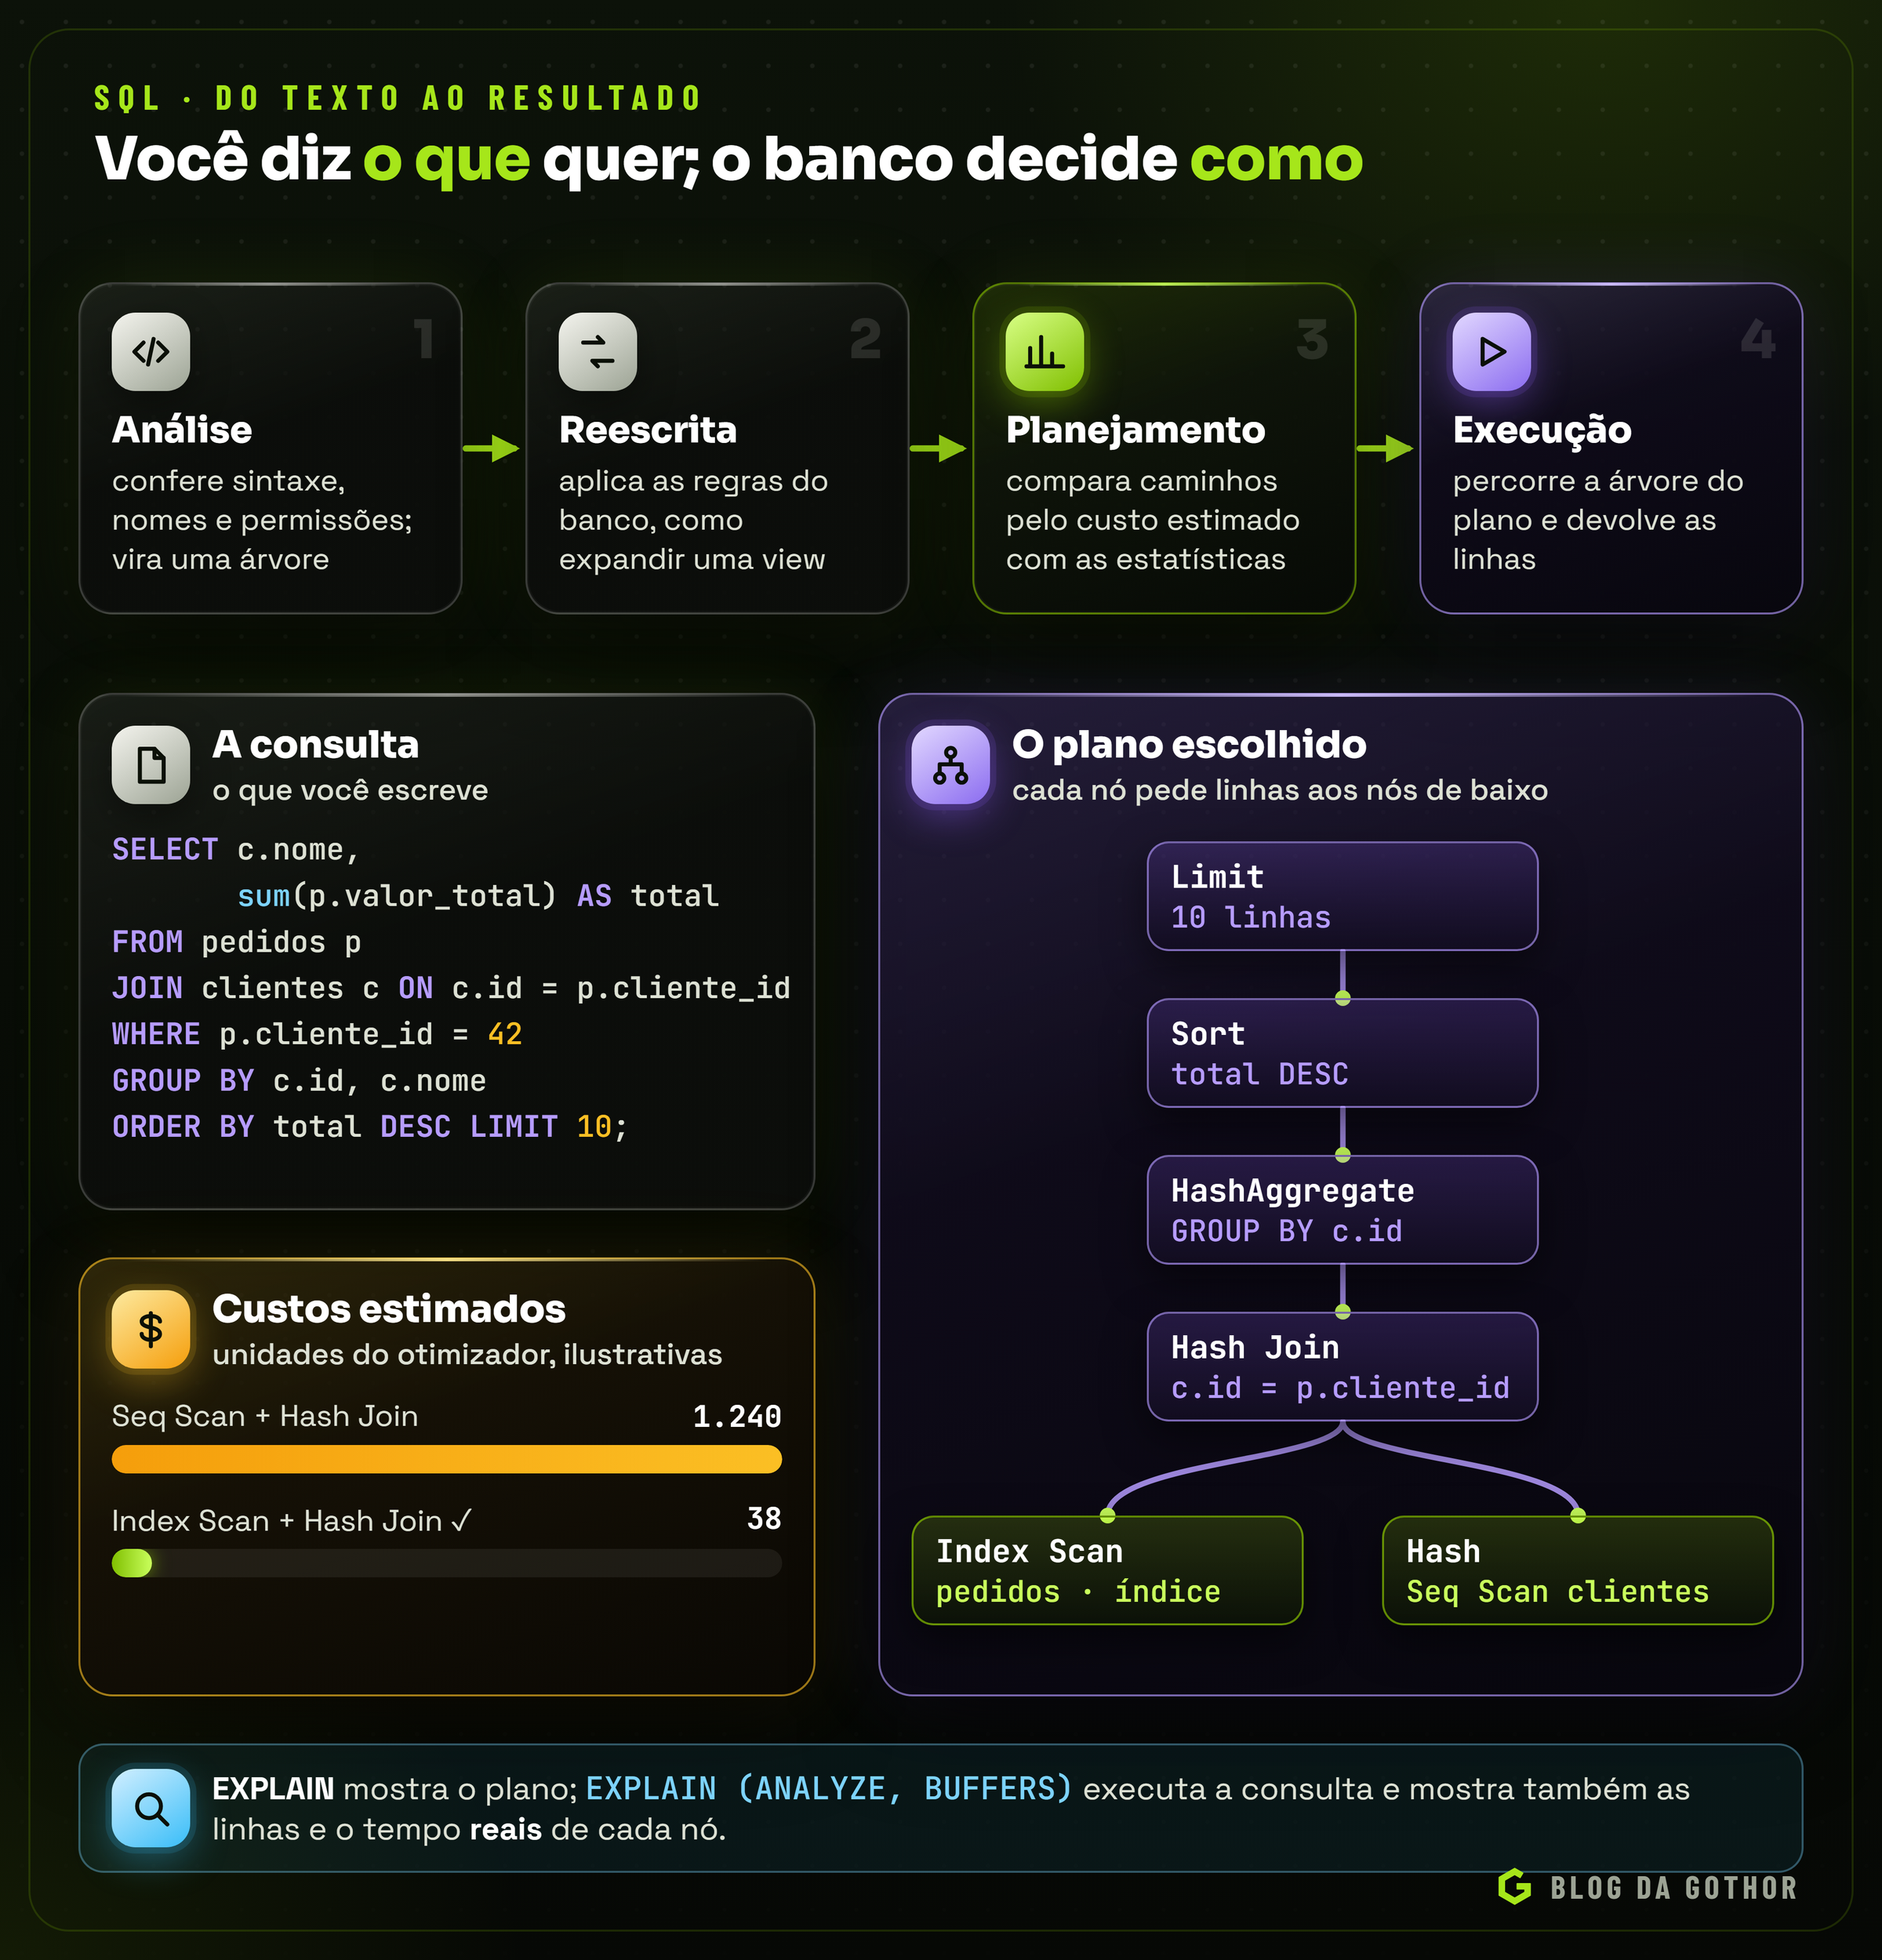
- Análise: confere a sintaxe, resolve os nomes e as permissões e transforma o texto numa árvore.
- Reescrita: aplica regras do banco, como expandir uma view na consulta que ela representa.
- Planejamento: o otimizador gera planos alternativos e estima o custo de cada um. Ler a tabela inteira ou usar um índice? Em que ordem juntar as tabelas, e com qual algoritmo? A estimativa usa estatísticas sobre os dados, como o número de linhas e os valores mais frequentes de cada coluna, coletadas pelo
ANALYZE. - Execução: o executor percorre o plano, uma árvore em que cada nó pede linhas aos nós de baixo.
Para juntar tabelas, o otimizador escolhe entre três algoritmos: o nested loop, que para cada linha de um lado busca as do outro, de preferência por índice; o hash join, que monta uma tabela hash com o lado menor e passa o maior por ela; e o merge join, que percorre ao mesmo tempo dois lados já ordenados.
Como o banco estima: estatísticas e seletividade
Todo o trabalho do otimizador depende de uma pergunta: quantas linhas cada etapa vai produzir? Para responder sem ler a tabela, o banco mantém, para cada coluna, um resumo coletado por amostragem: os valores mais comuns e a frequência de cada um, um histograma com a distribuição dos outros valores, a proporção de nulos e o número estimado de valores distintos. Com isso, ele estima a seletividade de cada filtro: situacao = 'cancelado' pode representar 2% da tabela, e cliente_id = 42, uma fração mínima.
As estimativas erram em dois casos típicos. O primeiro é a tabela que mudou muito desde a última coleta; a manutenção automática atualiza as estatísticas, mas depois de uma carga grande vale rodar ANALYZE na hora. O segundo é a correlação entre colunas: o banco supõe que os filtros são independentes e multiplica as frações, o que dá errado quando as colunas andam juntas, como cidade e CEP. Para isso, o PostgreSQL tem as estatísticas estendidas, criadas com CREATE STATISTICS, que registram a relação entre colunas escolhidas. Quando um plano parece absurdo, a primeira pergunta é sempre se as linhas estimadas estão perto das reais.
EXPLAIN: perguntando ao banco o que ele vai fazer
O EXPLAIN mostra o plano escolhido. Com ANALYZE, executa a consulta e mostra, ao lado das estimativas, os números reais. A saída abaixo é ilustrativa:
EXPLAIN (ANALYZE, BUFFERS)
SELECT * FROM pedidos WHERE cliente_id = 42 AND emitido_em >= date '2026-10-01';

Index Scan using pedidos_cliente_emitido_idx on pedidos
    (cost=0.43..36.12 rows=9 width=52) (actual time=0.031..0.058 rows=11 loops=1)
  Index Cond: ((cliente_id = 42) AND (emitido_em >= '2026-10-01'::date))
  Buffers: shared hit=6
Execution Time: 0.081 ms
Observe o tipo de cada nó (um Seq Scan numa tabela grande, para devolver poucas linhas, é um alerta), a diferença entre linhas estimadas e reais (estimativas muito erradas levam a planos ruins) e os buffers, as páginas lidas da memória ou do disco. Cuidado: EXPLAIN ANALYZE executa de verdade, inclusive um UPDATE. A regra que mais economiza tempo é medir pelo plano, e não pelo relógio: uma consulta lenta pode estar lendo um milhão de linhas para devolver dez, e só o plano mostra isso.
Instruções preparadas e o plano que muda sozinho
As aplicações costumam enviar as consultas como instruções preparadas: o texto com parâmetros ($1, $2) é analisado uma vez e executado muitas vezes, com valores diferentes, na mesma sessão. O PostgreSQL pode executá-las com um plano sob medida, refeito a cada chamada com os valores daquela vez, ou com um plano genérico, feito uma vez e reaproveitado. Pela regra atual, as cinco primeiras execuções usam planos sob medida; depois, o banco monta um plano genérico e passa a usá-lo se o custo estimado dele não for muito maior que a média dos anteriores.
Isso explica um caso que intriga: a consulta é rápida nas primeiras chamadas e fica lenta a partir da sexta. Acontece quando os dados são muito desiguais, como um cliente com metade dos pedidos da tabela, e o plano genérico, que não conhece o valor, serve mal a uma parte deles. O EXPLAIN EXECUTE mostra o plano em uso (o genérico exibe $1 no lugar do valor), e o parâmetro plan_cache_mode, desde a versão 12, força um dos dois comportamentos quando a heurística erra.
Índices: a diferença entre ler tudo e ir direto ao ponto
Sem índice, para encontrar os pedidos do cliente 42, o banco lê a tabela inteira e testa cada linha: é o seq scan. Com mil linhas é instantâneo; com centenas de milhões, não. Um índice é uma estrutura mantida pelo próprio banco que guarda os valores de uma ou mais colunas em ordem, cada um com o endereço da linha na tabela. O tipo padrão, em praticamente todos os bancos relacionais, é a árvore B (B-tree).
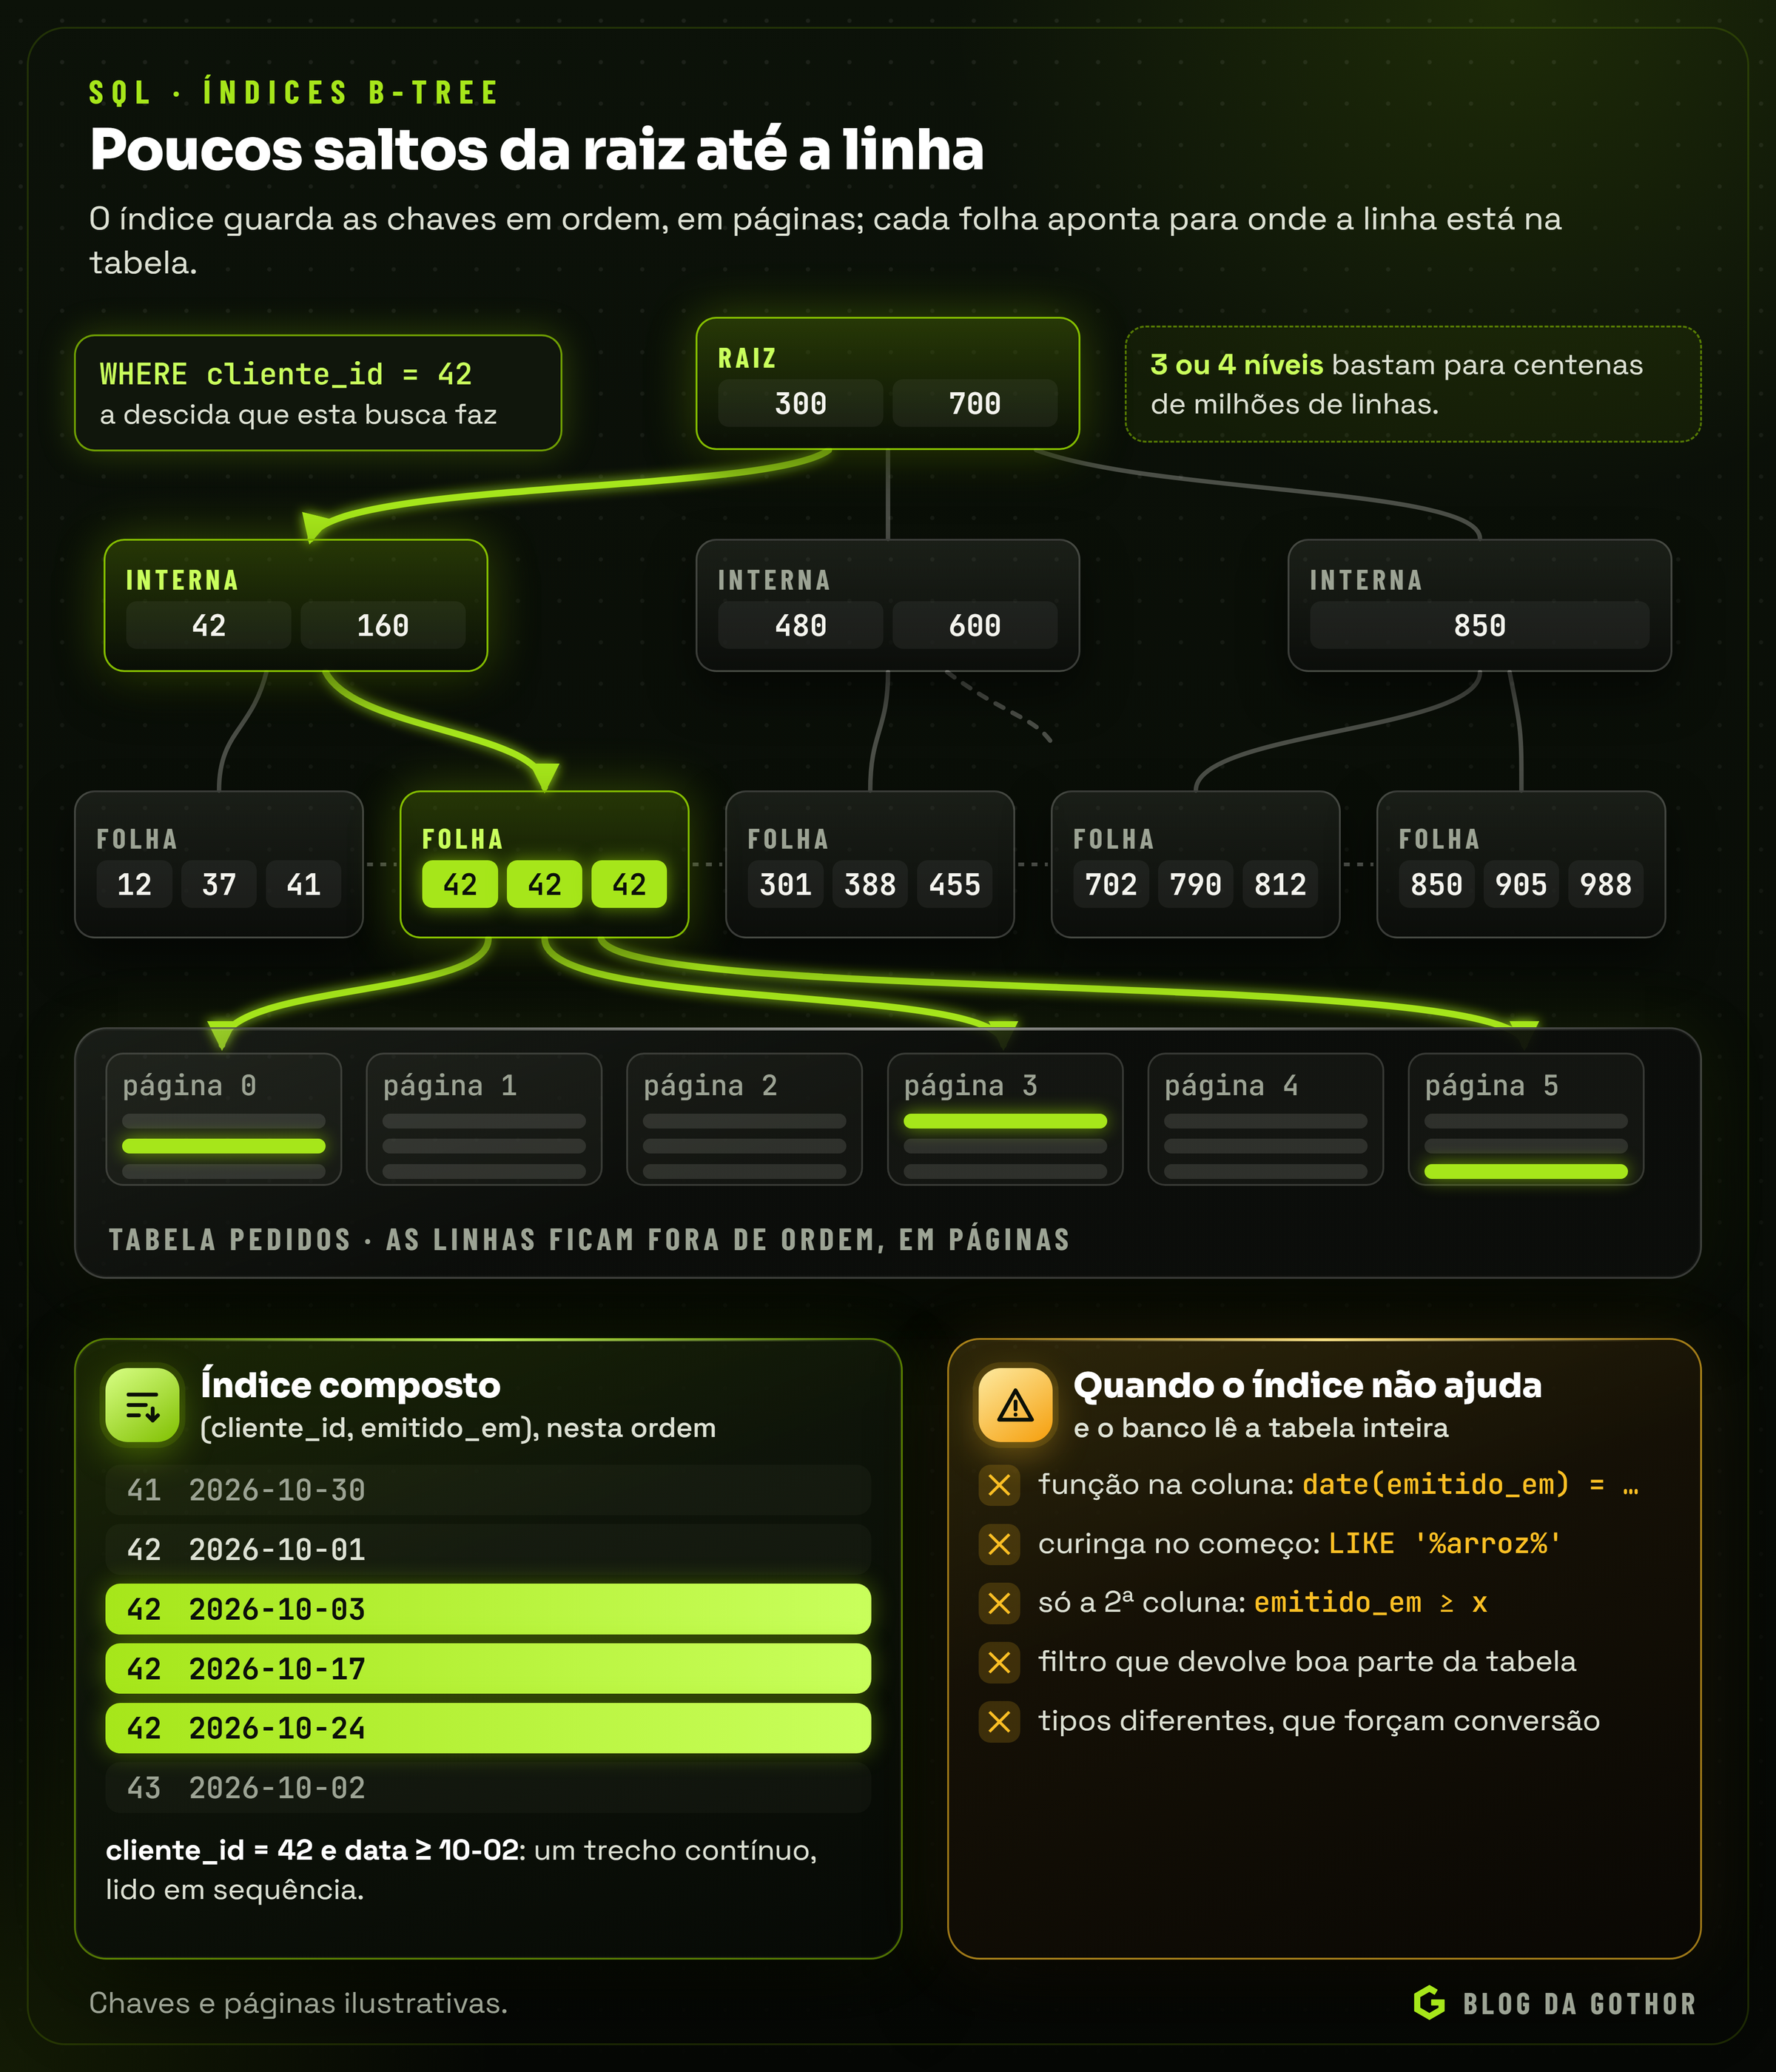
A árvore B é rasa: cada página guarda centenas de chaves, então mesmo tabelas enormes costumam ter três ou quatro níveis, e as páginas de cima quase sempre já estão na memória. É ordenada: as folhas guardam as chaves em ordem e são ligadas umas às outras, então o mesmo índice serve para igualdade, para intervalos (>=, BETWEEN), para prefixos (LIKE 'abc%') e para devolver linhas já ordenadas. E se mantém equilibrada: inserções e exclusões dividem e juntam páginas para que todos os caminhos tenham o mesmo comprimento.
Se todas as colunas que a consulta precisa estiverem no índice, o PostgreSQL responde só com ele, sem visitar a tabela: é o index only scan. A cláusula INCLUDE acrescenta colunas às folhas exatamente para isso.
A ordem das colunas importa
O índice (cliente_id, emitido_em) é ordenado por cliente e, dentro de cada cliente, por data, como uma lista telefônica ordenada por sobrenome e depois por nome. Ele serve muito bem para WHERE cliente_id = 42, para cliente_id = 42 AND emitido_em >= ... e para cliente_id = 42 ORDER BY emitido_em DESC. E serve mal para emitido_em >= ... sozinho, assim como uma lista ordenada por sobrenome não ajuda a encontrar todo mundo que se chama Ana. A regra geral: primeiro as colunas comparadas por igualdade, depois a de intervalo ou de ordenação. O PostgreSQL 18 consegue, em alguns casos, "pular" a primeira coluna quando ela tem poucos valores diferentes, mas o desenho do índice continua sendo o que decide.
Quando o índice não ajuda
- Função sobre a coluna.
WHERE date(emitido_em) = '2026-10-26'não usa o índice deemitido_em. Reescreva como intervalo (emitido_em >= '2026-10-26' AND emitido_em < '2026-10-27') ou crie um índice de expressão. - Curinga no começo.
LIKE '%arroz%'não usa B-tree. Para busca por trecho, o PostgreSQL oferece índices GIN com a extensãopg_trgmou a busca textual completa. - Filtro pouco seletivo. Se a condição devolve boa parte da tabela, ler tudo em sequência é mais barato, e o otimizador escolhe o seq scan, corretamente.
- Escrita. Cada índice é atualizado em todo
INSERT,UPDATEeDELETE. Crie índices para as consultas que existem, e não para as que talvez existam.
Em tabelas grandes em produção, CREATE INDEX CONCURRENTLY constrói o índice no PostgreSQL sem bloquear as gravações.
Outros tipos de índice
A árvore B resolve a maior parte dos casos, mas não todos. O PostgreSQL oferece variações e outros tipos que vale conhecer:
| Índice | Para quê | Exemplo |
|---|---|---|
| parcial | indexar só as linhas que interessam a uma consulta frequente | ON titulos (vencimento) WHERE pago_em IS NULL |
| de expressão | buscar pelo resultado de uma função | ON clientes (lower(email)), para buscas sem diferenciar maiúsculas |
| único parcial | unicidade só num subconjunto | um só endereço principal por cliente: UNIQUE ... WHERE principal |
| GIN | valores com várias partes: listas, JSON, texto completo e trechos com pg_trgm | USING gin (tags) para buscar posts por etiqueta |
| BRIN | tabelas enormes em que a ordem física acompanha uma coluna, como registros por data | ocupa uma fração mínima do espaço de uma árvore B |
| GiST | dados geométricos, intervalos e restrições de exclusão | impedir duas reservas sobrepostas da mesma sala |
O índice parcial é o mais subestimado da lista: em filas, títulos ou tarefas, a maior parte das linhas está num estado final, e um índice só com as pendentes é pequeno e acompanha exatamente a pergunta frequente.
Transações e concorrência
Uma transação agrupa operações que precisam acontecer juntas ou não acontecer, como debitar uma conta e creditar outra. As garantias são resumidas na sigla ACID: atomicidade (tudo ou nada), consistência (de um estado válido a outro, respeitando as restrições), isolamento (transações simultâneas não enxergam o trabalho pela metade umas das outras) e durabilidade (depois do COMMIT, a mudança sobrevive a uma queda de energia, porque o banco grava antes num registro sequencial, o WAL no PostgreSQL ou o redo log no Oracle).
MVCC: leitores não bloqueiam escritores
PostgreSQL e Oracle usam MVCC (multiversion concurrency control): quando uma linha é alterada, o banco mantém a versão antiga enquanto alguma transação ainda puder precisar dela, e cada transação lê a partir de uma fotografia consistente dos dados. Assim, leituras não bloqueiam gravações, e gravações não bloqueiam leituras. Uma consequência prática: é possível trocar o conteúdo inteiro de uma tabela dentro de uma transação, apagando tudo e inserindo de novo, e quem lê ao mesmo tempo vê a versão antiga completa até o COMMIT, e a nova completa depois, nunca uma tabela vazia ou pela metade.
No PostgreSQL, as versões antigas das linhas continuam no arquivo da tabela até serem limpas pelo VACUUM, que roda automaticamente. Transações abertas por muito tempo atrapalham essa limpeza, porque obrigam o banco a guardar todas as versões que elas ainda poderiam ver, e a tabela incha. Uma conexão "esquecida" com uma transação aberta é um problema real; o parâmetro idle_in_transaction_session_timeout encerra essas sessões depois de um tempo.
Níveis de isolamento
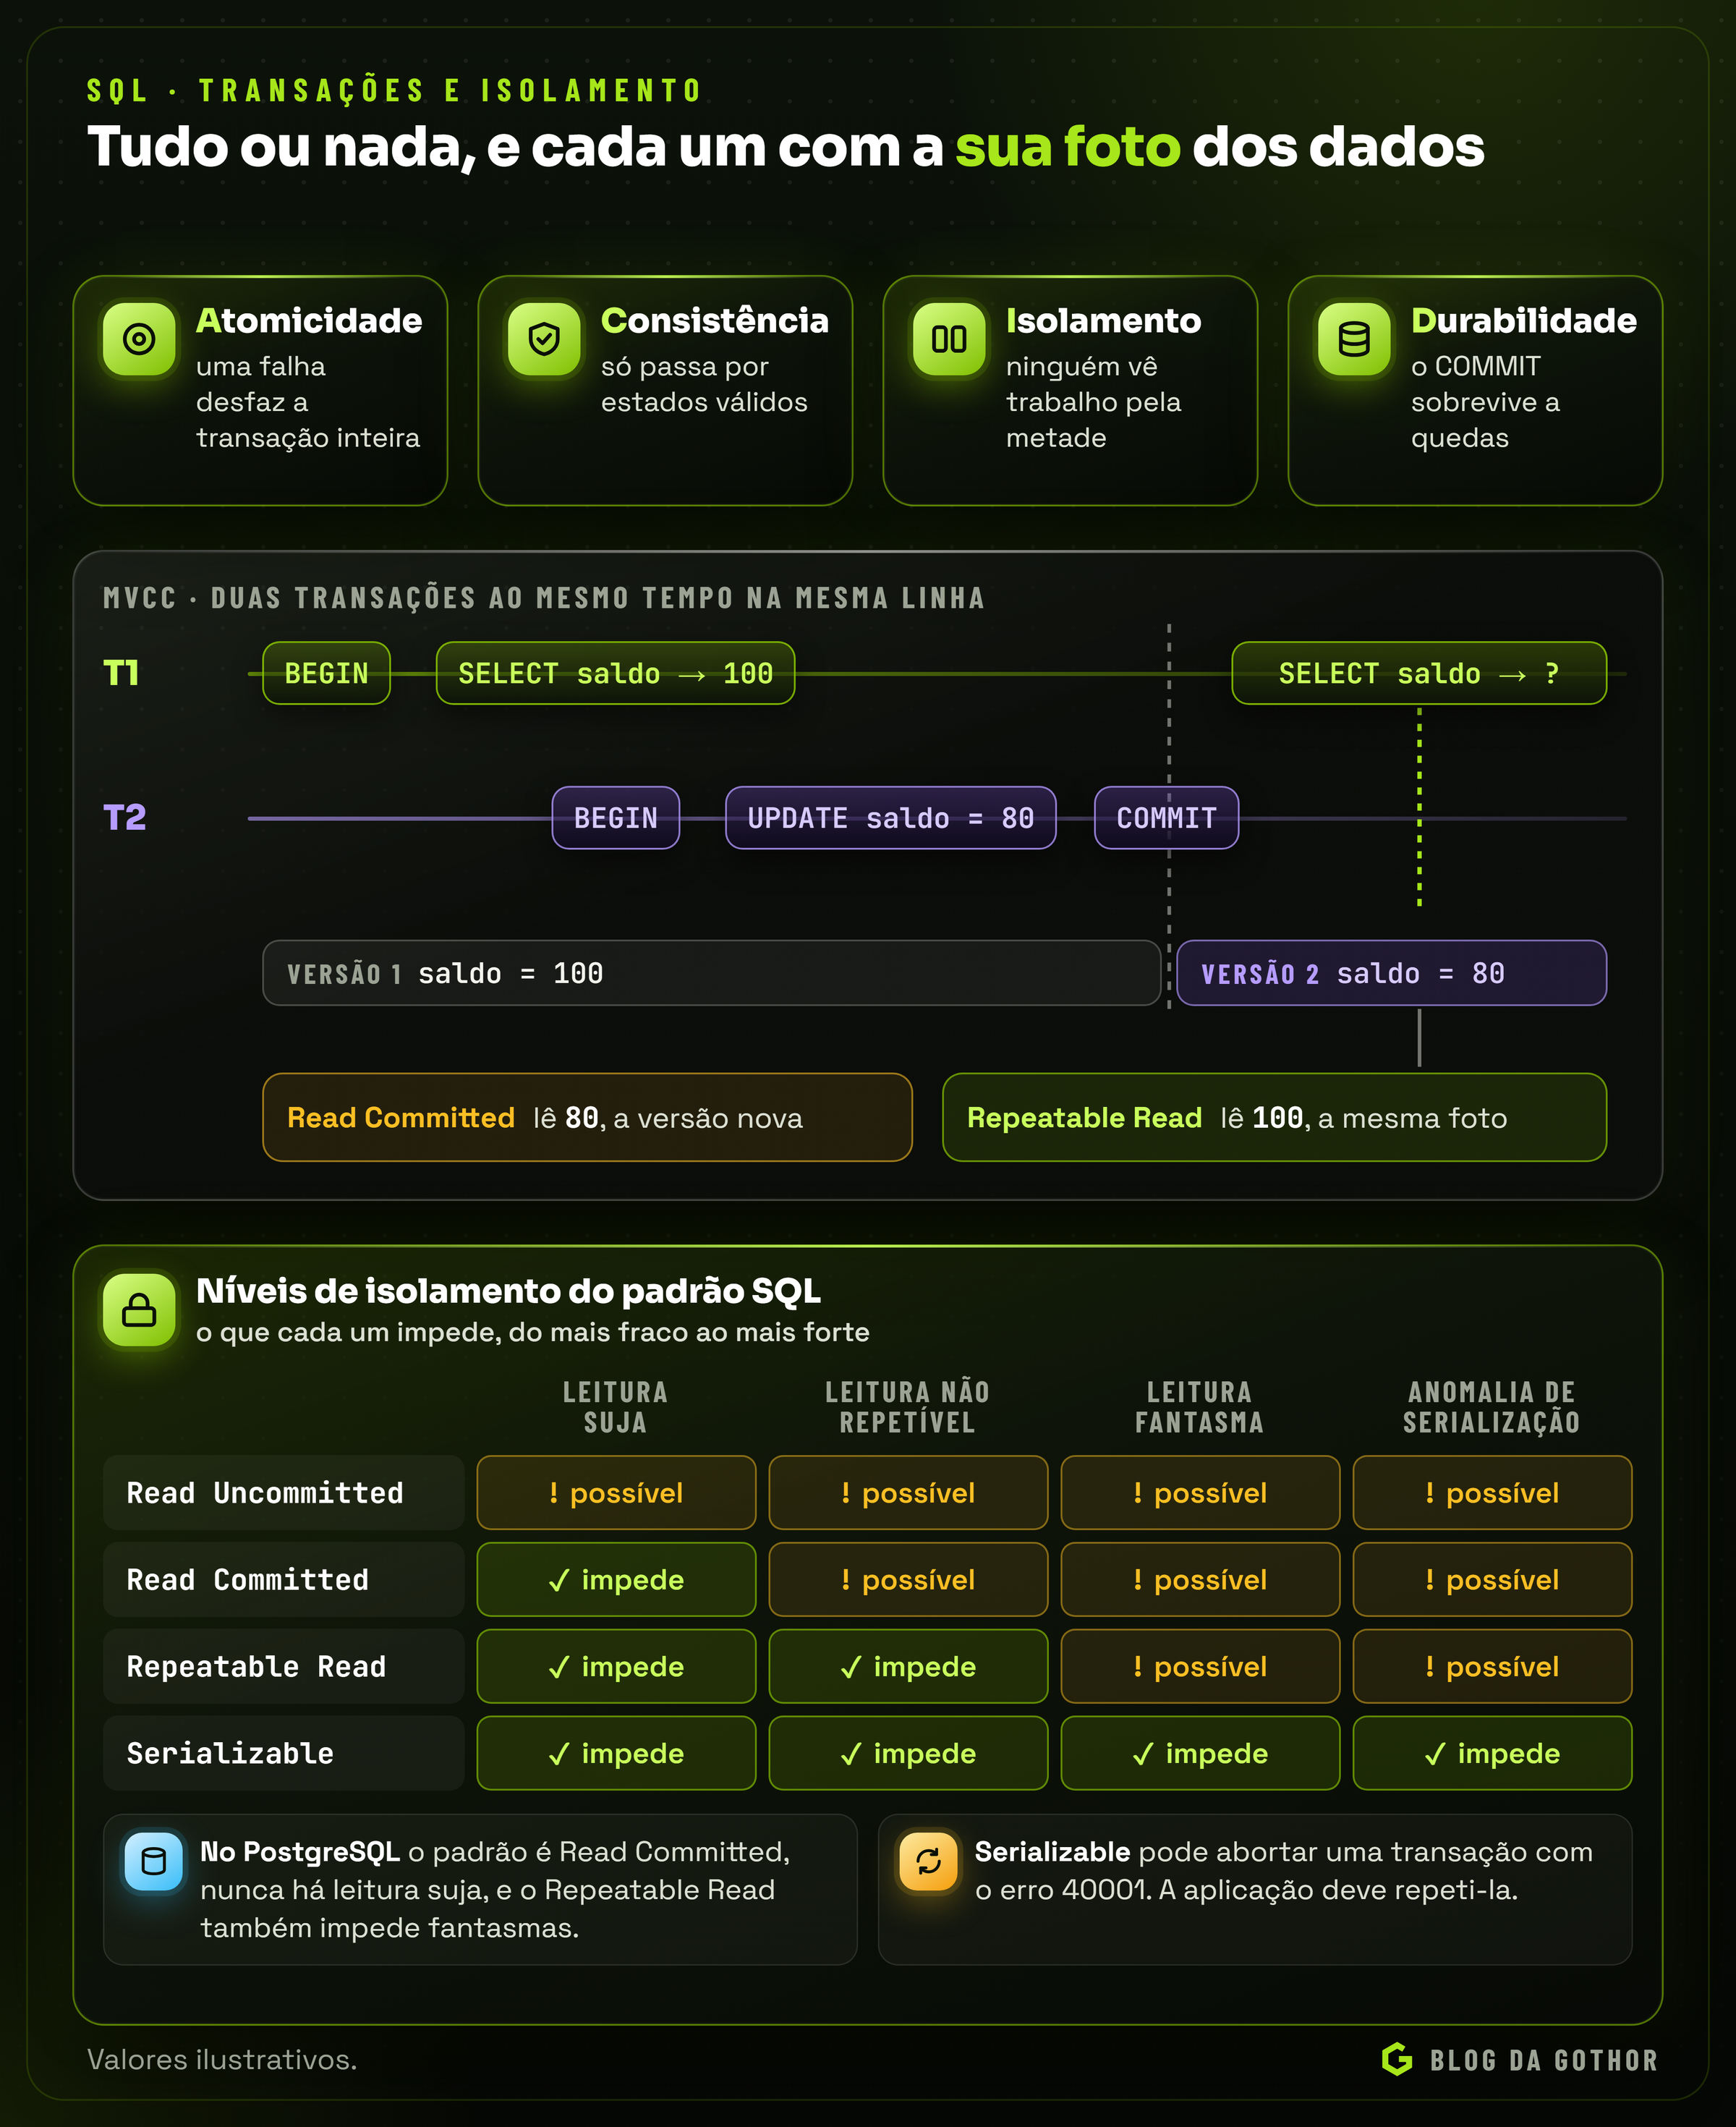
O padrão SQL define quatro níveis pelo tipo de anomalia que cada um impede: a leitura suja (ver dados ainda não confirmados), a leitura não repetível (ler a mesma linha duas vezes e encontrar valores diferentes), a leitura fantasma (repetir uma consulta e encontrar linhas novas) e a anomalia de serialização (um resultado que não corresponde a nenhuma ordem em que as transações poderiam ter rodado uma depois da outra). Do mais fraco ao mais forte: Read Uncommitted, Read Committed, Repeatable Read e Serializable.
Os bancos reais implementam isso à sua maneira. O PostgreSQL usa Read Committed como padrão, nunca mostra dados não confirmados, e o seu Repeatable Read também impede fantasmas. O Serializable dele detecta padrões perigosos e aborta uma das transações com um erro de serialização (código 40001), que a aplicação deve tratar repetindo a transação. O Oracle também usa Read Committed como padrão e oferece o Serializable.
Quando o Repeatable Read não basta
O Repeatable Read do PostgreSQL é implementado com a técnica que a literatura chama de isolamento por fotografia (snapshot isolation), e ela deixa passar uma anomalia sutil. A documentação dá o exemplo: uma tabela com linhas de duas classes; a transação A soma os valores da classe 1 e grava o resultado como uma linha nova da classe 2, enquanto a transação B, ao mesmo tempo, soma a classe 2 e grava o resultado na classe 1. Cada uma leu uma fotografia correta e alterou linhas que a outra não alterou, então as duas confirmam. Mas o resultado não corresponde a nenhuma ordem em fila: se A tivesse rodado antes, B teria somado outro valor.
O mesmo padrão aparece em regras de negócio reais: "pelo menos um gerente de plantão", "o limite de crédito considera todos os pedidos em aberto". Duas transações conferem a regra, cada uma vê que está tudo bem e cada uma faz uma alteração que, sozinha, respeita a regra; juntas, violam. No Serializable, o PostgreSQL detecta essas dependências entre leituras e gravações e desfaz uma das transações com o erro 40001. A documentação recomenda que a aplicação tenha um tratamento geral para esse erro, repetindo a transação inteira, e que declare READ ONLY as transações que só leem, o que reduz o custo da verificação.
A atualização perdida
A anomalia mais comum em sistemas de gestão é a atualização perdida: duas pessoas abrem o mesmo produto, uma soma 10 unidades ao estoque, a outra subtrai 3, e as duas gravam o valor que calcularam na aplicação. A última gravação apaga a primeira. Há três saídas:
- Deixar o banco fazer a conta, numa instrução só:
UPDATE estoque SET quantidade = quantidade - 3 WHERE produto_id = 7. - Travar ao ler, quando a decisão depende do valor lido:
SELECT ... FOR UPDATEdentro da transação. - Controle otimista: um número de versão na linha e a gravação com
WHERE id = 7 AND versao = 12. Se nenhuma linha for afetada, alguém mudou o registro no meio.
Travas, filas e deadlocks na prática
Além das travas de linha, que o UPDATE e o FOR UPDATE pegam sozinhos, três recursos resolvem problemas comuns de concorrência.
O primeiro é o FOR UPDATE SKIP LOCKED, que transforma uma tabela numa fila de trabalho segura: vários trabalhadores pegam a próxima tarefa pendente ao mesmo tempo, e cada um pula as linhas que outro já travou, sem esperar nem pegar a mesma tarefa duas vezes.
SELECT id, dados
FROM tarefas
WHERE situacao = 'pendente'
ORDER BY criada_em
LIMIT 1
FOR UPDATE SKIP LOCKED;
O segundo são as travas consultivas (advisory locks) do PostgreSQL, travas sobre um número escolhido pela aplicação, e não sobre uma linha. Elas servem para garantir que uma operação inteira, como uma importação ou uma troca completa de uma lista, rode uma de cada vez, mesmo com várias instâncias do serviço. A variante de transação, pg_advisory_xact_lock, é liberada sozinha no COMMIT ou no ROLLBACK.
O terceiro são os limites de espera. Por padrão, uma transação que encontra uma linha travada espera indefinidamente. Os parâmetros lock_timeout e statement_timeout limitam essa espera e a duração de cada comando, o que impede que uma migração demorada ou uma consulta descontrolada congele a aplicação inteira.
E há o deadlock: a transação A trava o pedido 1 e quer o 2, enquanto a B trava o 2 e quer o 1. Nenhuma pode continuar, e o banco detecta o ciclo e aborta uma delas. A prevenção é simples de dizer: transações curtas, sem esperar resposta de rede ou de pessoa dentro delas, e travas sempre na mesma ordem, por exemplo pelo id crescente.
Desempenho no dia a dia
No dia a dia de uma aplicação, outros fatores pesam tanto quanto índices e planos:
- O problema N+1. Buscar 100 pedidos e, num laço, o cliente de cada um gera 101 consultas; a soma das idas e vindas pela rede pesa. A correção é buscar os clientes de uma vez, com uma junção ou um
WHERE id IN (...). - Conexões são caras. No PostgreSQL, cada conexão é um processo do sistema operacional, com memória própria. Centenas de conexões abertas por aplicações que não as reaproveitam consomem o servidor. Um pool de conexões, na aplicação ou num serviço como o PgBouncer, mantém poucas conexões abertas e as empresta a cada requisição.
- Contar é caro. Por causa do MVCC, um
count(*)numa tabela grande confere a visibilidade de cada linha. Quando a tela só precisa de "cerca de 2 milhões", a estimativa das estatísticas da tabela basta. - Paginação pela chave.
OFFSET 100000lê e descarta cem mil linhas antes de devolver as próximas. Paginar pela última chave vista,WHERE id < :ultimo ORDER BY id DESC LIMIT 50, custa o mesmo na primeira e na milésima página. - Cargas em lote. Um
INSERTpor linha, cada um na sua transação, é lento; lotes numa transação, ou oCOPYdo PostgreSQL, são ordens de grandeza mais rápidos. - Saber onde está o tempo. A extensão
pg_stat_statementsagrupa as consultas pelo formato e mostra quantas vezes cada uma rodou e quanto tempo consumiu no total. A consulta que mais pesa raramente é a mais lenta, e sim uma rápida que roda um milhão de vezes por dia.
Mudando a estrutura sem parar a operação
Um banco em produção nunca fica parado: colunas novas aparecem, tipos mudam, tabelas se dividem. A dificuldade é que alguns comandos de estrutura travam a tabela enquanto rodam, e numa tabela grande isso pode significar minutos de sistema fora do ar. Conhecer o custo de cada comando evita surpresas:
| Comando no PostgreSQL | O custo |
|---|---|
ADD COLUMN anulável, ou com padrão constante | instantâneo desde a versão 11: só altera o catálogo |
ADD COLUMN ... DEFAULT now() ou outro padrão calculado | reescreve a tabela inteira |
SET NOT NULL | lê a tabela inteira para conferir; com uma restrição CHECK já validada, a leitura é dispensada |
ADD FOREIGN KEY ou ADD CHECK | confere todas as linhas; com NOT VALID e depois VALIDATE CONSTRAINT, a conferência não bloqueia as gravações |
CREATE INDEX | bloqueia as gravações até terminar; o CONCURRENTLY evita isso, ao custo de demorar mais |
| mudar o tipo de uma coluna | em geral, reescreve a tabela e todos os índices dela |
Para mudanças que quebram, como renomear uma coluna ou trocar o tipo dela, a técnica mais segura é expandir e contrair, em várias implantações pequenas em vez de uma grande:
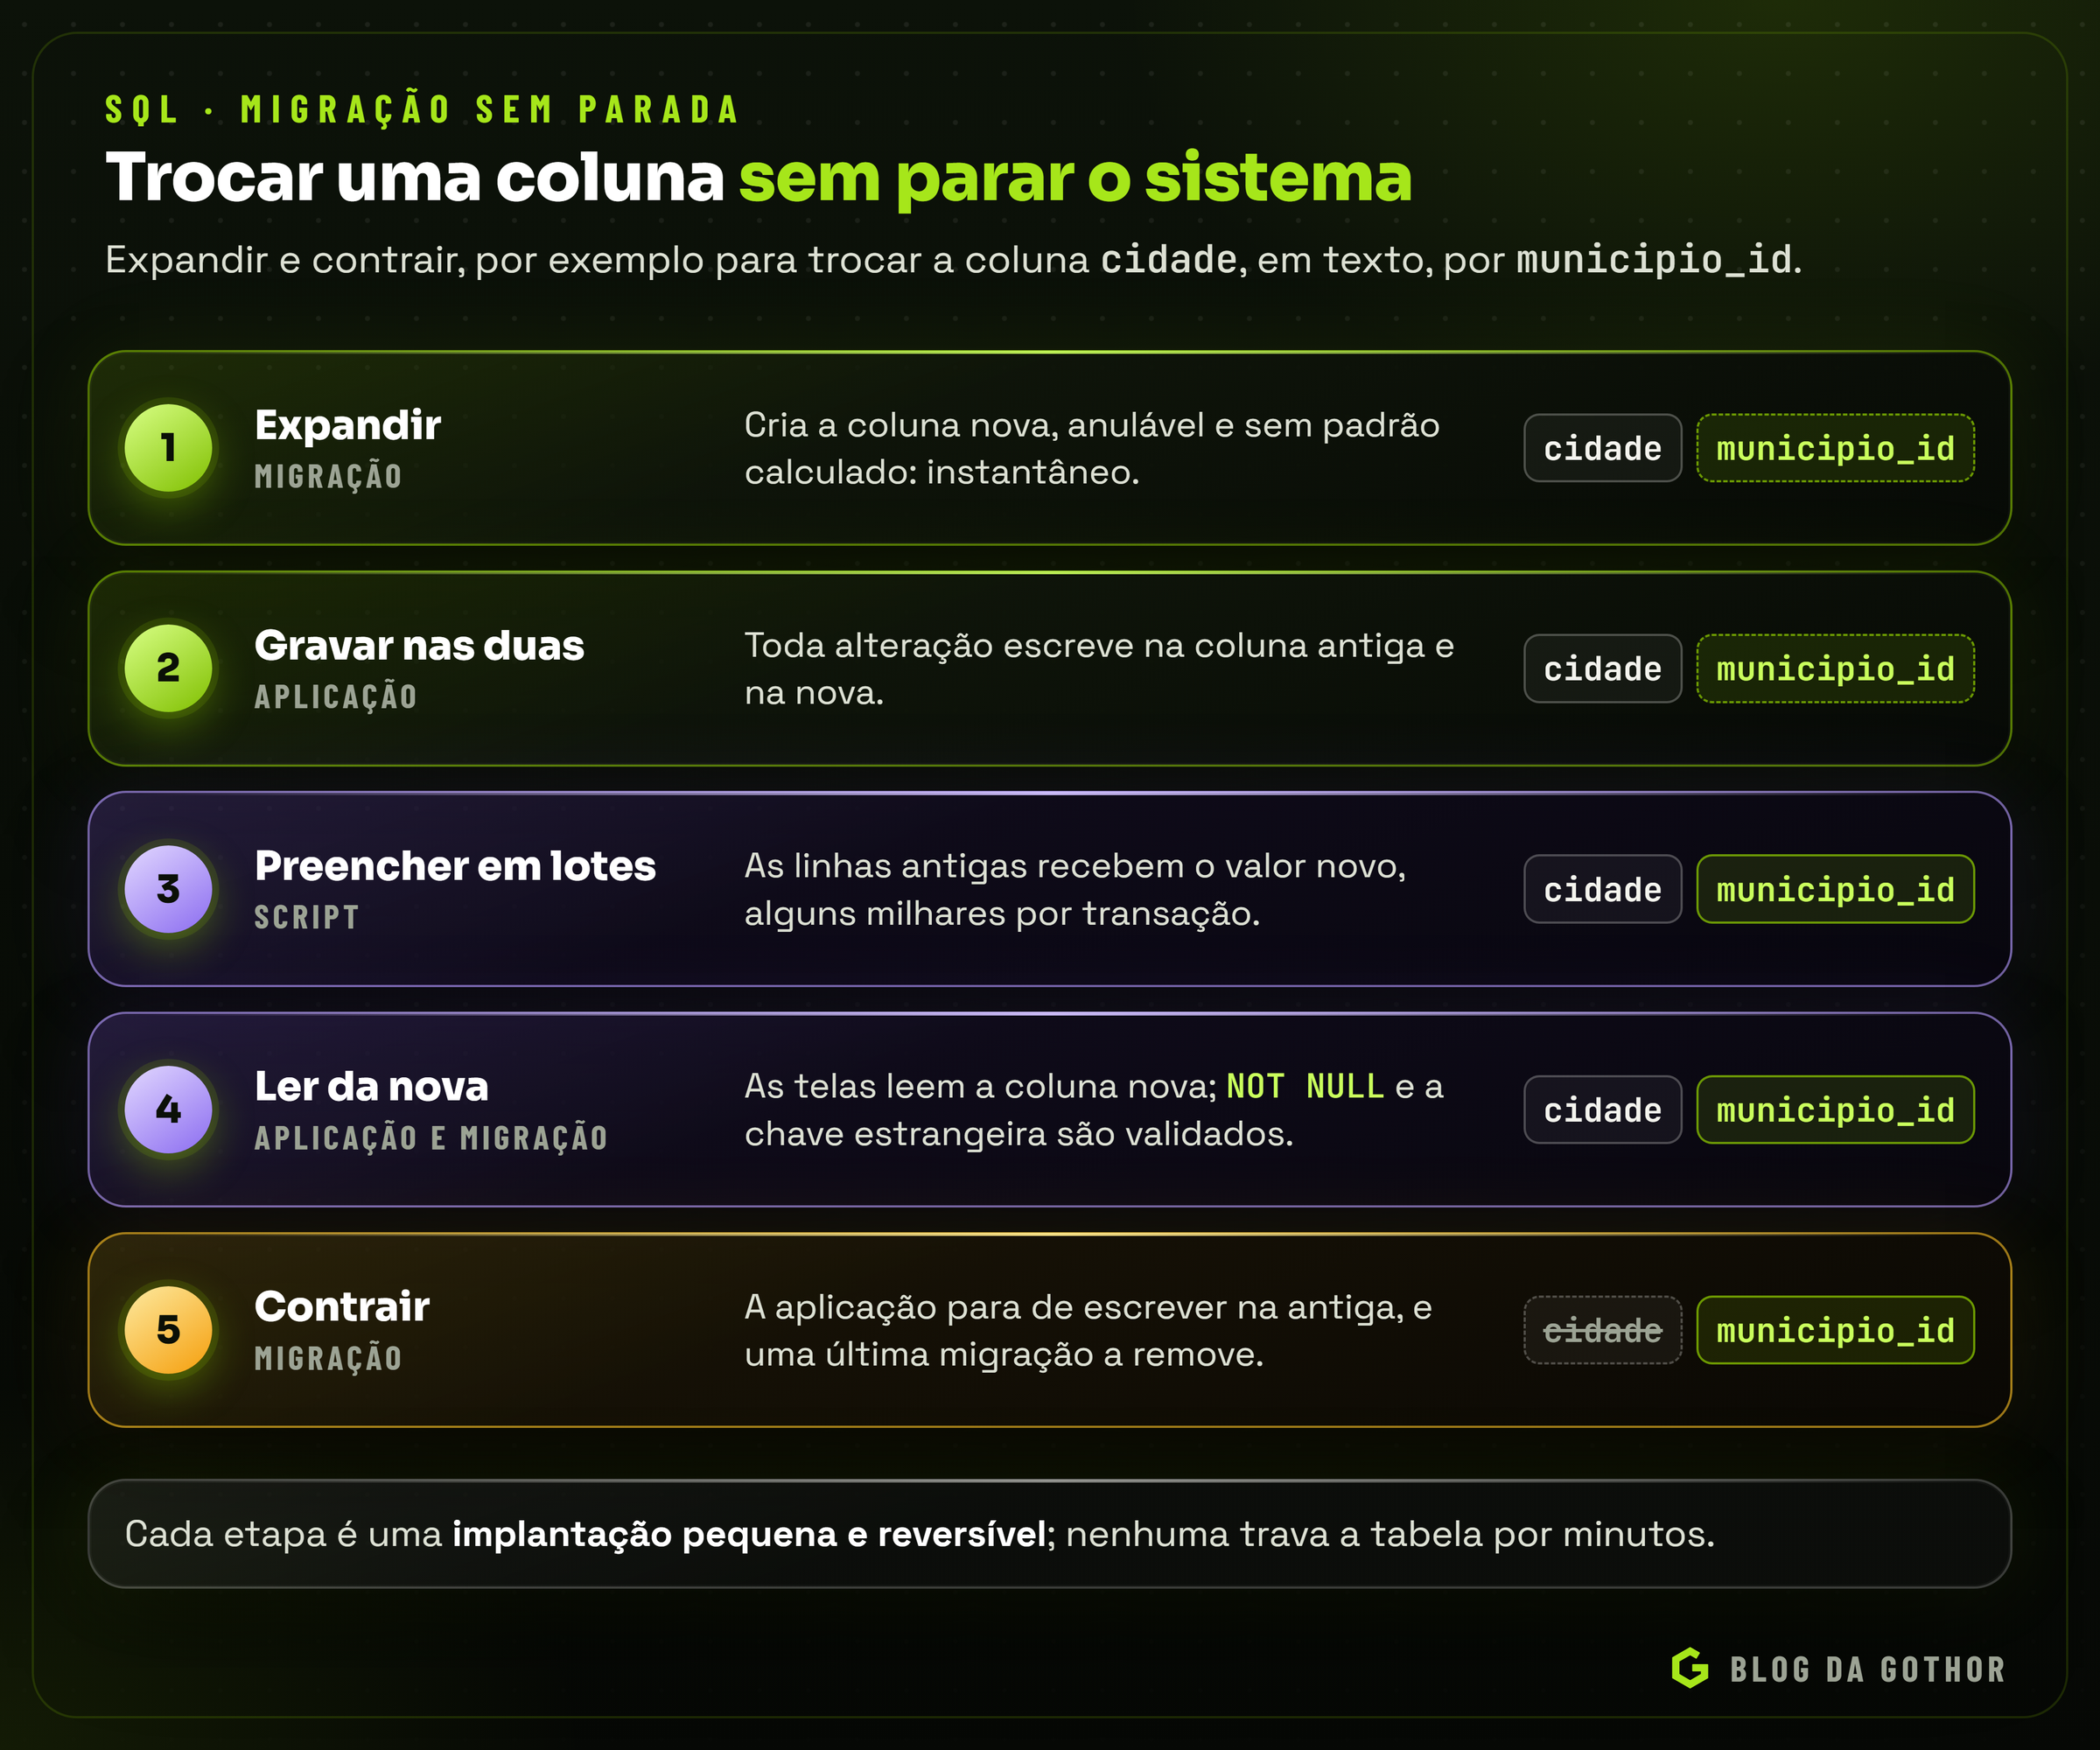
- Expandir: criar a coluna nova, anulável, sem padrão calculado.
- Gravar nas duas: a aplicação passa a escrever na antiga e na nova a cada alteração.
- Preencher em lotes: as linhas antigas recebem o valor novo em lotes de alguns milhares, cada lote na sua transação, para não segurar travas nem inchar o WAL de uma vez.
- Ler da nova: a aplicação passa a ler da coluna nova, e as restrições dela (
NOT NULL, chaves) são validadas. - Contrair: a aplicação para de escrever na antiga, e uma última migração a remove.
Cada etapa é reversível, e tudo entra em migrações versionadas, aplicadas na mesma ordem em todos os ambientes.
Dialetos: PostgreSQL, Oracle e os outros
O núcleo é o mesmo em todo lugar, mas cada banco tem diferenças que pegam quem migra de um para outro:
| Assunto | PostgreSQL | Oracle |
|---|---|---|
| Limitar linhas | LIMIT 10 ou FETCH FIRST 10 ROWS ONLY | FETCH FIRST 10 ROWS ONLY (12c em diante) ou ROWNUM |
| Texto vazio | '' é diferente de NULL | '' é tratado como NULL |
| Data | date só tem o dia | DATE guarda dia e hora até o segundo |
| Consulta sem tabela | SELECT 1 | SELECT 1 FROM dual |
| Parâmetros no driver | $1, $2 | :1 ou :nome |
| Linguagem procedural | PL/pgSQL | PL/SQL |
| Upsert | INSERT ... ON CONFLICT ou MERGE | MERGE |
| Diferença de conjuntos | EXCEPT | MINUS (e EXCEPT nas versões recentes) |
| Junção lateral | LATERAL | LATERAL ou CROSS APPLY |
O texto vazio merece atenção especial: no Oracle, WHERE observacao = '' nunca é verdadeiro, porque '' vira NULL, e código portado sem considerar isso produz relatórios silenciosamente errados. O DATE com hora é o outro clássico: WHERE vencimento = DATE '2026-10-26' não encontra um registro gravado às 14h daquele dia, e a forma segura é o mesmo intervalo semiaberto usado no PostgreSQL.
SQL, ORMs e segurança
Um ORM (Prisma, TypeORM, Hibernate) traduz tabelas em objetos, gera o SQL e organiza as migrações, os arquivos que versionam cada mudança de estrutura. Ele acelera o trabalho comum, mas não dispensa saber SQL: o problema N+1 nasce justamente de um laço inocente sobre objetos, e consultas analíticas costumam ficar mais claras em SQL escrito à mão.
A injeção de SQL, uma das falhas mais graves de aplicações web, acontece quando um texto vindo do usuário é concatenado na consulta. A defesa é usar parâmetros: os valores vão separados do comando e nunca são interpretados como SQL.
// ERRADO: com nome = "x' OR '1'='1", a consulta devolve todos os clientes
await pool.query("SELECT id, nome FROM clientes WHERE nome = '" + nome + "'");

// CERTO: o valor viaja como parâmetro, nunca como texto do comando
await pool.query('SELECT id, nome FROM clientes WHERE nome = $1', [nome]);
Parâmetros servem para valores, e não para nomes de tabelas ou colunas; quando o nome precisa variar, valide contra uma lista fechada. E aplique o menor privilégio: a aplicação conecta com um usuário que só pode fazer o que ela precisa, sem permissão para apagar tabelas ou criar usuários. Para dados de vários clientes na mesma tabela, o PostgreSQL oferece ainda a segurança por linha (row-level security): políticas declaradas no banco que limitam quais linhas cada usuário enxerga, uma segunda barreira caso a aplicação esqueça um filtro.
Dois cuidados completam o quadro. Segredos não ficam no banco em texto puro: senhas são guardadas como hash lento, com sal, e tokens de uso único, como os de redefinição de senha, como hash, para que um vazamento do banco não entregue credenciais utilizáveis. E cópias de segurança só valem se forem restauradas: um teste periódico de restauração é o que prova que o pg_dump ou o arquivamento do WAL funcionam.
Erros comuns
| Erro | Por que acontece | A correção |
|---|---|---|
SELECT * em código de aplicação | é mais rápido de escrever | liste as colunas: o resultado não muda quando a tabela muda |
| junções que multiplicam linhas | duas tabelas filhas juntadas ao mesmo pai | agregue cada filha antes de juntar |
filtro da tabela da direita no WHERE de um LEFT JOIN | o NULL completado não passa no filtro | leve a condição para o ON |
comparar com NULL usando =, ou NOT IN com nulos | a lógica de três valores | IS NULL e NOT EXISTS |
funções sobre colunas indexadas no WHERE | o índice guarda a coluna, e não a função | intervalo ou índice de expressão |
BETWEEN com datas e horas | o fim para numa meia-noite | intervalo semiaberto, com < no fim |
paginação com OFFSET alto | o banco lê e descarta as linhas puladas | paginação pela chave |
| ler, calcular na aplicação e gravar | duas sessões calculam a partir do mesmo valor | operação atômica, FOR UPDATE ou versão |
| migração que trava uma tabela grande | o comando reescreve ou confere a tabela inteira | CONCURRENTLY, NOT VALID e expandir e contrair |
Boas práticas
- Modele primeiro e coloque as regras de integridade no banco, e não só na aplicação.
- Versione toda mudança de estrutura como migração, revisada como qualquer código.
- Crie índices a partir das consultas reais e confira com
EXPLAIN ANALYZE. - Use parâmetros sempre e prefira operações atômicas a ler e gravar na aplicação.
- Mantenha as transações curtas e trate erros de serialização com novas tentativas limitadas.
- Monitore as consultas mais caras com
pg_stat_statementse defina limites de tempo para comandos e esperas.
Perguntas frequentes
SQL ou NoSQL? Para dados de negócio com relações, totais e regras de integridade, como pedidos, títulos e estoque, um banco relacional é quase sempre a escolha certa. Bancos não relacionais brilham em casos específicos, como cache, busca textual e grandes volumes de eventos, e costumam conviver com o relacional, e não substituí-lo.
Preciso saber SQL se uso um ORM? Sim. O ORM escreve o SQL do dia a dia, mas é o SQL que explica por que uma tela ficou lenta, por que um total dobrou ou por que uma migração travou a produção.
O que é uma view, e uma materialized view? Uma view é uma consulta com nome, que o banco expande a cada uso: não guarda dados, só simplifica. Uma materialized view guarda o resultado e precisa ser atualizada (REFRESH MATERIALIZED VIEW); é útil para relatórios pesados que podem estar alguns minutos defasados.
Como usamos SQL na Gothor
Títulos, pedidos e pagamentos passam por bancos relacionais em quase tudo o que a Gothor faz, inclusive nas integrações com o Winthor. Os cuidados deste artigo são parte do trabalho diário: consultas parametrizadas, nunca montadas por concatenação de texto; transações onde várias gravações precisam acontecer juntas; e mudanças de estrutura versionadas, aplicadas da mesma forma em todos os ambientes.
Resumo
- SQL é declarativo: você descreve o resultado, e o otimizador decide como obtê-lo, apoiado na álgebra relacional.
- O modelo relacional liga tabelas por valores, com chaves primárias e estrangeiras; normalizar é guardar cada fato num lugar só, e chaves substitutas poupam mudanças dolorosas.
- A ordem lógica do
SELECTexplica onde cada filtro e cada apelido podem ser usados. - Junções combinam linhas por uma condição; cuidado com a multiplicação de linhas, com o filtro no lugar errado de um
LEFT JOINe comNULL. - Períodos se filtram com intervalos semiabertos e com o fuso certo; texto se compara com a collation certa.
ROLLUPdá os subtotais numa leitura só, as molduras definem o que cada função de janela enxerga e oWITH RECURSIVEpercorre árvores.- O otimizador escolhe o plano pelo custo estimado a partir das estatísticas;
EXPLAIN ANALYZEmostra o que de fato aconteceu. - Índices B-tree são rasos, ordenados e equilibrados; a ordem das colunas importa, e índices parciais são pequenos e certeiros.
- Transações dão garantias ACID; o MVCC deixa leituras e gravações conviverem, e o nível de isolamento define as anomalias possíveis.
- Parâmetros sempre, operações atômicas, transações curtas e migrações em etapas evitam os problemas mais caros.
Para ir além
- A linguagem SQL na documentação do PostgreSQL, o ponto de partida do item no Wisdom.
- Tutorial do PostgreSQL e o capítulo sobre funções de janela.
- Usando o EXPLAIN, índices, estatísticas do planejador e controle de concorrência, na documentação do PostgreSQL.
- Travas explícitas no PostgreSQL, com as travas de linha e as consultivas.
- Consultas com WITH, GROUPING SETS, CUBE e ROLLUP, chamadas de funções de janela e molduras e as funções de janela, na documentação do PostgreSQL.
- Níveis de isolamento, restrições adiáveis no CREATE TABLE, collations e instruções preparadas, também na documentação do PostgreSQL.
- Recursos do padrão SQL no PostgreSQL, com as partes da ISO/IEC 9075, e as notas das versões 11, 12, 14 e 18.
- Consultas hierárquicas no Oracle, com o
CONNECT BY. - Referência da linguagem SQL do Oracle Database e os conceitos do Oracle Database.
- O artigo original de E. F. Codd, de 1970, na biblioteca da ACM.
- Documentação do Prisma, com a página sobre SQL bruto.
- Prevenção de injeção de SQL, da OWASP.
Este post foi escrito com a ajuda da Juniper, a assistente de IA da Gothor, e revisado pela nossa equipe antes de ir ao ar.