JSON por dentro: o formato que virou a língua comum das APIs
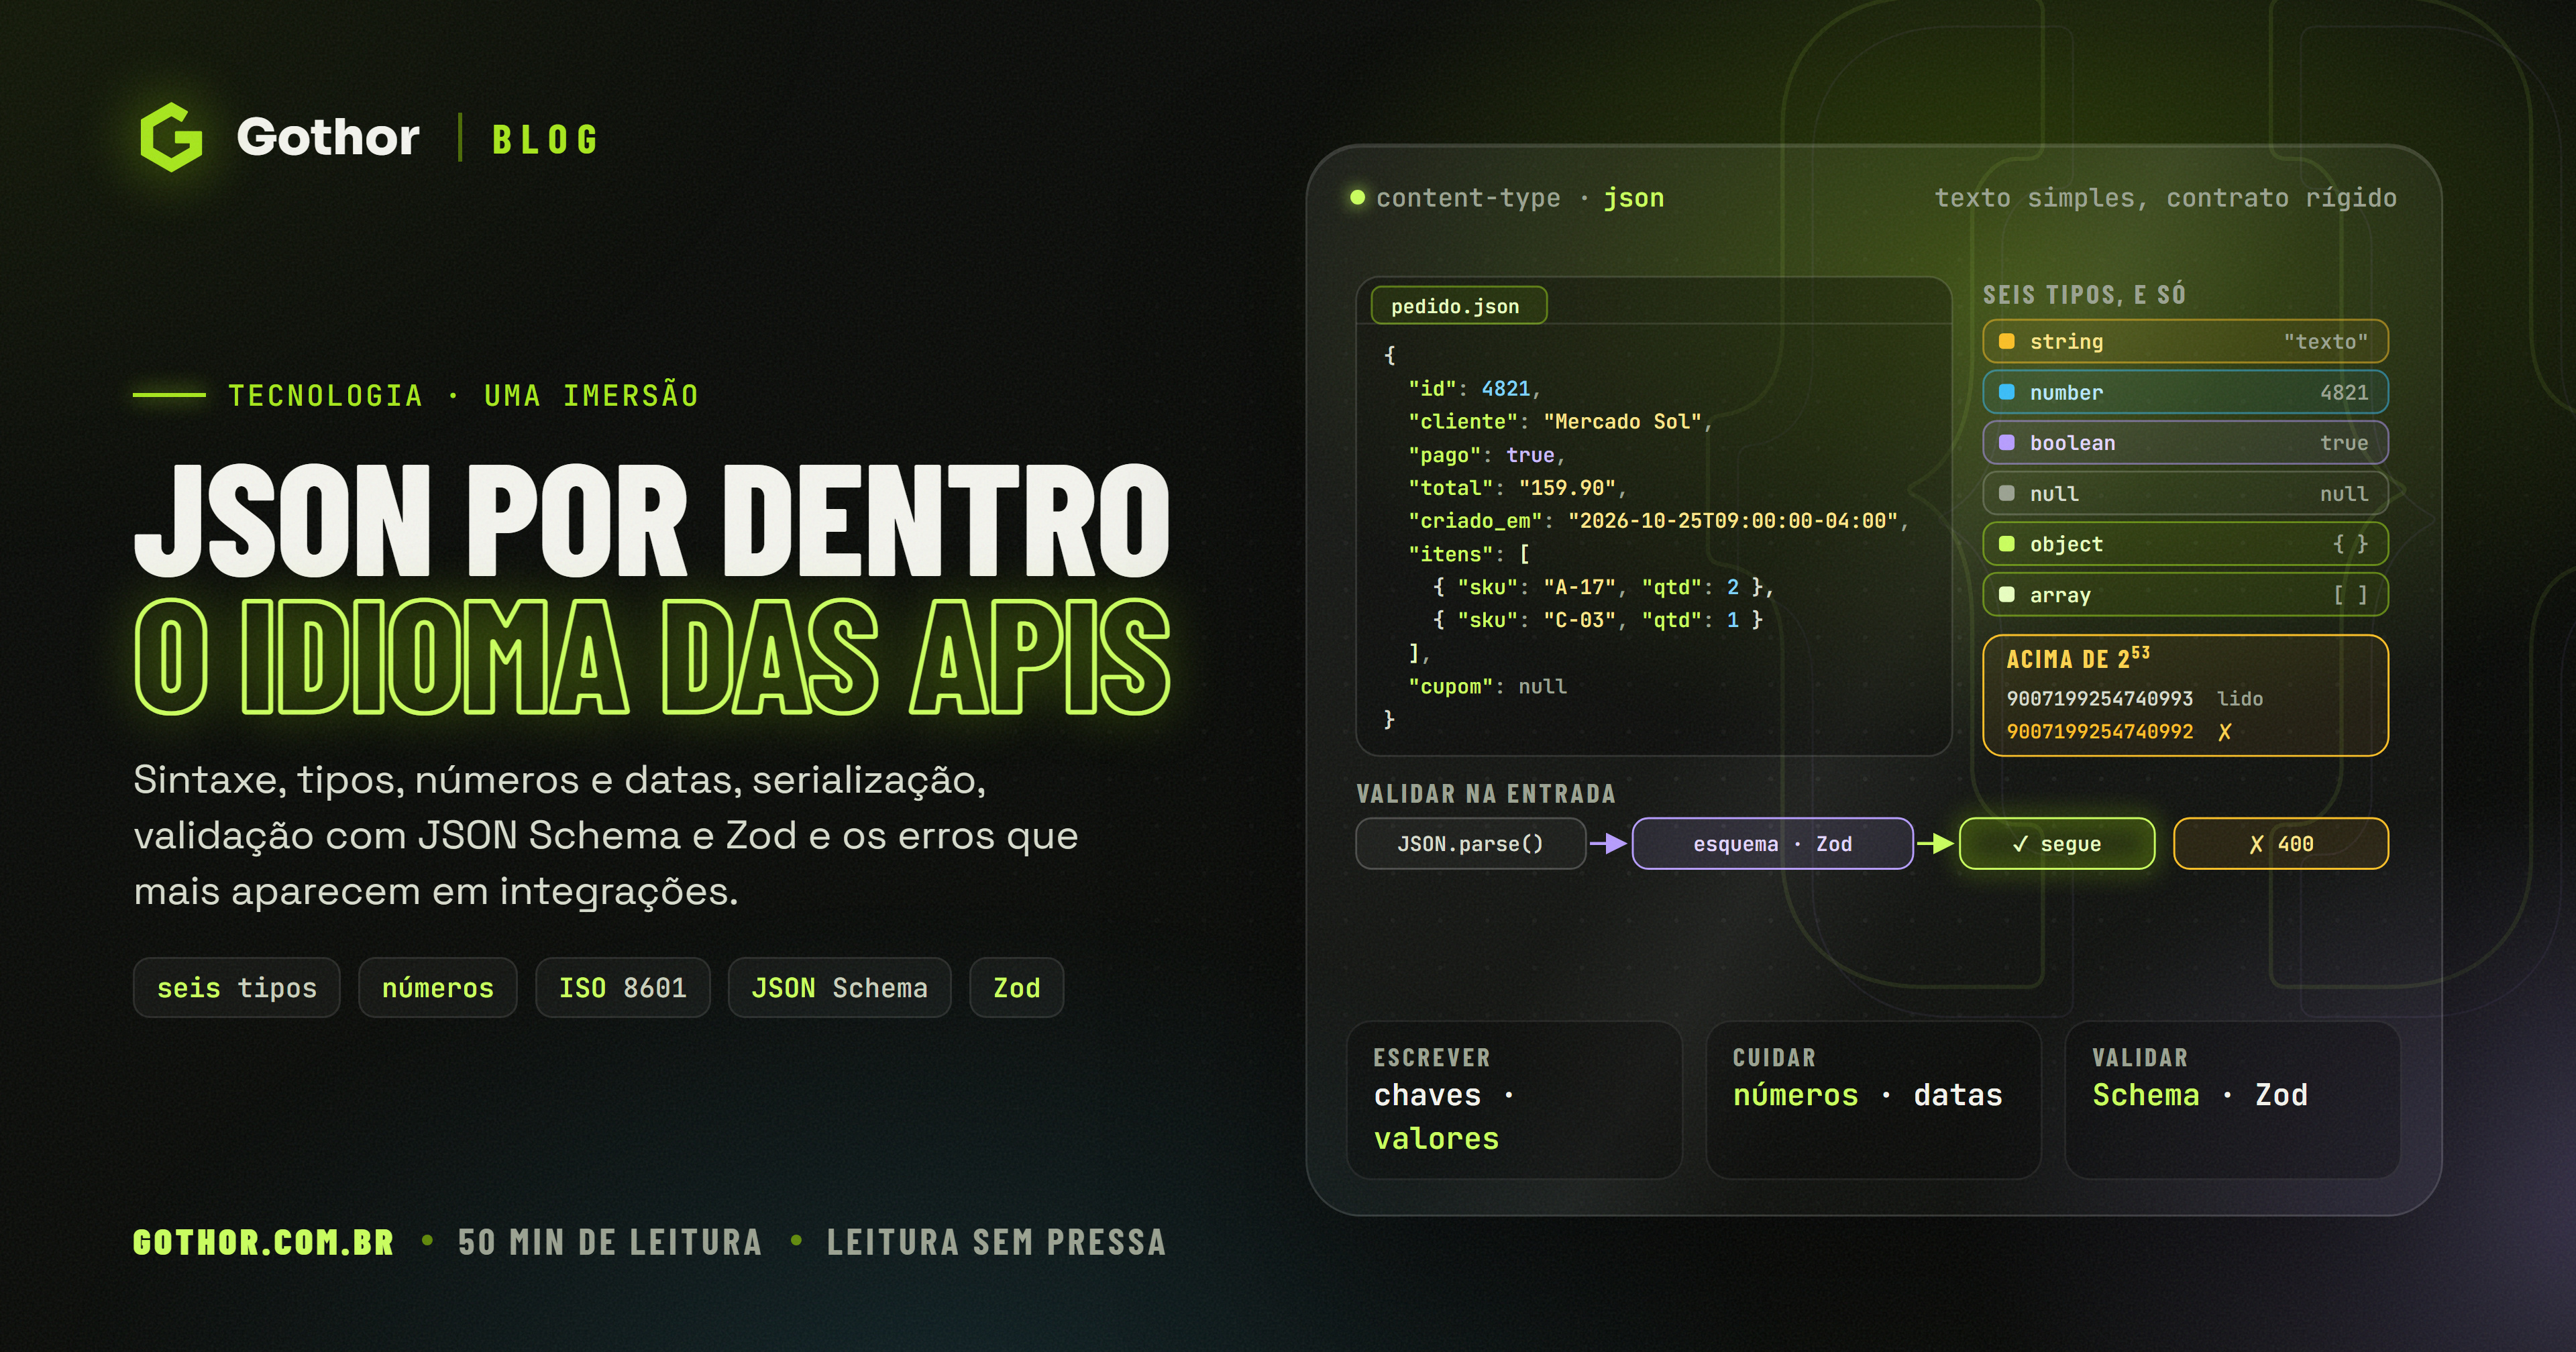
Uma imersão no JSON, da sintaxe aos contratos entre sistemas, passando por números, datas, validação, IA e os erros mais comuns em integrações, com o jeito como usamos o formato na Gothor.
Quando um aplicativo de celular mostra os seus pedidos, quando o sistema de gestão consulta o saldo no banco, quando a loja virtual calcula o frete com a transportadora, os dados quase sempre viajam no mesmo formato: JSON. Ele está nas APIs, nos arquivos de configuração, nos logs, nos bancos de dados, nas conversas com modelos de inteligência artificial e até dentro das páginas da web, descrevendo o conteúdo para os buscadores.
O JSON é tão simples que cabe num cartão de visita, e é exatamente por isso que tanta gente o usa sem conhecer os detalhes. Os problemas aparecem nas bordas: um identificador grande que muda sozinho, uma data que chega sem fuso, um valor em dinheiro com casas decimais estranhas, uma vírgula sobrando que derruba uma integração inteira, um campo renomeado que quebra um aplicativo de que ninguém lembrava. Este artigo explica o formato de dentro para fora: de onde veio, as regras exatas da sintaxe, como um leitor de JSON trabalha, o que acontece na ida e na volta entre texto e objeto, como validar o que chega, como desenhar e evoluir contratos entre sistemas e como evitar os erros mais comuns.
O que é JSON
JSON, JavaScript Object Notation, é um formato de texto para representar dados estruturados. Ele descreve valores simples, como textos e números, e duas formas de agrupá-los: listas ordenadas e objetos com pares de nome e valor. Com essas peças, dá para representar praticamente qualquer estrutura de dados: um pedido com os seus itens, um cliente com os seus endereços, uma configuração com as suas opções.
Três características explicam o sucesso:
- É texto legível. Uma pessoa consegue ler e escrever JSON sem ferramenta nenhuma, e um log ou uma resposta de API pode ser inspecionado a olho.
- É mínimo. A especificação completa tem poucas páginas, e qualquer linguagem de programação tem um leitor de JSON pronto, normalmente na biblioteca padrão.
- Mapeia direto para as estruturas das linguagens. Objeto vira dicionário, mapa ou objeto; lista vira array ou vetor. Não há tradução complexa entre o formato e o código.
O nome engana um pouco: apesar de vir da sintaxe de objetos do JavaScript, o JSON é independente de linguagem. Python, Java, C#, Go, Rust, Dart, PHP e todas as outras linguagens relevantes o leem e escrevem com a mesma naturalidade.
Vale separar desde já duas ideias que se confundem no dia a dia. O texto JSON é a sequência de caracteres que viaja pela rede ou fica gravada num arquivo. O objeto é a estrutura que existe na memória de um programa depois que esse texto é lido. Um objeto JavaScript pode ter funções, datas, valores indefinidos e referências circulares; um texto JSON não tem nada disso. Boa parte dos problemas deste artigo nasce na passagem de um para o outro.
Uma história curta
No começo dos anos 2000, aplicações web começavam a buscar dados no servidor sem recarregar a página, e o formato da moda para trocar dados era o XML. Douglas Crockford e colegas da State Software perceberam que a própria notação de objetos do JavaScript resolvia o problema com muito menos cerimônia: o navegador já sabia interpretá-la. Crockford não se diz inventor, e sim "descobridor" do formato, porque a sintaxe já existia na linguagem. Em 2001 ele passou a chamá-lo de JSON, e em 2002 publicou o site json.org, com os diagramas de sintaxe que até hoje resumem tudo.
O crescimento acompanhou o Ajax e as APIs web. Em 2006, a RFC 4627 registrou o tipo de mídia application/json. Em 2009, o ES5 trouxe JSON.parse e JSON.stringify nativos para o JavaScript, acabando com a prática perigosa de interpretar respostas com eval. Em 2013, a Ecma publicou o padrão ECMA-404, e em 2017 a RFC 8259 consolidou a especificação e passou a exigir UTF-8 na troca de dados entre sistemas. Pelo caminho, o JSON tirou o XML do posto de formato padrão das APIs web.
Um detalhe dessa história explica uma das regras mais discutidas do formato: o JSON não aceita comentários. Crockford conta que os removeu porque algumas pessoas passaram a usá-los para colocar instruções de processamento, o que destruiria a interoperabilidade. A decisão incomoda em arquivos de configuração até hoje, e por isso surgiram variações como o JSONC e o JSON5, que veremos adiante.
Dois episódios que moldaram as regras
A primeira RFC exigia que um documento fosse um objeto ou uma lista no nível de cima. A RFC 7159, de 2014, retirou a restrição, e hoje 42 e "ok" são documentos válidos. Mesmo assim, objetos no topo continuam sendo a recomendação, e há um motivo histórico para isso: o JSON hijacking. Por volta de 2006, pesquisadores mostraram que, em navegadores da época, um site malicioso podia incluir uma API de outro domínio com uma tag <script>; se a resposta fosse uma lista, ela era executada como JavaScript, e o atacante lia os dados com os cookies da vítima. Os navegadores modernos fecharam a brecha, mas o costume de responder com um objeto ficou.
O segundo episódio é mais sutil. Durante anos, o JSON não era um subconjunto exato do JavaScript: o separador de linha (U+2028) e o separador de parágrafo (U+2029) eram válidos dentro de textos JSON, mas proibidos em textos literais do JavaScript. Código que embutia JSON numa página quebrava quando alguém colava um texto com esses caracteres. A edição de 2019 da linguagem corrigiu a diferença.
A sintaxe completa, sem atalhos
Toda a gramática do JSON cabe num diagrama. Um documento JSON é um valor, e um valor é um destes seis tipos:
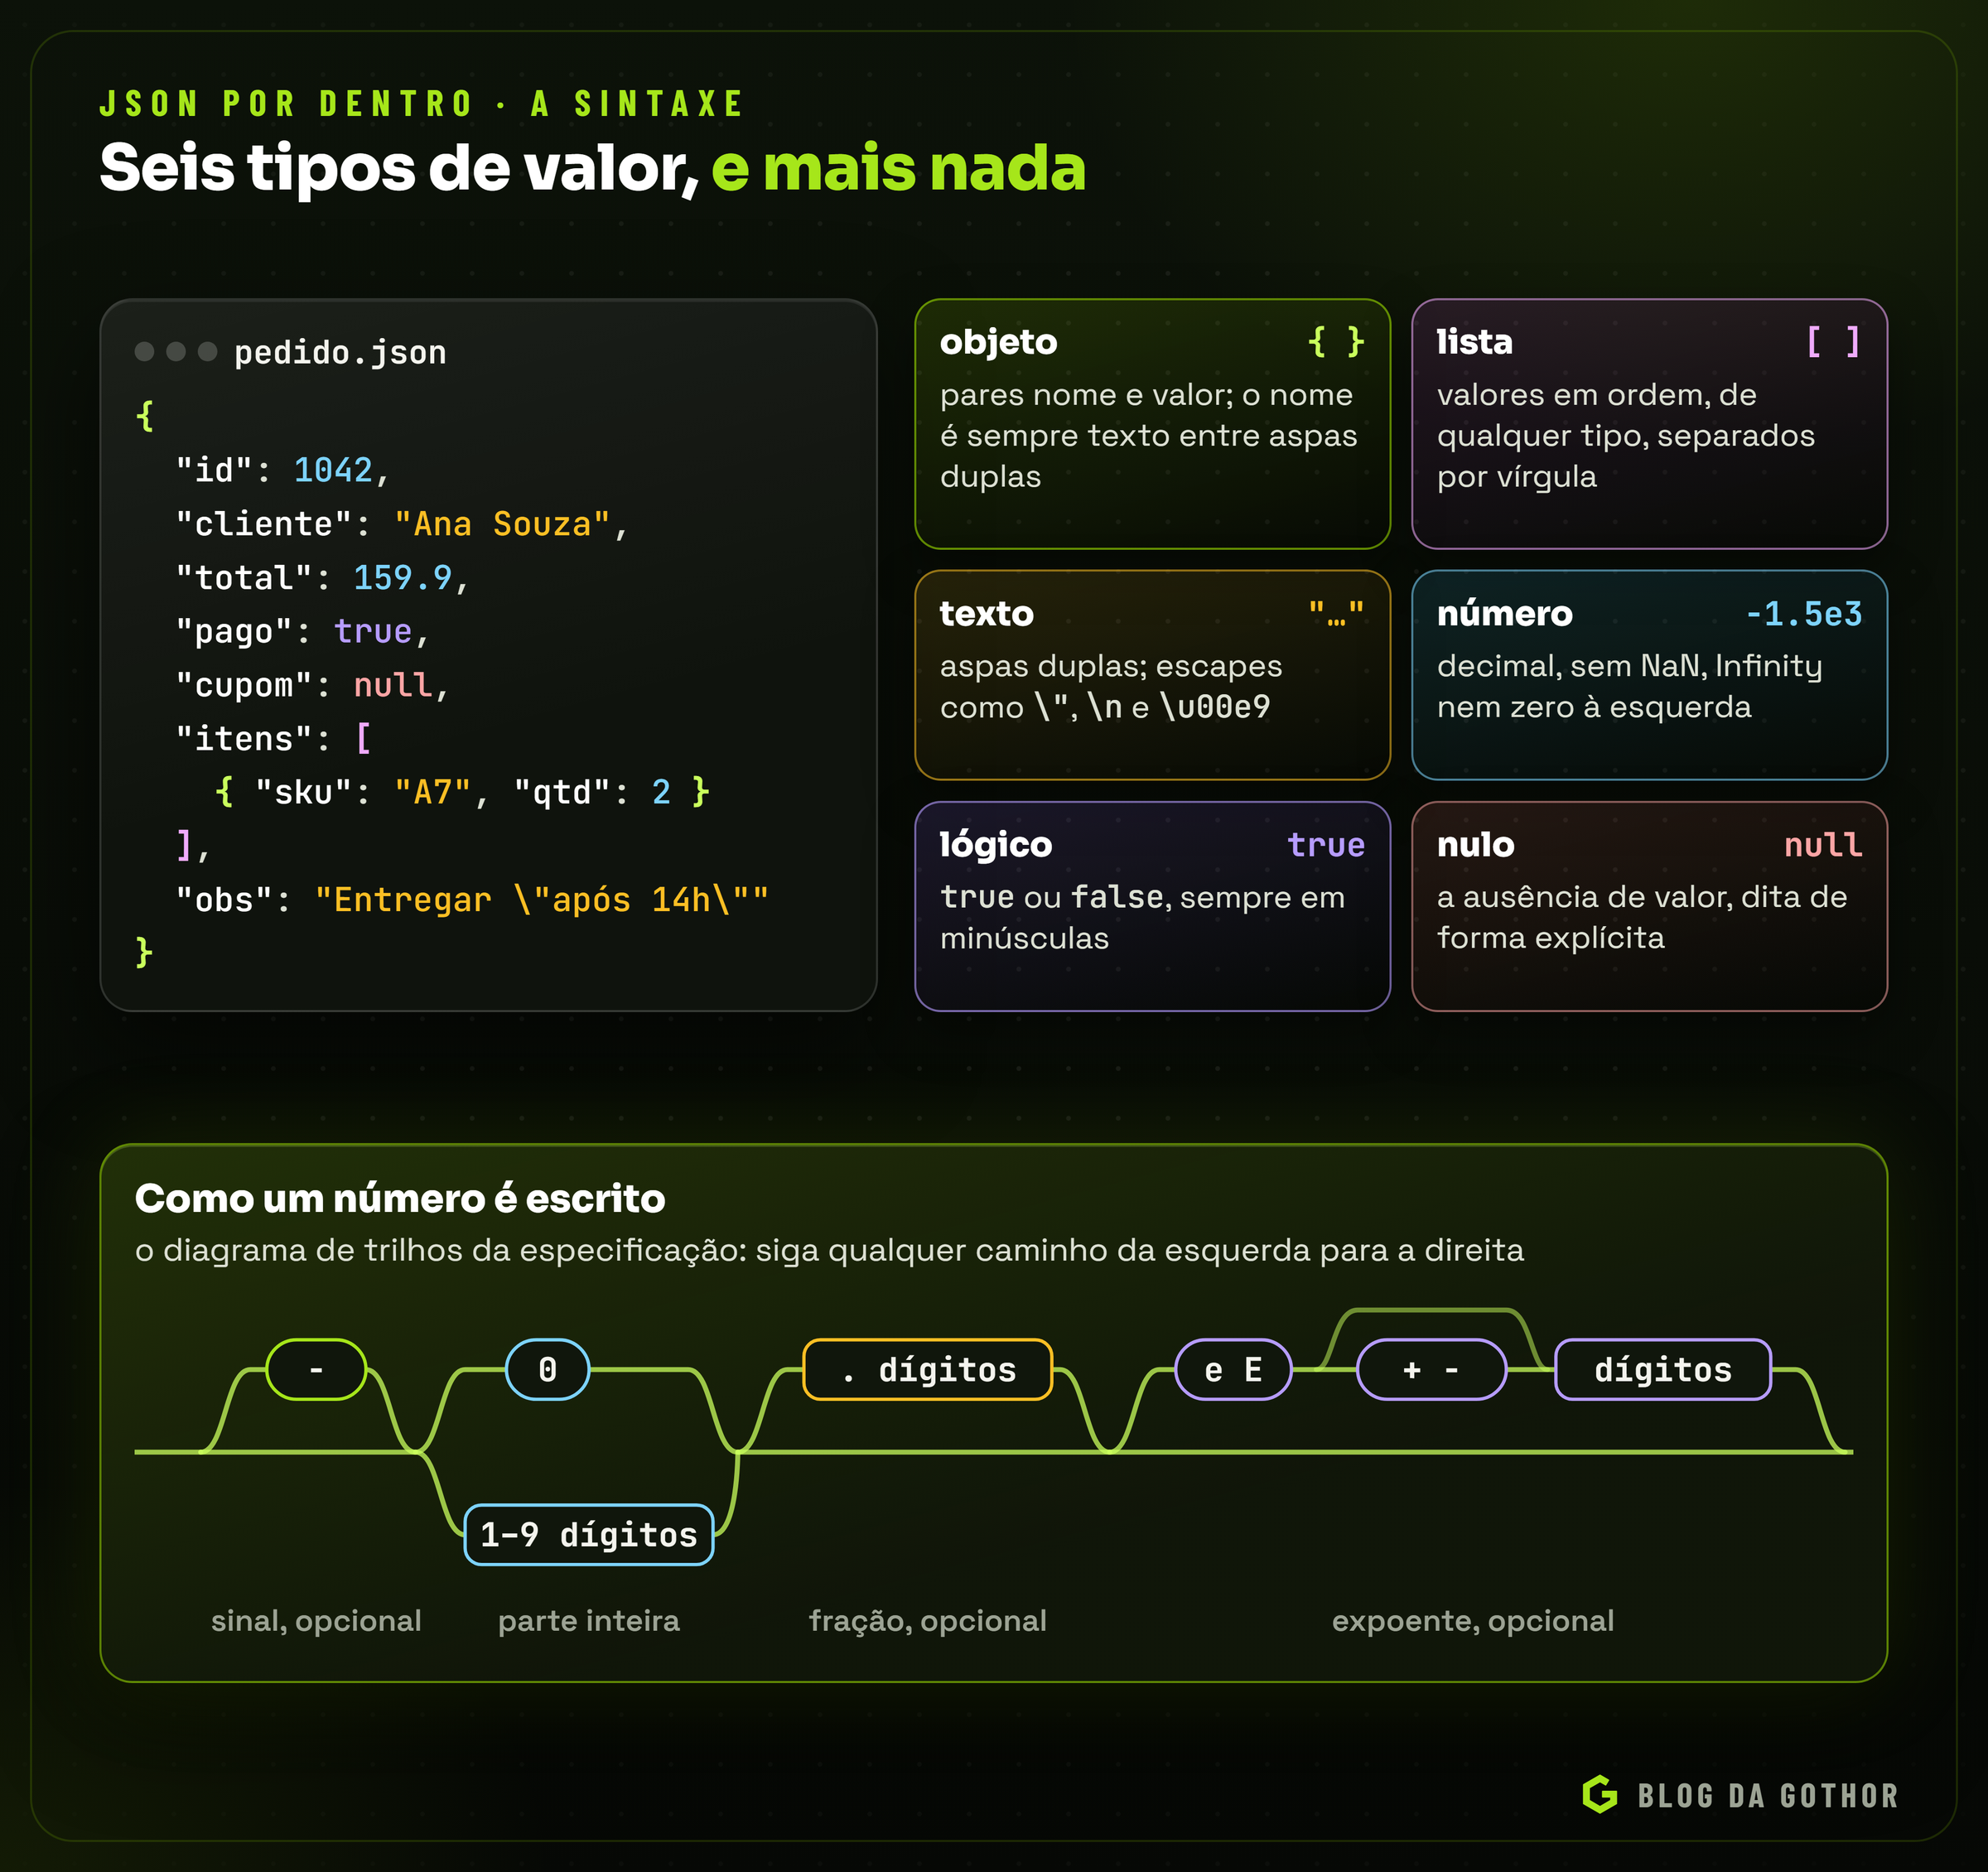
- Objeto: pares
"nome": valorentre chaves, separados por vírgula. O nome é sempre um texto entre aspas duplas. - Lista (array): valores entre colchetes, em ordem, separados por vírgula. Os valores podem ser de tipos diferentes.
- Texto (string): caracteres Unicode entre aspas duplas, com escapes por barra invertida:
\",\\,\n,\te\u00e9para um caractere pelo código. - Número: decimal, com sinal opcional, fração opcional e expoente opcional, como
42,-3.75e1.5e3. - Lógico:
trueoufalse, em minúsculas. - Nulo:
null.
Espaços, quebras de linha e tabulações entre os elementos são ignorados, então o mesmo documento pode ser escrito numa linha só ou formatado com recuos.
O que a sintaxe não aceita é tão importante quanto o que aceita, porque é aí que as integrações quebram:
| Escrito assim | Válido em JSON? | O motivo |
|---|---|---|
{"a": 1,} | não | vírgula sobrando no fim |
{'a': 1} | não | aspas simples |
{a: 1} | não | nome sem aspas |
// comentário | não | comentários não existem |
NaN, Infinity | não | não são números válidos |
007 | não | zero à esquerda |
0x1F | não | hexadecimal não existe |
.5 ou +1 | não | a fração precisa de dígito antes do ponto, e só o sinal de menos existe |
undefined | não | não é um valor JSON |
"linha 1 seguido de uma quebra de linha | não | quebras de linha num texto precisam ser \n |
Duas regras ficam menos visíveis. A especificação diz que os nomes de um objeto devem ser únicos, mas não obriga o leitor a rejeitar duplicatas, e cada biblioteca faz uma coisa: no JavaScript, vale o último; em outras, o primeiro, ou um erro. E a ordem dos campos de um objeto não tem significado: duas representações com os mesmos campos em ordens diferentes são o mesmo dado. Quem depende da ordem dos campos, por exemplo para comparar textos ou calcular uma assinatura, precisa de uma forma canônica, como a definida na RFC 8785.
I-JSON: o perfil que fecha as brechas
A RFC 8259 deixa várias decisões em aberto: nomes repetidos são desaconselhados, mas não proibidos; números podem ter qualquer tamanho; caracteres inválidos dentro de textos têm comportamento indefinido. Para quem projeta um protocolo, essa liberdade é um risco, porque cada biblioteca resolve as ambiguidades de um jeito. A RFC 7493, de março de 2015, escrita por Tim Bray, define o I-JSON (Internet JSON), um subconjunto mais rígido, pensado para mensagens entre sistemas. As regras principais:
- O texto deve estar em UTF-8, e nomes e textos não podem conter surrogates soltos nem "não caracteres" do Unicode, nem mesmo na forma de escape. Um
"\uDEAD"sozinho torna a mensagem inválida. - Objetos não podem ter nomes repetidos, comparados depois de resolver os escapes:
{"a": 1, "a": 2}também é repetição. - Números não devem ultrapassar a precisão do ponto flutuante de 64 bits, e quem envia não pode supor que inteiros fora da faixa de -(2^53)+1 a 2^53-1 serão tratados com exatidão. Quando a exatidão importa, a recomendação é enviá-los como texto.
- O documento de nível mais alto deve ser um objeto ou uma lista, por compatibilidade com leitores antigos, e quem lê deve ignorar os campos que não conhece, em vez de tratá-los como erro.
- Datas e horas vão como texto no perfil da RFC 3339, com letras maiúsculas (
TeZ), fuso explícito e os segundos sempre presentes, mesmo quando são zero. Durações seguem a mesma RFC. - Dados binários vão em base64url, a variante do Base64 que troca
+e/por-e_, seguros em endereços e nomes de arquivo.
Declarar que uma API usa I-JSON resolve num parágrafo boa parte das dúvidas que este artigo discute. Várias recomendações das seções seguintes, como identificadores grandes como texto e datas com fuso, são exatamente as regras desse perfil.
Textos, Unicode e escapes
Um texto JSON pode conter qualquer caractere Unicode, com três exceções que precisam de escape: as aspas duplas, a barra invertida e os caracteres de controle, do código 0 ao 31, que incluem a quebra de linha e a tabulação. Todo o resto pode ir direto, inclusive acentos, e é o que se recomenda: "ação" é mais legível e menor que "a\u00e7\u00e3o", e os dois representam exatamente o mesmo texto.
O escape \u aceita quatro dígitos hexadecimais, o que cobre os primeiros 65.536 códigos do Unicode. Caracteres além disso, como a maioria dos emojis, são escritos como um par substituto (surrogate pair), dois escapes seguidos: o rosto sorridente U+1F600 vira "\ud83d\ude00". É uma consequência da forma como o JavaScript e o Java representam textos internamente, em unidades de 16 bits. Um escape solitário dessa faixa, sem o par, é um texto malformado, e cada leitor reage de um jeito: uns trocam pelo caractere de substituição, outros rejeitam.
O problema também aparece na direção contrária. Um texto JavaScript pode conter um surrogate solto, por exemplo quando alguém corta um emoji ao meio com slice. Antes da edição de 2019 da linguagem, o JSON.stringify escrevia esse caractere literalmente, gerando uma saída que não podia ser convertida em UTF-8 válido. A edição de 2019 trouxe o JSON.stringify "bem formado": surrogates soltos passaram a sair como escape, JSON.stringify('\uD800') produz "\ud800", e a saída é sempre Unicode válido. A mensagem continua carregando um caractere quebrado, mas pelo menos chega inteira, e um leitor rigoroso pode recusá-la com uma mensagem clara.
Na troca entre sistemas, a RFC 8259 exige UTF-8 e proíbe que quem gera o texto inclua a marca de ordem de bytes (BOM, os três bytes EF BB BF) no começo. Na prática, um BOM vindo de um editor do Windows ou de um sistema antigo é a causa clássica do erro "caractere inesperado na posição 0" num arquivo que parece perfeito. Outra armadilha é a normalização: o "é" pode ser um caractere só ou a letra "e" seguida de um acento combinante. As duas formas aparecem iguais na tela, mas são textos diferentes numa comparação. Quem compara nomes ou códigos vindos de fontes diversas deve normalizar antes (no JavaScript, com texto.normalize('NFC')).
E há a diferença entre caracteres e bytes. Em UTF-8, cada letra acentuada ocupa dois bytes, e limites de banco de dados, de mensageria ou de API quase sempre são contados em bytes. É comum um texto "caber" na tela e não caber no destino. Ao cortar um texto para respeitar um limite em bytes, é preciso cuidado para não partir um caractere ao meio, o que deixaria UTF-8 inválido no fim.
Como um leitor de JSON funciona por dentro
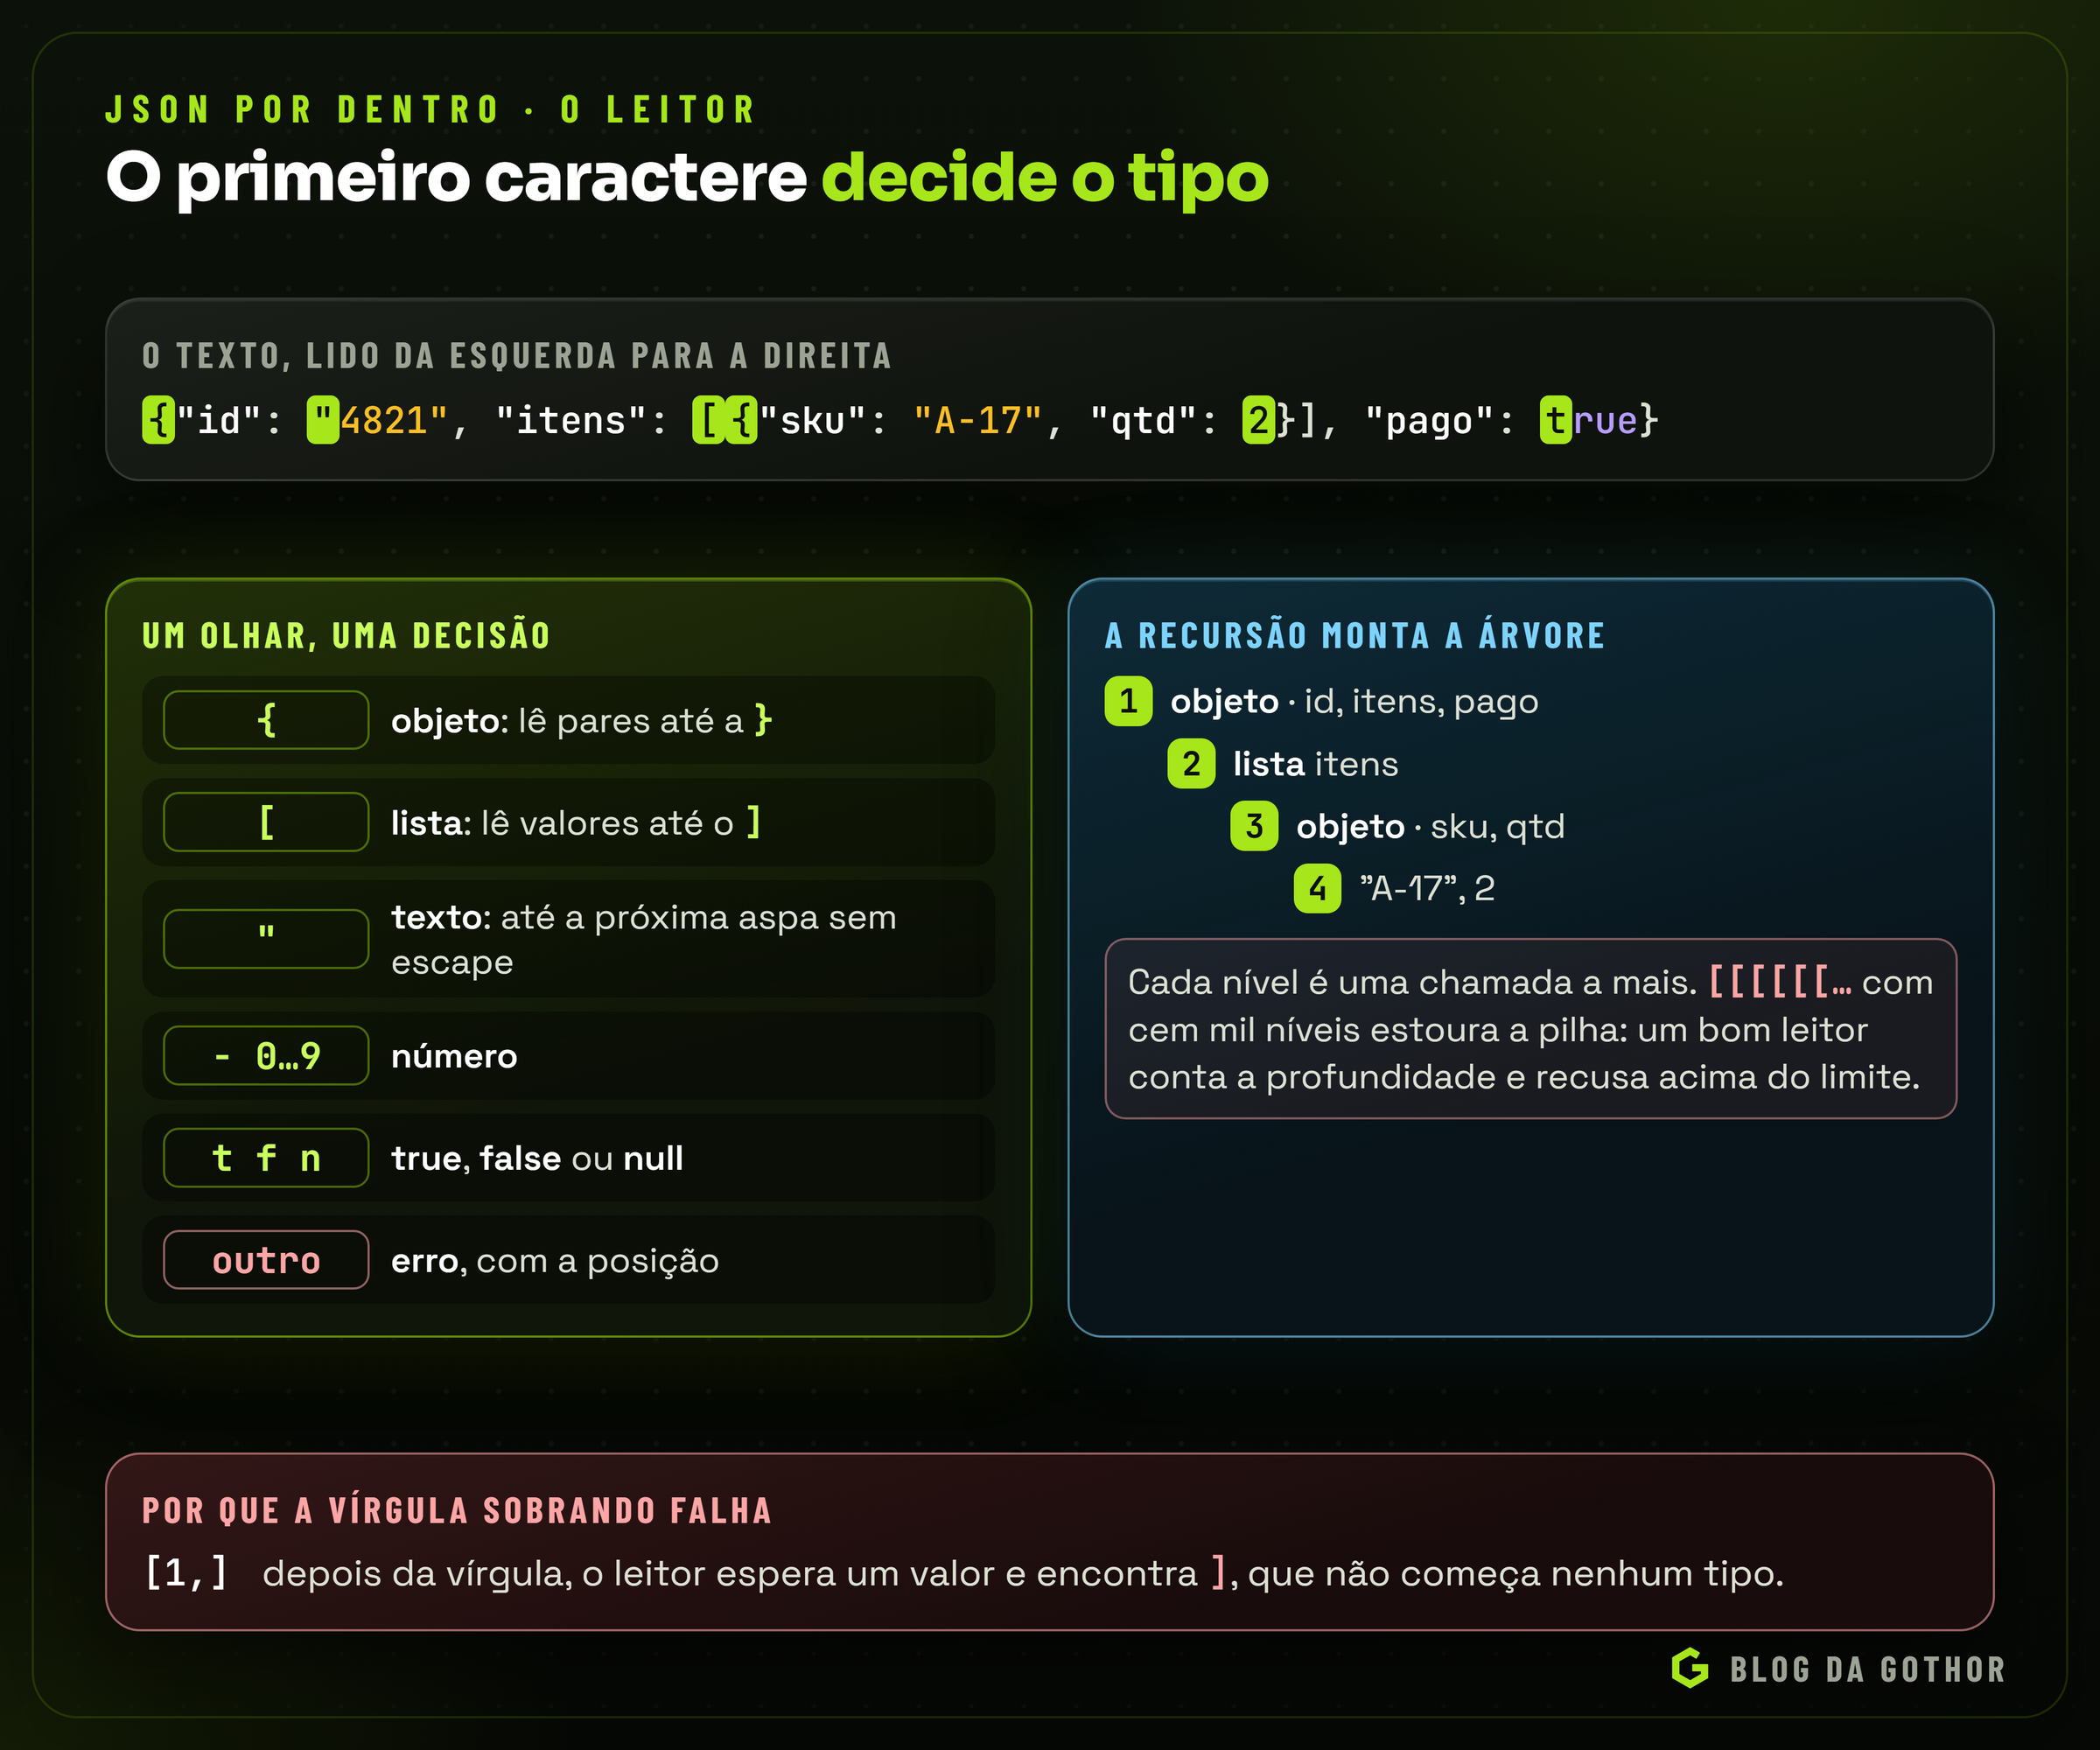
Ler JSON parece mágica até que se veja o algoritmo, e ele é surpreendentemente simples. A gramática foi desenhada de forma que o primeiro caractere de um valor sempre diz qual é o tipo: { abre um objeto, [ abre uma lista, " abre um texto, um dígito ou - começa um número, t e f começam os lógicos e n começa o nulo. Não há ambiguidade e não é preciso olhar adiante. Gramáticas assim podem ser lidas por um analisador descendente recursivo: uma função para cada tipo, que chama as outras quando encontra um valor aninhado.
O núcleo cabe em poucas linhas. O trecho abaixo é simplificado, mas é essencialmente o que os leitores fazem:
function lerValor(t) {                       // t = { texto, pos }
  pularEspacos(t);
  const c = t.texto[t.pos];
  if (c === '{') return lerObjeto(t);
  if (c === '[') return lerLista(t);
  if (c === '"') return lerTexto(t);
  if (c === '-' || (c >= '0' && c <= '9')) return lerNumero(t);
  if (t.texto.startsWith('true', t.pos)) { t.pos += 4; return true; }
  // ... false e null do mesmo jeito
  throw new SyntaxError(`caractere inesperado na posição ${t.pos}`);
}

function lerLista(t) {
  t.pos++;                                   // consome o [
  const lista = [];
  pularEspacos(t);
  if (t.texto[t.pos] === ']') { t.pos++; return lista; }
  for (;;) {
    lista.push(lerValor(t));                 // recursão: a lista pode conter listas
    pularEspacos(t);
    const c = t.texto[t.pos++];
    if (c === ']') return lista;
    if (c !== ',') throw new SyntaxError(`esperava , ou ] na posição ${t.pos - 1}`);
  }
}
Esse esboço já explica várias regras da tabela anterior. A vírgula sobrando em [1,] falha porque, depois da vírgula, lerValor encontra ], que não começa nenhum tipo. Um comentário falha porque / também não começa nenhum tipo. E as mensagens de erro com posição, comuns em todas as bibliotecas, vêm do contador que o leitor carrega.
O esboço também revela o ponto fraco desse desenho: cada nível de aninhamento é uma chamada de função a mais. Um documento malicioso com cem mil colchetes abertos faz um leitor ingênuo estourar a pilha e derrubar o processo. Leitores sérios contam a profundidade e recusam documentos acima de um limite, muito além de qualquer dado legítimo.
Desempenho: quando ler JSON deixa de ser barato
Os leitores de produção percorrem bytes em vez de caracteres, evitam cópias de textos sem escapes e convertem números com algoritmos especializados. O projeto simdjson, publicado em 2019 por Geoff Langdale e Daniel Lemire, levou isso ao extremo: usa instruções do processador que tratam dezenas de bytes de uma vez e lê gigabytes de JSON por segundo num único núcleo.
O custo que costuma pesar não é o da leitura em si, e sim o do que vem junto. Montar milhões de objetos pequenos pressiona o coletor de lixo, e no Node.js um JSON.parse de centenas de megabytes bloqueia o processo inteiro enquanto roda: nenhuma outra requisição é atendida nesse tempo. A seção "Quando o JSON fica grande", mais adiante, mostra as saídas.
Números: o detalhe que mais causa estrago
A especificação do JSON não limita o tamanho nem a precisão dos números: ela só define como escrevê-los. Quem impõe limites é a linguagem que lê. E a maioria das linguagens, a começar pelo JavaScript, lê números JSON como ponto flutuante de 64 bits (IEEE 754), que representa inteiros com exatidão só até 2^53, ou 9.007.199.254.740.991.
Acima disso, os números mudam sem aviso:
JSON.parse('9007199254740993');                 // 9007199254740992
JSON.parse('{"id": 1234567890123456789}').id;   // 1234567890123456800
Isso já quebrou muitas integrações com identificadores grandes, gerados por bancos de dados ou por serviços de mensagens. A solução usual é enviar identificadores grandes como texto: "id": "1234567890123456789". O perfil I-JSON sugere exatamente isso para qualquer número fora da faixa segura.
Valores em dinheiro pedem um cuidado parecido. Um 159.9 vira ponto flutuante na leitura, e somas acumulam erros de arredondamento, como o famoso 0.1 + 0.2 que não dá 0.3. Os caminhos seguros são enviar centavos em número inteiro ("total_centavos": 15990) ou o valor decimal como texto ("total": "159.90"), convertido para um tipo decimal exato do lado de quem recebe. O que não pode acontecer é cada sistema da integração escolher um caminho diferente.
Números grandes sem perder dígitos: o texto-fonte do JSON.parse
Às vezes não dá para mudar o contrato: a API de um parceiro envia identificadores de 19 dígitos como número, e pronto. Até pouco tempo, o JavaScript não tinha saída limpa para isso, porque quando o reviver do JSON.parse era chamado o número já tinha sido convertido e arredondado. A proposta JSON.parse source text access, do TC39, entrou na edição de 2026 da linguagem e resolveu as duas pontas.
Na leitura, o reviver passou a receber um terceiro argumento, com o texto original do valor em source. Com ele, dá para reconstruir o número sem perda, por exemplo como BigInt. Na escrita, o JSON.rawJSON cria um valor que o JSON.stringify copia para a saída exatamente como está:
const lerIds = (chave, valor, { source }) =>
  chave === 'id' && /^-?\d+$/.test(source) ? BigInt(source) : valor;

const pedido = JSON.parse('{"id": 1234567890123456789, "total": 159.9}', lerIds);
pedido.id;                       // 1234567890123456789n, sem arredondamento

const escreverIds = (chave, valor) =>
  typeof valor === 'bigint' ? JSON.rawJSON(valor.toString()) : valor;

JSON.stringify(pedido, escreverIds); // '{"id":1234567890123456789,"total":159.9}'
O JSON.rawJSON aceita só texto JSON de um valor simples (número, texto, lógico ou nulo) e lança SyntaxError se receber um objeto ou uma lista, para que ninguém o use como atalho para injetar estruturas inteiras na saída. A MDN marca o recurso como disponível nos navegadores atuais desde março de 2025. Ele não dispensa a recomendação de enviar identificadores grandes como texto, que continua valendo para todas as outras linguagens da integração; ele apenas dá ao JavaScript uma forma correta de lidar com quem não segue essa recomendação.
Cada linguagem lê de um jeito
O mesmo número pode chegar intacto a um sistema e alterado a outro, porque cada linguagem tem a sua regra:
| Onde | Como um número do JSON é lido | O cuidado |
|---|---|---|
| JavaScript e TypeScript | sempre number, ponto flutuante de 64 bits | inteiros acima de 2^53 perdem dígitos; um BigInt nem chega a ser serializado |
| Python | inteiros como int de precisão ilimitada; frações como float | o json.dumps escreve NaN e Infinity por padrão, gerando texto que os outros leitores rejeitam |
| Go | float64, quando o destino é genérico | o Decoder.UseNumber() preserva o número como texto |
| Java, com Jackson | int, long ou BigInteger, conforme o tamanho | uma opção lê frações como BigDecimal, exato |
| Dart | inteiros como int de 64 bits nos apps nativos | no Flutter para a web, valem as regras do JavaScript |
PostgreSQL, em jsonb | numeric, exato | o problema reaparece quando a aplicação lê o valor |
O caso do Python inverte a direção do problema: o leitor é generoso, mas o escritor pode produzir JSON inválido sem aviso. Um relatório com a média de uma lista vazia (NaN) quebra o painel em JavaScript que tenta lê-lo. Passar allow_nan=False transforma o caso em erro na origem, onde é fácil de achar.
A lição geral é que o tipo de um número no contrato precisa dizer mais do que "número": inteiro ou com fração, a faixa possível, a unidade (centavos ou reais, gramas ou quilos) e quantas casas decimais. Isso evita a pior categoria de erro, a que não dá erro: um valor que chega diferente e segue adiante como se estivesse certo.
Datas: o tipo que o JSON não tem
Não existe tipo de data no JSON. Datas viajam como texto, e a forma que funciona é o padrão ISO 8601, no perfil da RFC 3339, sempre com o fuso:
{
  "criado_em": "2026-10-25T09:00:00-04:00",
  "vencimento": "2026-11-10",
  "atualizado_em": "2026-10-25T13:00:00Z"
}
Algumas regras evitam a maior parte dos problemas. Um instante no tempo (quando um pedido foi criado) leva o fuso ou o Z de UTC; sem ele, cada sistema vai supor o próprio fuso, e o mesmo pedido aparece com horários diferentes em cada tela. Uma data de calendário (o vencimento de um boleto) vai só com o dia, AAAA-MM-DD, sem hora: transformá-la em meia-noite de algum fuso é o caminho mais curto para um vencimento que "volta um dia". E formatos locais, como 25/10/2026, ficam para a tela, nunca para a troca de dados.
Deslocamento não é fuso, e ordem de texto não é ordem de tempo
O -04:00 no fim de uma data é um deslocamento: diz quantas horas aquele instante está atrás de UTC. Um fuso horário, como America/Cuiaba, é um conjunto de regras que diz qual deslocamento vale em cada época, inclusive horários de verão que um governo pode criar ou extinguir. Para registrar algo que já aconteceu, o deslocamento basta. Para agendar algo futuro e recorrente, como "todo dia útil às 6h no horário de Cuiabá", o certo é guardar a hora local e o nome do fuso, e calcular o instante perto da hora.
Uma vantagem pouco lembrada do formato AAAA-MM-DD é que ele ordena como texto: comparar "2026-10-16" < "2026-11-16" como texto dá o mesmo resultado que comparar as datas. Com instantes completos, isso só vale quando todos estão no mesmo deslocamento: "2026-10-25T09:00:00-04:00" e "2026-10-25T12:30:00Z" ficam fora de ordem numa comparação de texto, porque o primeiro é, na verdade, 13h em UTC. Por isso a prática mais segura entre sistemas é enviar instantes em UTC, sempre com a mesma precisão, e converter para o horário local só na tela.
Ida e volta: serializar e ler
Converter um objeto da memória em texto JSON é serializar; o caminho inverso é ler (parse). No JavaScript, as duas operações são JSON.stringify e JSON.parse, e o que não aparece no diagrama a seguir costuma surpreender.
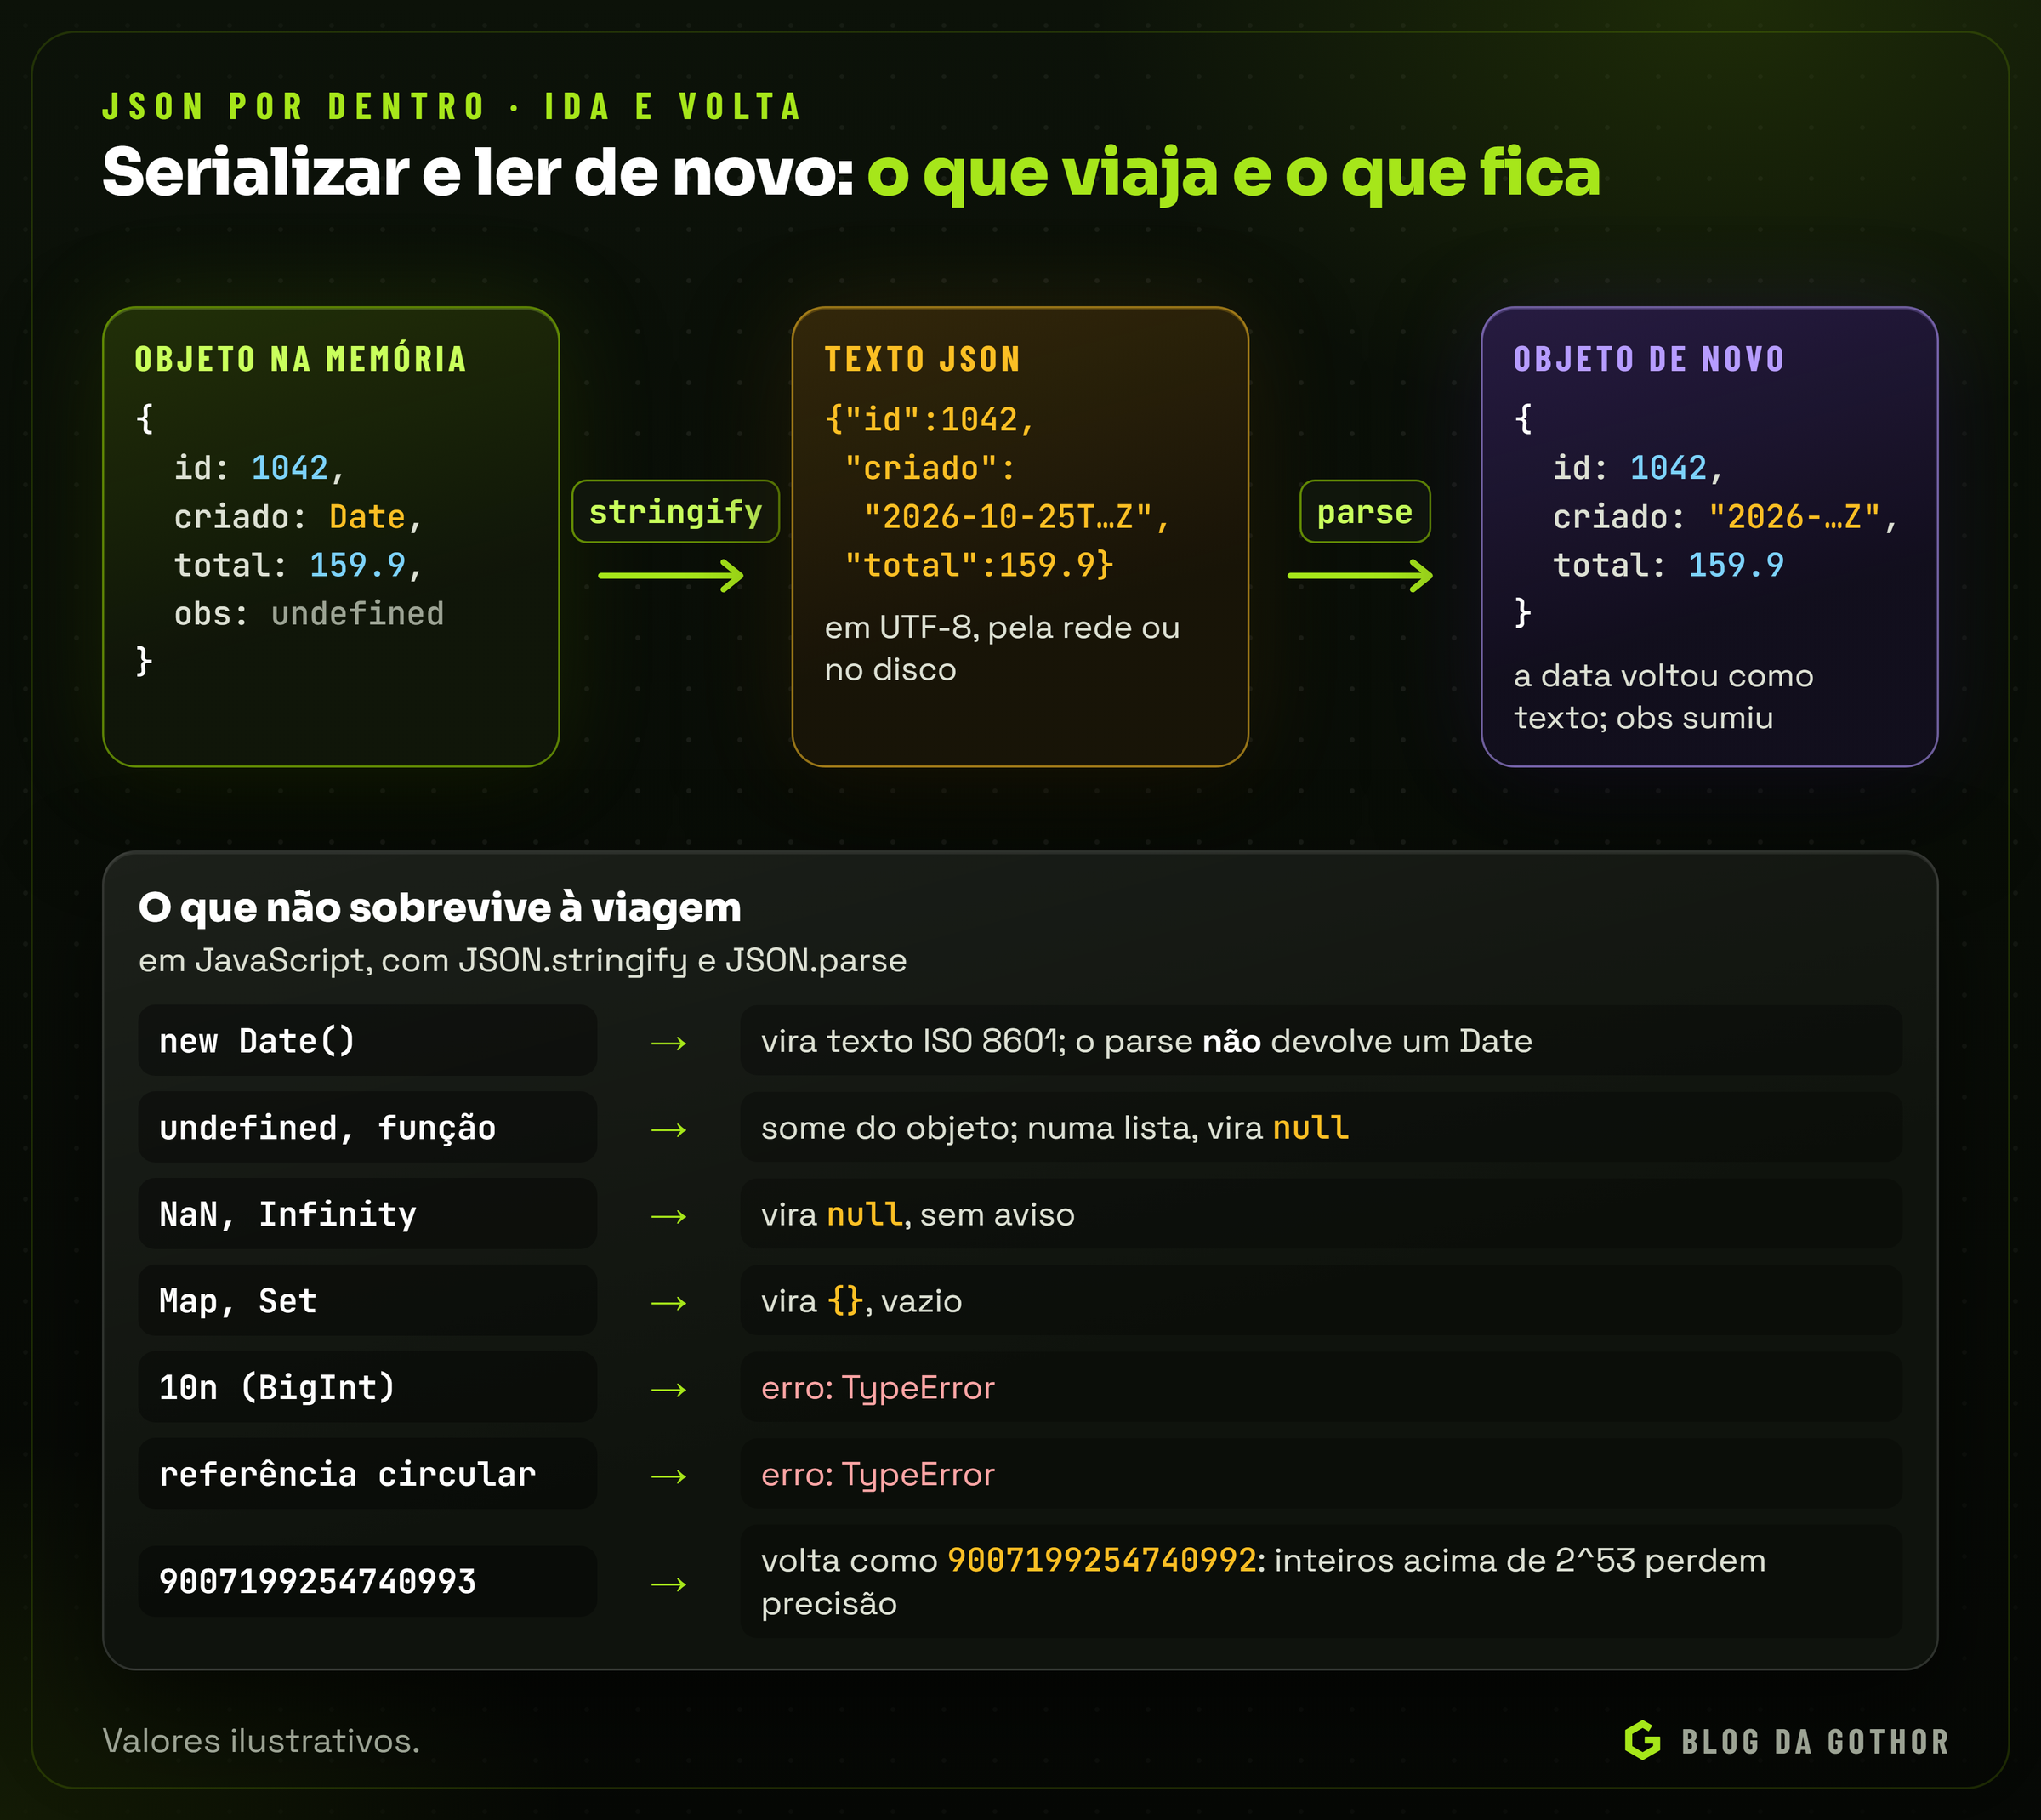
O JSON só conhece os seis tipos. Tudo o que não é um deles é convertido, descartado ou rejeitado na serialização:
- Um
Datevira texto ISO pelo seu métodotoJSON, mas oJSON.parsedevolve texto, e não umDate. undefined, funções e símbolos somem dos objetos; numa lista, viramnull.NaNeInfinityviramnull, sem aviso.MapeSetviram{}, vazios.BigInte referências circulares geram erro.
Os dois métodos aceitam ajudantes. O JSON.stringify recebe um replacer, que filtra ou transforma valores, e um espaçamento para formatar a saída; o JSON.parse recebe um reviver, que pode, por exemplo, transformar de volta em Date os campos que terminam em _em:
const texto = JSON.stringify(pedido, null, 2);   // formatado, com 2 espaços

const lido = JSON.parse(texto, (chave, valor) =>
  chave.endsWith('_em') && typeof valor === 'string' ? new Date(valor) : valor,
);
O replacer tem um uso que vai além da formatação: tirar dados sensíveis antes de gravar ou registrar. Uma função que troca o valor de qualquer campo chamado senha ou token por um marcador, aplicada a toda mensagem antes de ir para um log, protege contra o descuido mais comum de todos, o de registrar o corpo inteiro de uma requisição. Do outro lado, qualquer classe pode decidir como vira JSON definindo um método toJSON, como o Date faz: um valor monetário pode se serializar como "159.90", e uma entidade, só com os campos públicos.
Um uso comum, e arriscado, é copiar objetos com JSON.parse(JSON.stringify(obj)). Funciona para dados simples, mas perde datas, undefined, Map e tudo o que não é JSON. Para copiar objetos de verdade, o JavaScript tem o structuredClone.
Em outras linguagens a ideia é a mesma, com o mapeamento de tipos de cada uma: o json do Python, o System.Text.Json do C#, o encoding/json do Go, o serde_json do Rust, o jsonDecode do Dart. O ponto a lembrar é que o texto JSON é o contrato, e cada lado converte esse contrato para os seus próprios tipos.
JSON como módulo: importar com atributos
Arquivos de configuração e tabelas pequenas, como a lista de unidades da federação, costumam ser lidos com fs.readFile seguido de JSON.parse, ou baixados com fetch. Desde a edição de 2025, o JavaScript também importa JSON como módulo, com uma sintaxe que deixa explícito o que se espera receber:
import ufs from './ufs.json' with { type: 'json' };

const config = await import('./config.json', { with: { type: 'json' } });
config.default.tema;   // o conteúdo vem na exportação padrão
O with { type: 'json' } são os atributos de importação, e a razão de existirem é de segurança. No navegador, um módulo é interpretado conforme o tipo de mídia que o servidor informa, e não pela extensão do endereço. Sem o atributo, um servidor comprometido poderia responder ao pedido do "JSON" com text/javascript e código malicioso, que seria executado. Com o atributo, a importação confere o tipo e falha se a resposta não for JSON: os dados nunca viram código.
Dois detalhes práticos. Um módulo JSON tem só a exportação padrão, então import { nome } from './dados.json' não funciona. E módulos ficam em cache durante toda a vida da página ou do processo: para dados que mudam, como uma configuração que pode ser editada, fetch ou a leitura do arquivo continuam sendo o caminho certo. Uma versão anterior da proposta usava a palavra assert no lugar de with, forma que deixou de ser padrão e ainda aparece em código antigo.
Dados binários dentro do JSON
O JSON não tem tipo para bytes. Quando um arquivo pequeno, como uma foto de perfil, precisa viajar dentro de um documento, ele vai como texto em Base64, que representa cada três bytes com quatro caracteres: cerca de 33% a mais de tamanho. Para alguns quilobytes, isso não importa. Para arquivos grandes, o melhor caminho é enviar o arquivo separado, numa requisição própria ou num envio multipart/form-data, e deixar no JSON só a referência. Uma variação comum é a data URL, como "data:image/png;base64,iVBORw0...", que já diz o tipo do conteúdo e pode ser usada diretamente numa tag de imagem.
Validar o que chega: JSON Schema e Zod
JSON.parse responde a uma pergunta só: o texto é JSON válido? Ele não sabe se o campo cliente existe, se a quantidade é positiva ou se o e-mail tem formato de e-mail. Numa API, essa segunda verificação é obrigatória, porque o corpo de uma requisição pode ter sido escrito por qualquer pessoa.
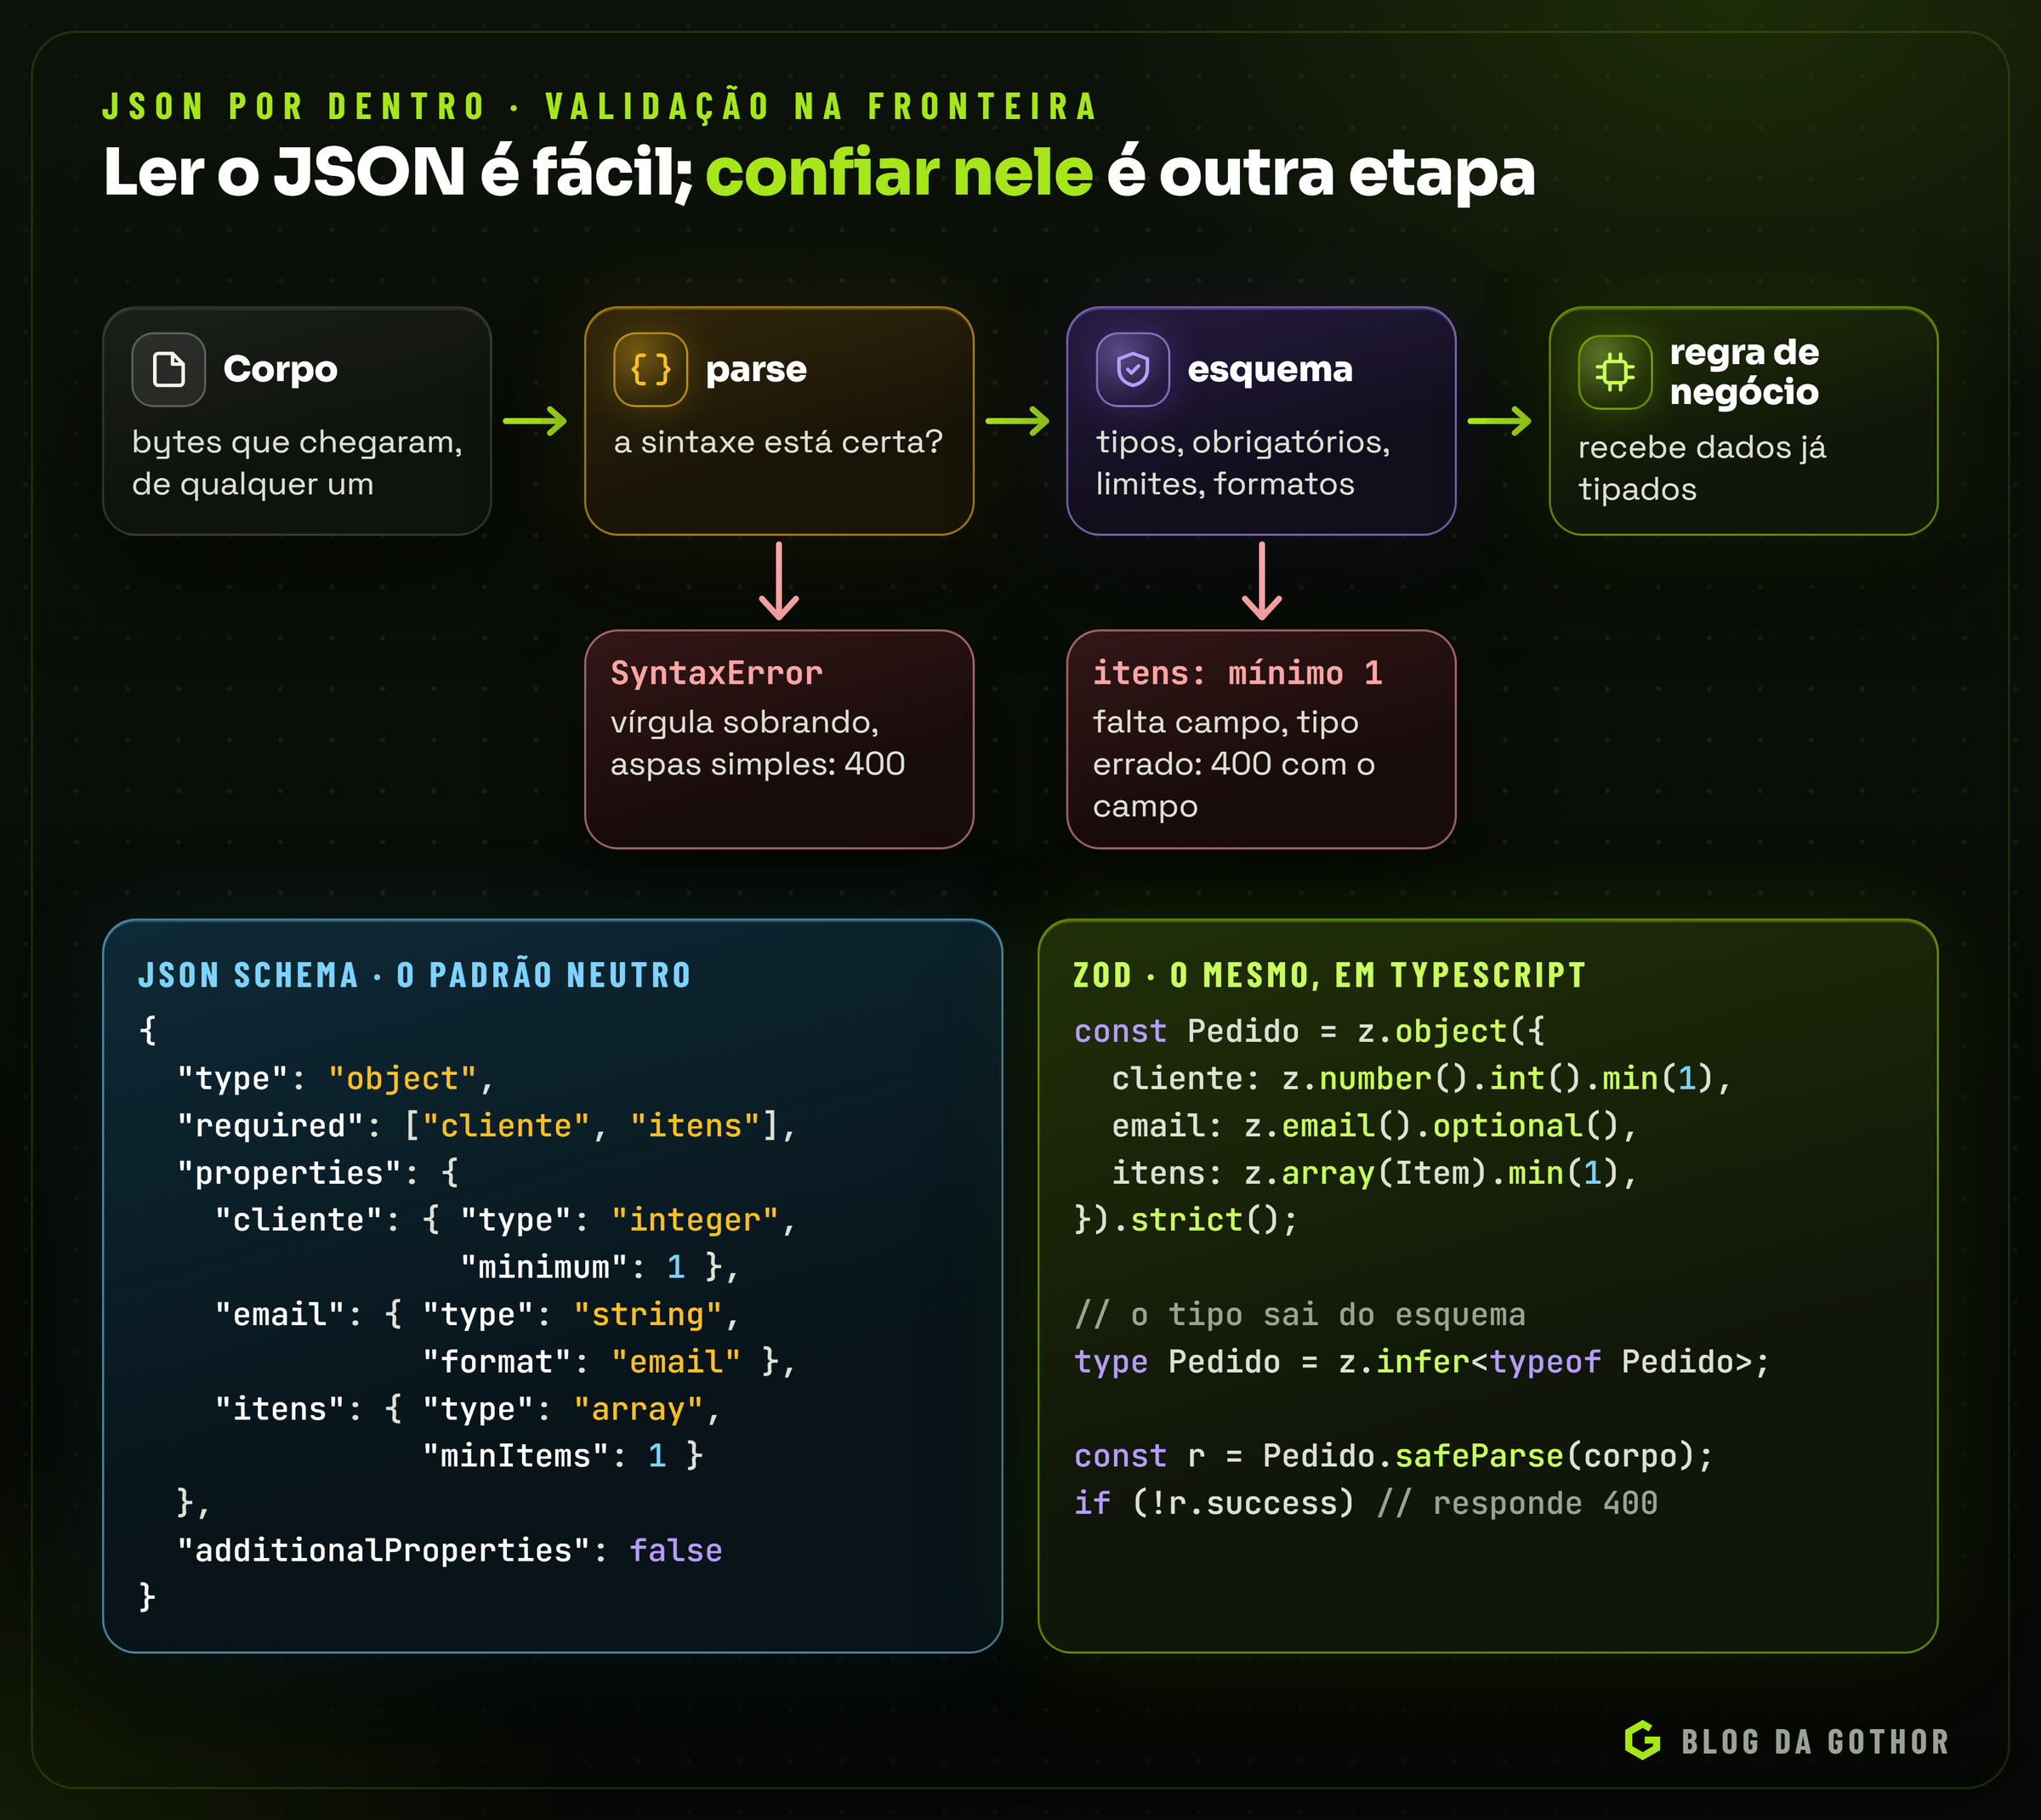
O JSON Schema é o padrão para descrever a forma de um documento JSON, escrito ele mesmo em JSON. Um esquema diz o tipo de cada campo, quais são obrigatórios, os limites de números e textos, os formatos (e-mail, data, URI) e se campos não previstos são aceitos. A versão atual é a 2020-12, e o OpenAPI 3.1, padrão para documentar APIs HTTP, usa exatamente esse vocabulário para descrever corpos de requisição e de resposta. Por ser neutro, o mesmo esquema serve para validar no servidor, gerar documentação e gerar código em várias linguagens.
Algumas palavras-chave resolvem a maior parte dos casos:
| Palavra-chave | O que diz | Exemplo |
|---|---|---|
type, required, properties | o tipo, os campos obrigatórios e o esquema de cada campo | "required": ["cliente", "itens"] |
additionalProperties | o que fazer com campos não previstos | false rejeita qualquer campo a mais |
minimum, maximum, multipleOf | limites numéricos | "multipleOf": 0.01 para duas casas |
minLength, maxLength, pattern | limites e formato de textos | "pattern": "^[0-9]{14}$" para um CNPJ só com dígitos |
enum, const | uma lista fechada de valores, ou um valor só | "enum": ["aberto", "faturado", "cancelado"] |
oneOf, anyOf, allOf | combinações de esquemas | um pagamento que é Pix ou boleto |
$ref, $defs | reaproveitar um esquema definido em outro ponto | "$ref": "#/$defs/endereco" |
Um detalhe costuma enganar quem começa: na versão 2020-12, a palavra format é, por padrão, apenas uma anotação. Um validador conforme pode ignorar "format": "email" e aceitar qualquer texto, a menos que seja configurado para conferir formatos; em bibliotecas populares, como o Ajv, isso exige um complemento próprio.
Versões, dialetos e composição de esquemas
O JSON Schema evoluiu em versões chamadas de drafts: draft-04, draft-06, draft-07, depois 2019-09 e a atual, 2020-12. Muitos esquemas que circulam pela internet ainda são draft-04 ou draft-07, e as diferenças importam. Por isso todo esquema deveria declarar a sua versão na palavra-chave $schema, para que o validador saiba quais regras aplicar:
{
  "$schema": "https://json-schema.org/draft/2020-12/schema",
  "$id": "https://exemplo.com.br/esquemas/pedido.json",
  "type": "object",
  "required": ["cliente", "itens"],
  "properties": {
    "cliente": { "type": "string" },
    "itens": { "type": "array", "minItems": 1, "items": { "$ref": "#/$defs/item" } }
  },
  "$defs": {
    "item": {
      "type": "object",
      "required": ["sku", "qtd"],
      "properties": { "sku": { "type": "string" }, "qtd": { "type": "integer", "minimum": 1 } }
    }
  }
}
A versão 2019-09 trouxe as mudanças mais visíveis: definitions foi renomeada para $defs; a antiga dependencies foi dividida em dependentRequired (se o campo A existe, o B também precisa existir) e dependentSchemas; e as palavras-chave foram organizadas em vocabulários, conjuntos que um validador declara suportar. A 2020-12 trocou a forma de descrever tuplas, com prefixItems para as posições fixas e items para o resto da lista, e separou o format em dois vocabulários, um que só anota e outro que exige.
A novidade mais útil para quem compõe esquemas é a unevaluatedProperties, de 2019-09. Ela resolve um problema clássico: o additionalProperties: false só enxerga as propriedades declaradas no mesmo subesquema. Se um esquema de "endereço" fechado com additionalProperties: false for combinado por allOf com outro que acrescenta o campo tipo, todo documento com tipo falha, porque para o primeiro esquema esse campo é "a mais". A unevaluatedProperties: false, posta no esquema de fora, enxerga tudo o que foi validado pelos subesquemas e rejeita só o que nenhum deles declarou:
{
  "allOf": [{ "$ref": "#/$defs/endereco" }],
  "properties": { "tipo": { "enum": ["residencial", "comercial"] } },
  "unevaluatedProperties": false
}
Para regras condicionais, as palavras-chave if, then e else dizem, por exemplo, que um pagamento com "forma": "boleto" exige vencimento, enquanto um com "forma": "pix" exige chave. Com essas peças, um esquema descreve quase todo contrato real; o que sobra, como "o vencimento não pode ser anterior à emissão", fica para o código.
Zod: o esquema que vira tipo
Em projetos TypeScript, bibliotecas como o Zod fazem o mesmo trabalho com uma vantagem: o tipo estático sai do próprio esquema. Escreve-se a regra uma vez, e o compilador passa a conhecer o formato dos dados validados:
import { z } from 'zod';

const Item = z.object({
  sku: z.string().min(1),
  qtd: z.number().int().positive(),
});

const Pedido = z.object({
  cliente: z.number().int().min(1),
  itens: z.array(Item).min(1),
  entrega: z.iso.date().optional(),
});

type Pedido = z.infer<typeof Pedido>;    // o tipo vem do esquema

const resultado = Pedido.safeParse(corpo);
if (!resultado.success) {
  // responder 400 com resultado.error.issues: o campo e o motivo
}
Três comportamentos do Zod merecem atenção. Por padrão, um z.object descarta os campos que não conhece, o que impede que um campo inesperado, como "nivel": 3, chegue a uma gravação no banco; há variantes que os recusam ou que os mantêm. As mensagens de erro podem ser escritas em português no próprio esquema, o que permite responder "Informe um e-mail válido." em vez de um código técnico. E o z.coerce converte valores antes de validar: útil para o que chega sempre como texto, como variáveis de ambiente, e perigoso no corpo JSON, onde um número enviado como texto deveria ser recusado, e não adivinhado. E o Zod gera JSON Schema a partir dos próprios esquemas.
A regra que vale para qualquer ferramenta: valide na fronteira. Tudo o que entra no sistema, seja o corpo de uma requisição, uma mensagem de fila, um arquivo importado ou a resposta de uma API de terceiros, passa por um esquema antes de chegar à regra de negócio. Depois da fronteira, o código trabalha com dados confiáveis e tipados; antes dela, nada é confiável. E o tipo do TypeScript, sozinho, não valida nada: ele existe só na compilação, e o que chega pela rede pode ser qualquer coisa.
Desenhando o JSON de uma API
A sintaxe é fixa, mas a forma dos documentos é decisão de quem projeta a API, e essas decisões duram anos, porque cada cliente que se integra passa a depender delas.
Nomes que se explicam. situacao, emitido_em e total_centavos dispensam documentação; st, dt e vl exigem uma tabela ao lado. Economizar caracteres nos nomes raramente compensa: a compressão da resposta elimina quase todo o custo da repetição.
Estados como texto, num campo só. "situacao": "faturado" se lê sozinho num log; "situacao": 3 obriga a procurar o significado. E um estado único é melhor que vários lógicos combinados: "cancelado": true, "faturado": true permite uma combinação impossível que alguém, um dia, vai gravar.
Identificadores como texto. Mesmo quando o banco usa números, enviar o id como texto protege contra o limite de 2^53 e permite trocar o formato no futuro, por um UUID, por exemplo, sem mudar o tipo do campo.
Objetos no topo, também nas listas. Uma resposta [...] não tem onde acrescentar o cursor da próxima página ou um aviso. Um envelope pequeno resolve:
{
  "dados": [
    { "id": "4821", "situacao": "aberto", "total": "159.90", "emitido_em": "2026-10-25T13:00:00Z" }
  ],
  "proximo": "eyJpZCI6IjQ4MjEifQ"
}
O cursor proximo é opaco para o cliente, que só o devolve na chamada seguinte. Por dentro, é comum que seja o próprio JSON da posição atual, {"id":"4821"}, em Base64; o prefixo eyJ denuncia isso, porque é a codificação de {". A paginação por cursor não pula nem repete registros quando alguém insere um pedido no meio da listagem, como acontece com a paginação por número de página.
Erros num formato só. A RFC 9457, Problem Details, define um formato pronto, com o tipo de mídia application/problem+json, e permite campos extras para os detalhes de cada caso:
{
  "type": "https://api.exemplo.com.br/problemas/estoque-insuficiente",
  "title": "Estoque insuficiente",
  "status": 422,
  "detail": "O item A-17 tem 1 unidade em estoque e o pedido pede 2.",
  "instance": "/pedidos/4821"
}
Ausente, nulo e vazio, cada um com o seu sentido. Um campo ausente costuma significar que o dado não se aplica ou não foi pedido; null, que se sabe que não há valor; [], que a lista existe e está vazia. Listas, em particular, nunca deveriam vir como null: um cliente que faz um laço sobre itens funciona com [] e quebra com null.
Contratos que evoluem: compatibilidade e versões
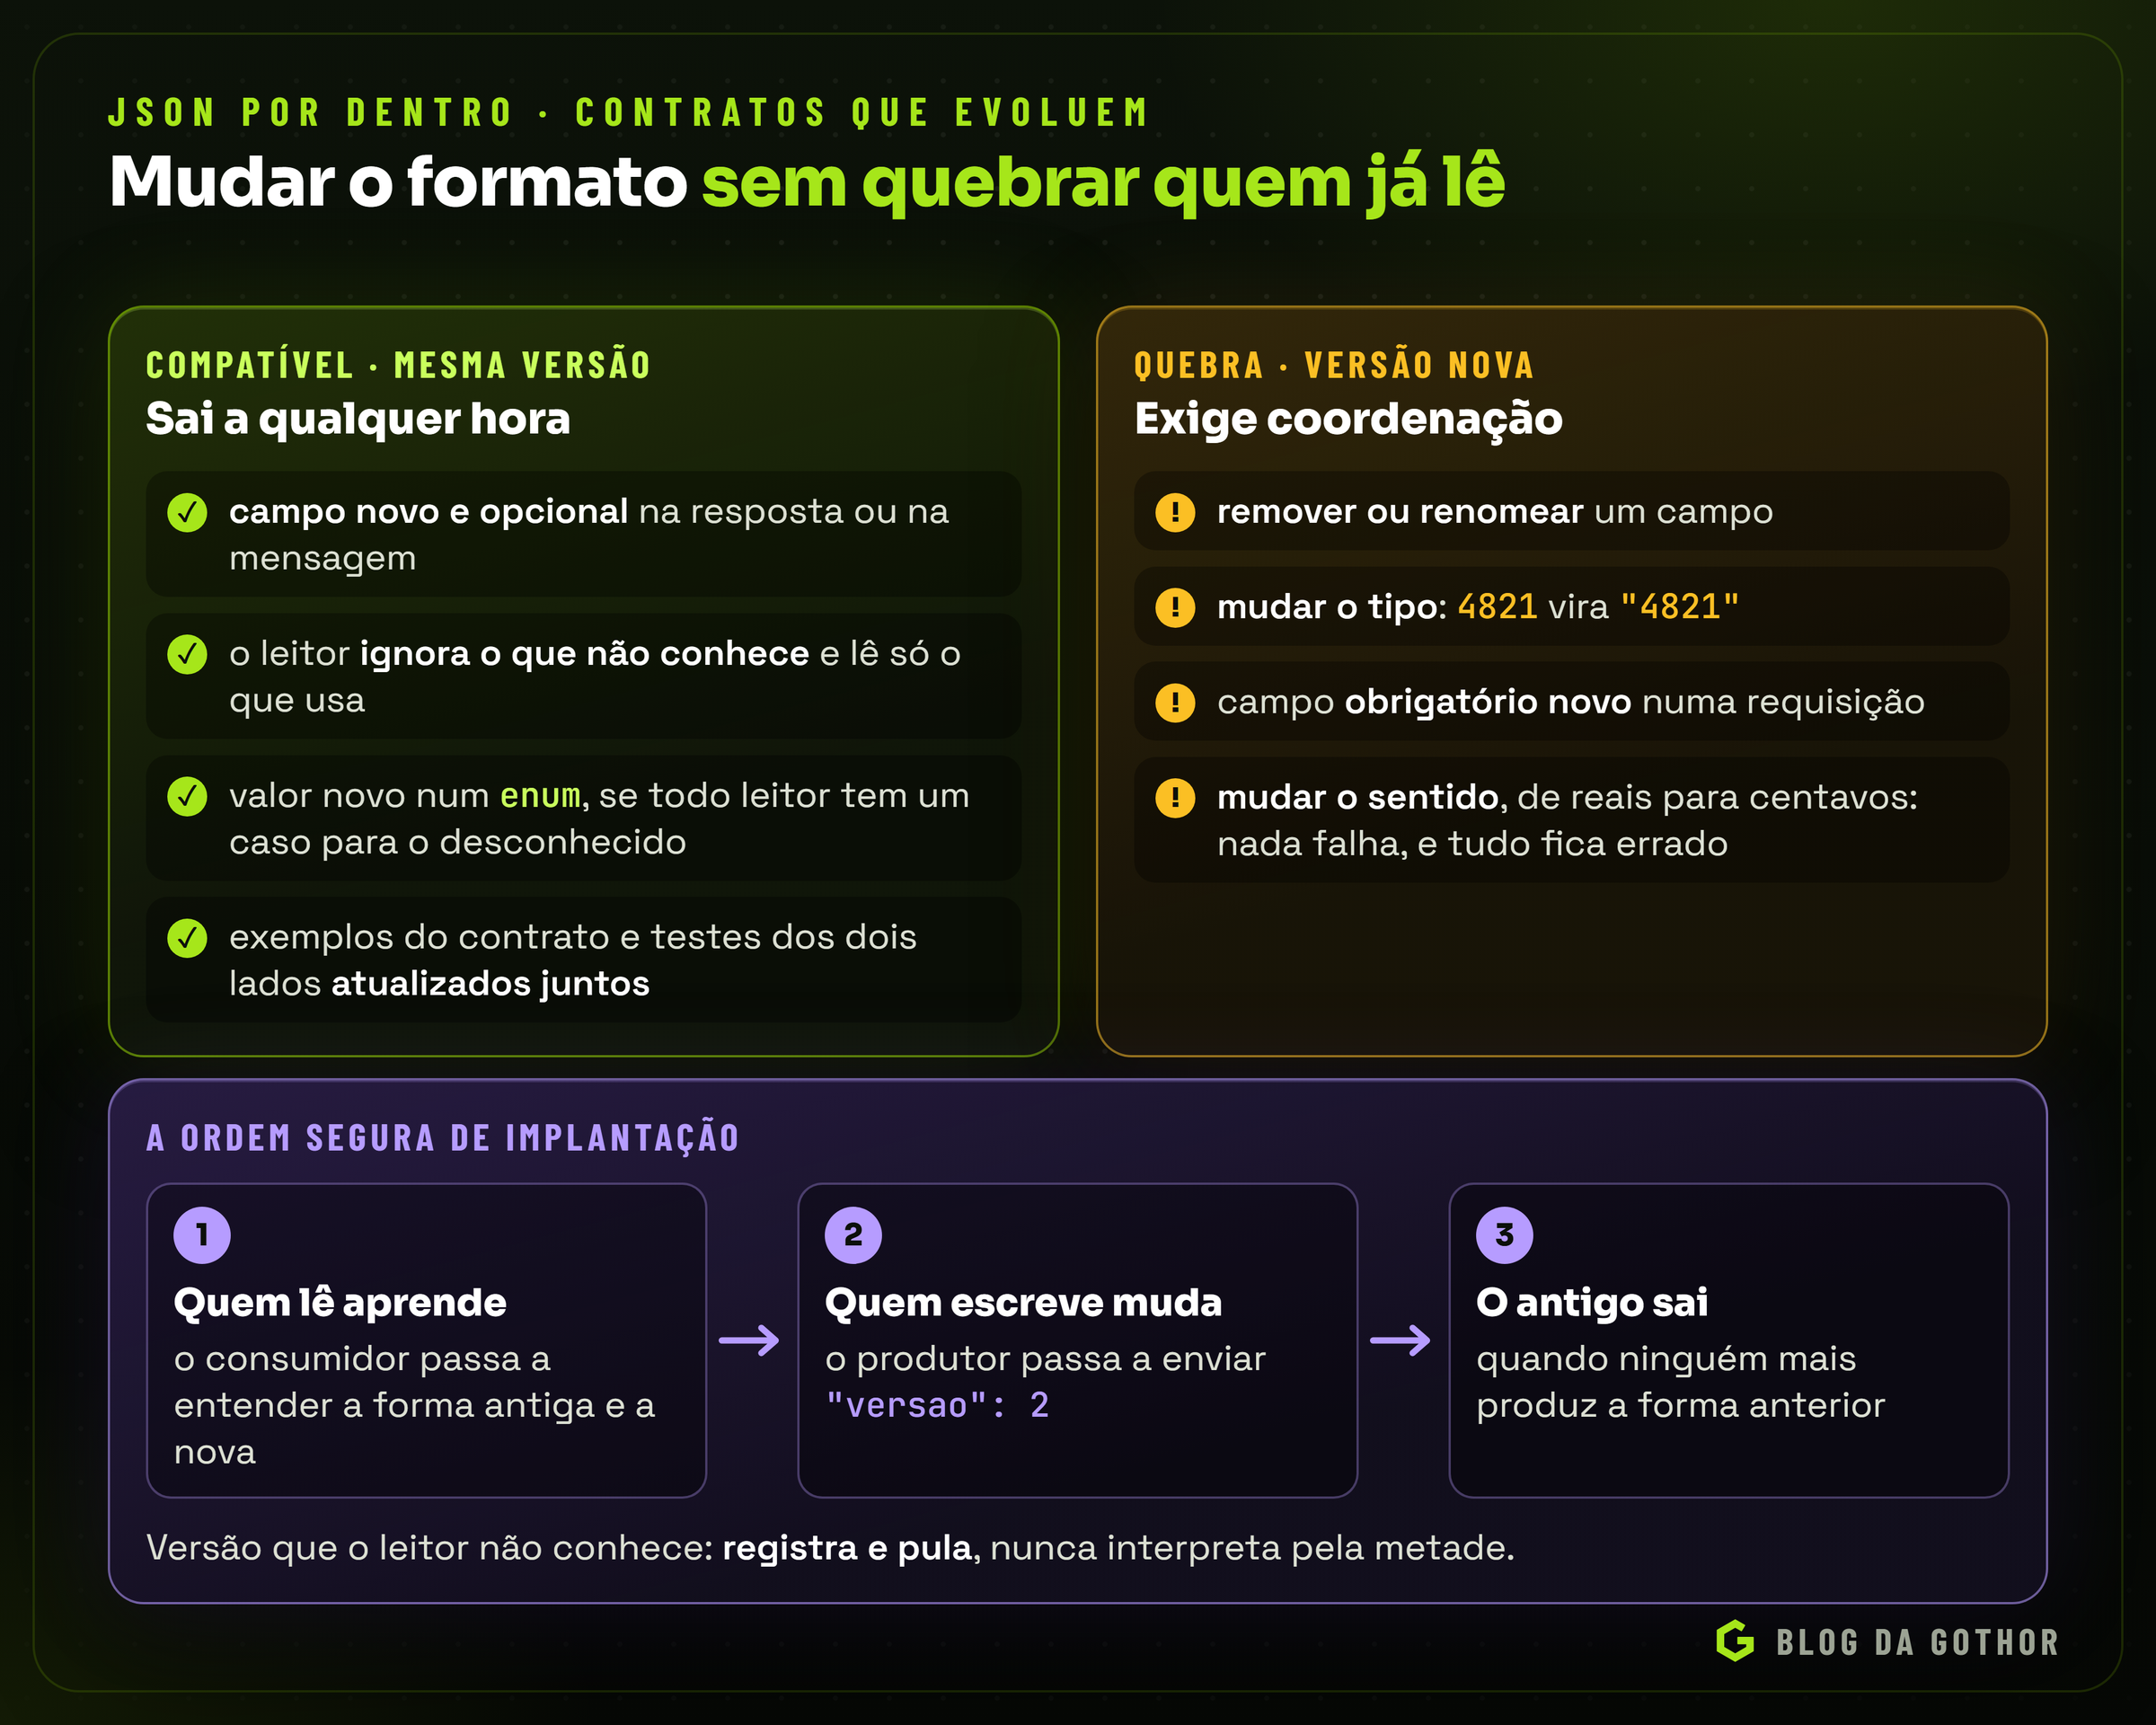
Nenhum formato fica parado. A pergunta que importa a cada mudança é simples: quem lê o formato antigo continua funcionando? Se sim, a mudança é compatível e pode sair a qualquer momento. Se não, ela exige coordenação.
| Mudança | Quebra quem lê? | Por quê |
|---|---|---|
| acrescentar um campo opcional | não, se o leitor ignora o que não conhece | é o caso mais comum, e o mais barato |
| acrescentar um campo obrigatório numa requisição | sim | os clientes antigos não o enviam |
| remover ou renomear um campo | sim | quem lia o campo passa a receber nada |
| mudar o tipo, de número para texto | sim | o leitor tipado recusa, ou converte errado |
acrescentar um valor a um enum | depende | quebra quem trata a lista como fechada |
passar a enviar null onde nunca vinha | sim, para quem não espera | o clássico "não é possível ler a propriedade de null" |
| mudar o sentido sem mudar a forma, de reais para centavos | sim, e em silêncio | o pior caso: nada falha, e os valores ficam cem vezes maiores |
A primeira linha só funciona com uma disciplina do lado de quem lê, conhecida como leitor tolerante: ignorar os campos desconhecidos em vez de recusar a mensagem, e ler só os campos de que precisa. A tolerância vale para campos a mais, e não para dados inválidos nos campos que o leitor usa.
Para as mudanças que quebram, há três ferramentas. Em APIs HTTP, uma versão no caminho, como /v2/pedidos, mantém as duas formas no ar enquanto os clientes migram. Em mensagens e arquivos, um campo de versão no próprio documento diz ao leitor qual regra aplicar; um leitor que encontra uma versão que não conhece deve pular a mensagem e registrar o fato, nunca interpretá-la pela metade. E a ordem de implantação importa: primeiro se atualiza quem lê, para que entenda as duas formas; depois quem escreve passa a produzir a nova; por fim, quando ninguém mais produz a antiga, o suporte a ela é retirado.
A forma mais confiável de não quebrar um contrato sem perceber é tratá-lo como código testado: manter exemplos reais do contrato num lugar só e fazer os testes dos dois lados lerem esses mesmos exemplos. Se alguém mudar o formato de um lado e esquecer o outro, um teste falha antes da implantação, e não depois.
JSON, XML e YAML
O JSON não é o único formato de texto para dados estruturados, e conhecer os vizinhos ajuda a escolher bem.
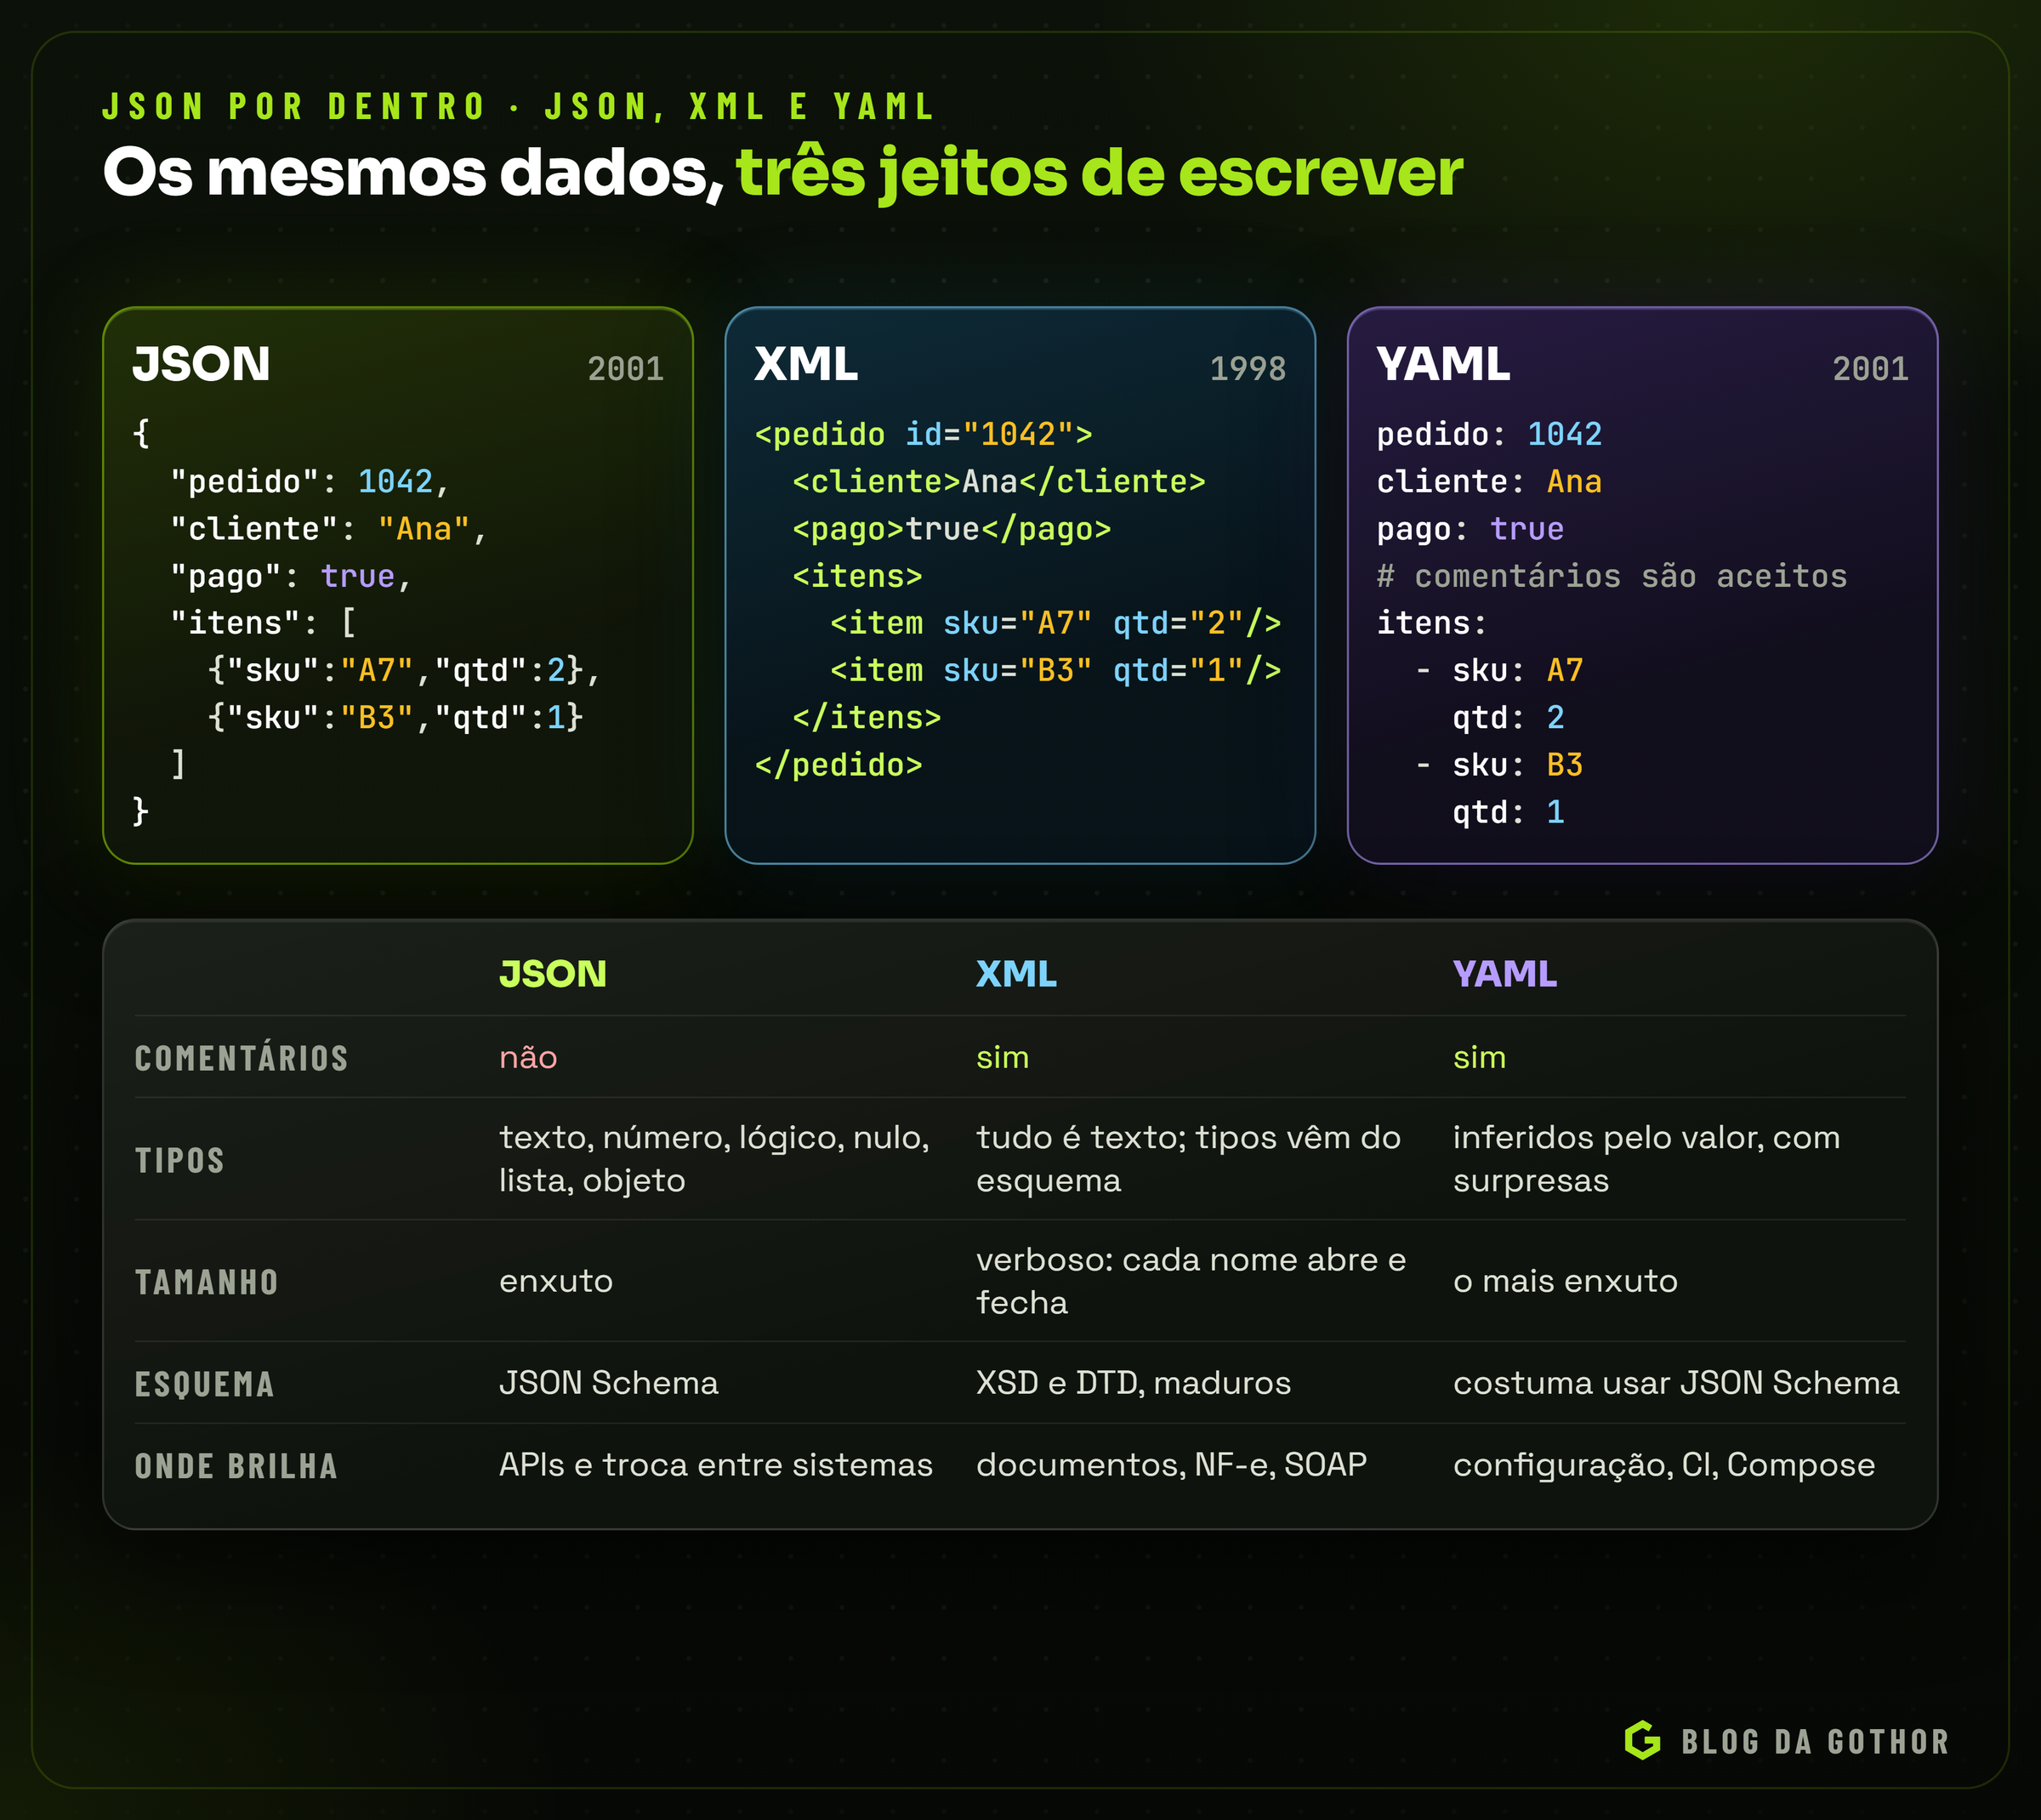
O XML veio antes, em 1998, e continua muito presente onde documentos precisam de validação rigorosa, assinatura digital e esquemas maduros. A nota fiscal eletrônica brasileira, por exemplo, é um XML assinado e validado contra esquemas oficiais. O XML é mais verboso, porque cada nome abre e fecha, e todo valor é texto até que um esquema diga o contrário, mas tem atributos, namespaces e um ecossistema completo de validação e transformação.
O YAML prioriza a leitura humana: usa recuo no lugar de chaves, aceita comentários e é o padrão de arquivos de configuração como os de integração contínua e do Docker Compose. Todo JSON válido é, na prática, YAML válido. O preço da conveniência são as surpresas: o recuo é significativo, e valores sem aspas são interpretados pelo formato. Em leitores que seguem a versão 1.1 do YAML, um no vira o lógico falso, o que fez muita gente descobrir da pior forma que o código da Noruega, NO, precisava de aspas.
Há também variações e parentes do JSON que vale conhecer:
- JSONC e JSON5 aceitam comentários e vírgulas no fim, e são usados em arquivos de configuração, como os do VS Code e o
tsconfig.json. Não servem para troca de dados entre sistemas. - JSON Lines (ou NDJSON) é um JSON por linha, sem lista em volta. É ótimo para logs e para processar arquivos enormes linha a linha, sem carregar tudo na memória.
- JSON-LD usa JSON para descrever dados ligados, e é o formato que os buscadores leem para entender o conteúdo de uma página.
- Formatos binários, como MessagePack, CBOR e Protocol Buffers, trocam a legibilidade por tamanho e velocidade, e aparecem em comunicações de alto volume entre serviços.
A regra prática: JSON para dados que viajam entre sistemas, YAML para configuração escrita por pessoas, XML onde um padrão externo o exige, e um formato binário só quando a medição mostrar que o tamanho ou o tempo de leitura do JSON é o gargalo.
JSON em APIs HTTP
Numa API, o JSON vem acompanhado de algumas convenções do HTTP:
- O tipo de mídia é
application/json. A especificação desse tipo não define o parâmetrocharset, porque o JSON trocado entre sistemas é sempre UTF-8. - O cliente diz o que envia no
Content-Typee o que aceita noAccept. Um servidor que recebeContent-Type: application/jsoncom um corpo malformado deve responder400. - Nomes de campos seguem um padrão só na API inteira, seja
camelCaseousnake_case. Misturar os dois é uma fonte inesgotável de bugs. - Num
PATCH, um campo ausente costuma significar "não mexa" e umnull, "apague o valor". - Listas grandes vêm paginadas, e respostas grandes são comprimidas (
Content-Encoding: gzipoubr). JSON é texto repetitivo e costuma encolher muito. - Erros também vêm em JSON, num formato único, de preferência o Problem Details.
No navegador e nos runtimes que seguem as APIs da web, o fetch cuida das duas pontas. Do lado de quem consome, await resposta.json() lê o corpo e o interpreta, e a Promise é rejeitada com SyntaxError se o corpo não for JSON válido, o que acontece com frequência quando um servidor responde uma página de erro em HTML. Vale conferir resposta.ok e o Content-Type antes de chamar json(), para que a mensagem de erro diga o que de fato aconteceu. Do lado de quem produz, o método estático Response.json(dados, opcoes) monta uma resposta com o corpo serializado e o Content-Type: application/json já preenchido, e lança TypeError se os dados não puderem ser serializados, como um objeto com referência circular.
Para alterar partes de documentos, existem padrões próprios. O JSON Pointer (RFC 6901) endereça um ponto do documento, como /itens/0/qtd. O JSON Patch (RFC 6902) descreve uma lista de operações (adicionar, remover, substituir) e o JSON Merge Patch (RFC 7396) descreve a mudança como um documento parcial. Para consultas, o JSONPath ganhou uma especificação própria em 2024, a RFC 9535.
Nem toda comunicação segue o ciclo de uma requisição e uma resposta. O JSON-RPC 2.0 é um protocolo mínimo de chamada de procedimentos, em que o cliente envia o método, os parâmetros e um id, e recebe o resultado com o mesmo id; é a base do protocolo dos editores de código com os servidores de linguagem e do MCP, que conecta assistentes de IA a ferramentas. E para respostas que chegam aos poucos, o padrão da web são os Server-Sent Events (SSE): o servidor mantém a conexão aberta, com Content-Type: text/event-stream, e envia eventos em linhas de texto, cada um com uma linha data: que quase sempre leva um JSON pequeno. É assim que os assistentes de IA mostram o texto enquanto ele é gerado.
JSON e inteligência artificial
Os modelos de linguagem trouxeram um uso novo, e exigente, para o JSON: ser a ponte entre um texto gerado por probabilidade e um programa que precisa de dados exatos.
O primeiro encontro é a chamada de ferramentas (function calling). A aplicação descreve ao modelo as ferramentas disponíveis, cada uma com um nome, uma descrição e os parâmetros em JSON Schema. Quando o modelo decide usar uma ferramenta, responde com o nome dela e os argumentos num objeto JSON; a aplicação executa e devolve o resultado, também em JSON, para o modelo continuar. As descrições dos campos no esquema são lidas pelo modelo e influenciam muito a qualidade dos argumentos.
O segundo é a saída estruturada. Quando a resposta inteira precisa ser um JSON com forma definida, por exemplo para classificar um pedido, os provedores oferecem modos em que a própria geração é restringida pelo esquema: o modelo não consegue produzir um texto que viole a forma pedida. Antes disso, o comum era pedir JSON nas instruções e torcer, e as respostas vinham envoltas em cercas de código Markdown, com vírgulas sobrando ou campos inventados.
Mesmo com saída estruturada, validar continua obrigatório. Nem todo modelo, sobretudo os menores, oferece a restrição completa. A forma pode estar certa e o conteúdo errado, como uma ferramenta que existe no esquema, mas está fora do ar naquele momento. E a regra de negócio não cabe num esquema. O JSON gerado por um modelo é um dado que chega de fora e passa pela fronteira como qualquer outro.
JSON no banco de dados
Os bancos relacionais modernos guardam e consultam JSON. No PostgreSQL há dois tipos: json, que guarda o texto exatamente como chegou, e jsonb, que guarda uma versão binária já interpretada, sem espaços, sem campos duplicados (fica o último) e sem a ordem original dos campos. O jsonb é mais rápido para consultar e aceita índices, inclusive sobre campos internos, e é quase sempre a escolha certa.
A consulta usa operadores próprios: -> devolve um campo como JSON, ->> devolve como texto, e @> testa se um documento contém outro:
SELECT id,
       dados->>'cliente'                  AS cliente,
       (dados->>'total_centavos')::bigint AS total_centavos
FROM pedidos_enviados
WHERE dados @> '{"situacao": "faturado"}';

-- um índice GIN acelera as buscas por conteúdo com @>
CREATE INDEX pedidos_enviados_dados_idx
  ON pedidos_enviados USING gin (dados jsonb_path_ops);
O exemplo usa a classe de operadores jsonb_path_ops, e a escolha merece explicação. O índice GIN padrão para jsonb, o jsonb_ops, cria uma entrada para cada chave e cada valor do documento, e por isso atende tanto o @> quanto os operadores que perguntam se uma chave existe (?, ?| e ?&). O jsonb_path_ops cria entradas só para os valores, cada um combinado com o caminho de chaves que leva até ele. Segundo a documentação, ele costuma ser bem menor e mais seletivo, sobretudo quando as chaves se repetem em todos os documentos, mas não atende as perguntas de existência de chave e fica lento para procurar estruturas vazias, como {"a": {}}. Para consultas de conteúdo, que são a maioria, ele é a melhor escolha; para "quais documentos têm o campo X", o padrão.
O PostgreSQL também implementa o SQL/JSON do padrão, com caminhos como $.itens[*].sku e, desde a versão 17, a função JSON_TABLE, que transforma um documento em linhas e colunas.
A tentação é transformar o banco relacional num depósito de documentos. A regra prática é usar colunas JSON para dados que são lidos e gravados juntos e raramente filtrados por partes, como o pedido completo enviado a um serviço externo, e manter em colunas comuns tudo o que entra em filtros, junções, totais e restrições de integridade. Quando um campo de dentro do JSON passa a aparecer em todo relatório, é sinal de que ele merece virar coluna. E quando a ordem dos campos importa para quem vai ler, o jsonb não serve, porque não a guarda: o caminho é o tipo json ou uma coluna de texto.
Ferramentas do dia a dia
Trabalhar com JSON fica muito mais rápido com as ferramentas certas:
- O **
jq** é um processador de JSON para a linha de comando: filtra, transforma e formata. Com ele, uma resposta de API vira uma tabela em uma linha de terminal. - As ferramentas de desenvolvedor do navegador mostram as respostas JSON de cada requisição já formatadas e navegáveis, na aba Rede.
- Os editores de código validam JSON enquanto você digita e, se o arquivo declarar um esquema no campo
$schema, completam os nomes dos campos e apontam erros de tipo. - Os módulos nativos das linguagens também formatam:
python -m json.tool arquivo.jsonimprime o arquivo indentado e acusa erros de sintaxe com a linha e a coluna.
Alguns exemplos do jq, com um arquivo de pedidos ilustrativo:
jq '.' pedidos.json                                   # formata e colore
jq '.[] | select(.status == "aberto") | .id' pedidos.json
jq '[.[] | .total_centavos] | add' pedidos.json       # soma de uma coluna
jq -c '.[]' pedidos.json > pedidos.jsonl              # uma linha por pedido (JSON Lines)
jq -r '.[] | [.id, .status] | @csv' pedidos.json      # vira planilha CSV
Uma advertência vale para todas as ferramentas: sites de formatação e validação de JSON on-line recebem tudo o que é colado neles. Uma resposta de API com nomes, documentos e valores de clientes não deve ir para um site de terceiros só para ser formatada. O jq, o editor e o navegador fazem o mesmo trabalho sem que os dados saiam da máquina, o que importa também para a LGPD.
Quando o JSON fica grande
Ler um JSON exige, na maioria das bibliotecas, carregar o texto inteiro e montar todos os objetos na memória. Para alguns megabytes, isso é instantâneo; para centenas, vira um problema de memória e de tempo. Três estratégias resolvem a maioria dos casos: paginar as respostas, para que nenhuma seja enorme; usar JSON Lines para arquivos e exportações, processando uma linha de cada vez; e, quando for inevitável ler um documento gigante, usar um leitor em fluxo (streaming), que entrega os valores à medida que lê. Na rede, a compressão costuma reduzir o tamanho de um JSON para uma fração do original, porque nomes de campos se repetem em todos os registros.
Sequências de JSON: JSON Lines e a RFC 7464
O JSON Lines resolve o problema dos arquivos grandes com uma regra mínima, publicada em jsonlines.org: o arquivo é UTF-8, sem BOM; cada linha contém um valor JSON completo; as linhas terminam em \n (o \r\n também é aceito); e linhas em branco não são permitidas. A extensão sugerida é .jsonl, ou .jsonl.gz quando o arquivo é comprimido. Como o JSON não permite quebras de linha dentro de textos, só como \n escapado, um serializador comum, sem espaçamento, já produz uma linha por registro.
{"id":"4821","situacao":"faturado","total":"159.90"}
{"id":"4822","situacao":"aberto","total":"89.00"}
As vantagens aparecem no dia a dia. Acrescentar um registro é só escrever uma linha no fim do arquivo, sem reabrir uma lista. Ferramentas de linha de comando que trabalham por linha, como head, tail, split e grep, funcionam direto. E um arquivo cortado no meio, por um disco cheio ou um processo interrompido, perde só a última linha, e não o arquivo inteiro.
A IETF tem uma especificação com a mesma ideia, a RFC 7464, de fevereiro de 2015, com o tipo de mídia application/json-seq. Nela, cada valor começa com o caractere separador de registro (o código 0x1E) e termina com uma quebra de linha. O separador permite que o leitor se ressincronize depois de um trecho corrompido: a RFC pede que ele pule o elemento defeituoso, registre o problema e continue a partir do próximo separador. A quebra de linha no fim tem um motivo sutil: um número no fim de um texto truncado parece válido (12 pode ser o começo de 1234), e a RFC manda descartar valores de nível mais alto que não terminam com espaço em branco.
Logs estruturados em JSON
Um log em texto livre, como Pedido 4821 faturado em 1,2 s, é fácil de ler e difícil de consultar. Quando cada evento é gravado como uma linha JSON, com campos fixos (o instante em UTC, o nível, a mensagem e os dados do evento), a ferramenta de logs passa a filtrar por campo, somar durações e agrupar por situação, sem depender de expressões regulares frágeis:
{"ts":"2026-10-25T13:00:01.204Z","nivel":"info","msg":"pedido faturado","pedido":"4821","duracao_ms":1204}Algumas regras tornam esse formato útil de verdade. Os nomes dos campos são os mesmos em todo o sistema, para que uma busca por pedido encontre os eventos de todos os serviços. Medidas levam a unidade no nome (duracao_ms, tamanho_bytes), pelo mesmo motivo do total_centavos. Erros entram com o tipo, a mensagem e a pilha em campos próprios, e não concatenados num texto. E dados pessoais ou sigilosos passam pelo replacer que mascara campos sensíveis antes de qualquer gravação, como mostrado na seção sobre serialização.
Segurança
O JSON em si é só texto, mas a forma de usá-lo cria riscos conhecidos:
- **Nunca interprete JSON com
eval** ou equivalentes. Use sempre o leitor da linguagem, que só aceita dados. - Limite o tamanho do corpo e a profundidade. Sem limite, um único JSON de centenas de megabytes consome a memória do servidor, e um documento com milhares de níveis aninhados estoura a pilha de um leitor recursivo.
- Cuidado ao mesclar objetos. Um JSON com a chave
__proto__, mesclado recursivamente por código ingênuo, pode alterar o protótipo de todos os objetos de uma aplicação JavaScript, o ataque chamado prototype pollution. Valide com esquemas que rejeitam campos não previstos e use bibliotecas de mesclagem que tratam esse caso. - Não grave o corpo inteiro direto no banco. Passar o JSON recebido diretamente para uma atualização permite que o cliente altere campos que não deveria, como o próprio nível de acesso: é a atribuição em massa (mass assignment), uma das falhas mais comuns em APIs segundo a OWASP.
- Desconfie de nomes duplicados. Se o componente que valida lê o primeiro valor de uma chave repetida e o que executa lê o último, um atacante passa pela validação com um valor e executa com outro. Validar e usar o resultado da mesma leitura elimina o problema.
- Não exponha mais do que precisa. Serializar a entidade inteira do banco na resposta da API vaza campos internos, como hashes de senha e anotações.
- JSON dentro de HTML exige escape. Um texto com
</script>dentro de um bloco<script type="application/ld+json">fecha a tag antes da hora e abre caminho para injeção de código; a solução é trocar todo<por\u003cao gerar o bloco.
Um caso especial é o JWT (JSON Web Token), o formato de token de acesso mais usado em APIs. Ele é, literalmente, JSON: o cabeçalho e o conteúdo são objetos JSON codificados em Base64, separados por pontos e seguidos de uma assinatura, e por isso todo JWT começa com eyJ. Daí vêm dois cuidados. O conteúdo de um JWT não é secreto, apenas assinado: qualquer pessoa o decodifica e lê. E o campo alg do cabeçalho, que diz qual algoritmo assinou o token, nunca deve ser aceito às cegas, porque um atacante pode trocá-lo por none. O servidor deve fixar o algoritmo esperado e, depois de verificar a assinatura, validar o conteúdo com um esquema, como faria com qualquer JSON vindo de fora.
Assinar JSON: canonicalizar ou embrulhar
Assinar um documento JSON parece simples até a primeira tentativa. Uma assinatura protege bytes, e o mesmo dado JSON pode ser escrito de muitas formas: com ou sem espaços, com os campos em outra ordem, com "é" ou "é", com 1.0 ou 1. Se quem assina e quem confere serializarem o objeto de jeitos diferentes, uma assinatura válida parece inválida. Há duas saídas.
A primeira é embrulhar, o caminho do JWS (RFC 7515), base do JWT. Em vez de assinar o objeto, assina-se o texto exato, já codificado em base64url: a entrada da assinatura é o cabeçalho e o conteúdo, cada um em base64url, unidos por um ponto. Quem confere não reserializa nada; verifica a assinatura sobre os bytes recebidos e só depois decodifica e lê o JSON. A RFC deixa claro que o conteúdo assinado pode ser qualquer sequência de bytes, e não precisa nem ser JSON.
A segunda é canonicalizar, o caminho da RFC 8785, o JSON Canonicalization Scheme (JCS), publicada em 2020 como documento informativo. Ela define uma única forma de escrever cada dado: nenhum espaço entre os elementos; campos ordenados recursivamente pelos códigos UTF-16 dos nomes, sem depender de idioma; números escritos pelas regras do próprio ECMAScript para converter número em texto; e só os escapes indispensáveis nos textos. A entrada precisa seguir o I-JSON, então nomes repetidos, NaN e surrogates soltos são erro. A vantagem é que o dado viaja no formato JSON normal, legível, e a assinatura é calculada sobre a forma canônica.
Na prática, o embrulho é mais simples e mais difícil de errar, porque ninguém precisa reproduzir a serialização do outro lado. A canonicalização faz sentido quando o documento precisa continuar sendo JSON comum, por exemplo para ser gravado e consultado num banco, e ainda assim carregar uma assinatura ou um hash que identifique o conteúdo.
Passo a passo: diagnosticando uma integração que quebrou
Quando uma integração quebra e a mensagem diz apenas "Unexpected token", um roteiro em ordem resolve quase todos os casos sem adivinhação.
- Capture o texto bruto. O que importa são os bytes que chegaram, e não o objeto que o seu código montou depois. Registre o corpo como veio, num ambiente de teste ou com os dados pessoais mascarados, junto com o status HTTP e os cabeçalhos.
- Confira o tipo e a codificação. Se o
Content-Typenão éapplication/json, o servidor pode ter respondido uma página de erro em HTML, e o "caractere inesperado na posição 0" é o<do<html>. Sequências comoçno lugar deçindicam UTF-8 lido como Latin-1, problema comum com sistemas antigos. Erro na posição 0 num texto que parece perfeito costuma ser um BOM. - Valide a sintaxe com uma ferramenta.
jq . resposta.jsonaponta a linha e a coluna do problema: vírgula sobrando, aspas simples,NaNou texto cortado no meio por um limite de tamanho no caminho. - Compare com o contrato. Passe o documento pelo esquema. Campos obrigatórios ausentes, nomes com outra grafia (
clienteIdem vez decliente_id) e tipos trocados aparecem com o caminho exato. - Olhe números, datas e nulos com lupa. Identificadores que terminam em zeros indicam perda de precisão; horários com três ou quatro horas de diferença, um fuso perdido; valores cem vezes maiores, uma confusão entre reais e centavos; e um campo que sempre vinha preenchido pode ter chegado
null. - Transforme o caso em teste. Guarde o documento problemático, anonimizado, entre os exemplos do contrato, e escreva um teste que o leia. O mesmo erro não volta sem que alguém perceba.
Erros comuns
| Erro | Por que acontece | A correção |
|---|---|---|
| vírgula sobrando, aspas simples e comentários | o arquivo foi escrito à mão ou montado por concatenação | gere JSON com o serializador da linguagem |
| identificadores grandes como número | o leitor usa ponto flutuante de 64 bits | identificadores como texto |
| dinheiro em ponto flutuante | 0.1 + 0.2 não dá 0.3 | centavos em inteiro ou decimal como texto |
| datas sem fuso, ou em formato local | cada sistema supõe o próprio fuso | ISO 8601 com deslocamento, de preferência em UTC |
| confiar no tipo do TypeScript | o tipo some na compilação | valide na fronteira com um esquema |
null, ausente e vazio tratados como a mesma coisa | a API não documentou a diferença | defina o sentido de cada um |
| mudar o formato de uma mensagem sem versionar | a mudança parecia pequena | versão, exemplos testados e consumidor atualizado primeiro |
| registrar o corpo inteiro das requisições | facilita a depuração no começo | registre metadados e mascare campos sensíveis |
Perguntas frequentes
JSON é mais rápido que XML? Em geral, sim: os documentos são menores e os leitores, mais simples. Mas a diferença raramente decide um projeto. O que decide é o ecossistema: onde há um padrão externo em XML, como a nota fiscal eletrônica, o XML é a escolha certa.
Posso colocar comentários num arquivo JSON de configuração? Só se quem lê o arquivo aceitar JSONC ou JSON5, como o VS Code e o compilador do TypeScript. Um leitor JSON comum vai recusar o arquivo. Uma alternativa compatível é um campo de texto com a explicação, como "_comentario": "...", que os programas ignoram.
Existe um tamanho máximo para um JSON? A especificação não define, mas todo servidor deve definir o seu. Limites de 1 a 10 MB por requisição são comuns em APIs; acima disso, o melhor é enviar arquivos separados ou dividir os dados em partes.
Como usamos JSON na Gothor
Na Gothor, o JSON é o formato padrão das conversas entre sistemas: APIs, integrações e mensagens entre serviços. A regra que mais importa é a deste artigo: todo JSON que chega de fora é validado contra um esquema antes de ser usado, e o formato de cada mensagem é tratado como um contrato, que só muda de forma compatível.
Resumo
- JSON é texto com seis tipos de valor: objeto, lista, texto, número, lógico e nulo. Nada de comentários, aspas simples, vírgula sobrando,
NaNou datas. - Nomes de campos devem ser únicos, a ordem dos campos não tem significado e os textos são Unicode em UTF-8, sem BOM.
- O primeiro caractere de cada valor diz o tipo, o que torna a leitura simples; bons leitores limitam o tamanho e a profundidade.
- Números são lidos como ponto flutuante na maioria das linguagens: identificadores grandes vão como texto e dinheiro vai em centavos ou como texto decimal.
- Datas vão como texto ISO 8601, com fuso nos instantes, de preferência em UTC, e só o dia nas datas de calendário.
- Serializar e ler de volta perde o que não é JSON: datas viram texto,
undefinedsome,NaNviranull. JSON.parseconfere a sintaxe; JSON Schema ou Zod conferem o formato. Valide tudo na fronteira, inclusive o que vem de um modelo de IA.- Contratos evoluem: campo novo e opcional não quebra; o resto pede versão e o consumidor atualizado antes do produtor.
- Em APIs:
application/jsonem UTF-8, um padrão de nomes, paginação, compressão, erros padronizados e limites de tamanho. - O I-JSON fecha as brechas da especificação; o JCS e o JWS resolvem a assinatura; JSON Lines e logs estruturados levam o formato a arquivos grandes e à observação dos sistemas.
Para ir além
- JSON.org em português, com os diagramas de sintaxe originais.
- RFC 8259, a especificação do JSON, e o padrão ECMA-404.
- RFC 7493, o perfil I-JSON, RFC 3339, datas e horas na internet, e RFC 8785, a forma canônica do JSON.
- JSON na MDN, com
JSON.parseeJSON.stringify. - JSON Schema, as notas das versões 2019-09 e 2020-12, e a documentação do Zod.
- A proposta de acesso ao texto-fonte no JSON.parse, o JSON.rawJSON e os atributos de importação, na MDN.
- RFC 7515, JSON Web Signature, e RFC 7464, sequências de textos JSON.
- RFC 9457, Problem Details para APIs HTTP.
- RFC 6901, JSON Pointer, RFC 6902, JSON Patch e RFC 9535, JSONPath.
- A especificação do JSON-RPC 2.0 e a RFC 7519, JSON Web Token.
- Tipos JSON no PostgreSQL.
- simdjson, o leitor que processa gigabytes por segundo.
- JSON Lines e JSON5.
- Manual do jq.
Este post foi escrito com a ajuda da Juniper, a assistente de IA da Gothor, e revisado pela nossa equipe antes de ir ao ar.