LLM por dentro: o que é um modelo de linguagem grande e como ele lê, calcula e escreve
Tokens, embeddings, atenção, treinamento, RAG, agentes e a escolha entre nuvem e modelo local, explicados sem mistério. Um guia completo para entender o que acontece entre a pergunta e a resposta de um LLM, e como usamos esses modelos na Juniper, a assistente da Gothor.
Em novembro de 2022, um chat ficou famoso em poucos dias e colocou uma sigla técnica na conversa de todo mundo. De lá para cá, modelos de linguagem passaram a resumir reuniões, responder clientes, escrever código, ler contratos e operar sistemas. Para muita gente, porém, o que acontece entre a pergunta e a resposta continua sendo uma caixa preta, e é difícil usar bem uma ferramenta que não se entende.
Este artigo abre a caixa. Sem fórmulas desnecessárias, mas sem simplificar até ficar errado, ele mostra o que é um LLM (large language model, ou modelo de linguagem grande), como ele transforma texto em números e números em texto, como é treinado, por que às vezes inventa coisas e quais são as formas práticas de adaptá-lo ao seu negócio. No fim, mostramos como esses modelos funcionam dentro da Juniper, a assistente de IA da Gothor.
O que é um LLM
Um LLM é uma rede neural treinada para prever o próximo pedaço de texto. Dado um trecho, ele calcula a probabilidade de cada continuação possível, escolhe uma, acrescenta ao texto e repete. Só isso. Tudo o que um assistente de IA faz, de responder perguntas a escrever um programa, sai dessa operação repetida milhares de vezes.
O "grande" do nome se refere a duas coisas. A primeira é o número de parâmetros, os valores numéricos ajustados durante o treinamento, que nos modelos atuais vai de alguns bilhões a centenas de bilhões. A segunda é o volume de dados de treinamento: trilhões de pedaços de texto de livros, páginas da web, artigos, código e documentos licenciados.
O ponto que surpreendeu até os pesquisadores é que, quando o modelo e os dados crescem o suficiente, prever a próxima palavra passa a exigir habilidades que ninguém programou explicitamente: para continuar bem um texto sobre física, o modelo precisa de alguma representação de física; para continuar um diálogo, precisa acompanhar quem disse o quê. É daí que vêm a capacidade de resumir, traduzir, raciocinar em etapas e seguir instruções.
Também ajuda saber o que um LLM não é. Ele não é um banco de dados que consulta fatos, nem um buscador que lê a internet em tempo real. É um modelo estatístico da linguagem, com um conhecimento enorme, mas aproximado, congelado na data em que o treinamento terminou. Essa diferença explica quase todos os erros que veremos adiante.
De onde veio: uma história curta
Modelos que preveem a próxima palavra existem há décadas. Os primeiros contavam frequências de sequências curtas (os n-gramas) e eram usados em corretores e teclados. A virada veio em etapas:
- 2013, embeddings de palavras. O word2vec mostrou que é possível representar palavras como vetores de números em que significados parecidos ficam próximos.
- 2014, sequência para sequência e atenção. Redes recorrentes passaram a traduzir frases inteiras, e o mecanismo de atenção permitiu que o modelo "olhasse" para as partes relevantes da entrada.
- 2017, o Transformer. O artigo "Attention Is All You Need", de pesquisadores do Google, descartou a recorrência e construiu tudo sobre atenção. A arquitetura se mostrou muito mais fácil de treinar em paralelo, em escala, e é a base de praticamente todos os LLMs atuais.
- 2018 a 2020, escala. Vieram o GPT e o BERT, depois o GPT-2 e, em 2020, o GPT-3, com 175 bilhões de parâmetros, que mostrou ser capaz de executar tarefas novas a partir de poucos exemplos no próprio texto da pergunta.
- 2022, modelos que seguem instruções. Com ajuste por instruções e aprendizado por preferências humanas, os modelos passaram a conversar e a obedecer pedidos. O lançamento do ChatGPT, em novembro, levou isso ao público.
- 2023 em diante, diversidade. Surgiram modelos com pesos abertos que rodam em computadores comuns, modelos multimodais que leem imagens e áudio, janelas de contexto muito maiores e modelos que "pensam" em etapas antes de responder.
Como um LLM escreve: um token de cada vez
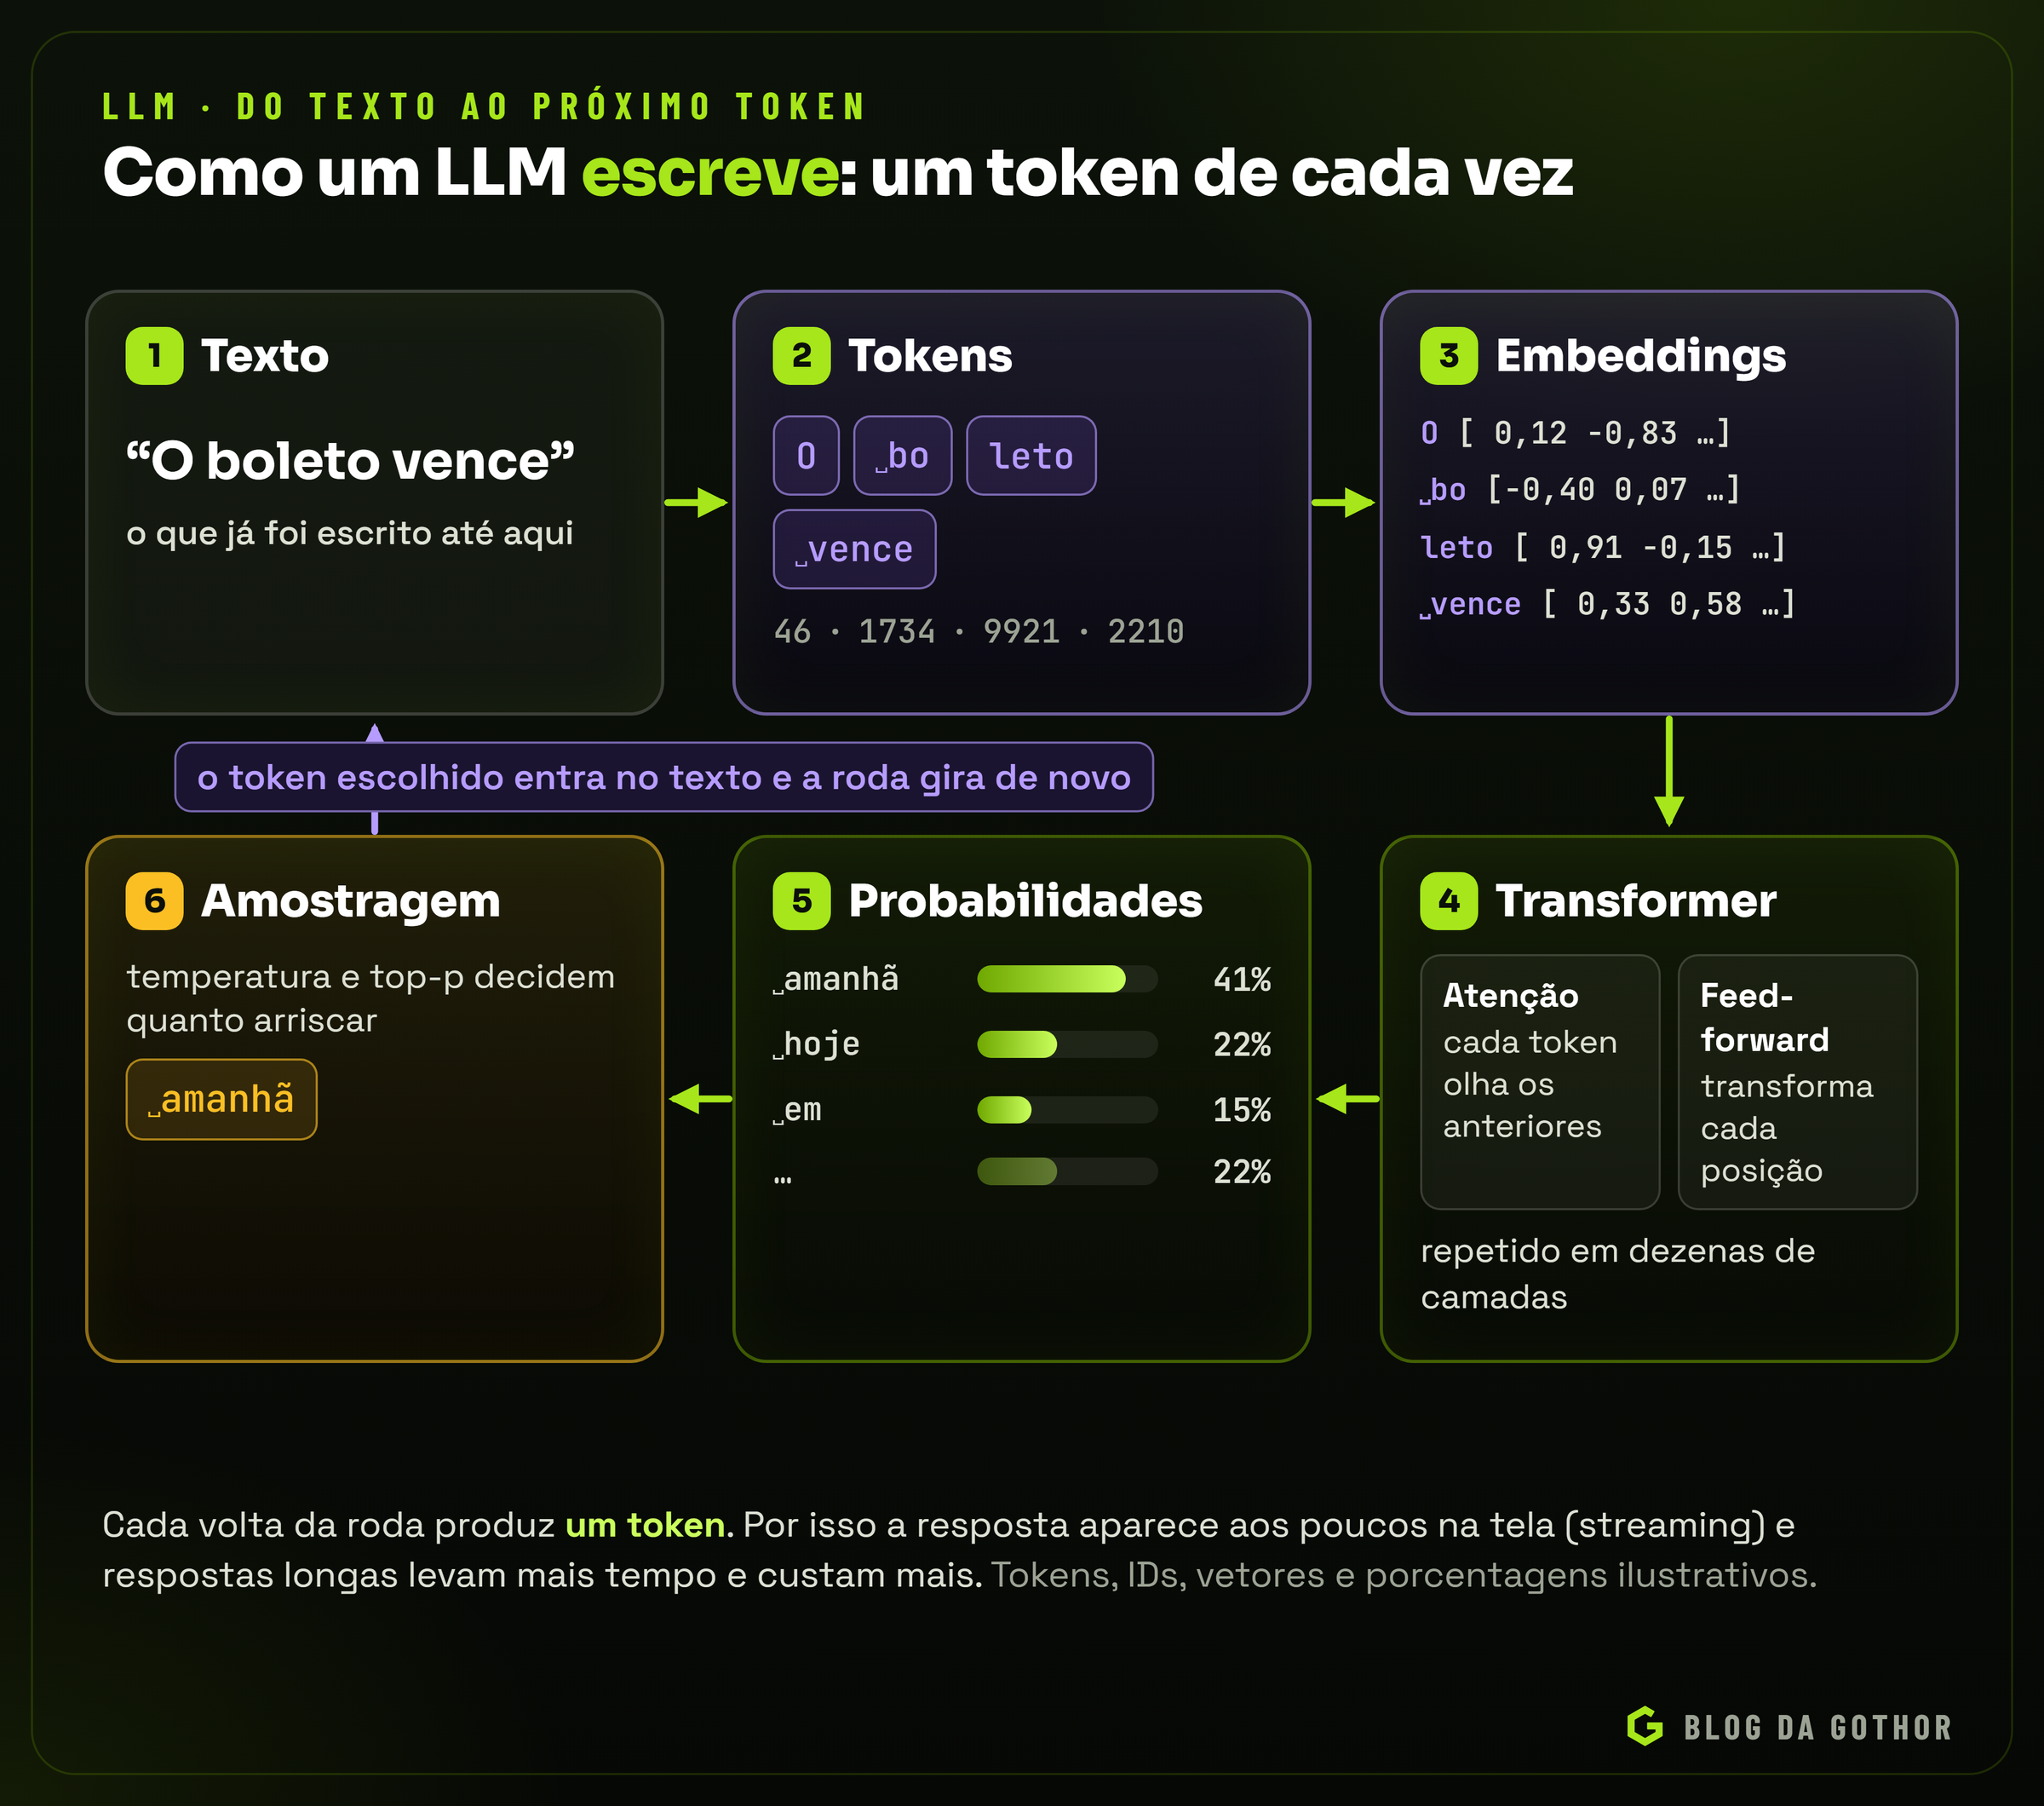
Por dentro, o caminho entre o texto de entrada e a próxima palavra tem seis etapas. Vale acompanhá-las com um exemplo: o modelo recebeu "O boleto vence" e precisa continuar.
Tokenização: o texto vira peças
O modelo não lê letras nem palavras, e sim tokens: pedaços de texto definidos por um tokenizador treinado antes do modelo. Palavras comuns costumam virar um token só; palavras raras, nomes e termos técnicos são quebrados em pedaços. Cada token tem um número de identificação, e é essa sequência de números que entra na rede.
Os tokenizadores atuais usam variações de um algoritmo chamado BPE (byte pair encoding), que começa com caracteres e junta os pares mais frequentes até formar um vocabulário de dezenas ou centenas de milhares de peças. A divisão exata depende de cada modelo, mas algumas consequências são gerais:
- Token não é palavra. Em inglês, um token corresponde em média a uns quatro caracteres. Em português, o mesmo conteúdo costuma gastar mais tokens, porque os tokenizadores foram treinados com mais texto em inglês.
- Limites e preços são em tokens. O tamanho máximo de uma conversa, o custo de uma chamada de API e a velocidade de resposta são medidos em tokens, e não em palavras.
- Algumas tarefas ficam estranhamente difíceis. Contar as letras de uma palavra ou inverter um texto é difícil para quem nunca vê as letras, só as peças.
Embeddings: as peças viram vetores
Cada número de token é trocado por um embedding: um vetor com centenas ou milhares de números que representa o significado daquela peça. No começo do treinamento esses vetores são aleatórios; ao final, tokens usados em contextos parecidos ficam próximos nesse espaço. A posição de cada token na frase também entra na conta, porque "o cliente pagou o boleto" e "o boleto pagou o cliente" têm as mesmas peças e sentidos opostos.
O Transformer e a atenção
Os vetores passam então por uma pilha de camadas Transformer, dezenas delas. Cada camada tem duas partes principais. A primeira é a atenção, que permite a cada token buscar informação nos tokens anteriores. A segunda é uma rede feed-forward, que transforma cada posição individualmente, e é onde se acredita que boa parte do conhecimento factual fica armazenada.
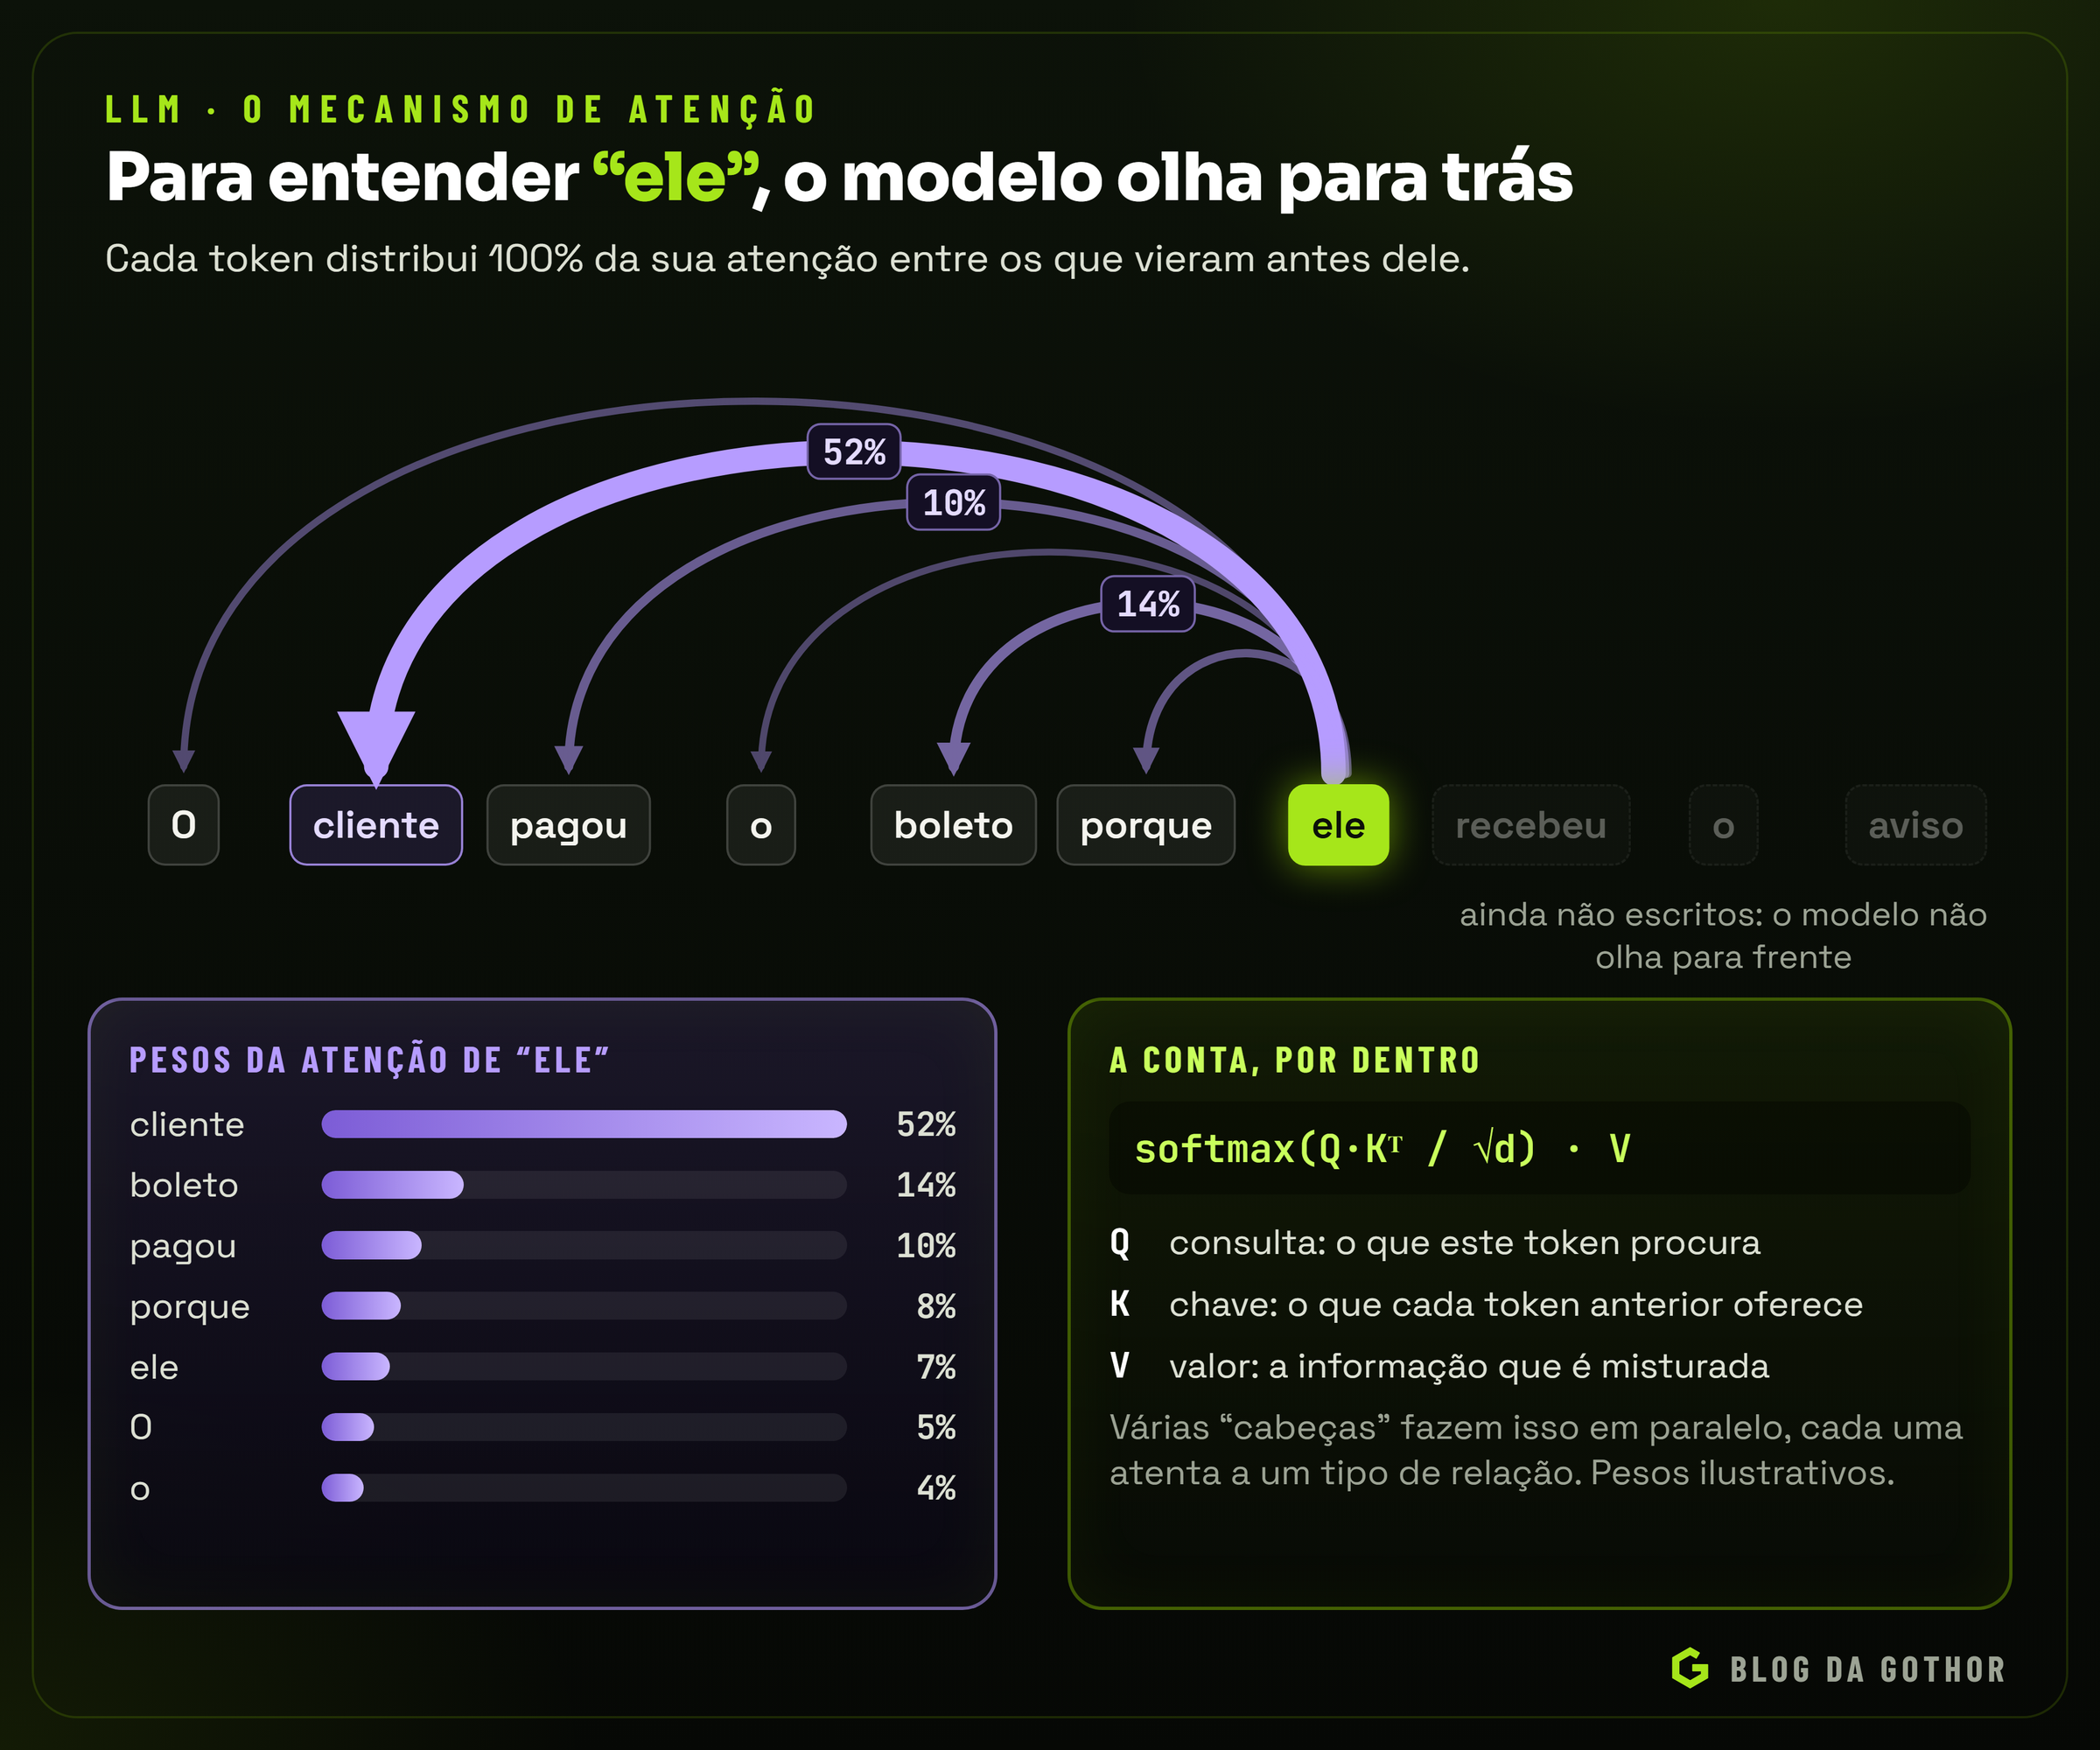
A atenção é a ideia central. Para cada token, o modelo calcula três vetores: uma consulta (query, o que este token procura), uma chave (key, o que cada token oferece) e um valor (value, a informação que será misturada). A consulta de um token é comparada com as chaves de todos os anteriores; as comparações viram pesos que somam 100%, e o resultado é uma média ponderada dos valores. Em notação compacta:
Atenção(Q, K, V) = softmax(Q · Kᵀ / √d) · VNa frase "O cliente pagou o boleto porque ele recebeu o aviso", a atenção permite que "ele" puxe informação principalmente de "cliente", e não de "boleto". Cada camada tem várias cabeças de atenção trabalhando em paralelo, cada uma especializada, durante o treinamento, num tipo de relação: concordância, referência, sintaxe, tema. Num modelo que gera texto, a atenção é causal: um token só olha para trás, nunca para palavras que ainda não foram escritas.
Das contas à palavra: probabilidades e amostragem
Ao fim da pilha, o vetor da última posição é convertido numa pontuação para cada token do vocabulário, os logits, e uma função chamada softmax transforma essas pontuações em probabilidades. Para "O boleto vence", o modelo pode atribuir 41% a " amanhã", 22% a " hoje", 15% a " em" e assim por diante.
Escolher o próximo token é a etapa de amostragem, controlada por alguns parâmetros que aparecem em quase todas as APIs:
- Temperatura: abaixo de 1, concentra a probabilidade nas opções mais prováveis; acima de 1, espalha. Perto de zero, o modelo escolhe quase sempre a mesma opção.
- Top-p (nucleus sampling): considera só os tokens mais prováveis que, somados, chegam a uma porcentagem, cortando a cauda de opções improváveis.
- Top-k: considera só os k tokens mais prováveis.
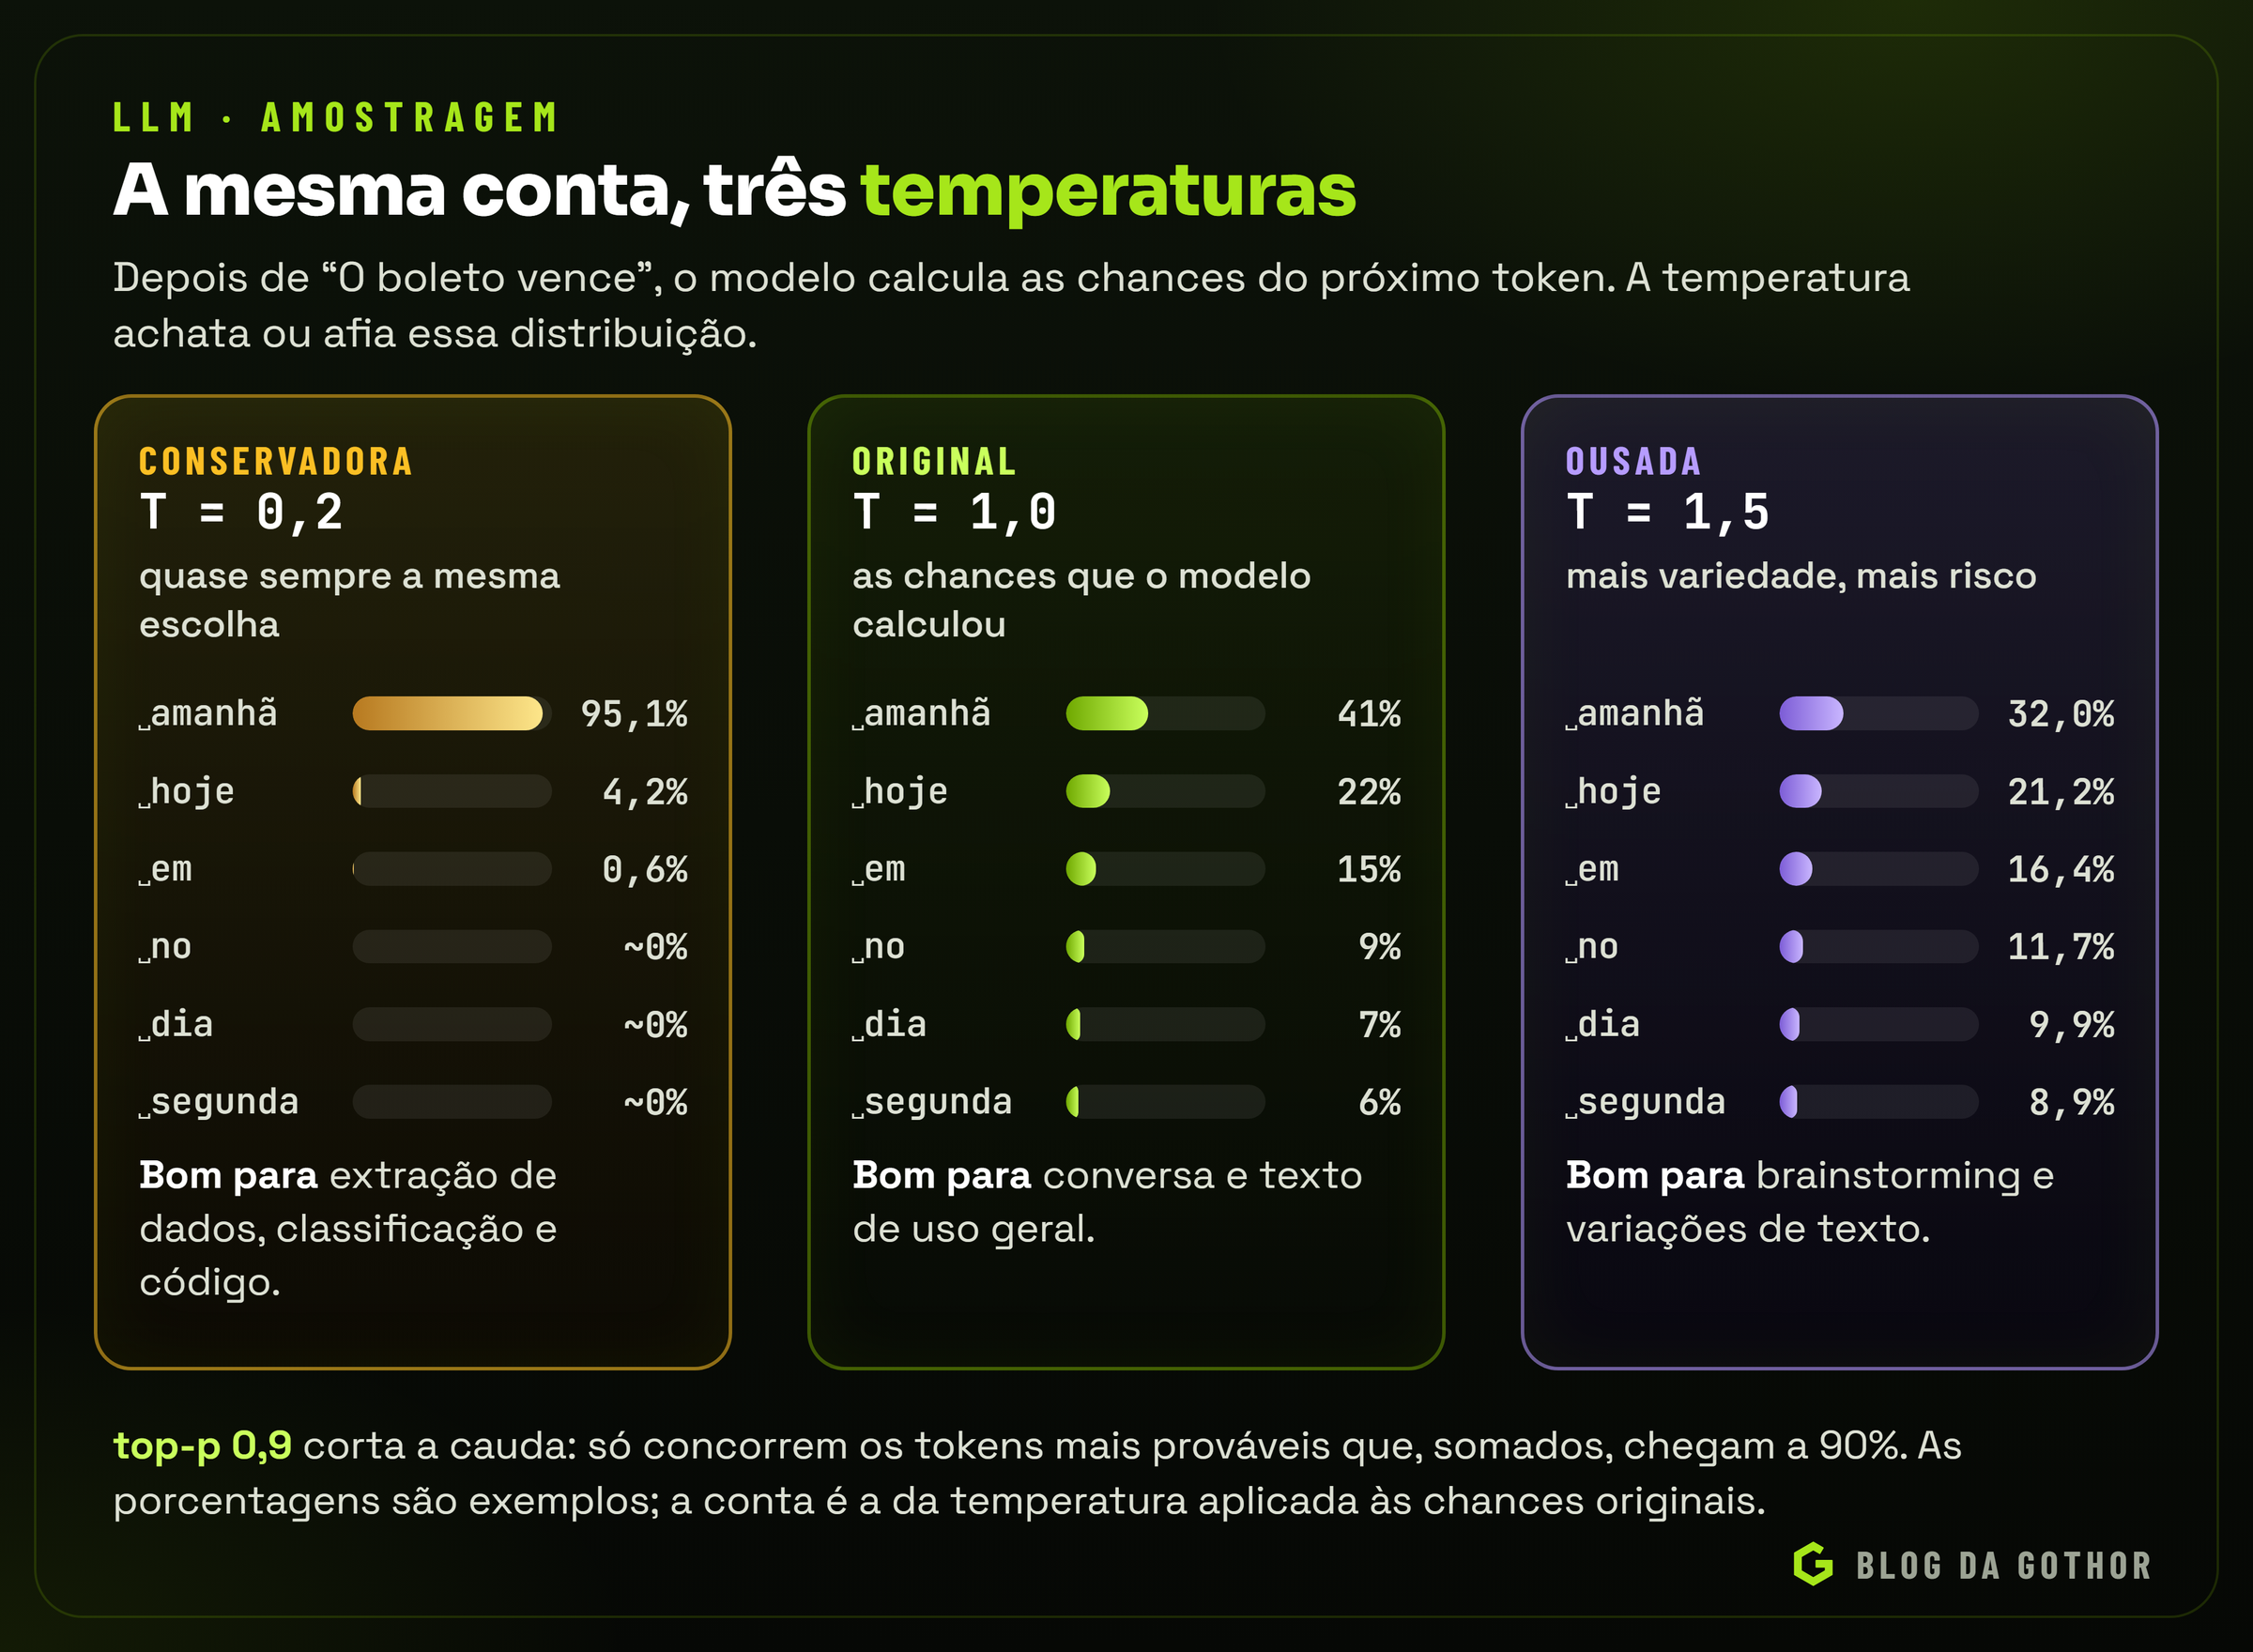
Para extrair dados de uma nota fiscal, classificar um chamado ou gerar código, temperaturas baixas dão respostas mais estáveis. Para gerar ideias ou variações de um texto, temperaturas mais altas trazem diversidade. Vale lembrar que, mesmo com temperatura zero, nem todo provedor garante respostas idênticas a cada chamada.
O laço, a janela de contexto e o cache
O token escolhido é acrescentado ao texto, e todo o processo se repete para o próximo. Isso tem consequências práticas que todo usuário percebe:
- A resposta aparece aos poucos (streaming) porque ela literalmente é produzida token a token.
- Respostas longas custam mais e demoram mais. Na maioria dos provedores, o token gerado é mais caro que o token lido.
- Existe um limite de contexto. A janela de contexto é o total de tokens que o modelo consegue considerar de uma vez: instruções, histórico da conversa, documentos e a própria resposta. Ela cresceu de alguns milhares para centenas de milhares de tokens, mas não é infinita, e o desempenho tende a cair com contextos muito longos e mal organizados.
Para não recalcular tudo a cada token, os servidores guardam as chaves e os valores da atenção já calculados, no chamado KV cache. Alguns provedores levam a ideia adiante com o cache de prompt: quando várias chamadas começam com o mesmo trecho longo (instruções, um manual, a definição de ferramentas), esse começo é processado uma vez e reaproveitado, com custo e latência menores.
Como um LLM é treinado
Um assistente moderno passa por pelo menos três fases de treinamento, e entender cada uma explica muito do seu comportamento.
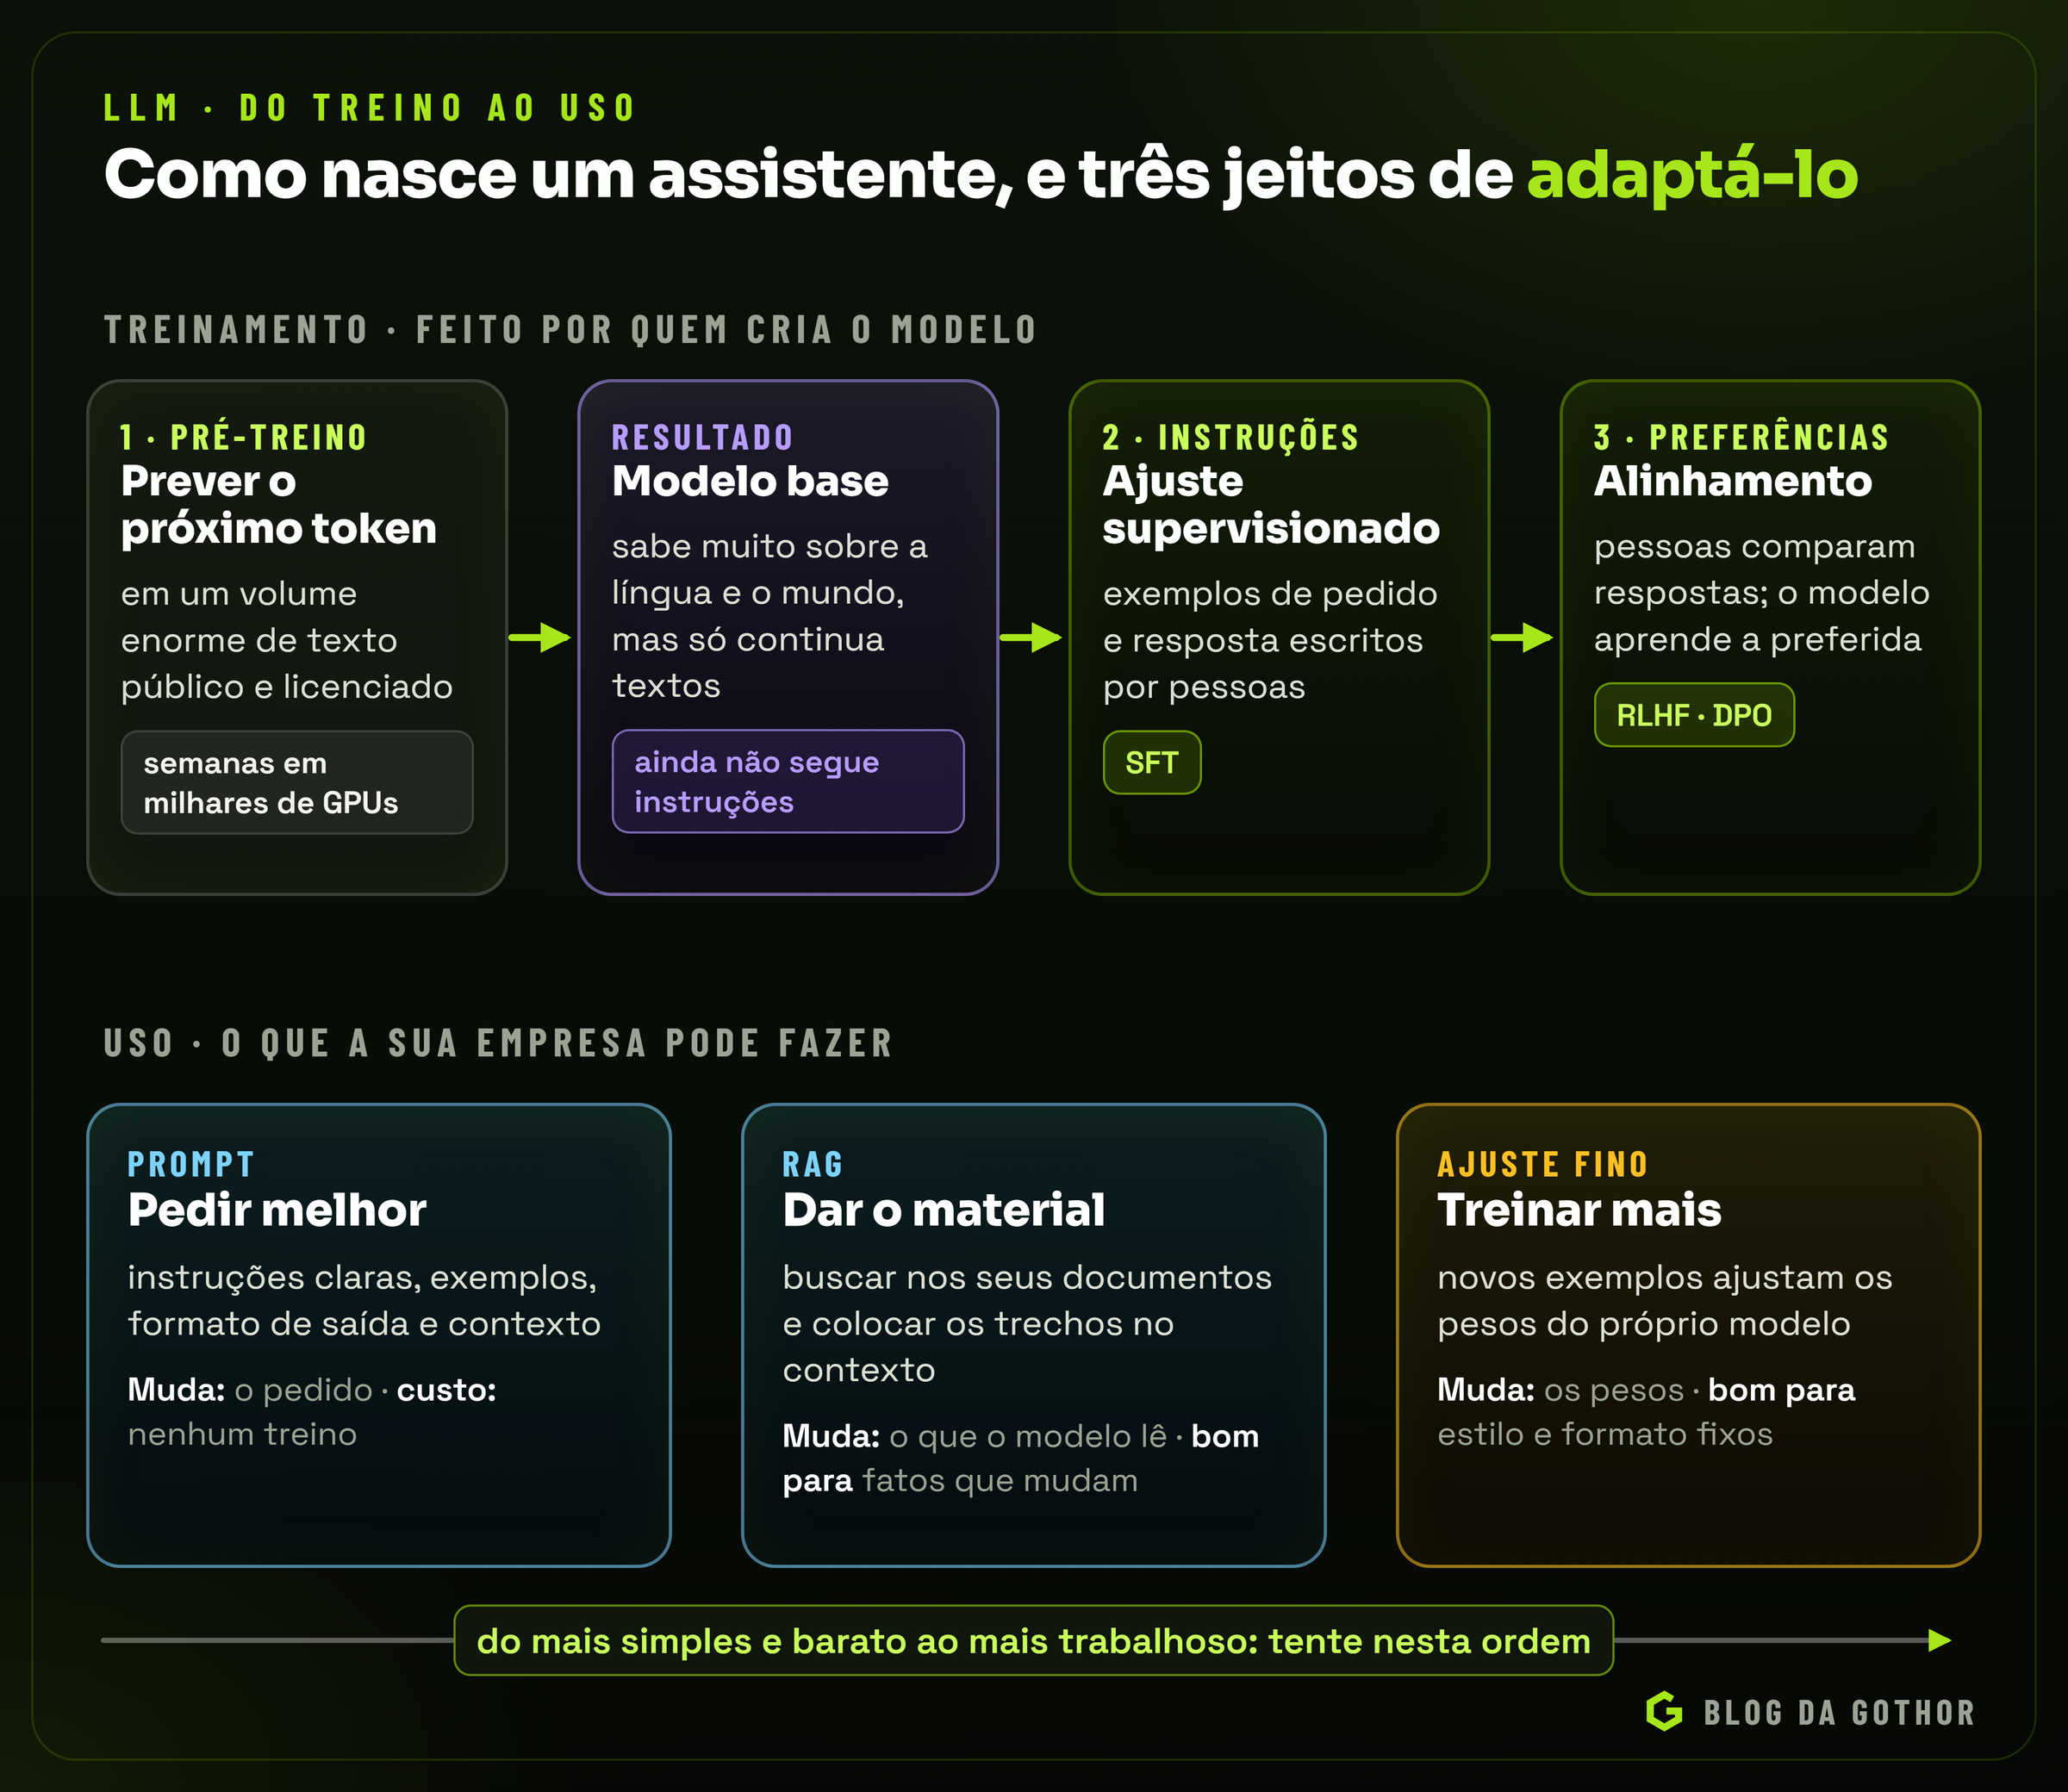
Pré-treinamento. O modelo lê um volume gigantesco de texto e aprende a prever o próximo token. Não há rótulos feitos por pessoas: o próprio texto é a resposta certa, o que permite usar trilhões de tokens. É a fase mais cara, que ocupa milhares de GPUs por semanas ou meses. Pesquisas sobre leis de escala mostraram que o erro cai de forma previsível quando crescem juntos o modelo, os dados e o poder de cálculo, o que orientou a corrida por modelos maiores e, depois, por modelos treinados com mais dados para o mesmo tamanho.
O resultado é um modelo base: sabe muito sobre a língua e o mundo, mas só continua textos. Pergunte "qual a capital do Brasil?" e ele pode responder com outra pergunta, porque é assim que listas de perguntas continuam na internet.
Ajuste por instruções. Na segunda fase, o modelo é treinado com exemplos de pedidos e boas respostas, escritos ou revisados por pessoas. É o supervised fine-tuning (SFT). O modelo aprende o formato de uma conversa e o hábito de atender ao que foi pedido.
Alinhamento por preferências. Na terceira fase, pessoas comparam pares de respostas e indicam a melhor. Com técnicas como RLHF (aprendizado por reforço com feedback humano) ou DPO (otimização direta de preferências), o modelo é ajustado para produzir o tipo de resposta preferida: útil, honesta, segura e no tom adequado. Fases mais recentes também usam aprendizado por reforço em problemas verificáveis, como matemática e programação, o que deu origem aos modelos que raciocinam em etapas antes de responder.
O que um LLM faz bem, e onde ele erra
Os LLMs são muito bons em tarefas de linguagem: resumir, reescrever, traduzir, classificar, extrair informação estruturada de texto livre, responder com base em documentos fornecidos, explicar, escrever e revisar código. Também são bons em raciocínio em etapas quando o problema cabe no contexto e há espaço para o modelo trabalhar.
Os pontos fracos decorrem diretamente de como eles funcionam:
- Alucinação. O modelo gera o texto mais plausível, e plausível não é o mesmo que verdadeiro. Sem a informação no contexto, ele pode inventar com segurança um número, uma citação ou uma função de biblioteca que não existe.
- Conhecimento datado. O que aconteceu depois do fim do treinamento não existe para o modelo, a não ser que entre pelo contexto.
- Contas e detalhes de caracteres. Aritmética longa, contagem de letras e comparação de números com muitas casas são frágeis. A boa prática é delegar essas tarefas a código.
- Contextos longos e confusos. Informação importante no meio de um contexto enorme pode receber menos atenção do que deveria.
- Injeção de instruções. Um texto malicioso dentro de um documento ou página pode tentar dar ordens ao modelo. Tudo o que vem de fora deve ser tratado como dado, nunca como instrução.
- Variação. A mesma pergunta pode gerar respostas diferentes, e pequenas mudanças no texto do pedido podem mudar o resultado.
Nenhum desses problemas impede o uso sério. Eles definem como usar: dar ao modelo a informação de que ele precisa, validar o que ele produz e manter uma pessoa no circuito quando a decisão importa.
Adaptando um LLM ao seu caso
Existem três formas principais de fazer um modelo pronto trabalhar com o contexto da sua empresa, e a ordem em que aparecem é também a ordem em que vale tentar.
1. Prompt: pedir melhor
A forma mais barata de melhorar uma resposta é melhorar o pedido. Um bom prompt diz quem o modelo deve ser, qual é a tarefa, qual o contexto, o formato da saída e o que fazer na dúvida. Exemplos concretos valem mais que adjetivos:
Você classifica chamados de suporte de um ERP de varejo.

Categorias possíveis: financeiro, estoque, fiscal, acesso, outro.
Responda apenas com JSON no formato {"categoria": "...", "urgente": true|false}.
Considere urgente o que impede faturar ou receber.
Se o texto não der informação suficiente, use "outro".

Chamado: "Desde cedo a rotina de boletos não gera o arquivo e o caixa está parado."
Pedir saída estruturada, como JSON, e validar essa saída no código antes de usá-la é uma das práticas mais importantes em produção. Vários provedores oferecem modos que garantem que a resposta siga um esquema definido.
2. RAG: dar o material
Quando a resposta depende de informação que o modelo não tem, como manuais internos, contratos ou dados de clientes, a solução mais usada é a geração aumentada por recuperação (retrieval-augmented generation, RAG). Em vez de esperar que o modelo saiba, o sistema busca os trechos relevantes e os coloca no contexto junto com a pergunta.
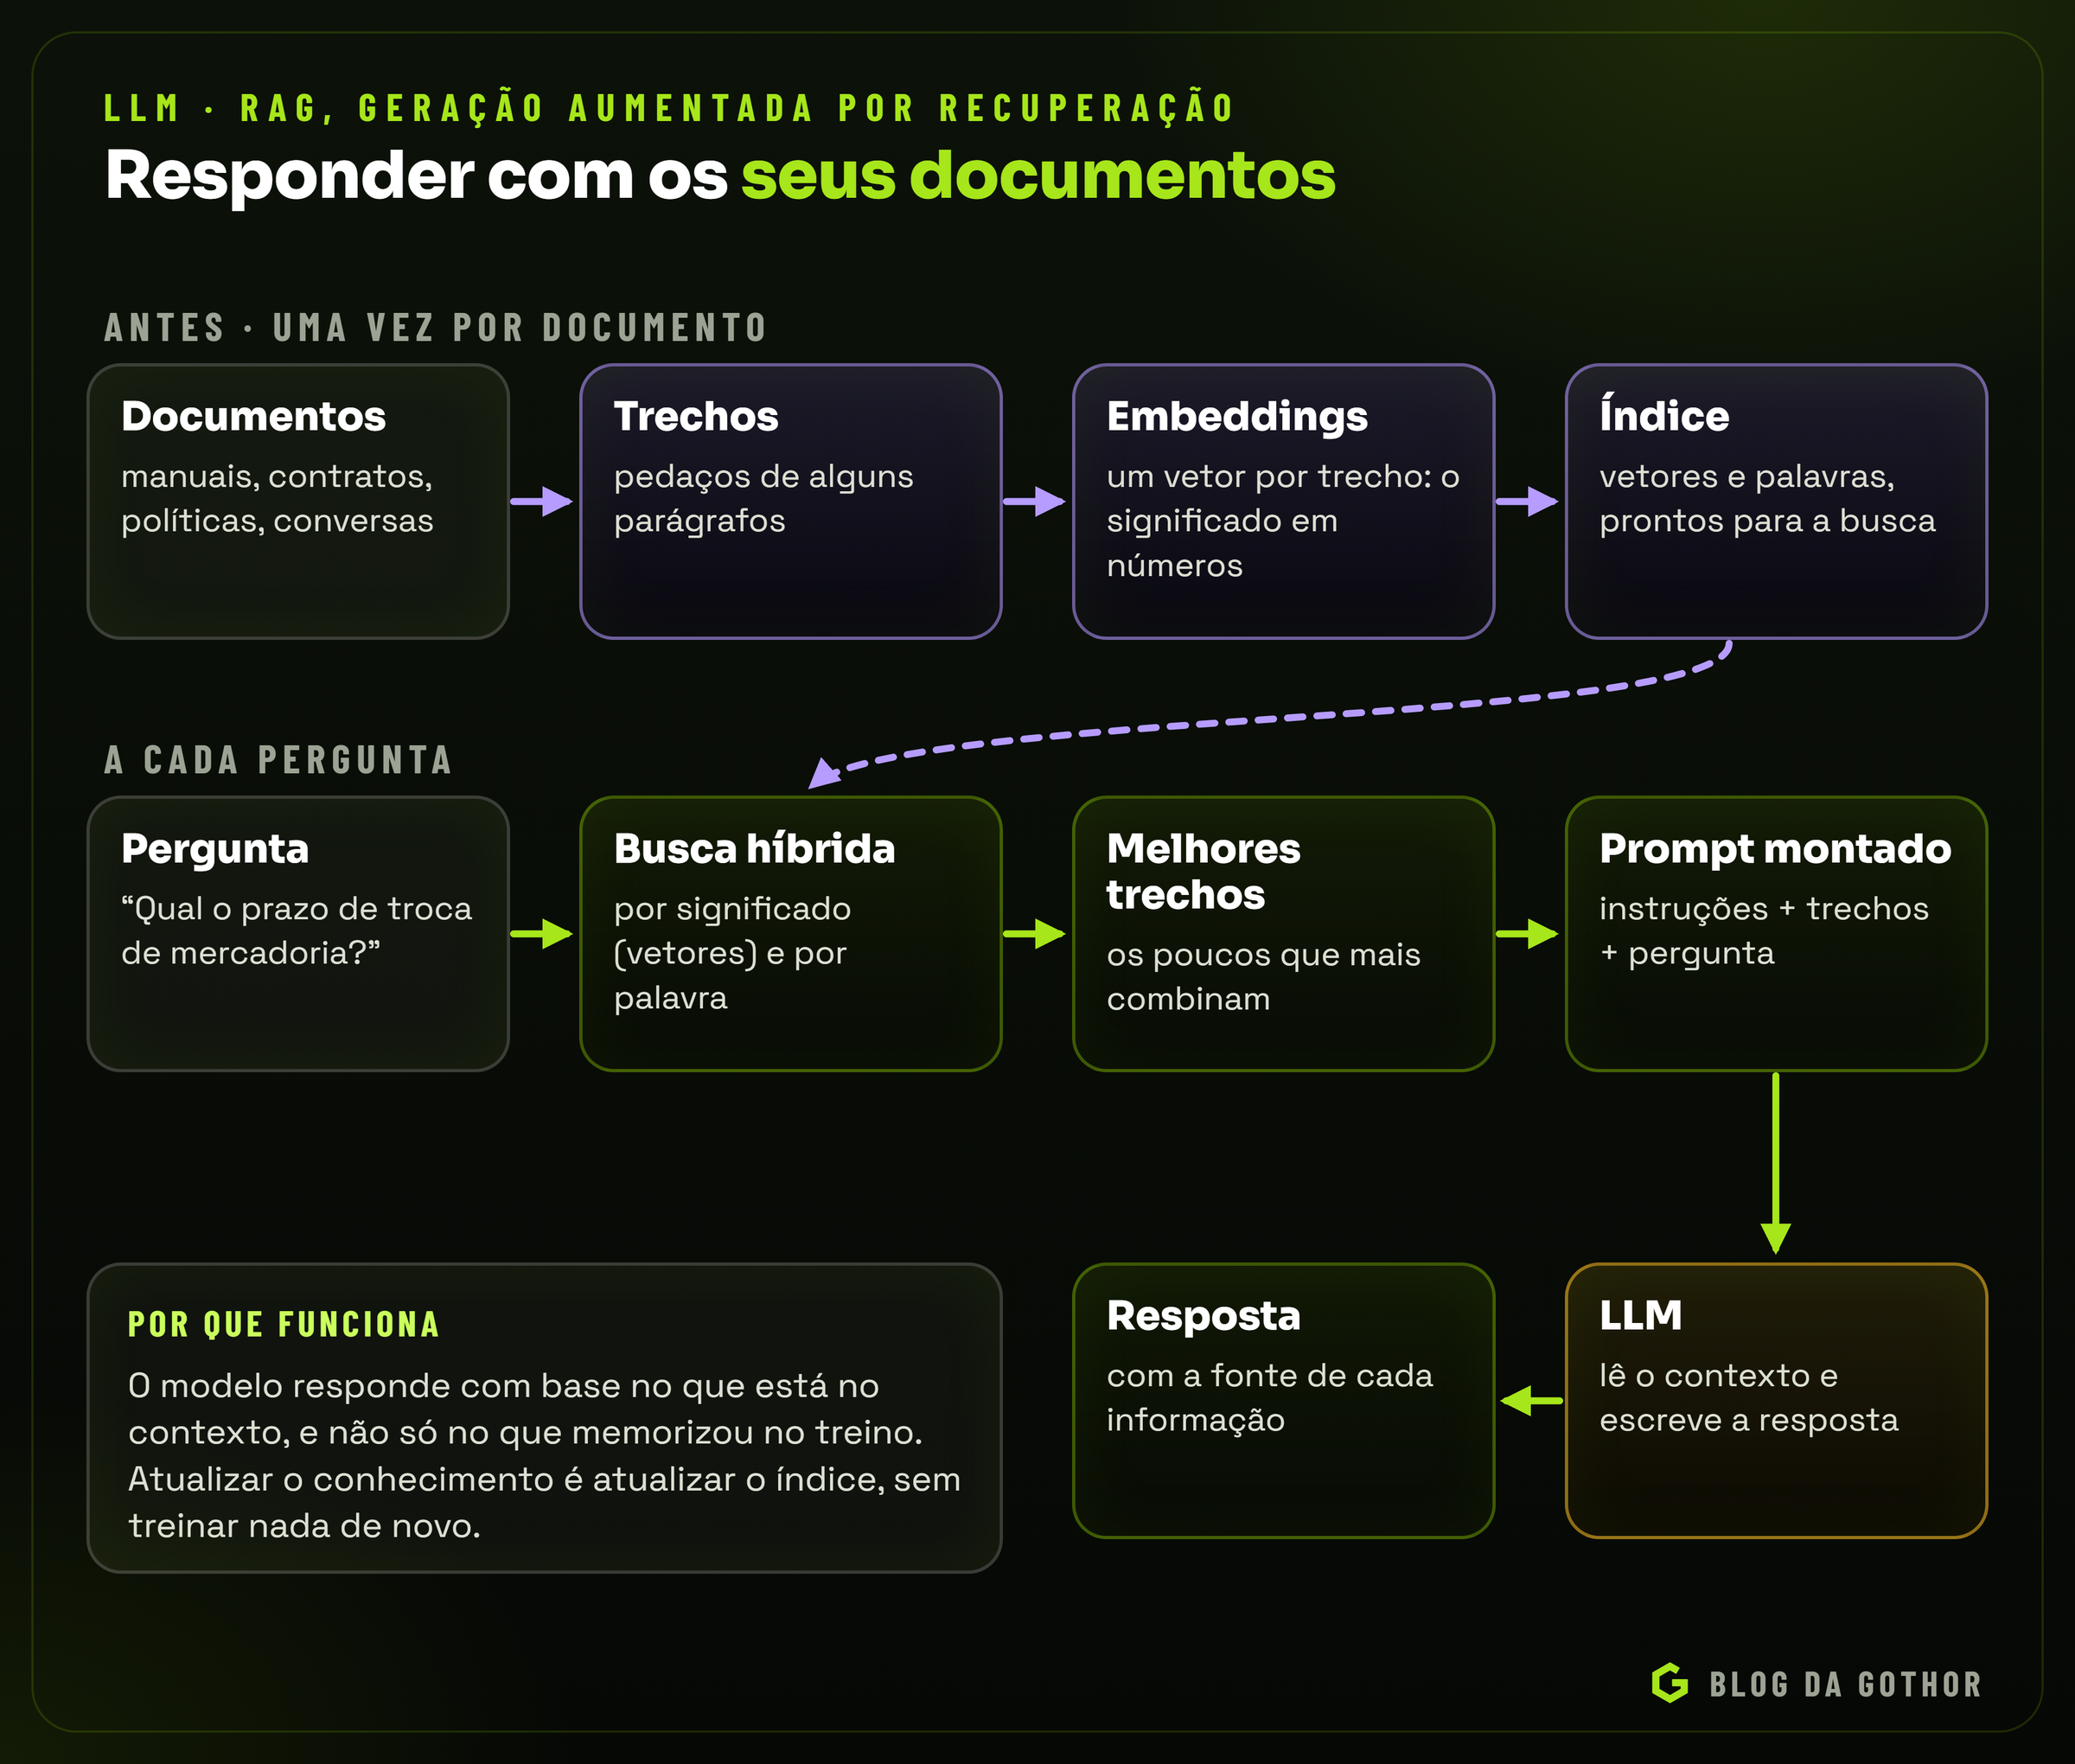
O fluxo tem duas metades. Antes, cada documento é dividido em trechos e cada trecho vira um embedding, guardado num índice. A cada pergunta, a pergunta também vira um embedding, o sistema busca os trechos mais parecidos (de preferência combinando busca por significado com busca por palavra, a chamada busca híbrida), monta o prompt com as instruções, os trechos e a pergunta, e o modelo responde citando as fontes.
As vantagens são grandes: atualizar o conhecimento é atualizar o índice, sem treinar nada; as respostas podem ser verificadas; e cada pessoa pode receber só os trechos que tem permissão de ver. A qualidade depende muito de detalhes como o tamanho dos trechos, a qualidade da busca e a instrução de responder "não sei" quando os trechos não cobrem a pergunta. Por isso, sistemas de RAG sérios são medidos com um conjunto de perguntas e respostas esperadas.
3. Ajuste fino: treinar mais
O ajuste fino (fine-tuning) continua o treinamento do modelo com exemplos seus, alterando os pesos. Técnicas como LoRA treinam só uma pequena fração de parâmetros extras, o que barateia muito o processo. O ajuste fino é bom para ensinar um estilo, um formato fixo ou uma tarefa estreita e repetitiva, e para fazer um modelo menor e mais barato executar bem algo que antes exigia um modelo grande. Ele não é a melhor forma de ensinar fatos que mudam: para isso, RAG é mais barato, mais rápido de atualizar e mais fácil de auditar.
Ferramentas e agentes
A fronteira mais recente é deixar o modelo agir. Com o recurso de uso de ferramentas (tool use ou function calling), a aplicação descreve funções disponíveis, como "consultar pedido" ou "emitir segunda via", e o modelo pode responder com um pedido estruturado para chamar uma delas. A aplicação executa a função, devolve o resultado e o modelo continua. Repetido em laço, isso forma um agente:
// Esboço de um laço de agente, independente de provedor.
let mensagens = [{ papel: 'usuario', texto: pergunta }];
for (let passo = 0; passo < 8; passo++) {          // sempre com um limite de passos
  const resposta = await modelo.responder(mensagens, ferramentas);
  if (!resposta.chamadaDeFerramenta) return resposta.texto;
  const { nome, argumentos } = resposta.chamadaDeFerramenta;
  if (precisaDeAprovacao(nome)) await pedirAprovacaoHumana(nome, argumentos);
  const resultado = await executar(nome, argumentos);  // validado e com permissão do usuário
  mensagens.push(resposta.mensagem, { papel: 'ferramenta', nome, texto: resultado });
}
throw new Error('O agente não concluiu dentro do limite de passos.');
Três cuidados aparecem no próprio esboço: limite de passos, aprovação humana para ações com efeito real e permissões verificadas pela aplicação, e não pelo modelo. Para padronizar a conexão entre modelos e ferramentas, o mercado vem adotando o Model Context Protocol (MCP), um protocolo aberto que permite que o mesmo servidor de ferramentas seja usado por diferentes aplicações de IA.
Nuvem ou local?
Há duas formas de ter um LLM à disposição, e elas se complementam.
| Critério | Modelo na nuvem, por API | Modelo local, com pesos abertos |
|---|---|---|
| Exemplos | Claude, GPT, Gemini | Gemma, Llama, Qwen, gpt-oss |
| Qualidade | os modelos mais capazes | muito bons em tarefas do dia a dia, abaixo dos maiores em tarefas difíceis |
| Custo | por token, sem investimento inicial | o hardware; cada resposta sai praticamente de graça |
| Privacidade | os dados vão ao provedor, conforme o contrato | os dados não saem da máquina |
| Disponibilidade | depende da internet e de cotas | funciona offline |
| Operação | nenhuma infraestrutura | baixar, atualizar e servir o modelo |
Rodar localmente ficou viável graças à quantização: guardar os pesos com menos bits, por exemplo 4 bits em vez de 16, com perda pequena de qualidade. Uma conta útil para estimar a memória de vídeo necessária é multiplicar o número de parâmetros pelos bytes por parâmetro. Um modelo de 12 bilhões de parâmetros em 4 bits ocupa algo em torno de 6 a 7 GB, mais a memória do contexto. Projetos como o llama.cpp, que usa o formato de arquivo GGUF, e ferramentas como o Ollama tornaram simples servir esses modelos numa placa de vídeo comum, e até no processador.
Como usamos LLMs na Gothor
A Juniper, a assistente de IA da Gothor, está no CRM, no celular (Android) e no computador (Windows). Ela é o nosso laboratório de uso real de LLMs, e o desenho segue uma ideia simples: local quando dá, nuvem quando precisa.
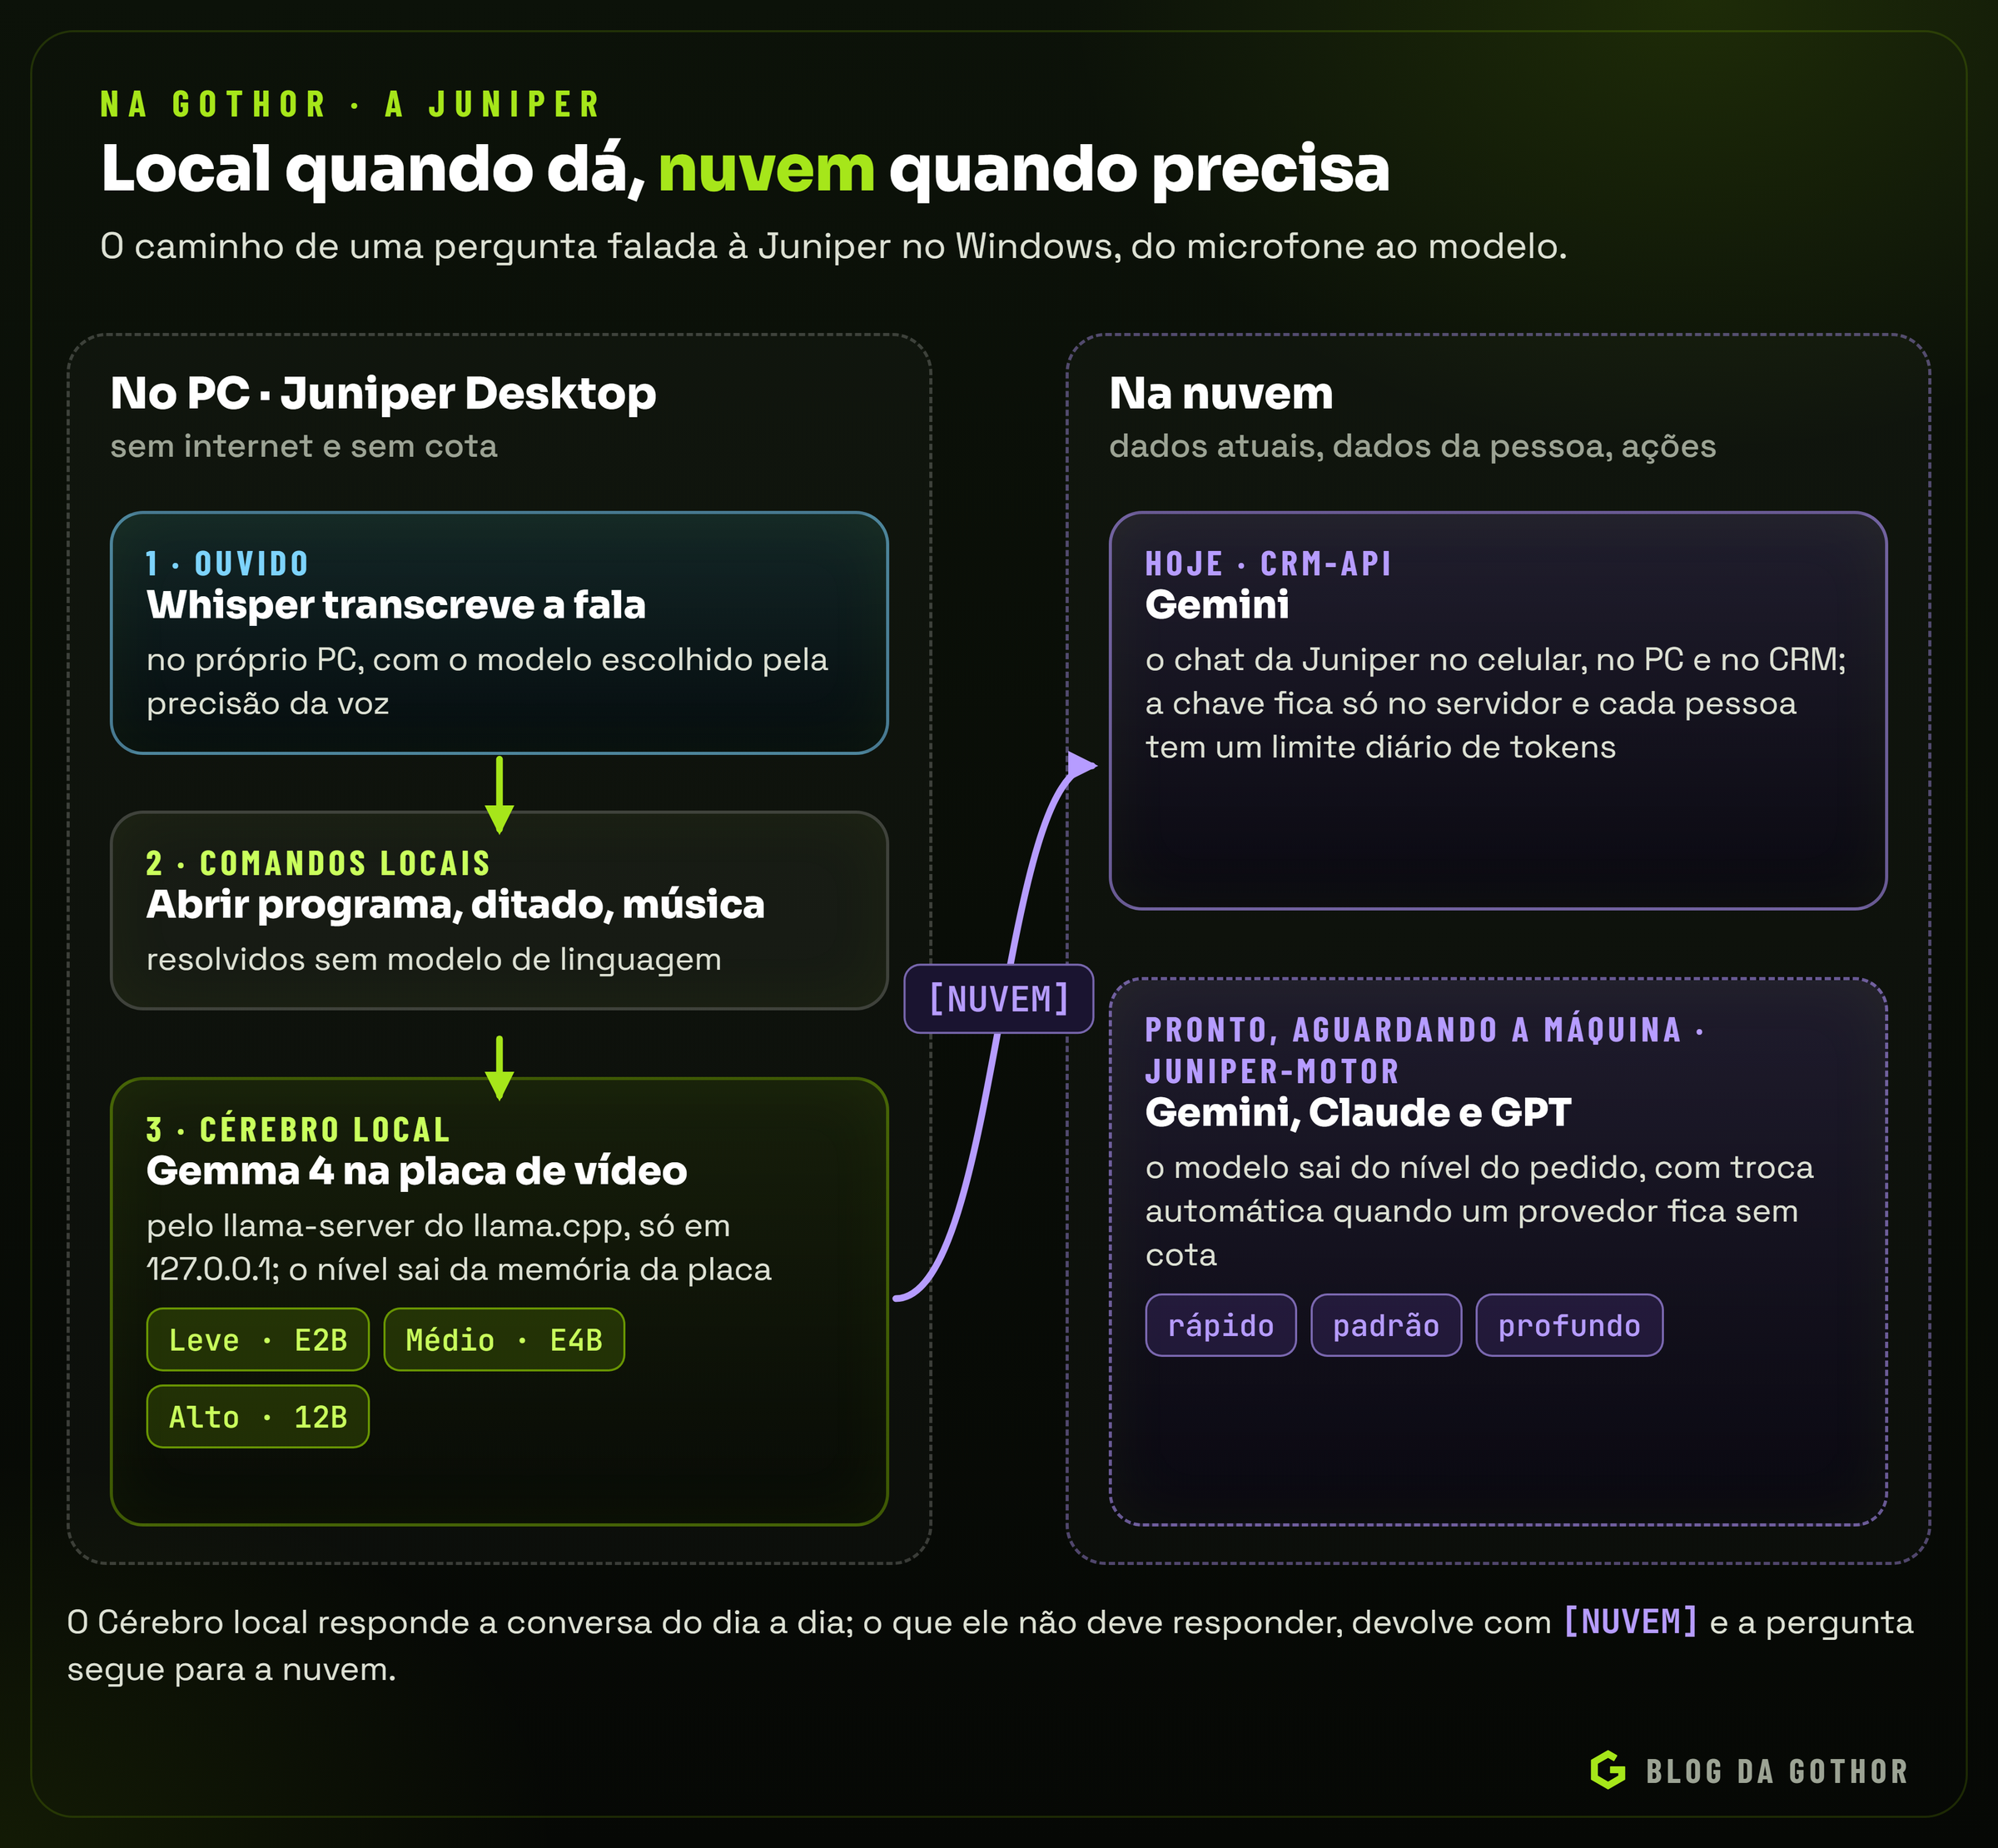
A voz é transcrita no próprio computador. No app do Windows, a fala é convertida em texto pelo Whisper, o modelo de reconhecimento de fala da OpenAI, rodando localmente pelo whisper.cpp, sem internet e sem custo por uso. A pessoa escolhe a precisão: há um modo só para comandos, com o reconhecedor offline do próprio Windows, e três níveis do Whisper, do modelo pequeno, que roda no processador, ao maior, que usa a placa de vídeo.
Comandos simples nem chegam a um LLM. Abrir um programa ou um site, pesquisar, ligar o ditado e controlar a música são resolvidos por comandos locais, que vêm antes de qualquer modelo. Usar um modelo de linguagem para o que uma regra resolve seria gastar tempo e dinheiro à toa.
O Cérebro local responde a conversa do dia a dia. O app do Windows roda um Gemma 4, modelo de pesos abertos do Google, na placa de vídeo do próprio PC, pelo servidor do llama.cpp, acessível só pela própria máquina (127.0.0.1). O tamanho do modelo é escolhido automaticamente pela memória da placa, em três níveis, com versões quantizadas em 4 bits. Os arquivos são baixados uma vez e conferidos pelo hash SHA-256. Um detalhe que só a medição revelou: o "modo pensando" do modelo fica desligado, porque, ligado, até um simples cumprimento levava alguns segundos de raciocínio antes da resposta.
O que precisa de mais, vai para a nuvem. O Cérebro local foi instruído a não responder o que depende de dados atuais, de dados da pessoa, de ações no sistema ou de programação. Nesses casos ele devolve a marca [NUVEM], e a pergunta segue para um modelo na nuvem. Hoje, o chat da Juniper passa pela API do CRM e usa o Gemini. A chave do provedor fica só no servidor, nunca no app; cada pessoa tem um limite diário de tokens; e só as falas mais recentes da conversa vão para o modelo, o que controla o custo sem perder o fio.
O próximo passo já está pronto. O juniper-motor, o serviço que vai concentrar a inteligência da Juniper, já fala com Gemini, Claude e GPT e escolhe o modelo pelo nível de cada pedido: rápido para perguntas curtas, padrão para o restante e profundo para tarefas longas e difíceis. Quem decide o nível é um classificador de regras, sem chamar nenhum modelo, o que custa microssegundos e dá sempre o mesmo resultado para o mesmo pedido. Quando um provedor fica sem cota, o motor troca automaticamente para o próximo. Ele também responde em streaming, consulta o CRM por ferramentas num laço de agente com limites, usa cache de prompt no Claude e pode contar com um orquestrador local, o gpt-oss-20b, na placa de vídeo. O motor e a memória de longo prazo, com busca por palavras e por significado e documentos em trechos para RAG, aguardam a máquina própria da Juniper para entrar no ar.
E este artigo? Como todo post deste blog, ele passa por revisão humana antes de ser publicado. A lista de tecnologias que deu origem a esta série, o Wisdom, também é mantida pela equipe dentro da Juniper.
Boas práticas para levar um LLM à produção
- Chaves no servidor. O app nunca deve carregar a chave do provedor. Uma API intermediária controla acesso, limites e registro.
- Limites e custo visíveis. Limite diário por pessoa, histórico enxuto e métricas de tokens por requisição evitam surpresas na fatura.
- Saída estruturada e validada. Quando o resultado vai para outro sistema, peça um formato definido e valide antes de usar.
- Dados do usuário como dados. Texto que vem de documentos, e-mails ou páginas nunca deve ser tratado como instrução para o modelo.
- Pessoas no circuito. Ações com efeito real, como enviar, pagar, excluir ou publicar, pedem confirmação.
- Alternativas. Provedores ficam fora do ar e cotas acabam. Ter um segundo modelo configurado mantém o serviço de pé.
- Avaliação contínua. Um conjunto fixo de perguntas com respostas esperadas permite medir se uma troca de modelo ou de prompt melhorou ou piorou o resultado.
- Privacidade. Envie ao modelo só o necessário, conheça os termos de uso de dados do provedor e prefira processamento local para o que é sensível.
Erros comuns
- Tratar o LLM como fonte de verdade. Sem o dado no contexto, a resposta é uma estimativa plausível. Para fatos, use RAG ou consulte o sistema de origem.
- Usar o maior modelo para tudo. A maior parte das tarefas do dia a dia é bem resolvida por modelos menores, mais rápidos e mais baratos. Reserve os maiores para o que exige raciocínio.
- Prompt vago. "Melhore este texto" deixa o modelo adivinhar o que é melhor. Diga o objetivo, o público, o tom e o formato.
- Contexto entulhado. Mais texto não é mais qualidade. Envie o que é relevante, organizado, com as instruções no começo.
- Pular a avaliação. Sem medir, cada ajuste vira opinião.
- Dar ferramentas sem limites. Um agente sem limite de passos, sem permissões e sem aprovação humana para ações sensíveis é um risco operacional.
Resumo
- Um LLM é uma rede neural treinada para prever o próximo token; responder, resumir e programar saem dessa operação repetida.
- O texto vira tokens, os tokens viram embeddings, a pilha de camadas Transformer usa atenção para relacionar cada token com os anteriores, e o resultado são probabilidades para o próximo token.
- Temperatura, top-p e top-k controlam o quanto a escolha do próximo token arrisca.
- O treinamento tem pré-treino, ajuste por instruções e alinhamento por preferências.
- Alucinação, conhecimento datado e fragilidade com contas são consequências do funcionamento, e se contornam com contexto, validação e código.
- Para adaptar um modelo, tente nesta ordem: prompt, RAG e ajuste fino. Ferramentas transformam o modelo em agente, com limites e aprovações.
- Nuvem e local se complementam: os maiores modelos por API, e modelos abertos quantizados para o que precisa ser rápido, barato, privado ou offline.
Para ir além
- Introdução aos modelos de linguagem grandes, do curso de machine learning do Google.
- Attention Is All You Need, o artigo que apresentou o Transformer.
- Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks, o artigo que deu nome ao RAG.
- Resumo dos tokenizadores e o curso de LLMs da Hugging Face.
- Documentação dos provedores: Claude, OpenAI e Gemini.
- Modelos e execução local: Gemma, llama.cpp, Whisper e whisper.cpp.
- Model Context Protocol, o protocolo aberto para conectar modelos a ferramentas.
Este post foi escrito com a ajuda da Juniper, a assistente de IA da Gothor, e revisado pela nossa equipe antes de ir ao ar.