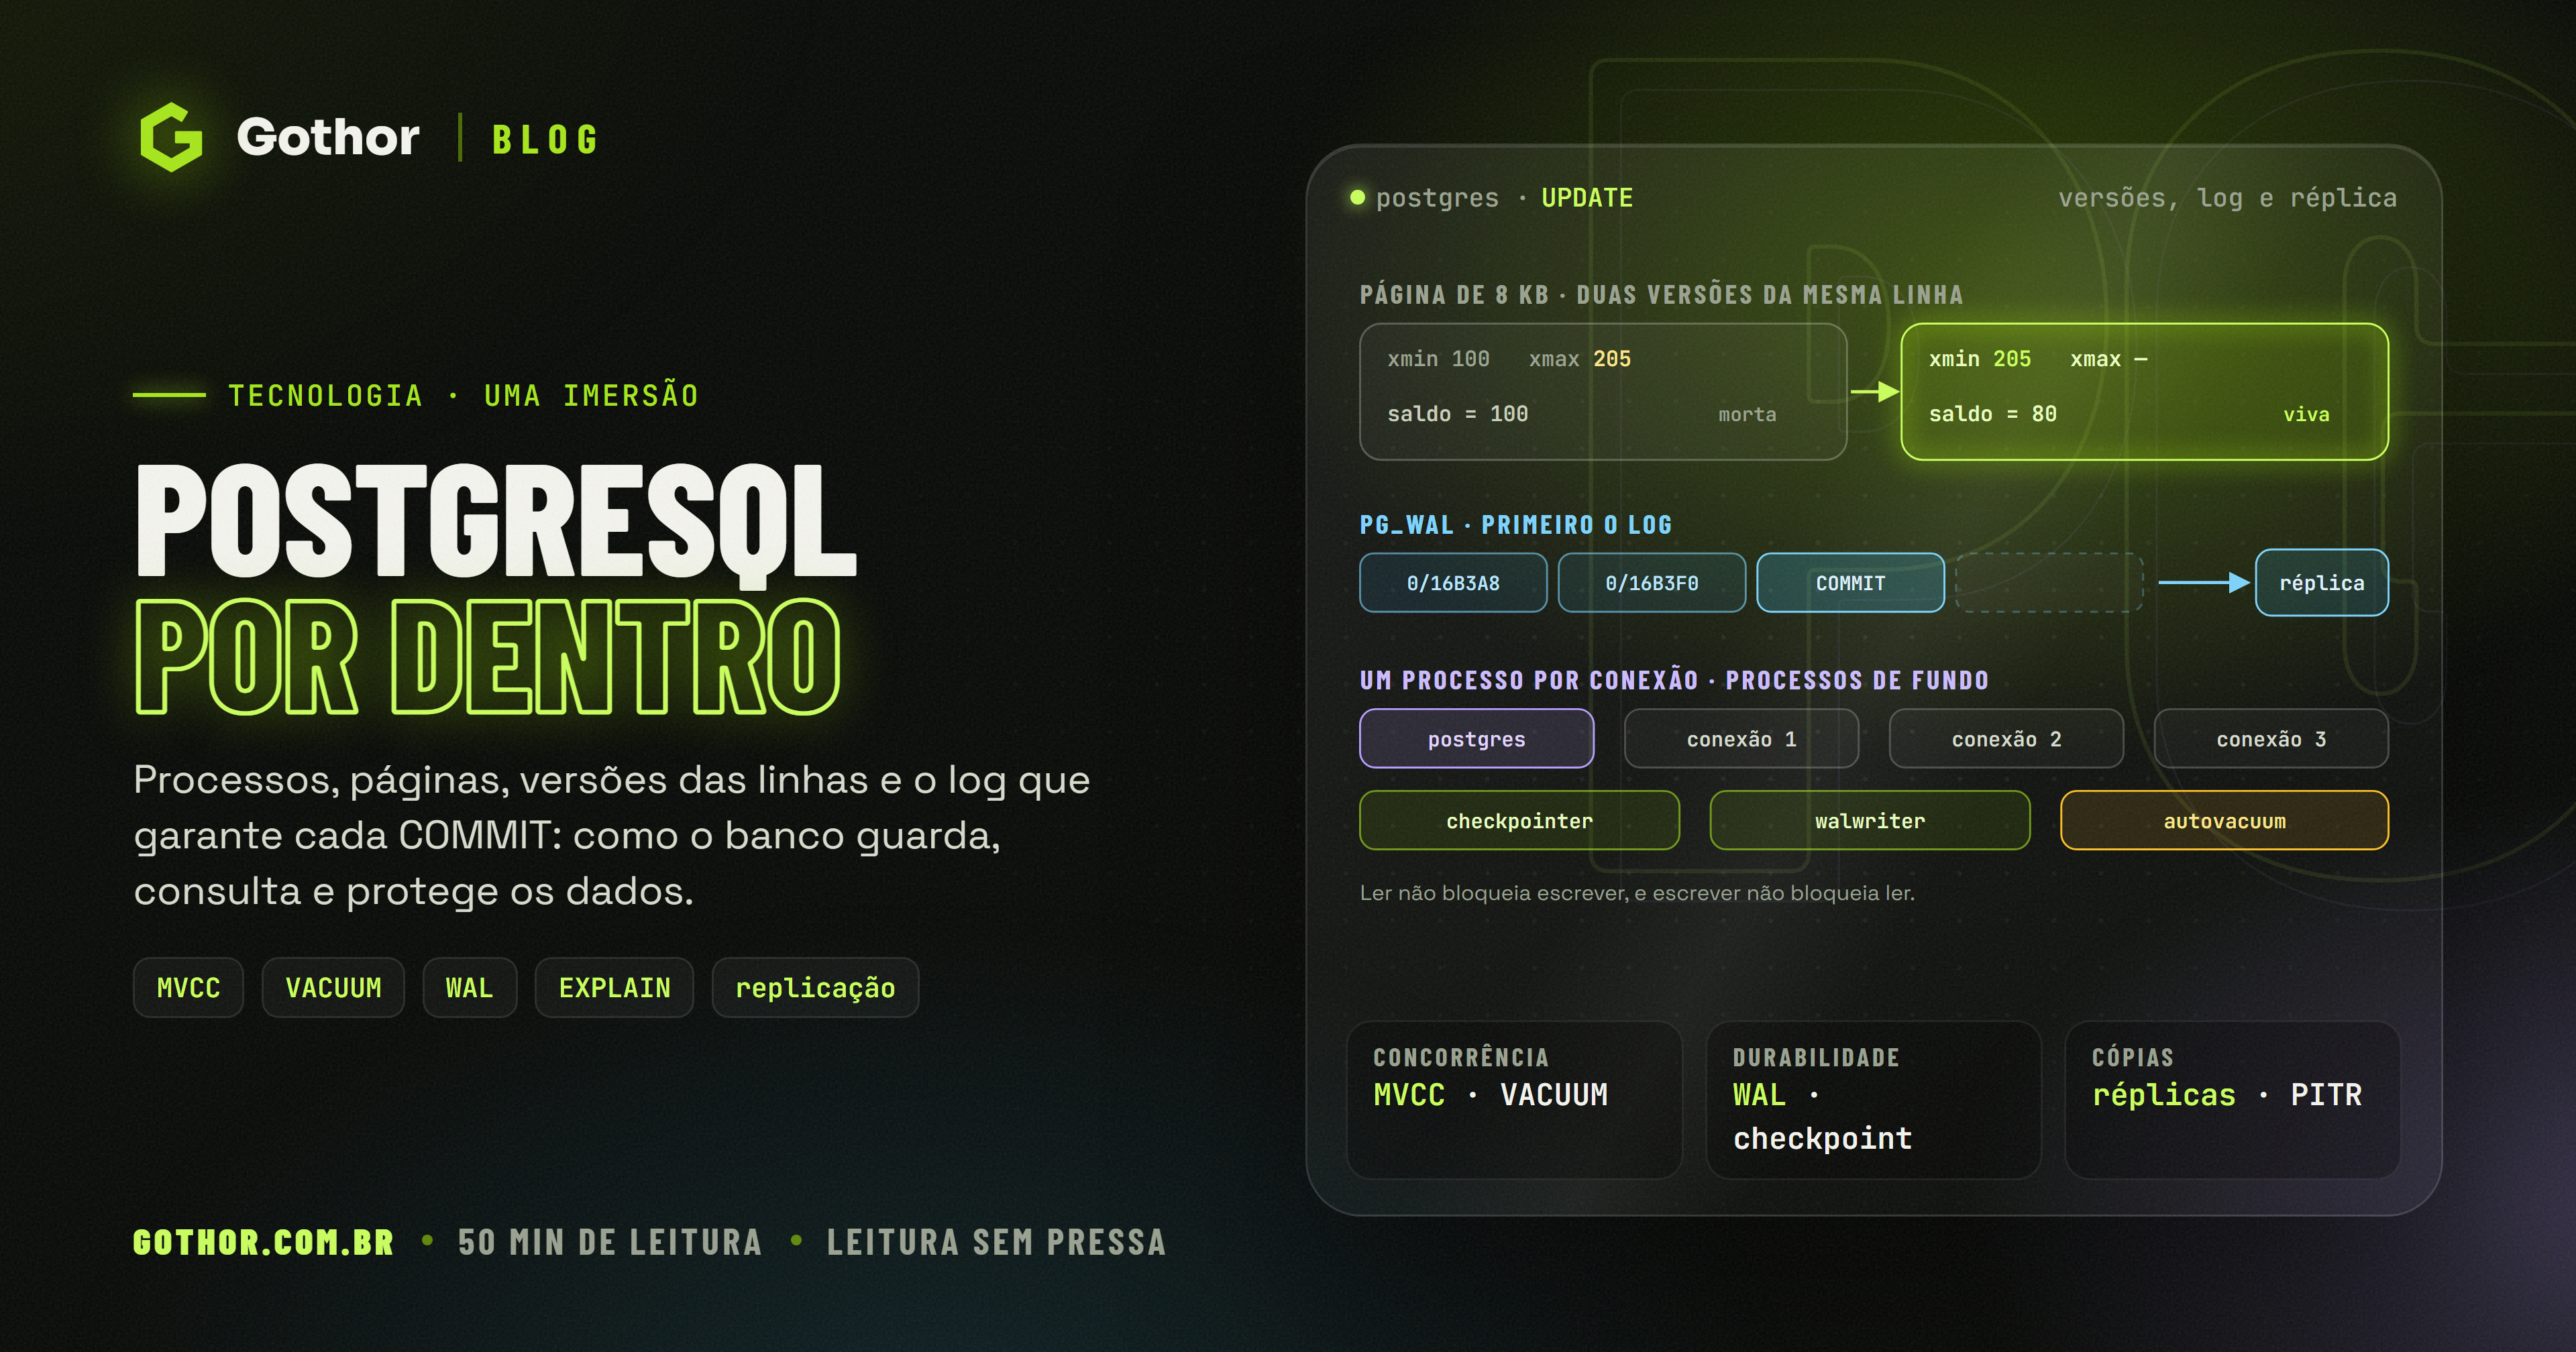
PostgreSQL por dentro: MVCC, WAL, VACUUM e replicação
Uma imersão no PostgreSQL, dos processos e das páginas no disco ao MVCC, ao VACUUM, ao WAL e à replicação, com índices, extensões e os erros mais comuns.
Um pedido gravado duas vezes porque o sistema caiu no meio da confirmação. Um relatório que leva minutos para abrir numa tabela que não parece tão grande. Um disco que enche numa madrugada sem que ninguém tenha guardado arquivo nenhum. Um servidor que recusa conexões novas às dez da manhã de uma segunda-feira. Quem cuida de sistemas com banco de dados já viu algum desses problemas, e quase todos têm a mesma origem: o banco foi tratado como uma caixa-preta que guarda tabelas, e não como o programa que ele é, com processos, memória, arquivos e regras próprias.
O PostgreSQL é um dos bancos de dados mais usados em sistemas novos, de pequenos serviços a plataformas que guardam terabytes. É gratuito, de código aberto, segue de perto o padrão SQL e se deixa estender com tipos, funções e índices novos. Essa combinação explica a popularidade, mas não poupa ninguém de entender como ele funciona: as decisões que deixam o PostgreSQL seguro e rápido, como guardar várias versões de cada linha ou gravar tudo num log antes de mexer nos arquivos, também explicam a maior parte das surpresas de quem o opera.
Este artigo é uma imersão no PostgreSQL, de dentro para fora: a história, os processos e a memória do servidor, as páginas do disco e o caminho de uma consulta; depois, os três mecanismos que sustentam tudo, o MVCC, o VACUUM e o WAL, e o que eles permitem, como a replicação e a recuperação até um ponto no tempo. No caminho, as consultas paralelas e as travas. Por fim, os índices, o JSONB, a busca textual, as extensões, a segurança, as versões, os erros mais comuns e o jeito como a Gothor usa o PostgreSQL.
O que é o PostgreSQL
O PostgreSQL é um sistema gerenciador de banco de dados objeto-relacional de código aberto, que usa e estende a linguagem SQL [4]. "Relacional" porque os dados ficam em tabelas, ligadas por chaves e consultadas com SQL; "objeto" porque o modelo vai além das tabelas simples: aceita tipos definidos pelo usuário, herança de tabelas, funções escritas em várias linguagens e operadores novos. A própria documentação resume a ideia de extensibilidade com três exemplos: definir os próprios tipos de dados, escrever funções sob medida e usar código de outras linguagens sem recompilar o banco [4].
Ele é distribuído sob a PostgreSQL License, uma licença livre e permissiva, parecida com a BSD e a MIT, que permite usar, copiar, modificar e distribuir o software para qualquer fim, sem custo e sem contrato, desde que o aviso de direitos autorais acompanhe as cópias [5]. Nenhuma empresa é dona do PostgreSQL. O projeto é mantido pelo PostgreSQL Global Development Group, uma comunidade de desenvolvedores, muitos deles pagos por empresas diferentes, e os direitos autorais são divididos entre esse grupo, desde 1996, e a Universidade da Califórnia, pelo código de 1994 [5]. Por isso existem tantas distribuições e serviços gerenciados com o mesmo motor por baixo: o código é o mesmo para todos.
Na conformidade com o padrão, o PostgreSQL atende pelo menos 170 dos 177 recursos obrigatórios do núcleo do SQL:2023, e a mesma página lembra que nenhum banco declarava conformidade total com esse núcleo [37]. Na prática, quem aprende SQL no PostgreSQL leva quase tudo para outros bancos.
O servidor roda no Linux, no Windows e no macOS e escuta por padrão na porta TCP 5432 [34]. Um mesmo servidor, que a documentação chama de cluster de banco de dados, guarda vários bancos; cada banco tem seus schemas, que são como pastas para tabelas e funções; e as permissões são dadas a roles, que fazem o papel de usuários e de grupos.
Uma história curta
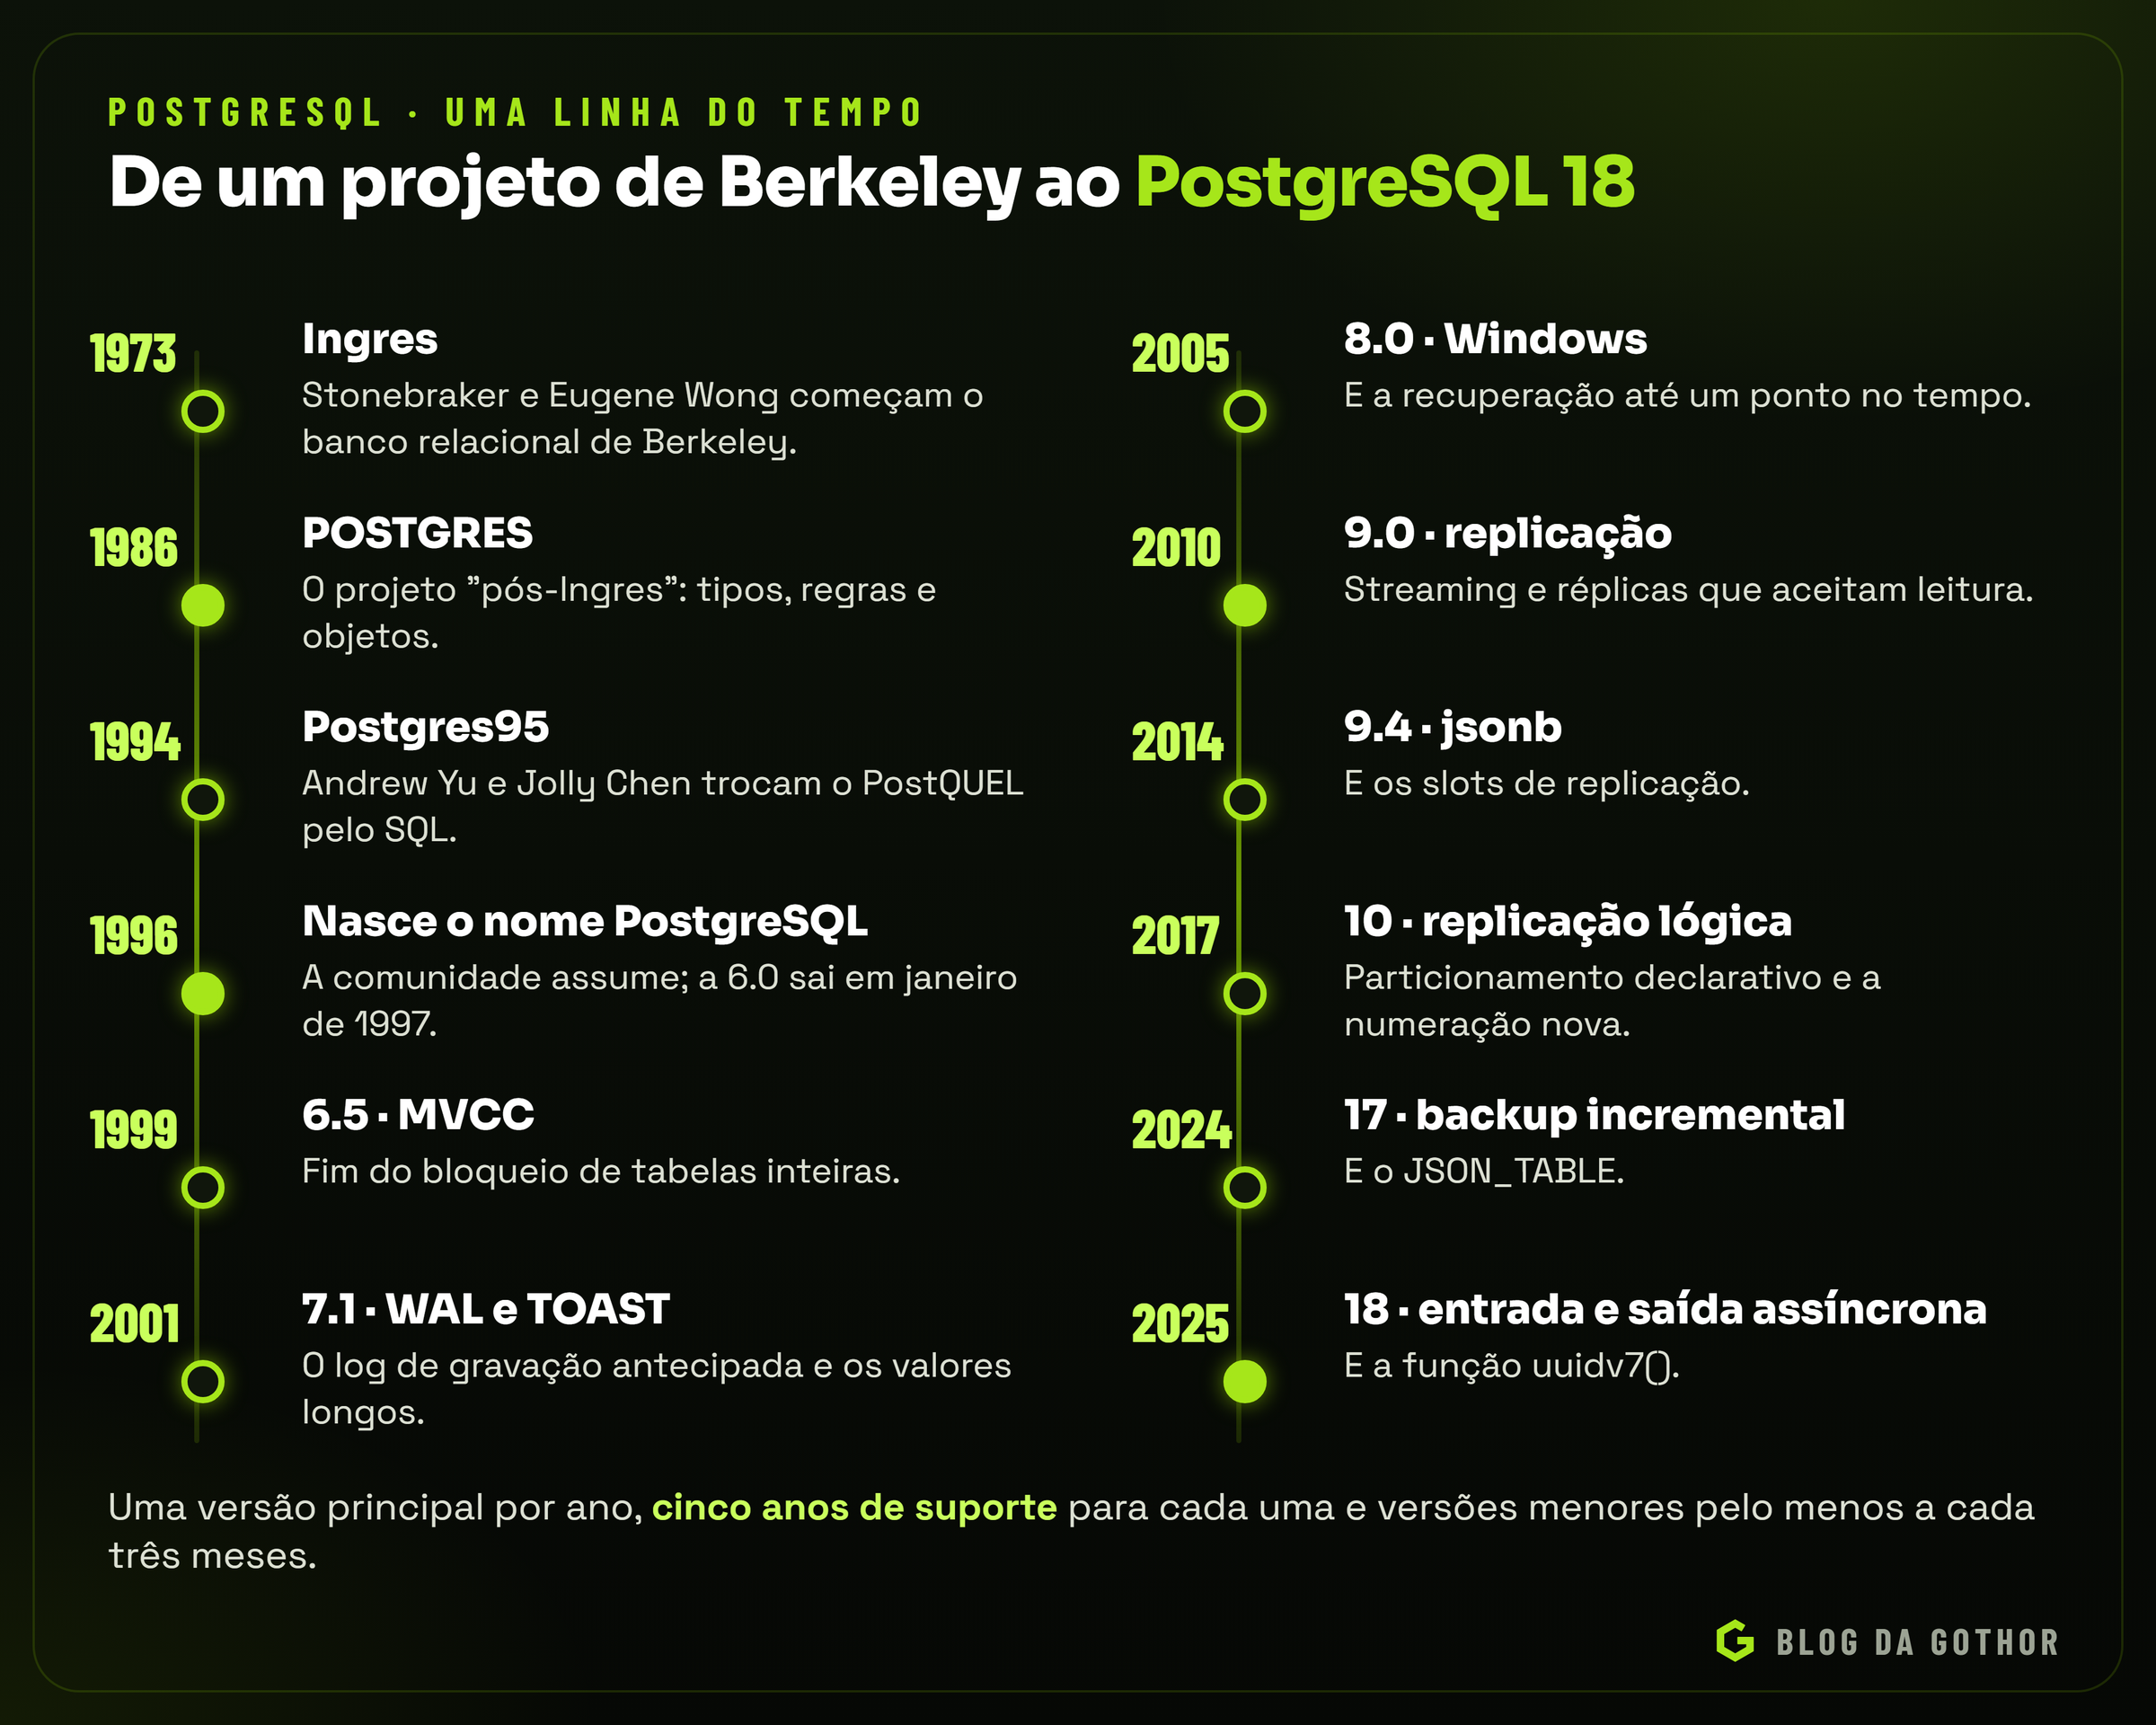
A história do PostgreSQL começa na Universidade da Califórnia em Berkeley, com o Ingres, um dos primeiros sistemas relacionais, iniciado em 1973 por Michael Stonebraker e Eugene Wong [3]. Stonebraker deixou a universidade em 1982 para levar o Ingres ao mercado e, de volta a Berkeley em 1985, começou um projeto "pós-Ingres" para resolver o que os bancos relacionais da época não resolviam bem: tipos de dados complexos, regras e relações entre objetos [2].
O projeto se chamou POSTGRES (de "post-Ingres") e começou a ser implementado em 1986, com patrocínio da DARPA, do Army Research Office, da National Science Foundation e da ESL [1]. A versão 1 chegou a alguns usuários externos em junho de 1989; a versão 2, com um sistema de regras novo, em junho de 1990; e a versão 3, em 1991 [1]. O código foi comercializado pela Illustra, depois incorporada pela Informix, e o esforço de dar suporte a uma comunidade que crescia levou Berkeley a encerrar o projeto na versão 4.2 [1].
A linguagem de consulta do POSTGRES não era SQL, mas o PostQUEL. Em 1994, dois estudantes, Andrew Yu e Jolly Chen, acrescentaram um interpretador de SQL ao código e o publicaram como Postgres95 [1]. A nova versão era escrita inteiramente em C ANSI, tinha 25% menos código e rodava de 30% a 50% mais rápido que o POSTGRES 4.2 no benchmark Wisconsin [1]. Em agosto de 1996, Marc Fournier, Bruce Momjian e Vadim B. Mikheev lançaram a primeira versão mantida fora de Berkeley [2], e no mesmo ano o projeto ganhou o nome que tem até hoje: PostgreSQL, para lembrar o POSTGRES original e a adoção do SQL. A numeração recomeçou na 6.0, continuando a sequência do projeto de Berkeley [1], e a versão 6.0 saiu em 29 de janeiro de 1997 [7].
Daí em diante, cada versão importante trouxe uma peça que hoje parece óbvia. A 6.5, de junho de 1999, trocou o antigo bloqueio de tabelas inteiras pelo MVCC, o controle de concorrência por múltiplas versões [7]. A 7.1, de abril de 2001, trouxe o WAL, o log de gravação antecipada, o TOAST, para valores longos, e as junções externas do SQL-92 [7]; desde 2001, o PostgreSQL atende às propriedades ACID [4]. A 8.0, de janeiro de 2005, foi a primeira a rodar nativamente no Windows, e trouxe ainda os savepoints, a recuperação até um ponto no tempo e os tablespaces [7]. A 8.1, no mesmo ano, levou o autovacuum para dentro do servidor e trocou usuários e grupos pelas roles [7].
A década seguinte foi a da replicação e dos tipos novos. A 9.0, de setembro de 2010, trouxe a replicação por streaming e o hot standby, as réplicas que aceitam consultas de leitura [7]. A 9.1, de 2011, a replicação síncrona, o CREATE EXTENSION, as tabelas externas e o isolamento serializável de verdade [7]. A 9.2, de 2012, o tipo json e as varreduras só de índice; a 9.4, de dezembro de 2014, o jsonb, os slots de replicação e a decodificação lógica; a 9.5, de janeiro de 2016, o INSERT ... ON CONFLICT, a segurança por linha e os índices BRIN [7].
A 10, de outubro de 2017, mudou a numeração: as versões passaram a ter duas partes, como 10.1, em vez de três, como 9.6.3 [7]. Ela trouxe também a replicação lógica por publicação e assinatura e o particionamento declarativo [7]. A 11, de 2018, os procedimentos com controle de transação, o particionamento por hash, a compilação JIT e os índices com colunas incluídas [7]. A 14, de 2021, passou a guardar as senhas novas com SCRAM-SHA-256 por padrão [7]. A 17, de setembro de 2024, trouxe o backup incremental e o JSON_TABLE [7]. A 18, de 25 de setembro de 2025, trouxe um subsistema de entrada e saída assíncrona, a função uuidv7(), a autenticação OAuth e as varreduras com salto em índices B-tree de várias colunas [7]. Em 15 de outubro de 2026, o projeto publicou a primeira versão candidata do PostgreSQL 19 [6].
Michael Stonebraker recebeu o Prêmio Turing de 2014 por suas contribuições à pesquisa em bancos de dados [3].
Os processos e a memória do servidor
O PostgreSQL usa o modelo cliente-servidor. Um processo servidor, o programa postgres, cuida dos arquivos do banco, aceita as conexões das aplicações e executa as operações em nome delas [8]. Do outro lado está o cliente: um programa com interface gráfica, a ferramenta de linha de comando psql, uma API escrita em Java, Node.js ou Python, ou qualquer outro programa que fale o protocolo do PostgreSQL. Cliente e servidor podem estar na mesma máquina ou em máquinas diferentes, ligados por TCP/IP [8].
O detalhe que mais influencia a operação é o modelo de processos. Para atender várias conexões ao mesmo tempo, o servidor cria um processo novo para cada conexão (um fork, no vocabulário do Unix); a partir daí, o cliente conversa só com esse processo, sem passar pelo processo original [8]. O processo principal, que a documentação chama em vários lugares de postmaster, fica sempre de pé esperando conexões; os processos de cada cliente nascem e morrem com as conexões [8].
Ao lado deles, o servidor mantém um grupo de processos de fundo. Uma listagem de processos de um PostgreSQL em funcionamento mostra, além do principal, o background writer, o checkpointer, o walwriter e o autovacuum launcher, e um processo por conexão, cujo título diz o usuário, o banco, o endereço e o que ele está fazendo [9]:
postgres  15551  postgres -i
postgres  15554  postgres: background writer
postgres  15555  postgres: checkpointer
postgres  15556  postgres: walwriter
postgres  15557  postgres: autovacuum launcher
postgres  15582  postgres: joe runbug 127.0.0.1 idle
postgres  15606  postgres: tgl regression [local] SELECT waiting
postgres  15610  postgres: tgl regression [local] idle in transaction
Cada um tem uma tarefa. O checkpointer faz os pontos de controle, que gravam no disco as páginas de dados alteradas; o background writer adianta parte dessa gravação aos poucos, para que os processos das conexões raramente precisem gravar páginas eles mesmos; o walwriter grava no disco o log de transações que está na memória; o autovacuum launcher distribui o trabalho de limpeza entre processos auxiliares, os autovacuum workers [9][18][21]. Com replicação, aparecem os processos que enviam e recebem o log, o walsender no servidor principal e o walreceiver na réplica [23]. E, desde o PostgreSQL 18, a leitura de dados pode ser feita por processos de entrada e saída assíncrona: o parâmetro io_method vem com o valor worker, e três processos io_workers cuidam das leituras por padrão [33].
A memória do servidor se divide em duas partes. A memória compartilhada é usada por todos os processos: nela ficam os shared buffers, o cache das páginas de tabelas e índices, os buffers do WAL e as estruturas de travas. O tamanho dos shared buffers vem de shared_buffers, que tem 128 MB por padrão; para um servidor dedicado ao banco com 1 GB de memória ou mais, a documentação sugere começar com 25% da memória da máquina [33]. Além disso, o PostgreSQL conta com o cache de arquivos do sistema operacional, que guarda as mesmas páginas uma segunda vez.
A outra parte é a memória de cada processo. O parâmetro work_mem, de 4 MB por padrão, limita a memória de cada operação de ordenação ou de tabela hash antes que ela passe a usar arquivos temporários no disco [33]. O detalhe importante é a palavra "cada": uma consulta pode ter várias dessas operações, e várias conexões podem executá-las ao mesmo tempo, então o consumo total pode ser muitas vezes o valor configurado [33]. Já o maintenance_work_mem, de 64 MB, vale para operações de manutenção como o VACUUM, o CREATE INDEX e a criação de chaves estrangeiras [33].
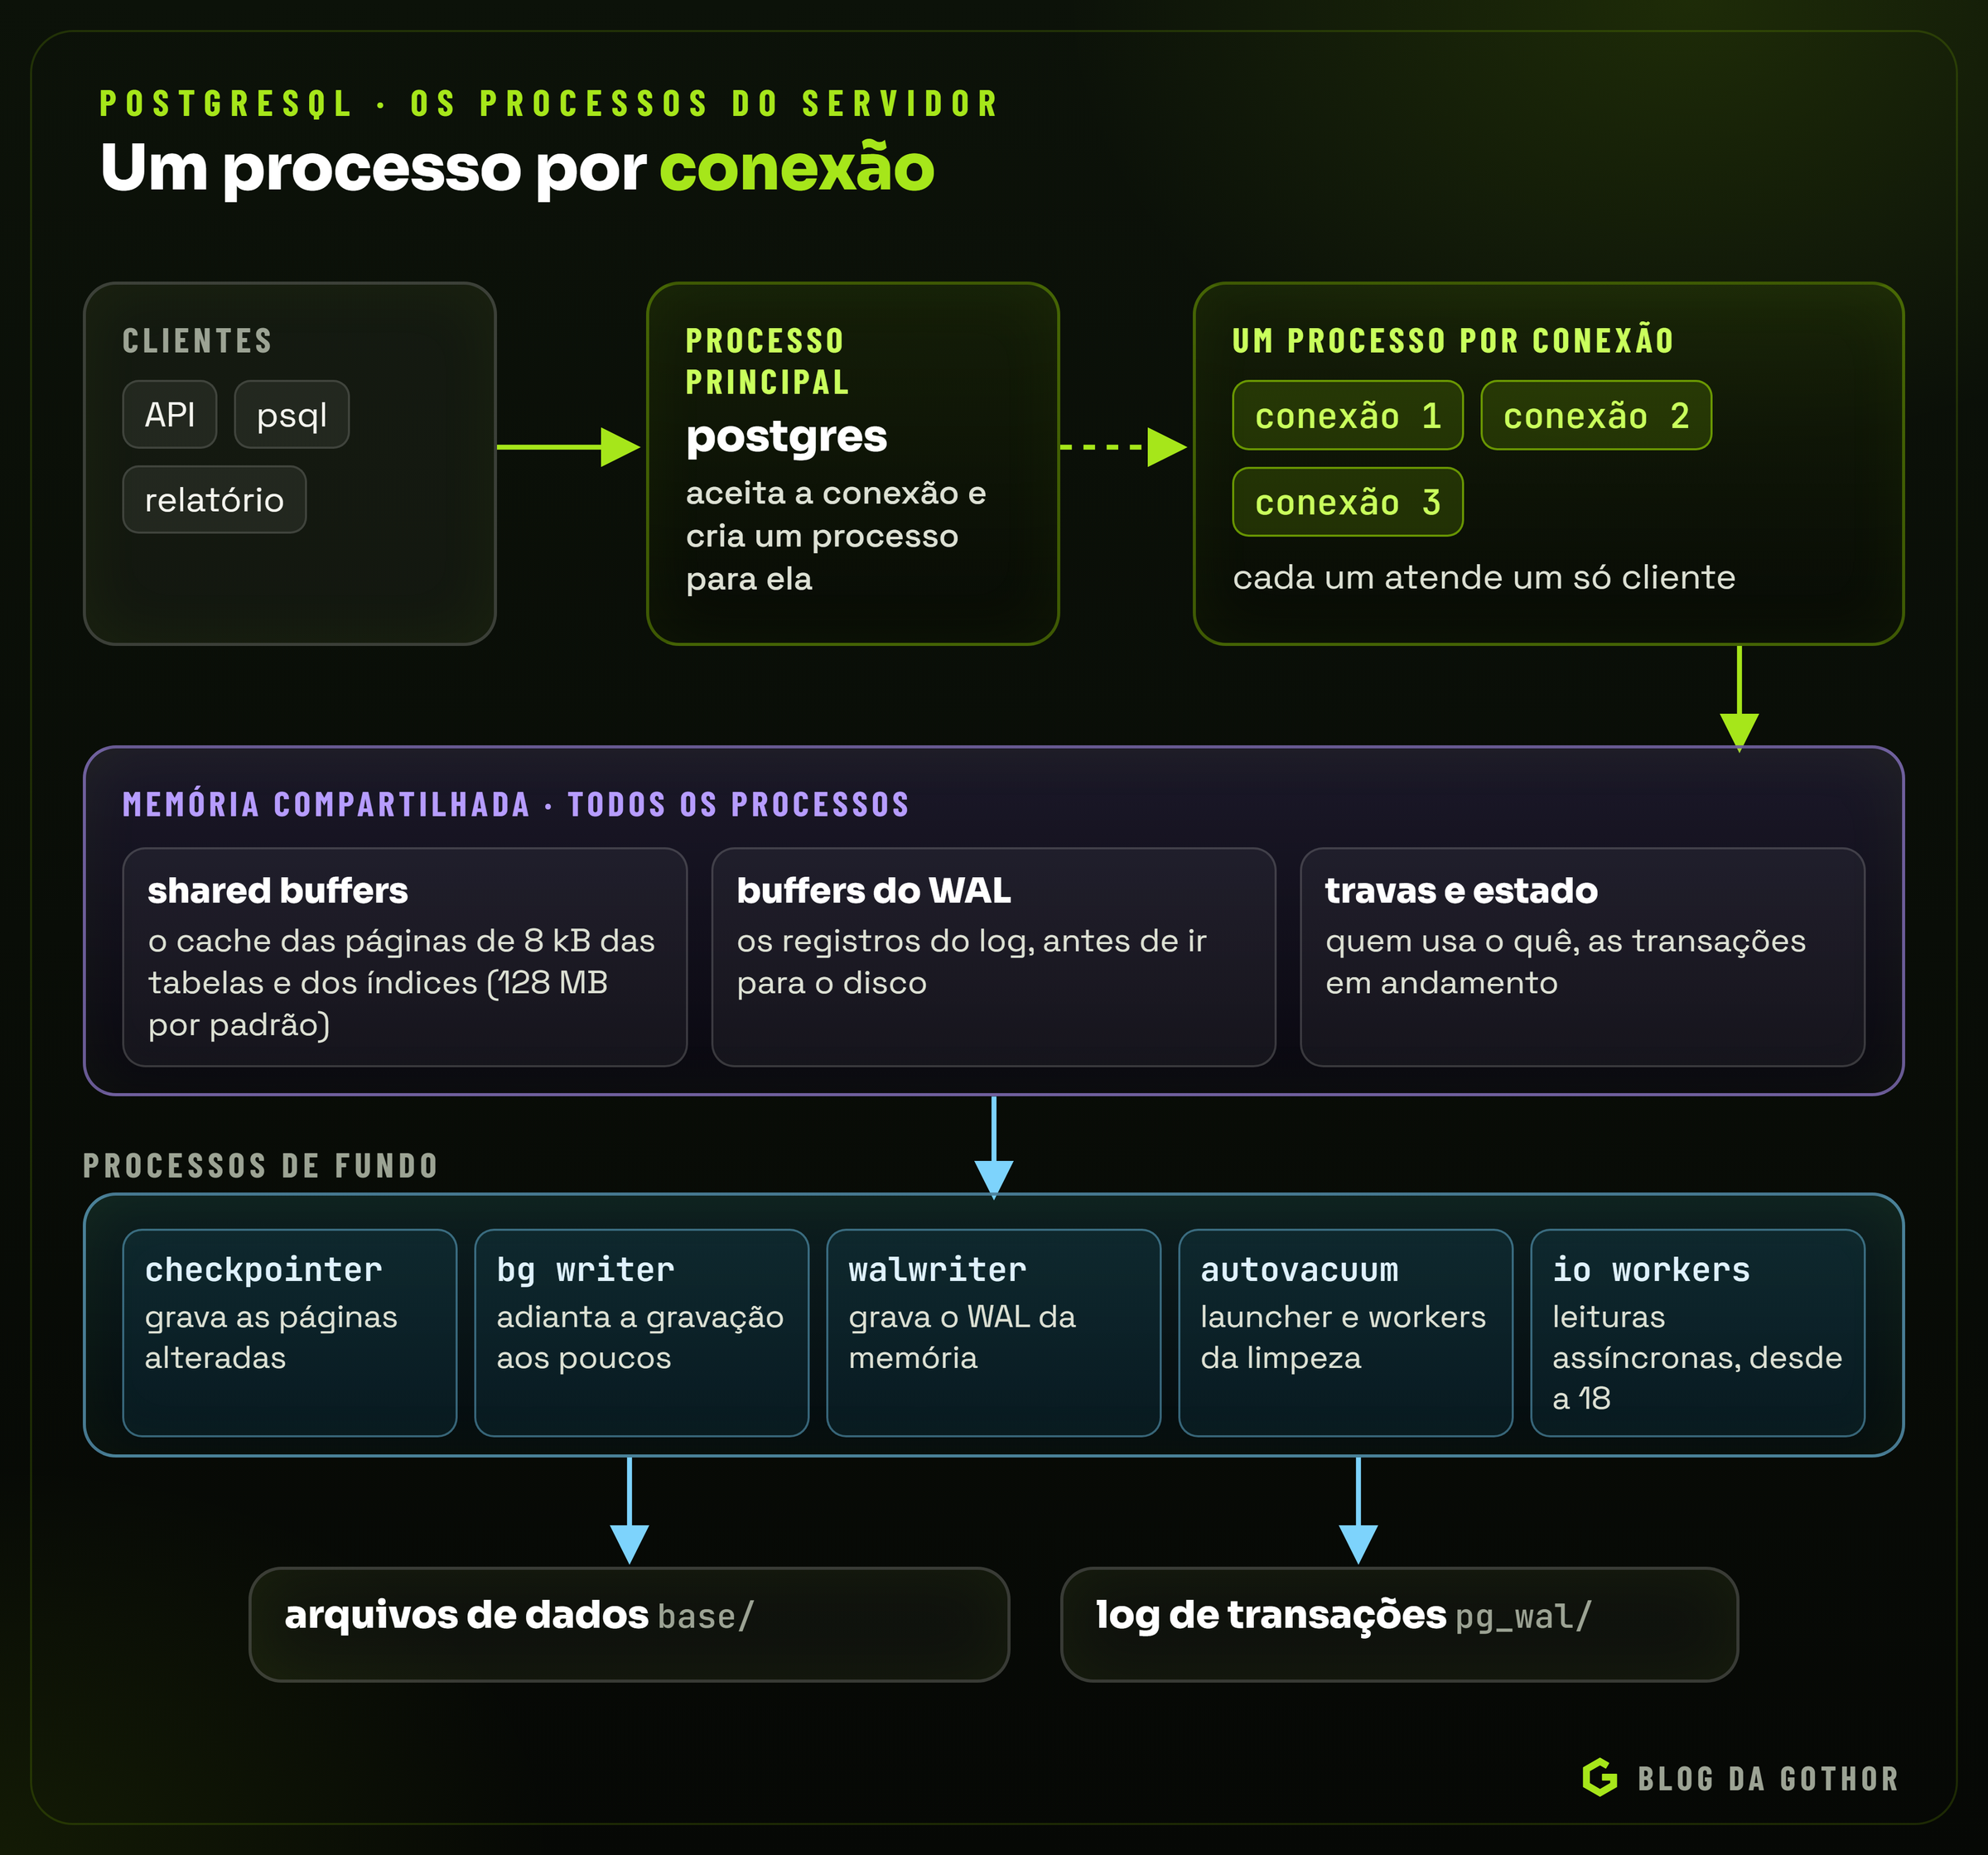
O modelo de um processo por conexão tem consequências diretas. Cada conexão custa um processo, com a memória dele, e o limite de conexões simultâneas, max_connections, costuma ser de 100 [34]. Aplicações que abrem uma conexão por requisição esgotam esse limite depressa. A resposta usual é um pool de conexões, na própria aplicação ou num serviço intermediário como o PgBouncer, que reparte poucas conexões reais entre muitos clientes. Aumentar o max_connections para milhares raramente resolve, porque cada processo a mais disputa memória e CPU com os outros.
Como os dados ficam no disco
Todos os arquivos de um servidor ficam num diretório de dados, conhecido pelo nome da variável de ambiente que costuma apontar para ele, PGDATA [10]. Lá estão os arquivos de configuração, o arquivo PG_VERSION, com a versão principal, e o diretório pg_wal, com o log de transações [10]. Cada banco tem um subdiretório em base/, com o identificador numérico do banco (o OID) como nome; e cada tabela e cada índice ficam em arquivos próprios, com o filenode da tabela como nome [10].
Uma consulta ao catálogo mostra onde uma tabela está:
SELECT pg_relation_filepath('pedidos');
-- base/16384/16385
Ao lado do arquivo principal de cada tabela ficam outros, chamados de forks: o mapa de espaço livre (sufixo _fsm), que diz onde há espaço para linhas novas, e o mapa de visibilidade (sufixo _vm), que marca as páginas sem linhas mortas [10]. Arquivos maiores que 1 GB são divididos em segmentos, com os sufixos .1, .2 e assim por diante [10].
Por dentro, cada arquivo é uma sequência de páginas de tamanho fixo, normalmente de 8 kB [11]. Cada página tem um cabeçalho de 24 bytes, uma lista de ponteiros de 4 bytes para as linhas, um espaço livre no meio e as linhas propriamente ditas, que são gravadas do fim da página para o começo, enquanto os ponteiros crescem do começo para o fim [11]. O endereço físico de uma linha, o ctid, é o número da página e a posição do ponteiro dentro dela [11]. Ele pode ser visto em qualquer tabela:
SELECT ctid, xmin, xmax, id, status FROM pedidos LIMIT 3;Cada linha guardada é uma tupla, com um cabeçalho fixo de 23 bytes na maioria das máquinas [11]. Três campos desse cabeçalho são a chave para entender o resto do artigo: o t_xmin, o identificador da transação que inseriu aquela versão da linha; o t_xmax, o da transação que a apagou ou travou; e o t_ctid, que aponta para a versão mais nova da mesma linha [11]. Uma linha, no PostgreSQL, é uma sequência de versões.
Como uma linha não pode se espalhar por várias páginas, valores grandes precisam de outro caminho. É o TOAST (The Oversized-Attribute Storage Technique): quando uma linha passaria de cerca de 2 kB, o PostgreSQL comprime os campos grandes e, se ainda for preciso, guarda-os fora da linha, numa tabela auxiliar, divididos em pedaços [12]. O mecanismo é transparente para quem consulta e limita cada valor a 1 GB [12]. Por isso, uma tabela com textos longos pode ocupar pouco no arquivo principal e muito no TOAST, e consultas que não leem essas colunas continuam rápidas.
O caminho de uma consulta
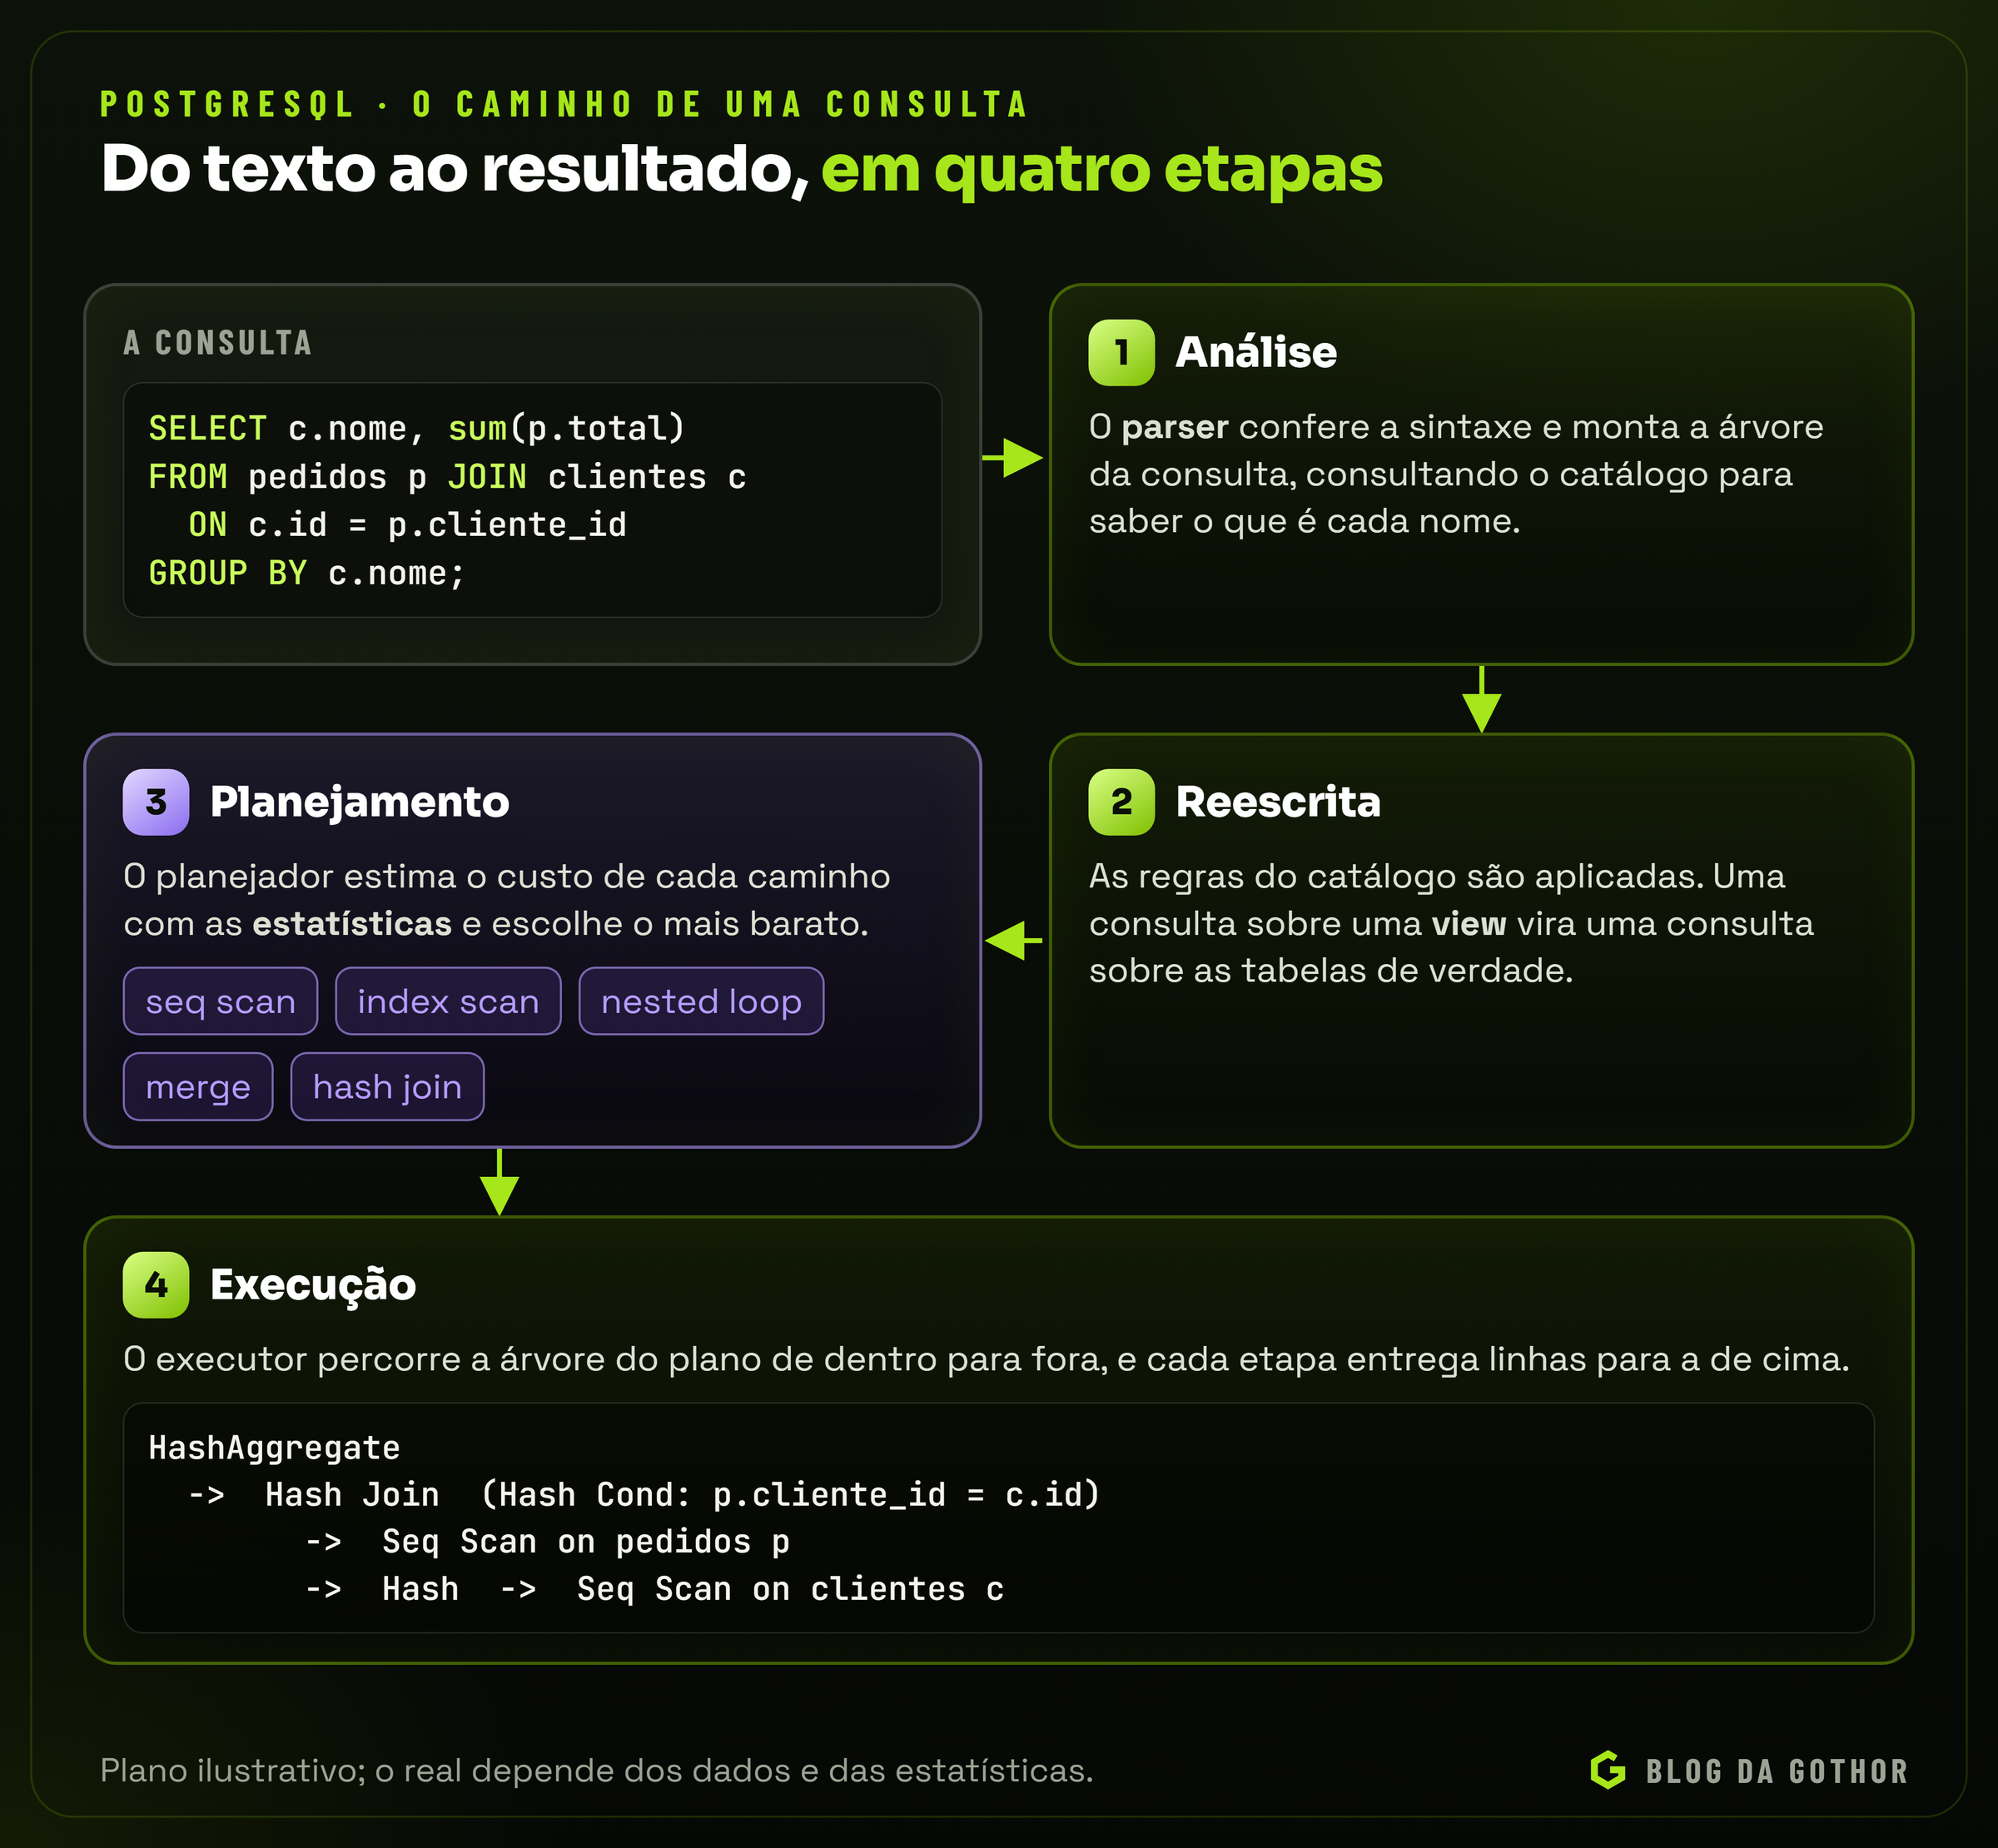
Quando a aplicação envia uma consulta, ela passa por etapas fixas, cada uma com o seu papel [13]:
- Conexão. A aplicação se conecta ao servidor, envia o texto da consulta e espera o resultado.
- Análise. O parser confere a sintaxe e monta uma árvore da consulta, consultando o catálogo para saber o que é cada nome.
- Reescrita. O sistema de regras aplica as regras guardadas no catálogo. É aqui que uma consulta sobre uma view vira uma consulta sobre as tabelas de verdade.
- Planejamento. O planejador, também chamado de otimizador, escolhe a estratégia de execução mais barata e a transforma num plano.
- Execução. O executor percorre a árvore do plano, de forma recursiva, e devolve as linhas.
O planejamento é a parte mais interessante. A mesma consulta pode ser respondida de muitas formas, e o planejador estima o custo de cada uma e escolhe a mais barata [14]. Para ler uma tabela, ele sempre considera a varredura sequencial, que lê a tabela inteira, e considera a varredura por índice quando há uma condição sobre uma coluna indexada ou quando a ordem do índice serve a um ORDER BY [14]. Para juntar tabelas, há três estratégias [14]:
- Laço aninhado (nested loop): para cada linha da tabela da esquerda, busca as correspondentes na da direita. É ótimo quando a da esquerda tem poucas linhas e a da direita tem um índice na coluna da junção.
- Junção por mesclagem (merge join): ordena as duas tabelas pela chave da junção e as percorre em paralelo. Funciona bem quando os dados já vêm ordenados, por exemplo de um índice.
- Junção por hash (hash join): carrega uma das tabelas numa tabela hash na memória e percorre a outra consultando essa tabela. É a escolha comum para junções grandes sem índice útil.
Com poucas tabelas, o planejador examina quase todas as ordens possíveis de junção. Acima de um limite, o parâmetro geqo_threshold, que vale 12, o número de combinações cresce demais, e ele passa a usar o otimizador genético, que encontra uma boa ordem por heurística em vez de testar todas [14].
As estimativas vêm das estatísticas de cada coluna, guardadas no catálogo: a fração de nulos, os valores mais comuns, um histograma da distribuição e o número de valores distintos. Elas são coletadas pelo ANALYZE, que o autovacuum roda sozinho quando uma parte da tabela mudou [18]. Quando as estatísticas estão velhas, por exemplo logo depois de uma carga grande, o planejador erra o número de linhas e pode escolher um laço aninhado onde uma junção por hash seria muito mais rápida. Um ANALYZE depois de cargas grandes evita boa parte desses casos.
O comando que mostra o plano escolhido é o EXPLAIN. Com ANALYZE, ele executa a consulta e mostra, para cada etapa, o tempo real e o número real de linhas ao lado das estimativas; com BUFFERS, mostra quantas páginas vieram do cache e quantas do disco:
EXPLAIN (ANALYZE, BUFFERS)
SELECT c.nome, sum(p.total)
FROM pedidos p
JOIN clientes c ON c.id = p.cliente_id
WHERE p.criado_em >= now() - interval '30 days'
GROUP BY c.nome;
O plano é uma árvore lida de dentro para fora: as etapas mais recuadas rodam primeiro e entregam linhas às de cima. O que mais vale olhar é a diferença entre as linhas estimadas e as reais; quando o planejador esperava 10 e vieram 100 mil, o problema quase sempre está nas estatísticas ou num índice que falta.
Consultas paralelas
Por muito tempo, cada consulta do PostgreSQL rodava num único processo, e portanto num único núcleo do processador, por maior que fosse a tabela. A versão 9.6, de 2016, trouxe a execução paralela de varreduras sequenciais, junções e agregações [7]. Quando o planejador conclui que dividir o trabalho sai mais barato, ele coloca no plano um nó Gather (ou Gather Merge, que preserva a ordenação), e tudo o que fica abaixo desse nó é executado ao mesmo tempo por vários processos [41]:
Gather  (cost=1000.00..217018.43 rows=1 width=97)
  Workers Planned: 2
  ->  Parallel Seq Scan on pgbench_accounts
        Filter: (filler ~~ '%x%'::text)
Ao chegar no Gather, o processo da conexão, que passa a ser o líder, pede processos auxiliares ao servidor; cada auxiliar executa a parte paralela do plano, e o líder também, além de juntar as linhas que os outros produzem [41]. O número de auxiliares por nó é limitado por max_parallel_workers_per_gather, que vale 2 por padrão, e o total do servidor por max_parallel_workers e max_worker_processes, que valem 8 [33][41]. Se não houver auxiliares livres no momento da execução, a consulta roda com menos processos do que o planejado, ou só com o líder, e pode ficar mais lenta do que o plano previa [41].
O paralelismo tem limites que explicam por que ele às vezes não aparece. O planejador não gera planos paralelos para consultas que alteram dados, nem quando a alteração está numa CTE; para cursores abertos com DECLARE CURSOR; e para consultas que chamam funções marcadas como PARALLEL UNSAFE, que é a marcação padrão das funções criadas pelo usuário [42]. Há exceções para comandos que criam dados a partir de uma consulta, como o CREATE TABLE ... AS e o REFRESH MATERIALIZED VIEW, cujo SELECT pode ser paralelo [42]. Na prática, o ganho aparece em relatórios que leem boa parte de tabelas grandes; consultas curtas, que buscam poucas linhas por índice, não se beneficiam, porque o custo de iniciar os auxiliares é maior que o trabalho.
MVCC: várias versões da mesma linha
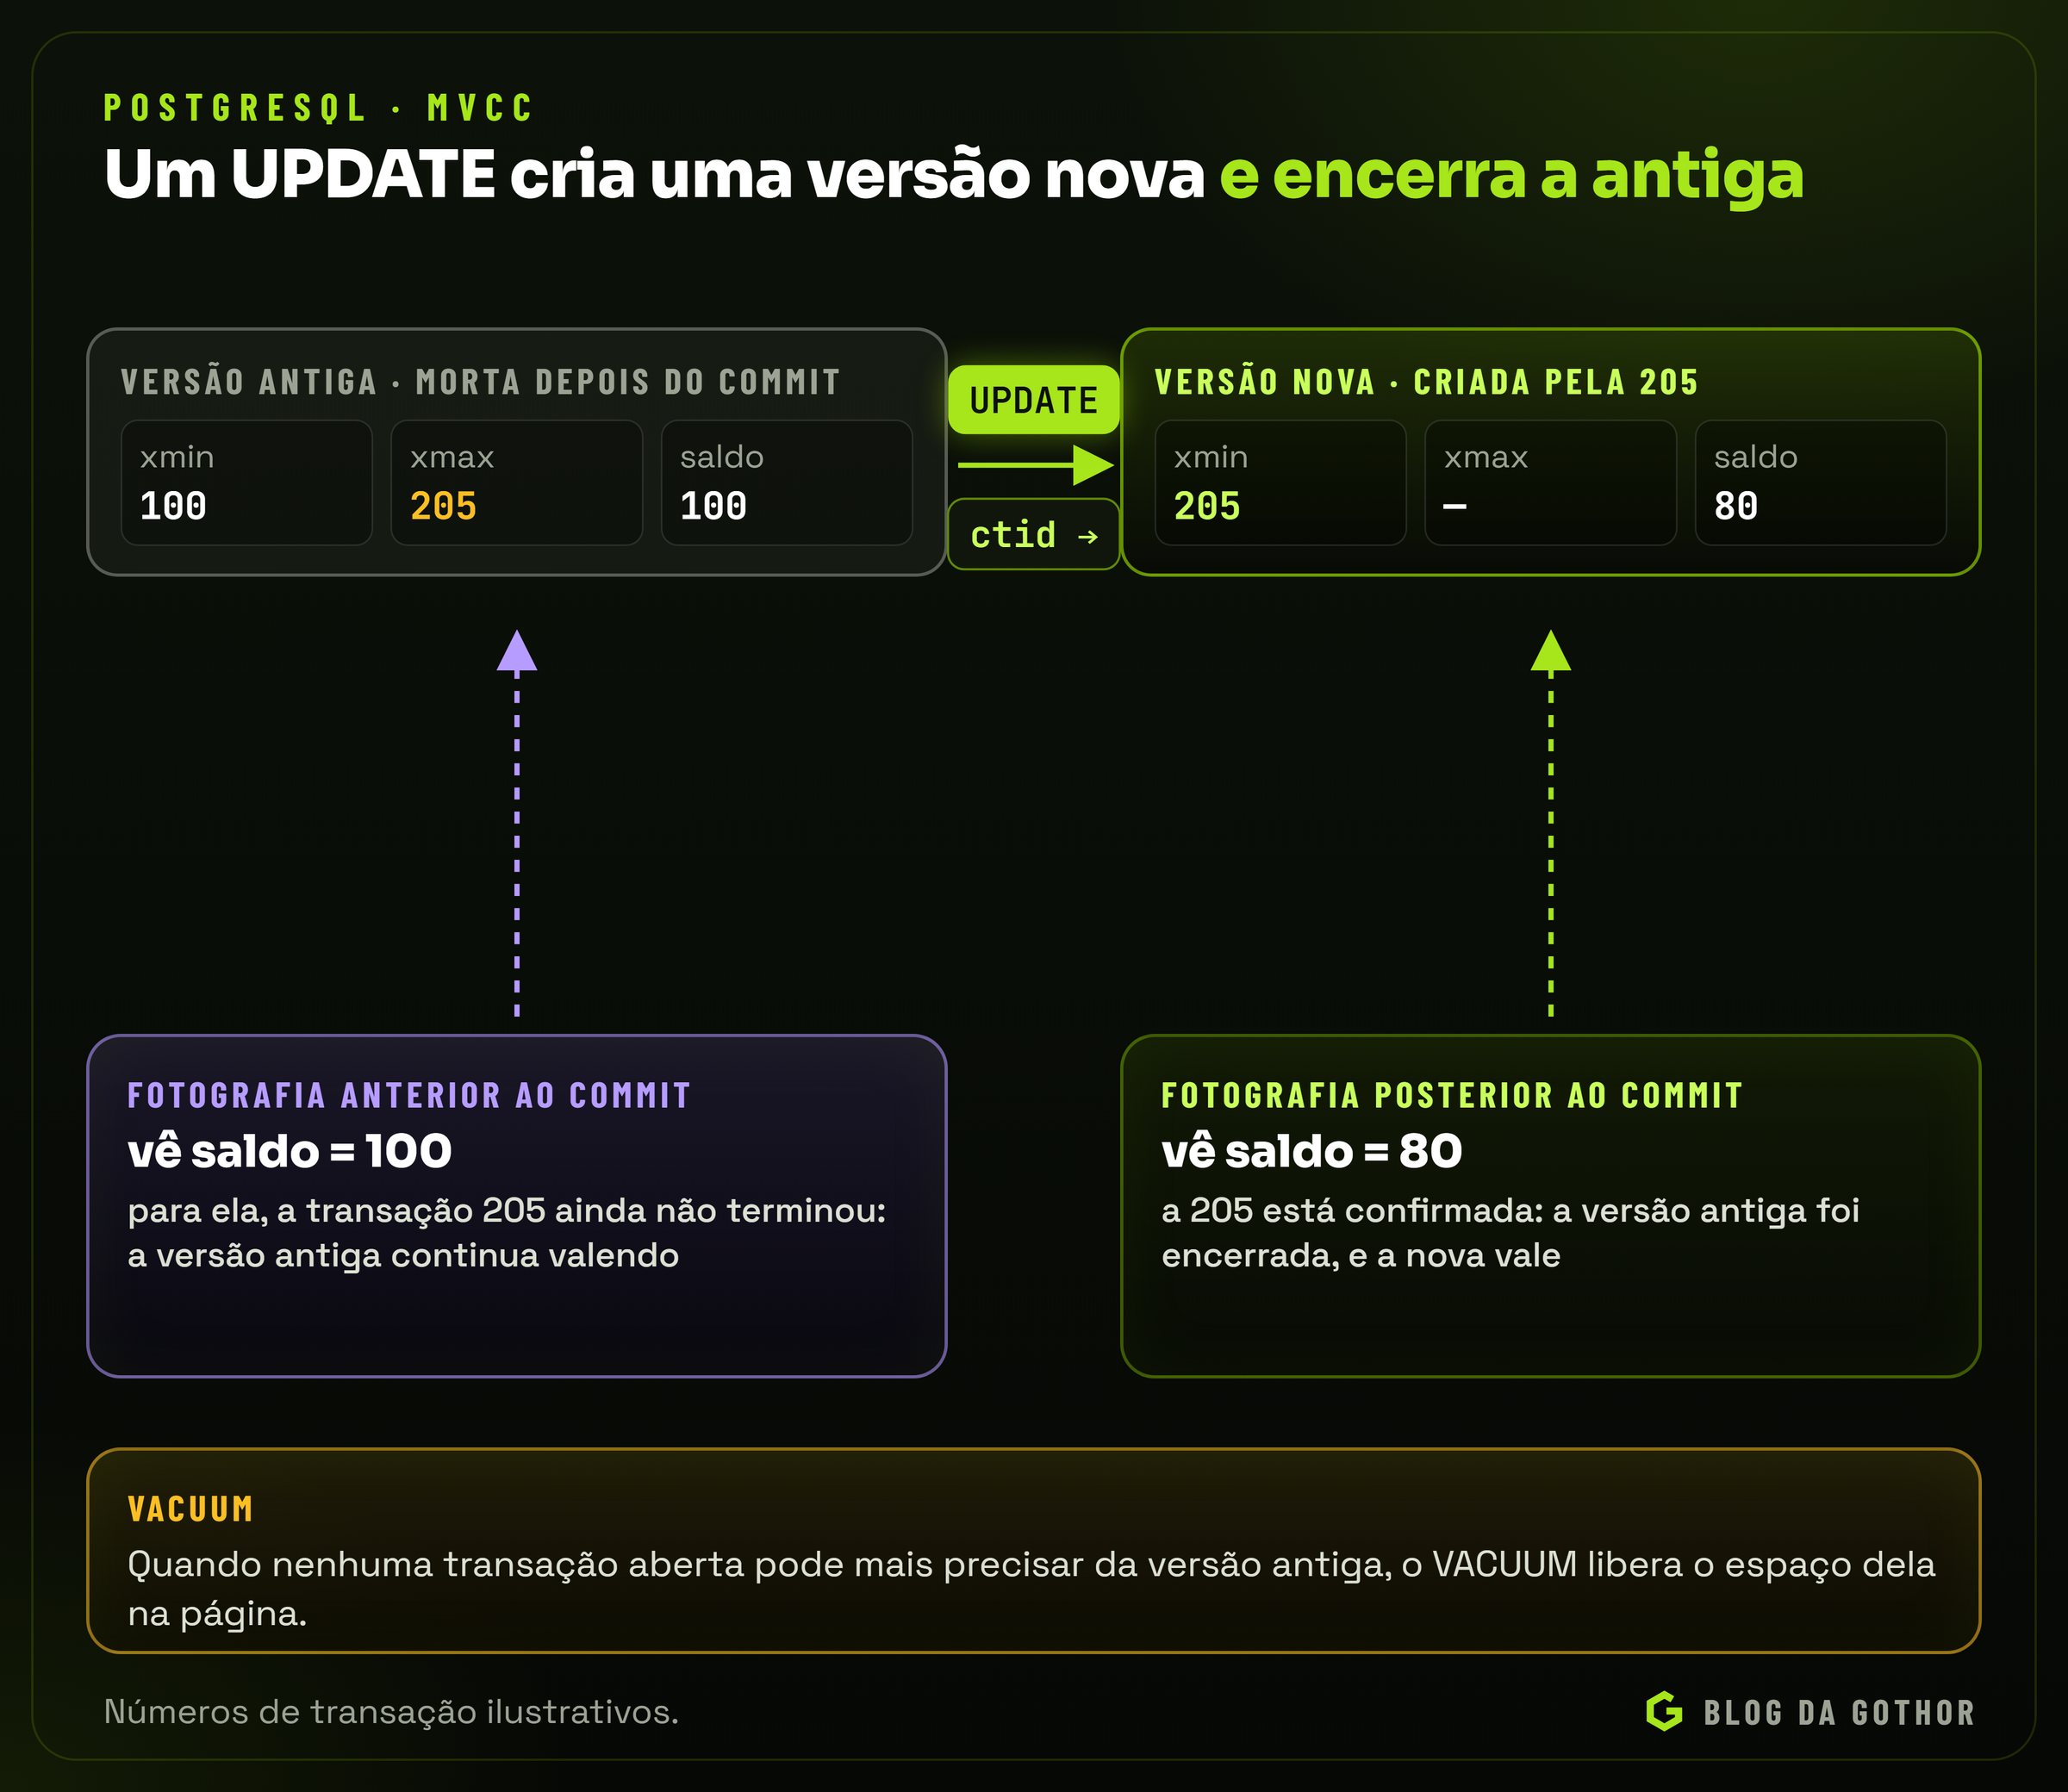
O PostgreSQL controla o acesso simultâneo aos dados com o MVCC (multiversion concurrency control). Cada instrução enxerga uma fotografia dos dados, uma versão do banco como ele era num instante, independentemente do que outras transações estejam fazendo naquele momento [15]. A vantagem principal sobre um modelo baseado só em travas é que as travas de leitura não conflitam com as de escrita: ler nunca bloqueia escrever, e escrever nunca bloqueia ler [15].
O mecanismo usa os campos xmin e xmax de cada versão de linha. Cada transação que altera dados recebe um número, o identificador de transação. Um INSERT cria uma versão com o xmin da transação. Um DELETE não apaga nada no arquivo: preenche o xmax da versão atual. E um UPDATE faz as duas coisas: encerra a versão antiga, preenchendo o xmax, e grava uma versão nova, com um xmin novo, ligada à anterior pelo ctid [11]. A fotografia de cada transação diz quais transações já estavam confirmadas quando ela começou; com isso, para cada versão de linha, o banco decide se ela é visível: a transação que a criou tem de estar confirmada na fotografia, e a que a encerrou, se houver, não.
Um exemplo com duas sessões mostra o efeito:
-- Sessão A
BEGIN;
UPDATE contas SET saldo = 80 WHERE id = 1;   -- ainda sem COMMIT

-- Sessão B, ao mesmo tempo
SELECT saldo FROM contas WHERE id = 1;       -- 100: vê a versão confirmada

-- Sessão A
COMMIT;

-- Sessão B
SELECT saldo FROM contas WHERE id = 1;       -- 80, no nível Read Committed
A sessão B não esperou a sessão A terminar, e a sessão A não esperou ninguém para gravar. Só há espera quando duas transações tentam alterar a mesma linha: a segunda aguarda a primeira confirmar ou desfazer.
Os níveis de isolamento
O padrão SQL define quatro níveis de isolamento, e o PostgreSQL implementa três de forma distinta [16]:
- Read Committed, o padrão: cada instrução vê uma fotografia tirada no momento em que ela começa. Duas leituras na mesma transação podem ver dados diferentes, se outra transação confirmou algo entre elas.
- Repeatable Read: a fotografia é tirada na primeira instrução da transação e vale até o fim. O padrão SQL permite as chamadas leituras fantasmas nesse nível, mas a implementação do PostgreSQL não as permite [16]. Se a transação tenta alterar uma linha que outra transação alterou e confirmou depois da fotografia, ela recebe um erro de serialização.
- Serializable: garante que o resultado de transações simultâneas é o mesmo de alguma execução em fila, uma depois da outra. O PostgreSQL implementa esse nível com o Serializable Snapshot Isolation, que acrescenta ao isolamento por fotografia uma verificação das dependências perigosas entre leituras e gravações [16].
O quarto nível do padrão, Read Uncommitted, se comporta como Read Committed: no PostgreSQL, nenhuma transação vê dados que ainda não foram confirmados [16].
Nos níveis Repeatable Read e Serializable, a aplicação precisa estar preparada para os erros de serialização, que sempre chegam com o código SQLSTATE 40001; a orientação é desfazer a transação e repeti-la inteira [16]. É um preço pequeno pela garantia de que regras que dependem de várias linhas, como um limite de crédito somado de todas as faturas, não serão violadas por duas transações que, sozinhas, estavam corretas.
O custo das versões e o HOT
O MVCC tem um custo: cada UPDATE grava uma linha nova e, em princípio, uma entrada nova em cada índice da tabela, apontando para a nova versão. Para reduzir esse custo, o PostgreSQL usa as tuplas só no heap (heap-only tuples, ou HOT) [17]. Quando o UPDATE não muda nenhuma coluna indexada e há espaço livre na mesma página para a versão nova, os índices não recebem entradas novas, e as versões intermediárias de uma linha alterada muitas vezes podem ser removidas durante o uso normal, até numa leitura, sem esperar o VACUUM [17]. Diminuir o fillfactor de uma tabela muito atualizada, deixando espaço livre em cada página, aumenta a chance de atualizações HOT [17].
Travas: quando alguém precisa esperar
O MVCC elimina a espera entre leitura e escrita, mas não acaba com as travas. O PostgreSQL tem oito modos de trava de tabela, do mais fraco ao mais forte, e cada comando pega um deles automaticamente [39]. O SELECT pega o ACCESS SHARE; INSERT, UPDATE, DELETE e MERGE pegam o ROW EXCLUSIVE; o VACUUM comum, o ANALYZE e o CREATE INDEX CONCURRENTLY pegam o SHARE UPDATE EXCLUSIVE; o CREATE INDEX sem CONCURRENTLY pega o SHARE, que bloqueia as gravações [39]. No topo está o ACCESS EXCLUSIVE, o único que bloqueia até as leituras, pego por DROP TABLE, TRUNCATE, VACUUM FULL, REFRESH MATERIALIZED VIEW sem CONCURRENTLY e por muitas formas de ALTER TABLE [39].
Esse último modo esconde a armadilha mais comum das mudanças de estrutura. Um ALTER TABLE rápido, que só altera o catálogo, ainda precisa da trava ACCESS EXCLUSIVE, e para consegui-la espera todas as transações que já usam a tabela, inclusive uma leitura demorada. Enquanto espera na fila, ele bloqueia os comandos que chegam depois dele e pedem travas conflitantes, até os SELECT simples: a documentação chama isso de bloqueio "suave", feito por quem ainda não tem a trava, mas está na frente na fila [43]. Um relatório de dez minutos, somado a uma migração que parecia instantânea, para a aplicação inteira por dez minutos. A defesa é rodar as migrações com um lock_timeout curto, de alguns segundos, que desiste do comando se a trava não vier nesse prazo (o padrão, zero, espera para sempre), e tentar de novo depois [44].
As travas de linha funcionam de outro jeito. O UPDATE comum pega a trava FOR NO KEY UPDATE na linha alterada; o DELETE e o UPDATE que muda uma coluna usada por chave estrangeira pegam a FOR UPDATE, mais forte [39]. A diferença existe para que a inserção de um item que referencia um pedido, que pega a trava FOR KEY SHARE no pedido, não espere uma atualização qualquer do pedido, só uma que mude a chave [39]. E, como o PostgreSQL não guarda na memória quais linhas estão travadas, não há limite para o número de linhas travadas ao mesmo tempo; em troca, travar uma linha com SELECT ... FOR UPDATE grava a marca na própria linha, o que custa uma escrita em disco [39].
Quando duas transações esperam uma pela outra, há um deadlock. Uma transação que espera uma trava por mais de deadlock_timeout, de um segundo por padrão, procura um ciclo de esperas; se encontrar, o servidor desfaz uma das transações envolvidas, e não dá para prever qual [39][40]. A documentação aponta a melhor defesa: fazer todas as partes da aplicação pegarem as travas na mesma ordem e, em cada objeto, pegar logo de início a trava mais forte de que a transação vai precisar; quando isso não é possível, repetir as transações desfeitas [39]. Para enxergar quem espera por quem, a função pg_blocking_pids devolve os processos que impedem outro de conseguir uma trava, tanto os que a seguram quanto os que estão na frente dele na fila [43]:
SELECT pid, pg_blocking_pids(pid) AS bloqueado_por, wait_event_type, left(query, 60)
FROM pg_stat_activity
WHERE cardinality(pg_blocking_pids(pid)) > 0;
VACUUM: a faxina que o MVCC exige
Se um UPDATE cria uma versão nova e um DELETE só marca a antiga, alguém precisa limpar as versões que ninguém mais vai ler. Esse alguém é o VACUUM, e a documentação lista quatro motivos para que ele rode com regularidade [18]:
- Recuperar ou reaproveitar o espaço ocupado por linhas alteradas ou apagadas.
- Atualizar as estatísticas usadas pelo planejador.
- Atualizar o mapa de visibilidade, o que acelera as varreduras só de índice.
- Proteger contra a perda de dados muito antigos pelo estouro do contador de transações.
O VACUUM comum roda junto com o trabalho normal: leituras e gravações continuam, e só alterações de estrutura da tabela ficam bloqueadas enquanto ele trabalha [18]. Ele marca o espaço das versões mortas como reaproveitável, mas, em geral, não devolve espaço ao sistema operacional; o arquivo só diminui quando as páginas do fim ficam inteiramente vazias [18]. O VACUUM FULL é outra coisa: reescreve a tabela inteira num arquivo novo, sem espaço morto, e para isso exige uma trava exclusiva, que bloqueia qualquer uso da tabela durante a operação, além de espaço em disco para a cópia [18]. Ele resolve um inchaço grande, mas não é ferramenta de rotina.
O autovacuum
Ninguém precisa agendar o VACUUM à mão: desde a versão 8.1 o autovacuum faz parte do servidor [7]. Ele é formado por um processo permanente, o launcher, que inicia workers para cada banco, um por banco a cada intervalo de autovacuum_naptime, e por até autovacuum_max_workers processos trabalhando ao mesmo tempo [18]. Os valores padrão são um minuto e três processos [19].
Uma tabela recebe o VACUUM quando o número de versões mortas passa de um limite calculado assim: 50 linhas mais 20% do tamanho estimado da tabela, com um teto de 100 milhões [18][19]. O ANALYZE automático segue uma regra parecida, com 50 linhas mais 10% das linhas alteradas desde a última coleta [19]. Numa tabela de 1 milhão de linhas, isso dá um VACUUM a cada 200 mil linhas mortas, mais ou menos. Em tabelas muito grandes, 20% é muita coisa, e é comum baixar o fator só para elas, com ALTER TABLE ... SET (autovacuum_vacuum_scale_factor = 0.02).
O estouro do contador de transações
O quarto motivo do VACUUM é o menos conhecido e o mais sério. Os identificadores de transação têm 32 bits: um servidor que roda por muito tempo, com mais de 4 bilhões de transações, daria a volta no contador [18]. Como a comparação entre identificadores é feita em aritmética circular, cada tabela de cada banco precisa passar pelo VACUUM pelo menos uma vez a cada 2 bilhões de transações [18]. Sem isso, transações antigas pareceriam estar "no futuro", e as linhas criadas por elas sumiriam das consultas.
A solução é o congelamento: o VACUUM marca as versões antigas como congeladas, e uma versão congelada é tratada como se estivesse no passado para todas as transações, qualquer que seja o valor do contador [18]. O autovacuum força esse trabalho quando a transação mais antiga não congelada de uma tabela passa de autovacuum_freeze_max_age, que vale 200 milhões de transações [18][19], mesmo que o autovacuum esteja desligado para a tabela.
Se o congelamento não acontece, o banco avisa e depois se protege. Os avisos começam quando faltam 40 milhões de transações para o estouro; se forem ignorados, com menos de 3 milhões restantes o servidor recusa novos identificadores de transação, e só transações de leitura podem começar até que o VACUUM resolva a situação [18]. Na prática, isso só acontece quando algo impede o VACUUM de terminar: uma transação aberta há dias, um slot de replicação abandonado ou o autovacuum desligado. A consulta abaixo mostra a idade da transação mais antiga não congelada de cada banco:
SELECT datname, age(datfrozenxid) FROM pg_database ORDER BY 2 DESC;WAL: gravar no log antes de gravar nos dados
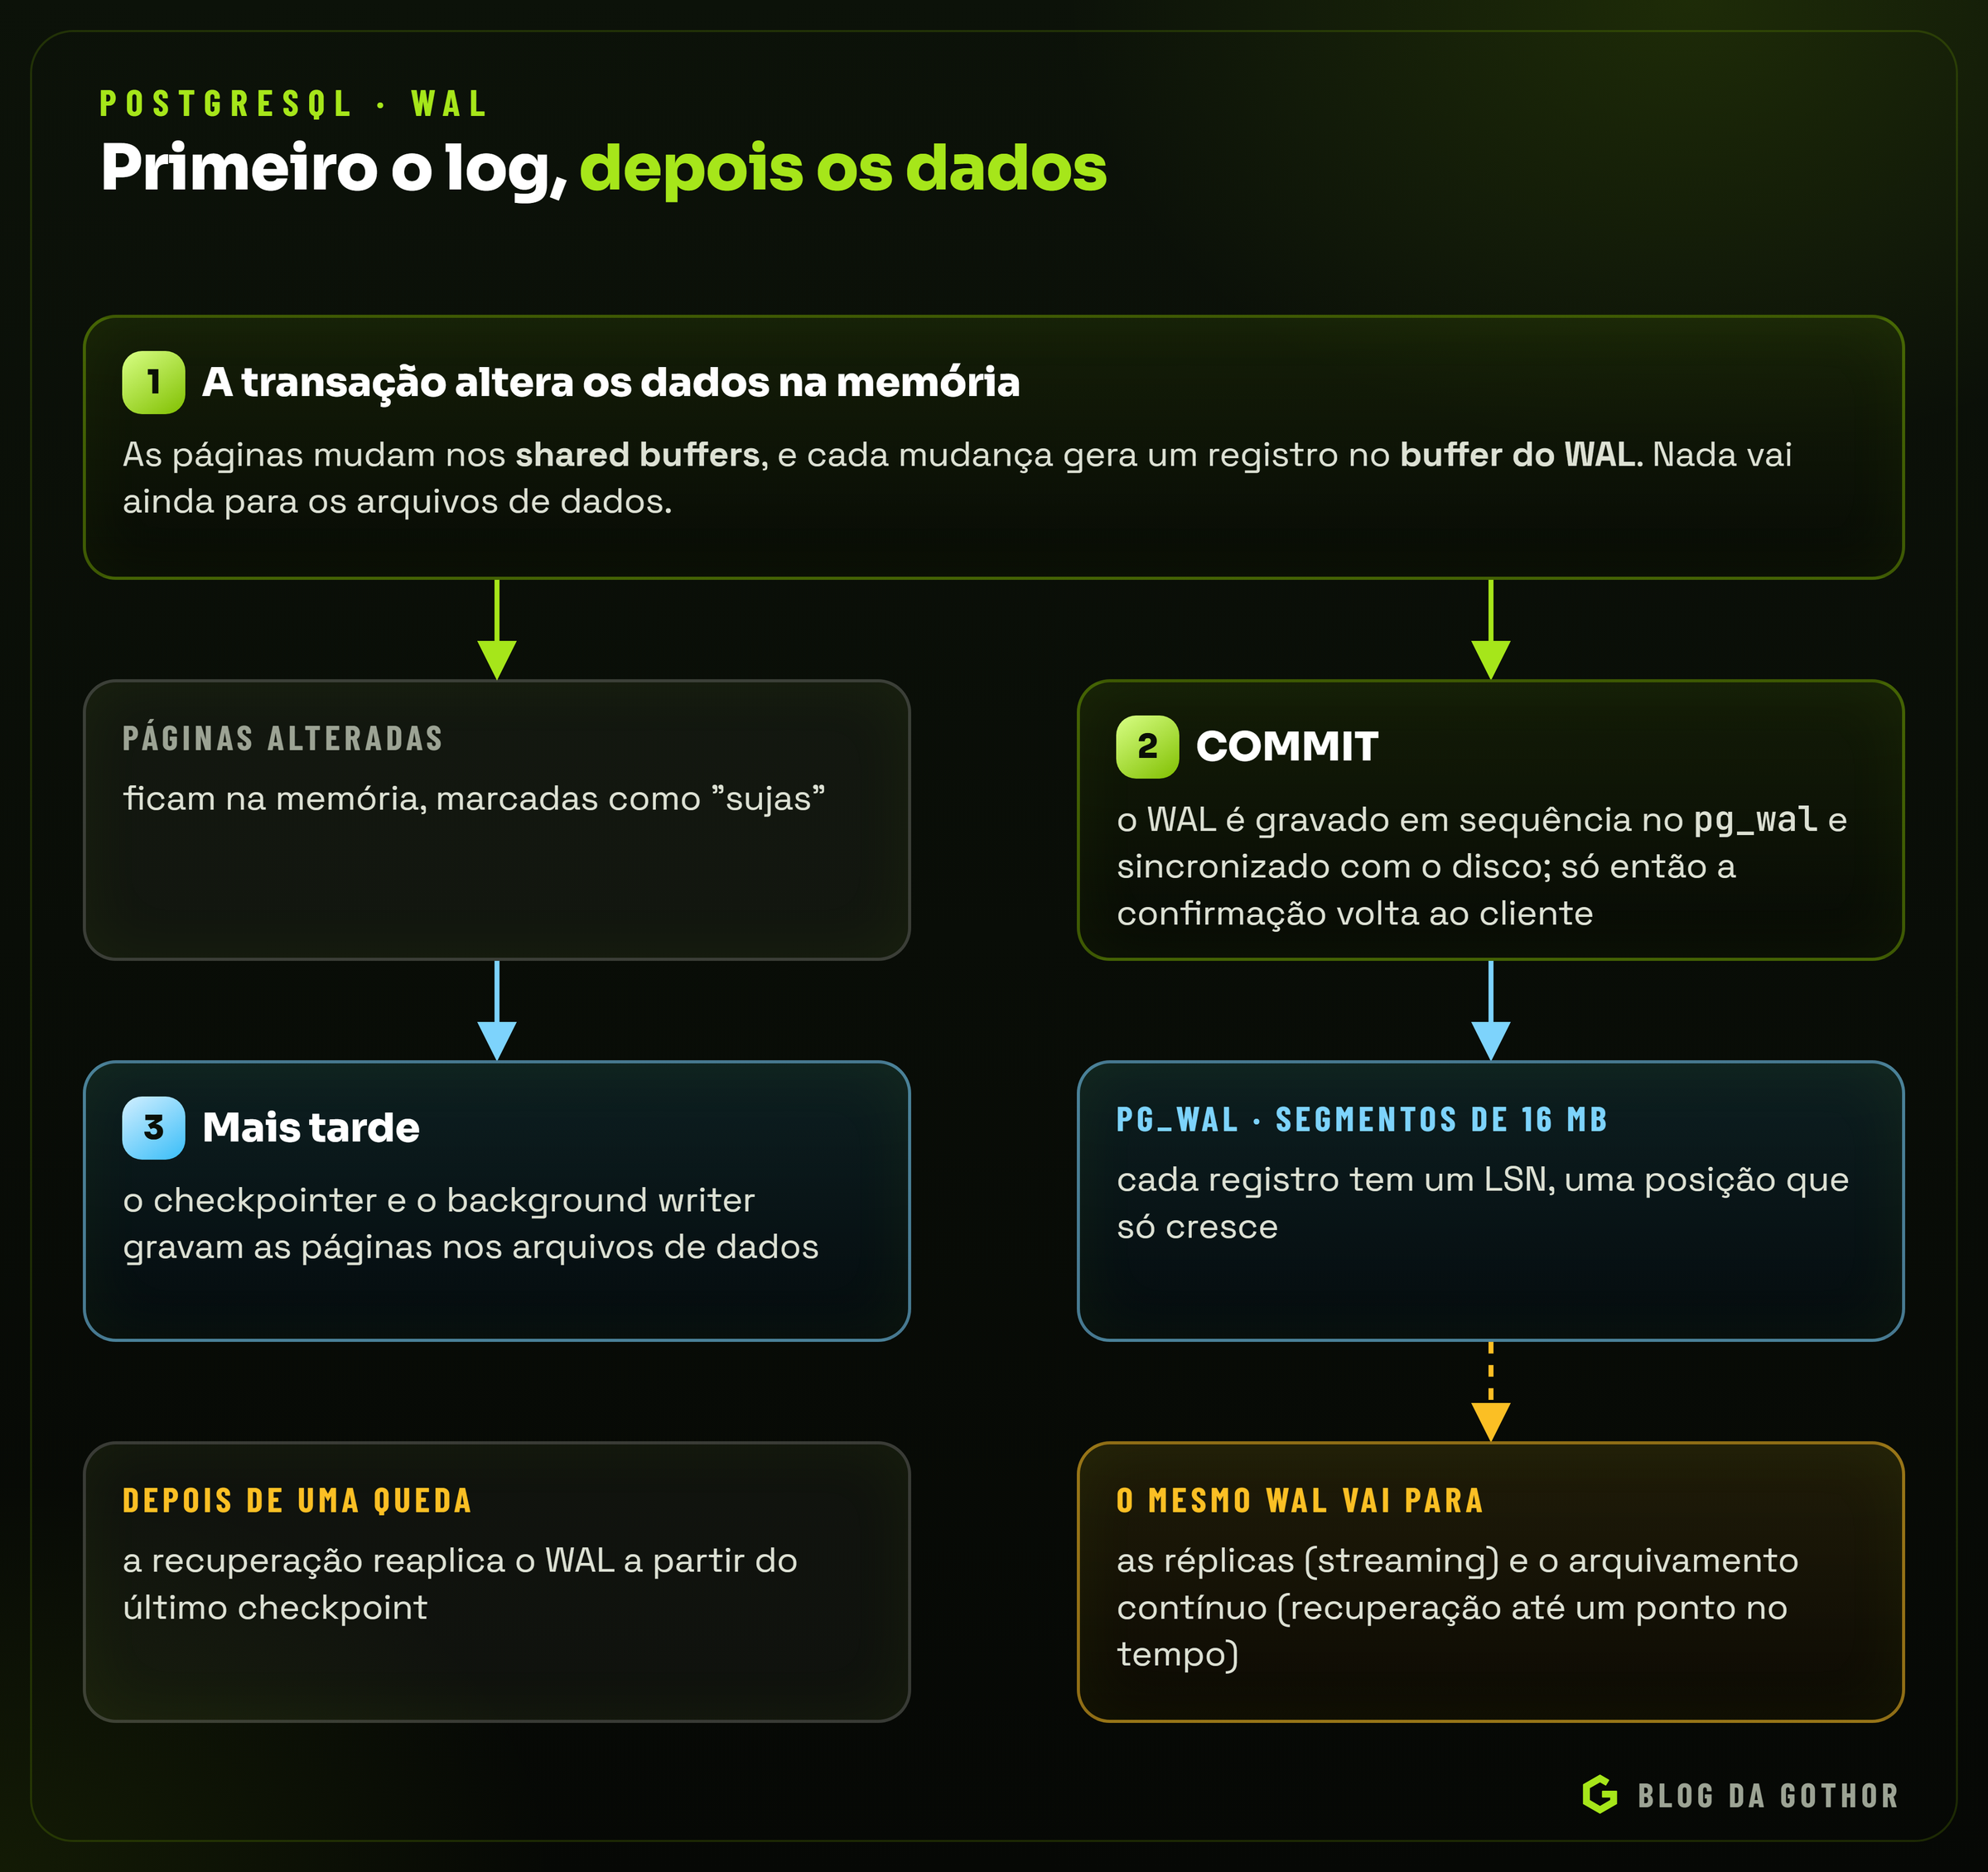
O PostgreSQL protege as transações confirmadas com o WAL (write-ahead log, o log de gravação antecipada). O princípio é simples: uma alteração nos arquivos de dados só pode ser gravada depois que os registros do WAL que a descrevem estiverem gravados de forma permanente [20]. Se o servidor cair, as alterações que ainda não chegaram aos arquivos de dados são refeitas a partir do WAL na próxima inicialização; é a recuperação por reaplicação do log, o REDO [20].
Isso parece trabalho dobrado, mas reduz as gravações em disco. Para confirmar uma transação, basta gravar o WAL, e não todas as páginas de dados que ela alterou [20]. O WAL é gravado em sequência, o que custa muito menos que gravar páginas espalhadas pelos arquivos, e, com muitas transações pequenas ao mesmo tempo, uma única sincronização do arquivo do WAL com o disco pode confirmar várias delas [20]. As páginas de dados alteradas ficam nos shared buffers e vão para o disco depois, com calma.
O WAL fica no diretório pg_wal, dividido em segmentos de 16 MB, cada um formado por páginas de 8 kB [22]. Cada registro tem uma posição, o LSN (log sequence number), que é um deslocamento em bytes que só cresce; a diferença entre dois LSNs é o volume de WAL entre eles, e por isso o LSN é usado para medir o avanço da replicação e da recuperação [22]:
SELECT pg_current_wal_lsn(), pg_walfile_name(pg_current_wal_lsn());Checkpoints
Se o WAL guarda tudo, até onde é preciso reaplicá-lo depois de uma queda? Até o último checkpoint. Um checkpoint é um ponto na sequência de transações em que é garantido que os arquivos de dados contêm tudo o que foi gravado antes dele: as páginas alteradas são gravadas no disco, e um registro especial é escrito no WAL [21]. Depois de uma queda, a recuperação começa no último checkpoint, e os segmentos de WAL anteriores a ele podem ser reciclados.
O checkpointer inicia um checkpoint a cada checkpoint_timeout, de 5 minutos por padrão, ou antes disso se o WAL estiver perto de passar de max_wal_size, de 1 GB [21]. Para não gerar um pico de gravação, ele espalha o trabalho por cerca de 90% do intervalo, conforme o checkpoint_completion_target [21]. Há um efeito colateral importante: com o full_page_writes ligado, que é o padrão, a primeira alteração de cada página depois de um checkpoint grava a página inteira no WAL, para proteger contra páginas gravadas pela metade numa queda [21]. Checkpoints muito frequentes aumentam o volume de WAL; muito espaçados, alongam a recuperação. Os valores padrão são conservadores para servidores com muita escrita, e aumentar o max_wal_size é um dos ajustes mais comuns.
Quanto custa um COMMIT
Por padrão, o PostgreSQL só responde a um COMMIT depois que o WAL foi sincronizado com o disco. Desligar o synchronous_commit numa transação faz a confirmação voltar antes, o que é mais rápido, mas uma queda pode perder as últimas transações confirmadas, sem corromper o banco: serve para dados que podem ser reconstruídos, nunca para dados financeiros. As tabelas UNLOGGED vão além e não passam pelo WAL: gravam mais rápido, mas são esvaziadas depois de uma queda e não vão para as réplicas [7].
Replicação e alta disponibilidade
O WAL é também a base da replicação. Se o log descreve cada alteração, outro servidor que receba esse log e o reaplique terá uma cópia exata do primeiro. É isso que a replicação por streaming faz, desde a versão 9.0: a réplica se conecta ao servidor principal, e o principal envia o WAL à medida que ele é gerado, sem esperar o segmento encher [23]. No principal aparece um processo walsender para cada réplica; na réplica, um walreceiver [23]. Com o hot standby, a réplica aceita consultas de leitura enquanto reaplica o log [7].
Por padrão, a replicação é assíncrona: há um pequeno atraso entre a confirmação no principal e a alteração aparecer na réplica, normalmente de menos de um segundo quando a réplica acompanha o ritmo [23]. Se o principal cair nesse intervalo, as últimas transações podem se perder. A replicação síncrona, ligada pelo parâmetro synchronous_standby_names, faz cada confirmação esperar até o registro estar gravado em disco também na réplica; aí, só uma queda simultânea do principal e da réplica perderia dados [23]. O custo é a latência: cada COMMIT passa a levar pelo menos uma ida e volta de rede, e, sem uma réplica síncrona disponível, as confirmações ficam paradas [23]. A replicação síncrona aceita listas de réplicas por prioridade (FIRST 2 (s1, s2, s3)) ou por quórum (ANY 2 (s1, s2, s3)) [23].
O atraso de uma réplica se mede comparando LSNs: o pg_current_wal_lsn() do principal com o pg_last_wal_receive_lsn() e o pg_last_wal_replay_lsn() da réplica, ou pela visão pg_stat_replication no principal [23].
Slots de replicação
Se uma réplica fica desconectada por algumas horas, o principal pode reciclar o WAL de que ela ainda precisaria, e a réplica teria de ser refeita a partir de uma cópia nova [23]. Os slots de replicação, desde a 9.4, resolvem isso: o principal guarda o WAL até que todas as réplicas com slot o tenham recebido [23]. O risco é o oposto: uma réplica abandonada com um slot ativo faz o principal guardar WAL indefinidamente, até encher o disco [23]. O parâmetro max_slot_wal_keep_size limita esse acúmulo, e a visão pg_replication_slots deve fazer parte do monitoramento de qualquer servidor com réplicas.
Replicação lógica
A replicação por streaming copia o servidor inteiro, byte a byte: mesma versão, mesma arquitetura, todos os bancos. A replicação lógica, desde a versão 10, trabalha em outro nível: copia as alterações de linhas de tabelas escolhidas, identificadas pela chave primária, num modelo de publicação e assinatura [24]. O servidor de origem cria uma publicação com as tabelas, e o de destino cria uma assinatura; a assinatura copia os dados existentes e, depois, recebe as alterações continuamente, na mesma ordem em que aconteceram [24]:
-- na origem
CREATE PUBLICATION vendas_pub FOR TABLE pedidos, itens_pedido;

-- no destino
CREATE SUBSCRIPTION vendas_sub
  CONNECTION 'host=origem dbname=erp user=replicador'
  PUBLICATION vendas_pub;
Entre os usos previstos pela documentação estão replicar entre versões principais diferentes do PostgreSQL, entre sistemas operacionais diferentes, juntar vários bancos num só para análise e compartilhar só uma parte dos dados [24]. O primeiro uso é o mais valioso para quem opera: permite atualizar a versão principal com uma parada de poucos segundos, deixando o servidor novo como assinante até alcançar o antigo.
Índices: muito além da árvore B
O PostgreSQL tem seis tipos de índice no núcleo, cada um para um formato de pergunta [25]:
- B-tree, o padrão: igualdade e intervalos em dados ordenáveis (
<,<=,=,>=,>), além deBETWEEN,IN,IS NULLeLIKEcom o começo fixo, como'Mercado%'. Também devolve os dados já ordenados [25]. - Hash: só igualdade, guardando um código hash de 32 bits do valor [25].
- GiST: uma infraestrutura para muitas estratégias, usada para geometria, intervalos e busca do vizinho mais próximo, como "os dez pontos mais próximos deste" [25].
- SP-GiST: estruturas não balanceadas, como árvores de quadrantes e árvores de prefixos [25].
- GIN: índices invertidos, com uma entrada para cada componente de um valor composto; servem para arrays, JSONB e busca textual, que perguntam "quais linhas contêm este elemento" [25][26].
- BRIN: guardam só um resumo, como o mínimo e o máximo, de cada faixa de páginas consecutivas; são minúsculos e funcionam quando os valores acompanham a ordem física da tabela, como a data de criação de um log que só recebe inserções [25].
CREATE INDEX ON logs USING brin (criado_em);
CREATE INDEX ON produtos USING gin (atributos jsonb_path_ops);
Além do tipo, três variações resolvem problemas comuns. O índice parcial só indexa as linhas que interessam, como os títulos em aberto, e fica muito menor que um índice da tabela inteira. O índice de expressão indexa o resultado de uma função, como lower(email), e serve às consultas que usam a mesma expressão. E o índice com colunas incluídas, desde a versão 11, acrescenta colunas às folhas de uma B-tree para que a consulta seja respondida só pelo índice [7]:
CREATE INDEX titulos_abertos ON titulos (vencimento) WHERE pago_em IS NULL;
CREATE UNIQUE INDEX usuarios_email ON usuarios (lower(email));
CREATE INDEX pedidos_cliente ON pedidos (cliente_id) INCLUDE (total);
A varredura só de índice depende do mapa de visibilidade: o PostgreSQL só pode pular a leitura da tabela quando a página está marcada como totalmente visível para todas as transações [18]. Numa tabela muito alterada e com o VACUUM atrasado, o plano diz Index Only Scan, mas visita a tabela quase sempre. É mais um motivo para manter o autovacuum em dia.
Por fim, criar um índice numa tabela grande em produção trava as gravações durante a construção; o CREATE INDEX CONCURRENTLY evita esse bloqueio, em mais tempo, e, se falhar no meio, deixa um índice inválido para apagar e criar de novo.
Tipos de dados e JSONB
Os tipos de dados são um dos pontos fortes do PostgreSQL. Além dos de qualquer banco, ele tem uuid, tipos de endereço de rede, arrays de qualquer tipo, tipos geométricos e intervalos (daterange, tstzrange), que guardam um começo e um fim e respondem a "contém" e "sobrepõe" [7]. Duas escolhas de tipo evitam a maior parte dos problemas: valores em dinheiro em numeric, e não no tipo money nem em ponto flutuante, e instantes em timestamptz, e não em timestamp sem fuso [38].
O tipo json, desde a 9.2, guarda uma cópia exata do texto e o interpreta de novo a cada uso. O jsonb, desde a 9.4, guarda o documento já decomposto num formato binário: a gravação é um pouco mais lenta, mas o processamento é bem mais rápido, e ele aceita índices [26]. Em troca, o jsonb não preserva espaços em branco, a ordem das chaves nem chaves repetidas; quando há chaves repetidas, fica só a última [26]. A documentação recomenda o jsonb para a maioria das aplicações [26].
O operador mais útil do jsonb é o de contenção, @>, que pergunta se um documento contém outro, em qualquer nível:
SELECT id, dados->>'nome'
FROM produtos
WHERE dados @> '{"categoria": "bebidas", "tags": ["gelada"]}';
Um índice GIN acelera esse tipo de consulta. A classe padrão, jsonb_ops, cria entradas para cada chave e cada valor e atende também às perguntas de existência de chave (?); a classe jsonb_path_ops só atende à contenção e às consultas por caminho, mas gera um índice bem menor e, em geral, mais rápido [26]. Desde a versão 17, o JSON_TABLE transforma um documento JSON numa tabela que pode ser usada no FROM de uma consulta [7].
O JSONB é ótimo para dados que mudam de forma de um registro para outro, como atributos de produtos, mas não substitui colunas: o que é filtrado com frequência ou ligado a outras tabelas fica melhor numa coluna própria, com tipo e restrições.
Busca textual
Procurar produtos ou documentos com LIKE '%termo%' funciona em tabelas pequenas e decepciona nas grandes. A documentação resume as três falhas desse caminho: não entende a língua, e não acha "cafés" quando se busca "café"; não ordena os resultados por relevância, o que torna inútil uma busca que encontra milhares de linhas; e é lenta, porque precisa ler cada documento a cada busca [45].
A busca textual do PostgreSQL resolve as três. Um documento é convertido num tsvector, a lista de lexemas, as palavras já normalizadas, com a posição de cada uma; a pergunta vira um tsquery, com termos combinados por "e", "ou", "não" e "seguido de"; e o operador @@ diz se um combina com o outro [45]. A normalização é feita por dicionários: eles passam tudo para minúsculas, tiram sufixos para chegar ao radical da palavra, descartam as palavras vazias, como artigos e preposições, que aparecem em todo texto e não ajudam a distinguir nenhum, e podem tratar sinônimos [45]. A distribuição traz um dicionário de radicais para o português, o portuguese_stem [46].
ALTER TABLE produtos
  ADD COLUMN busca tsvector
  GENERATED ALWAYS AS (to_tsvector('portuguese', coalesce(nome, '') || ' ' || coalesce(descricao, ''))) STORED;

CREATE INDEX produtos_busca ON produtos USING gin (busca);

SELECT id, nome, ts_rank_cd(busca, q) AS relevancia
FROM produtos, websearch_to_tsquery('portuguese', 'café torrado -descafeinado') AS q
WHERE busca @@ q
ORDER BY relevancia DESC
LIMIT 20;
O índice pode ser criado de duas formas. Um índice de expressão sobre to_tsvector('portuguese', ...) ocupa menos disco, mas só é usado quando a consulta repete a mesma expressão com o mesmo nome de configuração; uma coluna gerada com o tsvector, como no exemplo, deixa as consultas mais simples e as buscas mais rápidas, porque o índice não precisa recalcular o vetor para conferir cada resultado [47]. Para ordenar por relevância, o ts_rank considera a frequência dos termos, e o ts_rank_cd também a proximidade entre eles; o websearch_to_tsquery aceita a sintaxe de um buscador da web, com aspas para frases, or e o sinal de menos para excluir, e nunca dá erro de sintaxe, o que o torna seguro para receber o texto digitado pelo usuário [48]. Para buscar trechos no meio de palavras ou tolerar erros de digitação, o caminho continua sendo o pg_trgm [27]; os dois se complementam.
Extensões: o banco que cresce sem ser modificado
A extensibilidade é a herança mais visível do projeto de Stonebraker. Além de tipos, funções e operadores próprios, o PostgreSQL aceita funções escritas em várias linguagens: PL/pgSQL, Perl, Python e Tcl vêm com ele, e outras, como Java, JavaScript, R, Lua e Rust, chegam por extensões [4].
Uma extensão é um pacote de objetos SQL (tipos, funções, operadores, índices) instalado de uma vez com CREATE EXTENSION, desde a 9.1 [7]. O comando registra os objetos só no banco em que foi executado, e deve ser rodado por um superusuário, exceto nas extensões marcadas como confiáveis, que qualquer usuário com permissão de criação no banco pode instalar [27]. A própria distribuição traz um conjunto de módulos opcionais, conhecido como contrib [27]. Alguns que aparecem em quase todo servidor:
- pg_stat_statements: guarda estatísticas de planejamento e execução de cada consulta, agrupadas pelo formato; é o primeiro lugar a olhar quando o banco fica lento [27].
- pg_trgm: mede a semelhança entre textos por trigramas e permite índices para buscas com
LIKE '%trecho%'e para buscas aproximadas de nomes [27]. - pgcrypto: funções de criptografia e de hash [27].
- postgres_fdw: acessa tabelas de outros servidores PostgreSQL como se fossem locais [27].
CREATE EXTENSION IF NOT EXISTS pg_stat_statements;

SELECT calls, round(mean_exec_time::numeric, 1) AS ms_medio, query
FROM pg_stat_statements
ORDER BY total_exec_time DESC
LIMIT 10;
O pg_stat_statements também precisa estar em shared_preload_libraries, na configuração do servidor, para coletar os dados.
Fora da distribuição, duas extensões mostram até onde o modelo vai. O PostGIS acrescenta ao PostgreSQL o armazenamento, a indexação e a consulta de dados geoespaciais, e transforma o banco num sistema de informação geográfica [29]. O pgvector acrescenta um tipo de vetor e a busca por similaridade, com distância euclidiana, por produto interno ou por cosseno, e índices aproximados HNSW e IVFFlat [28]. É o que permite guardar os embeddings de documentos ao lado dos dados de negócio e fazer buscas semânticas no mesmo banco:
CREATE EXTENSION vector;
CREATE TABLE trechos (id bigserial PRIMARY KEY, texto text, embedding vector(768));
SELECT id, texto FROM trechos ORDER BY embedding <=> $1 LIMIT 5;
As tabelas externas (foreign data wrappers), desde a 9.1, levam a mesma ideia a dados fora do banco, como um arquivo CSV ou outro servidor, consultados como tabelas locais [7].
Particionamento e tabelas grandes
Uma tabela de logs que recebe milhões de linhas por mês acaba enfrentando dois problemas: consultas que só querem o mês atual passam por índices enormes, e apagar os meses antigos com DELETE gera milhões de versões mortas para o VACUUM limpar. O particionamento declarativo, desde a versão 10, divide uma tabela lógica em várias tabelas físicas, as partições [7][30]. Há três formas: por faixa de valores, como meses; por lista de valores, como estados; e por hash, que distribui as linhas de forma uniforme [30].
CREATE TABLE logs (
  id          bigint GENERATED ALWAYS AS IDENTITY,
  cliente_id  int NOT NULL,
  criado_em   timestamptz NOT NULL,
  dados       jsonb
) PARTITION BY RANGE (criado_em);

CREATE TABLE logs_2026_11 PARTITION OF logs
  FOR VALUES FROM ('2026-11-01') TO ('2026-12-01');
Os ganhos aparecem quando a maior parte dos acessos cai em poucas partições: os índices de cada uma cabem melhor na memória, e o planejador descarta as partições que não podem conter o que a consulta pede, tanto no planejamento quanto na execução [30]. Remover dados antigos vira DETACH PARTITION ou DROP TABLE de uma partição, sem o custo de um DELETE em massa nem o trabalho do VACUUM depois [30]. A documentação dá uma regra prática: o particionamento costuma compensar quando a tabela ficaria maior que a memória física do servidor [30]. Em tabelas menores, ele acrescenta complexidade sem ganho.
Segurança: quem entra e o que pode ver
A segurança no PostgreSQL começa antes do SQL, no arquivo pg_hba.conf, que diz quais conexões são aceitas e como cada cliente prova quem é [32]. Cada linha combina um tipo de conexão (local, TCP/IP, TCP/IP com TLS), um banco, um usuário, uma faixa de endereços e um método de autenticação. A primeira linha que combina com a conexão decide; se a autenticação falhar, as linhas seguintes não são consultadas, e se nenhuma combinar, a conexão é recusada [32]:
# tipo    banco   usuário   endereço          método
local     all     postgres                    peer
hostssl   erp     api       10.0.0.0/24       scram-sha-256
host      all     all       0.0.0.0/0         reject
O método recomendado para senhas é o scram-sha-256, que desde a versão 14 é também o formato padrão em que as senhas são guardadas [7][34]. O método md5 está obsoleto e será removido numa versão futura, e o trust, que aceita a conexão sem senha, nunca deve ser usado em conexões de rede, porque qualquer cliente pode se apresentar como qualquer usuário, inclusive o superusuário [32][38]. O parâmetro listen_addresses, que vem como localhost, define em quais interfaces o servidor escuta [34]; expor a porta 5432 na internet, mesmo com senha, é desnecessário na maioria dos casos.
Dentro do banco, as permissões são dadas a roles com GRANT e REVOKE. A boa prática é a do menor privilégio: a aplicação conecta com uma role que só pode fazer o que precisa, sem ser dona das tabelas nem superusuária.
Para sistemas com dados de vários clientes na mesma tabela, a segurança por linha (row-level security), desde a 9.5, filtra as linhas que cada role pode ver e alterar [7][31]. Ligada numa tabela, ela nega tudo até que uma política permita; cada política é uma expressão booleana avaliada linha a linha [31]:
ALTER TABLE pedidos ENABLE ROW LEVEL SECURITY;

CREATE POLICY por_empresa ON pedidos
  USING (empresa_id = current_setting('app.empresa_id')::int);
Superusuários e roles com o atributo BYPASSRLS sempre passam por cima das políticas, e o dono da tabela também, a menos que ela tenha FORCE ROW LEVEL SECURITY [31]. Por isso, a política só protege de verdade quando a aplicação usa uma role comum.
Backups e recuperação
Existem duas famílias de backup no PostgreSQL, e um plano sério usa as duas.
O backup lógico é feito pelo pg_dump, que exporta um banco como comandos SQL ou num formato próprio. Ele gera uma cópia coerente mesmo com o banco em uso e não bloqueia leituras nem gravações [35]. O formato custom (-Fc) é comprimido e permite restaurar só parte do conteúdo, numa ordem escolhida; o formato directory (-Fd) é o único que permite gerar a cópia em paralelo; e os dois permitem restaurar em paralelo com o pg_restore -j [35]. O pg_dump exporta um banco só; roles e tablespaces, que são do servidor inteiro, saem com o pg_dumpall --globals-only [35].
pg_dump -Fc -d erp -f erp-2026-11-03.dump
pg_restore -j 4 -d erp_teste erp-2026-11-03.dump
pg_dumpall --globals-only > globais.sql
O backup lógico é portátil entre versões e ótimo para levar dados a outro ambiente, mas a própria documentação lembra que, exceto em casos simples, ele não é a forma certa de fazer os backups regulares de bancos de produção [35]: a restauração recria tudo do zero e só devolve o banco ao instante da cópia.
O backup físico copia os arquivos do servidor, com o pg_basebackup ou ferramentas próprias, e se combina com o arquivamento contínuo do WAL. Com uma cópia física e todo o WAL desde ela, é possível restaurar o banco em qualquer instante coberto pelo log: basta instalar a cópia e reaplicar o WAL até o momento desejado [20]. É a recuperação até um ponto no tempo, que existe desde a 8.0 [7], e é o que permite voltar o banco para as 14h32, um minuto antes de alguém rodar um DELETE sem WHERE. Desde a versão 17, o pg_basebackup também faz backups incrementais, só com o que mudou desde o anterior, e o pg_combinebackup junta as partes [7].
Qualquer que seja o método, um backup só existe de verdade depois de restaurado com sucesso, e restaurar periodicamente num servidor de teste é a única forma de saber se a cópia serve e quanto tempo a volta leva.
Versões e atualizações
O PostgreSQL publica uma versão principal por ano, com recursos novos, e versões menores pelo menos a cada três meses, só com correções de erros e de segurança [6]. Cada versão principal recebe correções por cinco anos a partir do lançamento; depois disso, sai uma última versão menor e ela chega ao fim da vida [6]. Em outubro de 2026, as versões com suporte são a 14, a 15, a 16, a 17 e a 18; a 14, lançada em 30 de setembro de 2021, deixa de receber correções em 12 de novembro de 2026, e a 18, lançada em 25 de setembro de 2025, tem suporte até 14 de novembro de 2030 [6].
As versões menores não mudam o formato dos arquivos: atualizar de 17.10 para 17.11 é instalar os binários novos e reiniciar o servidor, e o pg_upgrade não é necessário [36]. Ficar para trás nas versões menores é deixar de lado correções de segurança sem nenhum ganho, e é o atraso mais fácil de evitar.
Já a troca de versão principal, como da 16 para a 18, exige converter o catálogo. Há três caminhos. O pg_dump seguido do pg_restore é o mais simples e o mais lento. O pg_upgrade recria as tabelas do sistema e reaproveita os arquivos de dados como estão; no modo --link, que usa ligações físicas em vez de copiar os arquivos, a atualização leva minutos mesmo em bancos grandes, com a ressalva de que o servidor antigo não pode mais ser usado depois que o novo sobe [36]. Desde o PostgreSQL 18, o pg_upgrade também mantém as estatísticas do planejador, o que evita as consultas lentas das primeiras horas depois da troca [7]. E a replicação lógica permite atualizar com uma parada de segundos, como descrito antes [24]. O pg_upgrade --check confere a compatibilidade antes de qualquer mudança [36].
Configuração e monitoramento
A configuração fica no arquivo postgresql.conf e também pode ser alterada pelo comando ALTER SYSTEM, desde a 9.4 [7]. Alguns parâmetros valem depois de um SELECT pg_reload_conf(); outros, como shared_buffers e max_connections, só depois de reiniciar o servidor [33][34]. Os valores padrão foram escolhidos para subir em qualquer máquina, não para aproveitar um servidor dedicado.
SHOW shared_buffers;
ALTER SYSTEM SET work_mem = '16MB';
SELECT pg_reload_conf();
Para saber o que o servidor está fazendo, as visões de estatísticas respondem quase tudo:
pg_stat_activity: as conexões, a consulta de cada uma, há quanto tempo ela roda e se espera uma trava [9].pg_stat_statements: as consultas que mais consomem tempo no total [27].pg_stat_user_tables: por tabela, as leituras sequenciais e por índice, as linhas mortas, a última passagem do VACUUM e as atualizações HOT [17].pg_stat_replicationepg_replication_slots: o atraso das réplicas e os slots que seguram WAL [23].pg_locks: quem trava quem [9].
SELECT pid, now() - xact_start AS tempo, state, left(query, 60)
FROM pg_stat_activity
WHERE state = 'idle in transaction'
ORDER BY tempo DESC;
Erros comuns
A maior parte dos problemas com PostgreSQL em produção se repete. Os mais frequentes:
- Transações esquecidas. Uma conexão que abriu uma transação e não a fechou impede o VACUUM de remover qualquer versão que ela ainda poderia ver, em todas as tabelas, e segura travas. O sintoma é o inchaço sem explicação. O parâmetro
idle_in_transaction_session_timeoutencerra essas sessões depois de um tempo. - Conexões demais. Cada conexão é um processo; centenas de conexões ociosas consomem memória e disputam CPU. A resposta é um pool, não um
max_connectionsmaior [8][34]. - **
VACUUM FULLcomo rotina, ou autovacuum desligado.** O primeiro trava a tabela inteira [18]; o segundo troca um custo pequeno e contínuo por inchaço, estatísticas velhas e, no limite, o estouro do contador de transações. - Chave estrangeira sem índice. O PostgreSQL cria índice automático na chave primária e nas restrições
UNIQUE, mas não na coluna que referencia outra tabela. Apagar uma linha do pai passa a varrer a tabela filha inteira. - **
NOT INcom subconsulta.** Se a subconsulta devolver um únicoNULL, o resultado é vazio. UseNOT EXISTS[38]. - **
BETWEENcom datas e horas.** Os dois extremos entram, e um registro exatamente à meia-noite é contado em dois dias. Use>=no começo e<no fim [38]. - **
money,char(n)evarchar(n)por hábito.** Omoneydepende da configuração regional e não guarda a moeda; ochar(n)completa com espaços; o limite devarchar(n)escolhido sem motivo vira erro de gravação no futuro. Usenumericetext, com uma restriçãoCHECKquando o limite for regra de negócio [38]. - Slot de replicação abandonado. Uma réplica desligada com o slot ativo enche o disco do principal com WAL [23].
Como usamos o PostgreSQL na Gothor
Os clientes da Gothor trabalham com o Winthor, cujo banco de dados é o Oracle, e as nossas integrações respeitam esse banco como ele é: a estrutura é do ERP, e o nosso trabalho é ler e gravar nele com cuidado. Nos sistemas que a Gothor desenvolve além da integração com o ERP, o banco padrão é o PostgreSQL, pelas razões que este artigo percorreu: é aberto, segue o padrão SQL de perto, protege as transações com o MVCC e o WAL e cresce com extensões em vez de exigir outro produto a cada necessidade nova. Os cuidados descritos aqui, como mudanças de estrutura versionadas, índices pensados a partir das consultas e operações concorrentes resolvidas pelo próprio banco, fazem parte do nosso dia a dia.
Resumo
- O servidor cria um processo por conexão, com uma memória compartilhada e processos de fundo para os checkpoints, o WAL e o autovacuum. Conexões demais se resolvem com um pool.
- Os dados ficam em páginas de 8 kB; cada linha é uma sequência de versões marcadas com a transação que as criou (
xmin) e a que as encerrou (xmax). Valores grandes vão para o TOAST. - Uma consulta passa por análise, reescrita, planejamento e execução. O planejador escolhe pelo custo estimado, com base nas estatísticas; o
EXPLAIN (ANALYZE, BUFFERS)mostra a escolha e onde a estimativa errou. - O MVCC faz cada instrução ler uma fotografia dos dados: leitura não bloqueia escrita, e escrita não bloqueia leitura. O nível padrão é o Read Committed; no Serializable, a aplicação repete as transações que falham com
40001. - As travas continuam existindo: um
ALTER TABLEna fila bloqueia quem chega depois dele, e olock_timeoutevita que uma migração pare a aplicação. - O VACUUM remove as versões mortas, atualiza as estatísticas e o mapa de visibilidade e congela as linhas antigas para evitar o estouro do contador de transações de 32 bits. O autovacuum faz isso sozinho, desde que nada o impeça.
- O WAL grava cada alteração num log sequencial antes dos arquivos de dados. Ele garante o
COMMIT, a recuperação depois de uma queda, a replicação e a recuperação até um ponto no tempo. - A replicação por streaming copia o servidor inteiro; a lógica copia tabelas escolhidas, inclusive entre versões diferentes.
- Além da B-tree, há índices Hash, GiST, SP-GiST, GIN e BRIN, e índices parciais, de expressão e com colunas incluídas.
- Uma versão principal por ano, cinco anos de suporte, versões menores a cada três meses. As menores se aplicam trocando os binários; as principais, com
pg_upgradeou replicação lógica.
Fontes
- A Brief History of PostgreSQL — postgresql.org
- PostgreSQL – Wikipédia, a enciclopédia livre — pt.wikipedia.org
- Michael Stonebraker – Wikipedia — en.wikipedia.org
- About PostgreSQL — postgresql.org
- PostgreSQL License — postgresql.org
- Versioning Policy — postgresql.org
- PostgreSQL Release Notes — postgresql.org
- Architectural Fundamentals — postgresql.org
- Standard Unix Tools (os processos do servidor) — postgresql.org
- Database File Layout — postgresql.org
- Database Page Layout — postgresql.org
- TOAST — postgresql.org
- The Path of a Query — postgresql.org
- Planner/Optimizer — postgresql.org
- Concurrency Control: Introduction — postgresql.org
- Transaction Isolation — postgresql.org
- Heap-Only Tuples (HOT) — postgresql.org
- Routine Vacuuming — postgresql.org
- Automatic Vacuuming (parâmetros) — postgresql.org
- Write-Ahead Logging (WAL) — postgresql.org
- WAL Configuration — postgresql.org
- WAL Internals — postgresql.org
- Log-Shipping Standby Servers — postgresql.org
- Logical Replication — postgresql.org
- Index Types — postgresql.org
- JSON Types — postgresql.org
- Additional Supplied Modules and Extensions — postgresql.org
- pgvector — github.com
- PostGIS — postgis.net
- Table Partitioning — postgresql.org
- Row Security Policies — postgresql.org
- The pg_hba.conf File — postgresql.org
- Resource Consumption — postgresql.org
- Connections and Authentication — postgresql.org
- pg_dump — postgresql.org
- pg_upgrade — postgresql.org
- SQL Conformance — postgresql.org
- Don't Do This — wiki.postgresql.org
- Explicit Locking — postgresql.org
- Lock Management (parâmetros) — postgresql.org
- How Parallel Query Works — postgresql.org
- When Can Parallel Query Be Used? — postgresql.org
- System Information Functions (pg_blocking_pids) — postgresql.org
- Client Connection Defaults (lock_timeout) — postgresql.org
- Full Text Search: Introduction — postgresql.org
- Full Text Search: psql Support — postgresql.org
- Full Text Search: Tables and Indexes — postgresql.org
- Full Text Search: Controlling Text Search — postgresql.org
Este post foi escrito com a ajuda da Juniper, a assistente de IA da Gothor, e revisado pela nossa equipe antes de ir ao ar.