Docker por dentro: como os contêineres empacotam e isolam aplicações
Uma imersão em imagens, camadas, contêineres, redes, volumes e Compose, de dentro para fora: o que o kernel faz para isolar um processo, como escrever um Dockerfile enxuto e seguro, como diagnosticar problemas e como levar uma aplicação do build à produção, com o jeito como usamos Docker na Gothor.
Toda equipe de software já ouviu a frase: "na minha máquina funciona". O sistema roda no computador de quem escreveu e quebra no servidor, porque lá a versão do Node é outra, falta uma biblioteca ou o fuso horário é diferente. Durante décadas, a resposta foram manuais de instalação longos, scripts frágeis e servidores configurados à mão, cada um um pouco diferente do outro.
O Docker mudou essa conversa. Em vez de descrever como preparar uma máquina para rodar a aplicação, você empacota a aplicação junto com tudo de que ela precisa numa imagem, e essa imagem roda do mesmo jeito no notebook, no servidor de integração contínua e em produção. Este artigo explica o que acontece por baixo disso: o que é um contêiner para o sistema operacional, como as imagens são montadas em camadas, como escrever um Dockerfile bom e como organizar redes, volumes e vários serviços com o Compose.
O que é o Docker, e o que é um contêiner
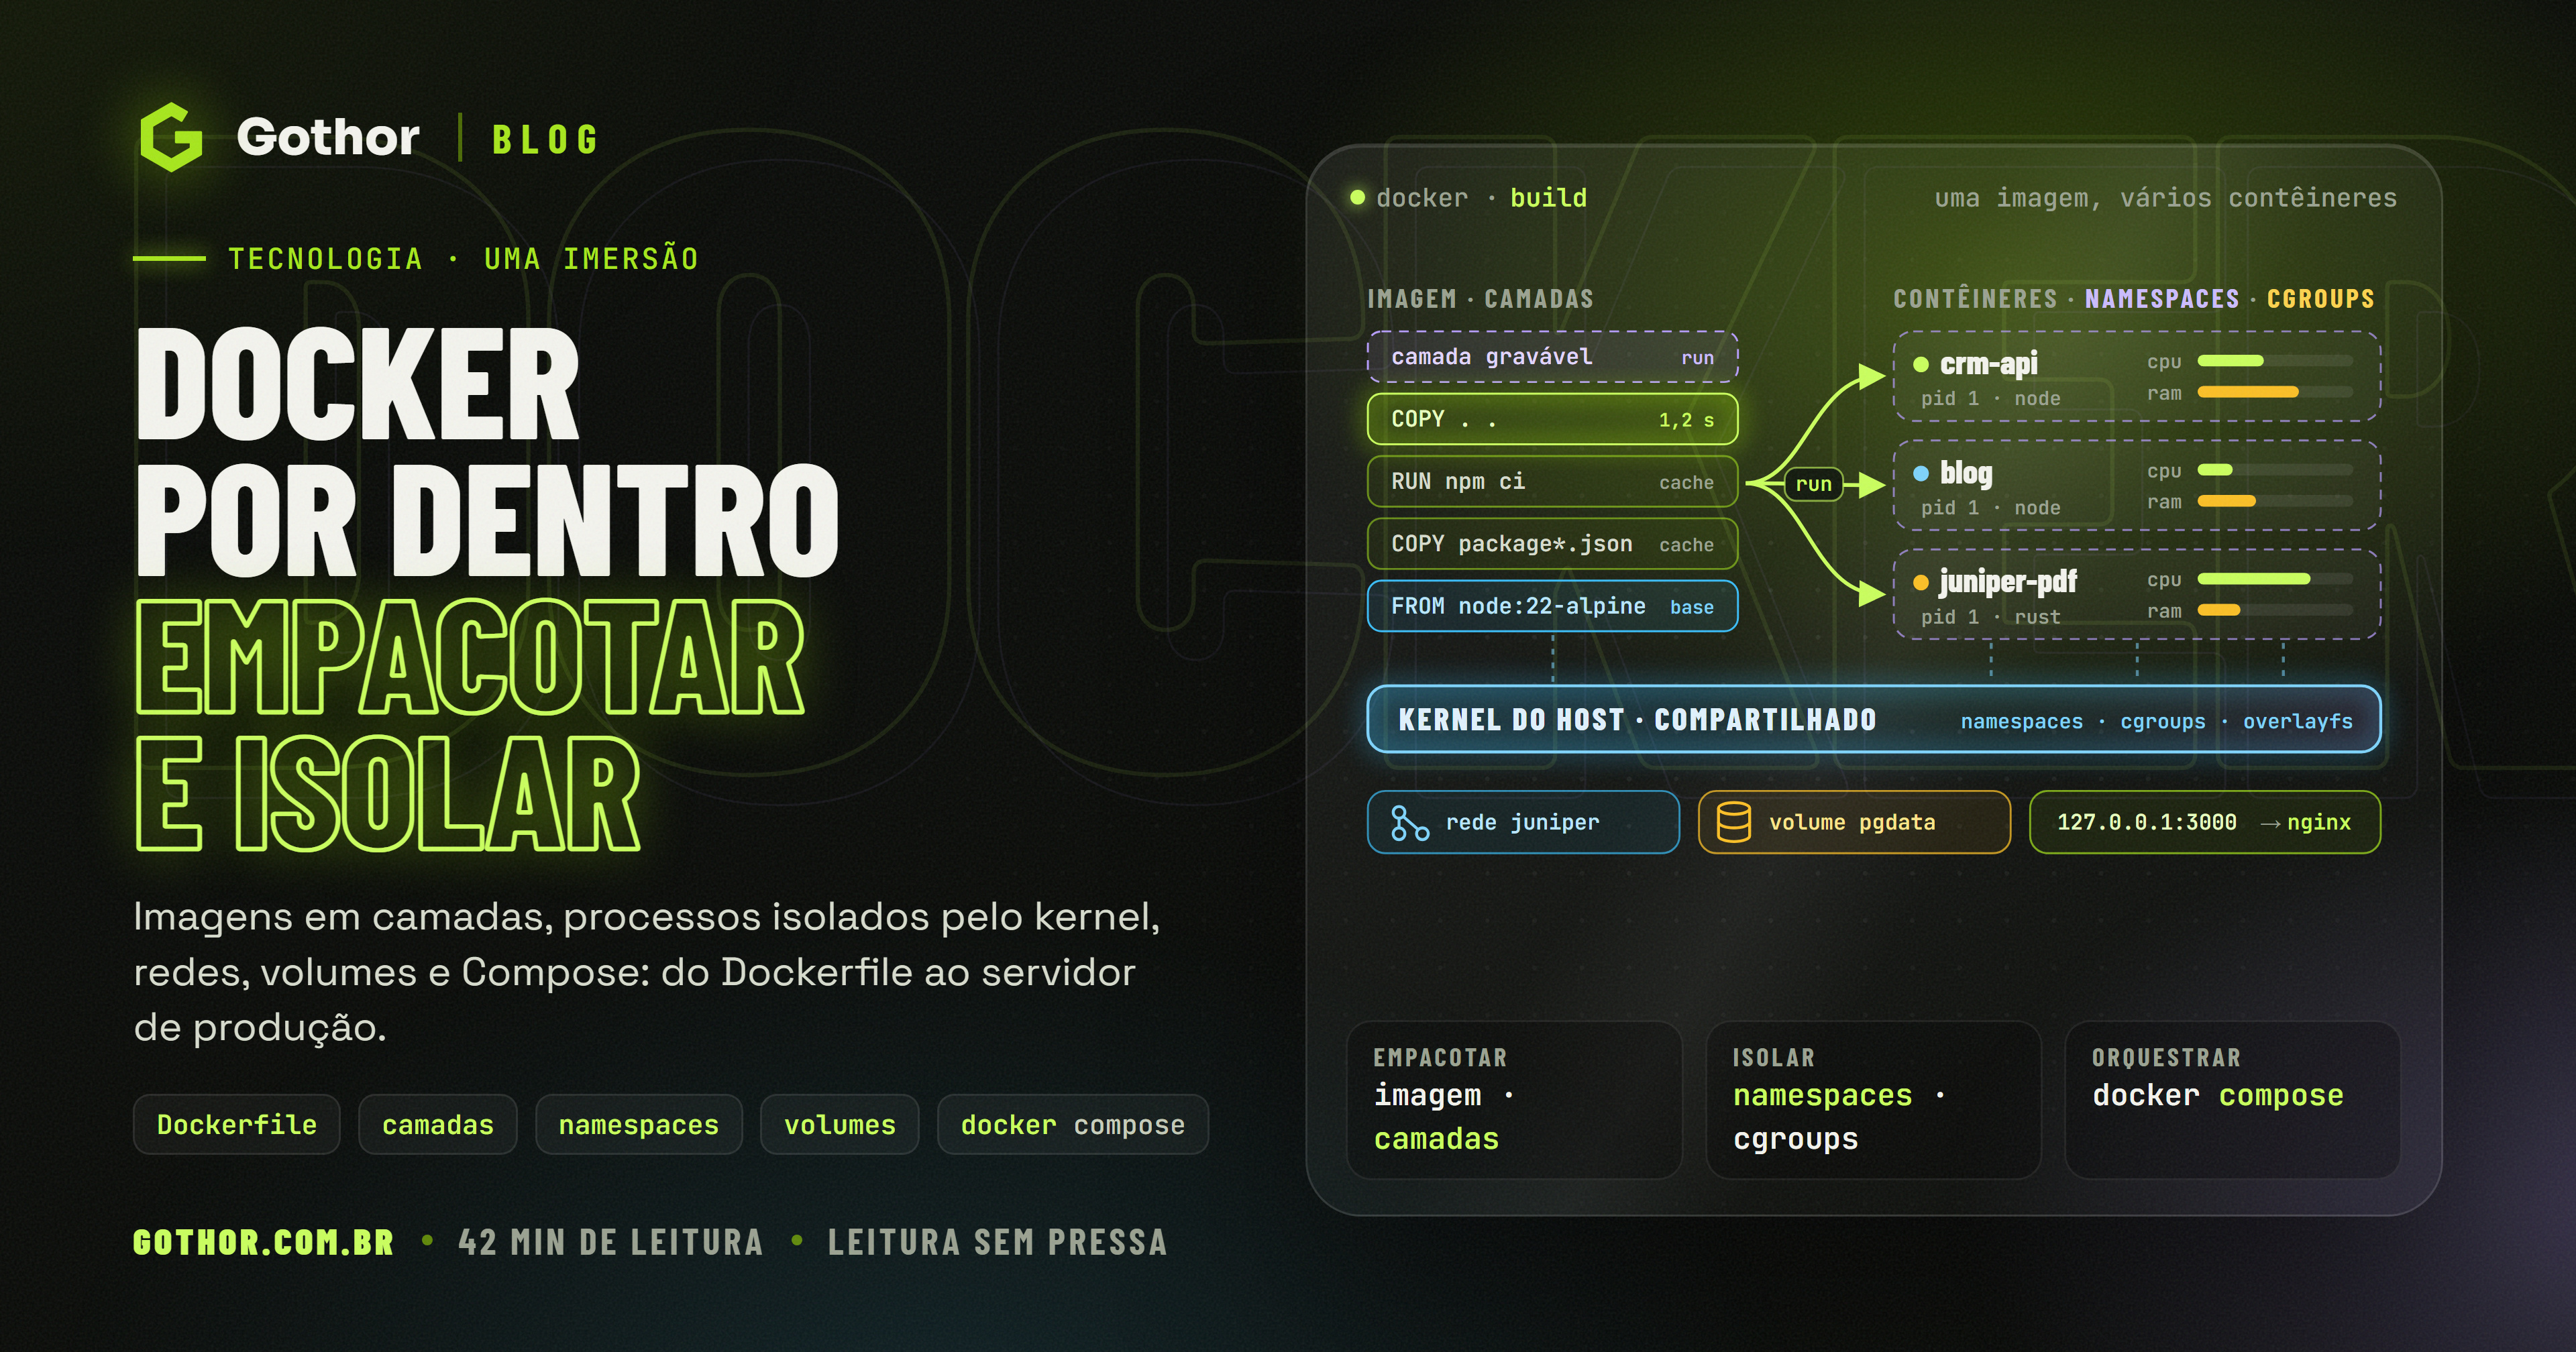
O Docker é uma plataforma para construir, distribuir e executar contêineres. Um contêiner é um processo comum do sistema operacional que roda com uma visão isolada da máquina: ele enxerga o seu próprio sistema de arquivos, a sua própria rede e os seus próprios processos, e tem limites de CPU e memória definidos.
Quatro palavras aparecem o tempo todo, e vale fixá-las desde já:
- Imagem: o pacote imutável com o sistema de arquivos da aplicação (binários, bibliotecas, código, configuração padrão) e os metadados de como executá-la. É o equivalente a uma classe.
- Contêiner: uma imagem em execução, com uma camada própria onde pode gravar. É o equivalente a um objeto: da mesma imagem saem quantos contêineres você quiser.
- Dockerfile: a receita, em texto, que diz como construir a imagem.
- Registro: o servidor que guarda e distribui imagens, como o Docker Hub ou o GitHub Container Registry.
Também vale separar o Docker da ideia de contêiner. Contêineres são um recurso do kernel Linux, e o formato das imagens é padronizado pela Open Container Initiative (OCI): uma imagem construída com o Docker roda no Podman, no containerd ou no Kubernetes. O Docker popularizou a ideia, mas não é dono dela.
Uma história curta: do chroot ao Docker
A ideia de isolar processos é antiga. Em 1979, o Unix ganhou o chroot, que faz um processo enxergar uma subpasta como se fosse /. Vieram depois as jails do FreeBSD, em 2000, e as Zones do Solaris, em 2004.
No Linux, os namespaces começaram em 2002 e os cgroups, criados por engenheiros do Google para limitar recursos de grupos de processos, entraram no kernel em 2008. No mesmo ano surgiu o LXC, que juntava essas peças. A tecnologia existia, mas era trabalhosa e não tinha uma forma simples de empacotar e distribuir uma aplicação.
Em março de 2013, Solomon Hykes apresentou o Docker numa palestra relâmpago na PyCon. A empresa dele, a dotCloud, oferecia hospedagem de aplicações e tinha construído internamente uma ferramenta para empacotá-las. O Docker não inventou o isolamento; inventou a experiência: um arquivo de texto para descrever a imagem, um comando para construí-la, outro para executá-la e um registro público para compartilhá-la. A dotCloud mudou o nome para Docker no mesmo ano, e a versão 1.0 saiu em junho de 2014.
O crescimento levou à padronização. Em 2015, o Docker e outras empresas fundaram a OCI e doaram o runc, o executor de contêineres de baixo nível; em 2017, o containerd foi doado à Cloud Native Computing Foundation. Em 2022, o Kubernetes passou a falar direto com o containerd, sem o Docker Engine no meio, o que não mudou nada para quem constrói imagens. Do lado do desenvolvedor, o BuildKit virou o construtor padrão em 2023, e o Compose virou um subcomando, docker compose.
Contêiner não é máquina virtual
A comparação mais comum é com máquinas virtuais, e a diferença é fundamental para entender tanto as vantagens quanto os limites dos contêineres.
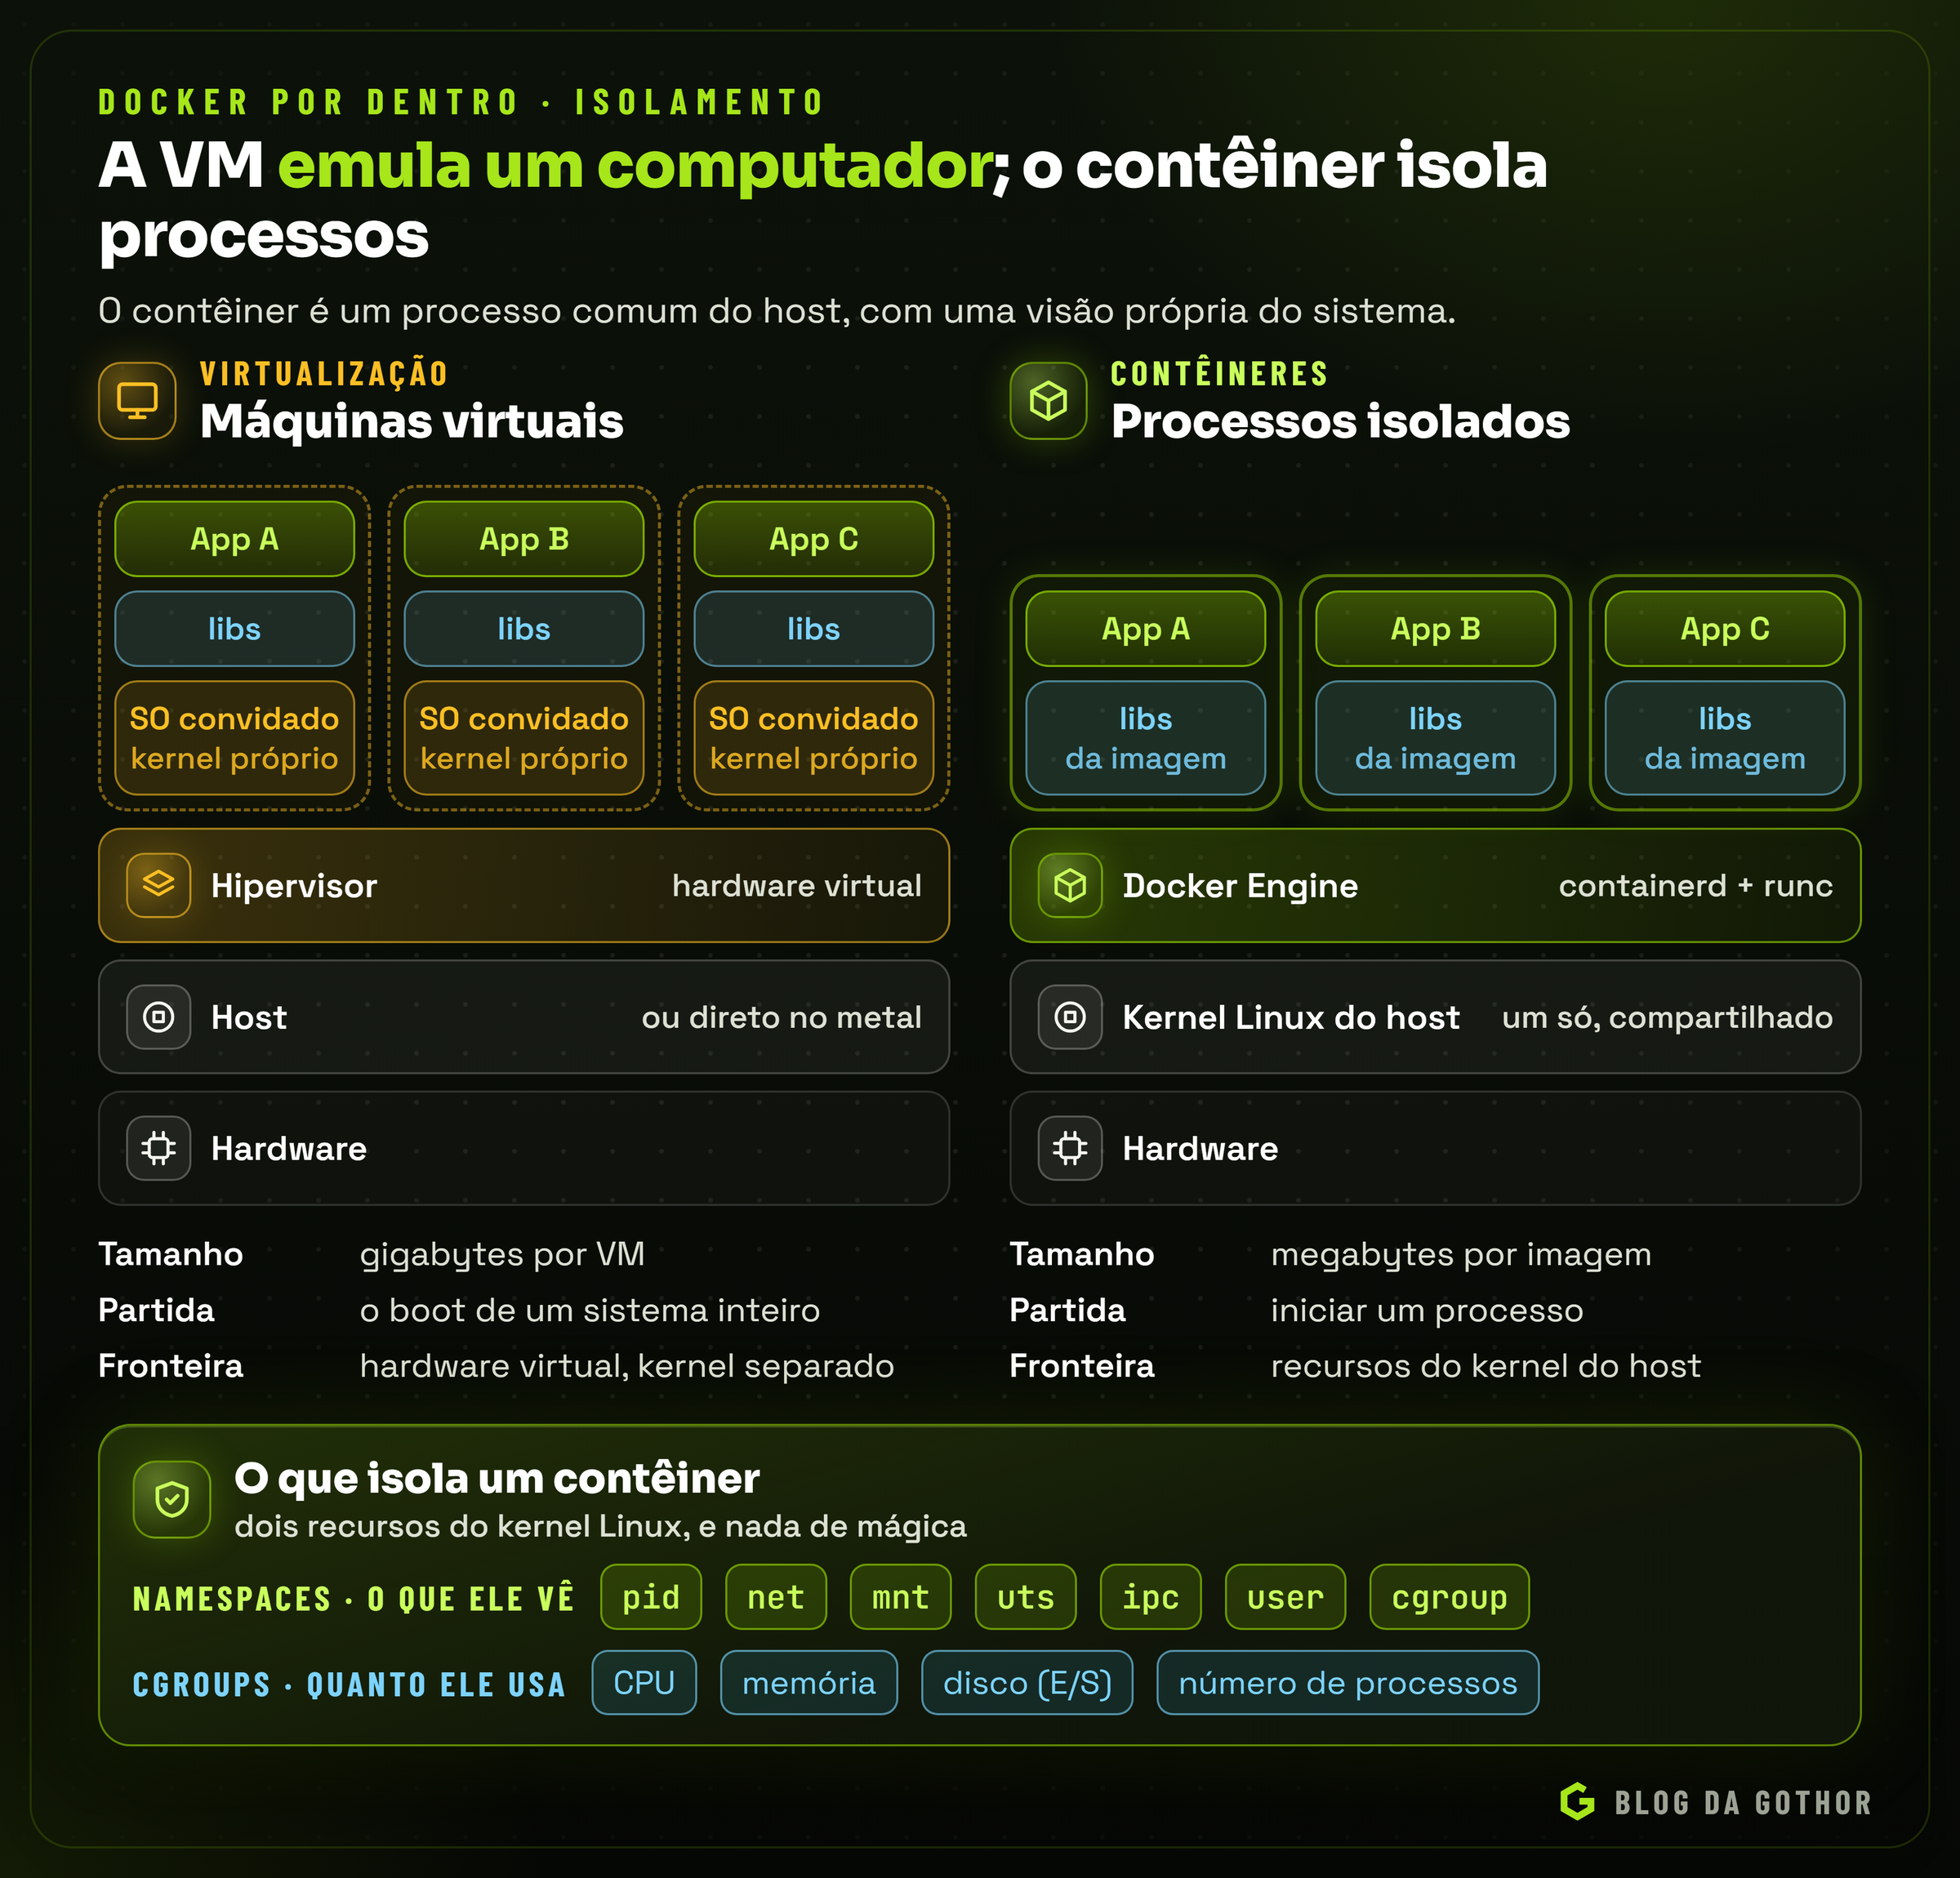
Uma máquina virtual emula um computador inteiro: o hipervisor oferece hardware virtual, e sobre ele roda um sistema operacional completo, com kernel próprio. Cada VM ocupa gigabytes e leva o tempo de um boot para subir, mas o isolamento é forte.
Um contêiner não emula nada. Ele é um processo do host, executado pelo mesmo kernel que executa todos os outros processos da máquina. O que muda é o que esse processo consegue ver e quanto ele pode usar. Por isso um contêiner sobe no tempo de iniciar um processo, e uma imagem costuma ter de dezenas a centenas de megabytes, porque não carrega um kernel.
Namespaces: o que o processo vê
Um namespace dá a um processo uma cópia isolada de algum recurso global do sistema. Os principais:
- pid: o contêiner tem a sua própria árvore de processos. Lá dentro, a aplicação é o processo 1 e não enxerga os processos do host.
- net: interfaces de rede, endereços IP, tabelas de rotas e portas próprias. Duas aplicações em contêineres diferentes podem escutar na mesma porta 3000 sem conflito.
- mnt: os pontos de montagem. É o que faz o contêiner enxergar o sistema de arquivos da imagem como
/. - uts: o nome da máquina (hostname).
- ipc: a memória compartilhada e as filas de mensagens entre processos.
- user: o mapeamento de usuários. O root de dentro do contêiner pode corresponder a um usuário sem privilégios do host.
- cgroup: a visão da própria hierarquia de cgroups.
cgroups: quanto o processo usa
Os control groups limitam e medem o consumo de recursos de um grupo de processos: CPU, memória, leitura e escrita em disco, número de processos. Quando você roda docker run --memory 512m, é um cgroup que garante o limite; se o processo passar dele, o kernel o encerra, e o Docker registra que o contêiner morreu por falta de memória. Sem limites, um contêiner com vazamento de memória pode derrubar todos os outros da mesma máquina.
Nas distribuições atuais, os cgroups estão na versão 2, que organiza tudo numa árvore única de pastas em /sys/fs/cgroup. Cada contêiner ganha a sua pasta, e os limites são arquivos de texto comuns: memory.max guarda o teto de memória em bytes, e cpu.max guarda uma cota de tempo de CPU por período. É assim que --cpus 1.5 funciona: em cada janela de 100 milissegundos, os processos do contêiner podem usar 150 milissegundos de CPU, somando todos os núcleos. Passou da cota, o kernel os faz esperar a próxima janela, o que aparece como lentidão, e não como erro.
Dois cuidados práticos. O primeiro é que memória e CPU se comportam de forma diferente no limite: CPU em excesso só deixa o processo mais lento; memória em excesso o mata. O segundo é que programas com gerenciamento de memória próprio precisam conhecer o limite. A JVM e o Node modernos leem o cgroup para dimensionar o heap, mas definir o tamanho explicitamente (como -Xmx na JVM ou --max-old-space-size no Node) deixa o comportamento previsível e evita que o coletor de lixo deixe a memória crescer até o teto.
Vendo o isolamento com os próprios olhos
Nada disso é abstrato. Alguns comandos mostram o isolamento funcionando:
docker run --rm alpine ps          # só um processo, o próprio ps, com o PID 1
docker run --rm alpine hostname    # um nome aleatório, não o do host
docker run -d --name teste --memory 256m nginx:alpine
docker inspect --format '{{.State.Pid}}' teste   # o PID do mesmo processo visto do host
ps -o pid,user,cmd -p <esse PID>                  # no host, ele é um processo como outro qualquer
ls -l /proc/<esse PID>/ns                          # os namespaces a que ele pertence
O processo que é o PID 1 lá dentro tem outro número do lado de fora, e o ps do host o mostra normalmente. O comando nsenter, do pacote util-linux, permite até "entrar" nos namespaces de um contêiner a partir do host, o que é útil para depurar uma imagem que não tem nenhuma ferramenta dentro.
O que acontece num docker run
O comando docker que você digita é só um cliente. Por trás dele há uma cadeia de programas, cada um com uma responsabilidade, e conhecê-la ajuda a entender mensagens de erro e o ecossistema.
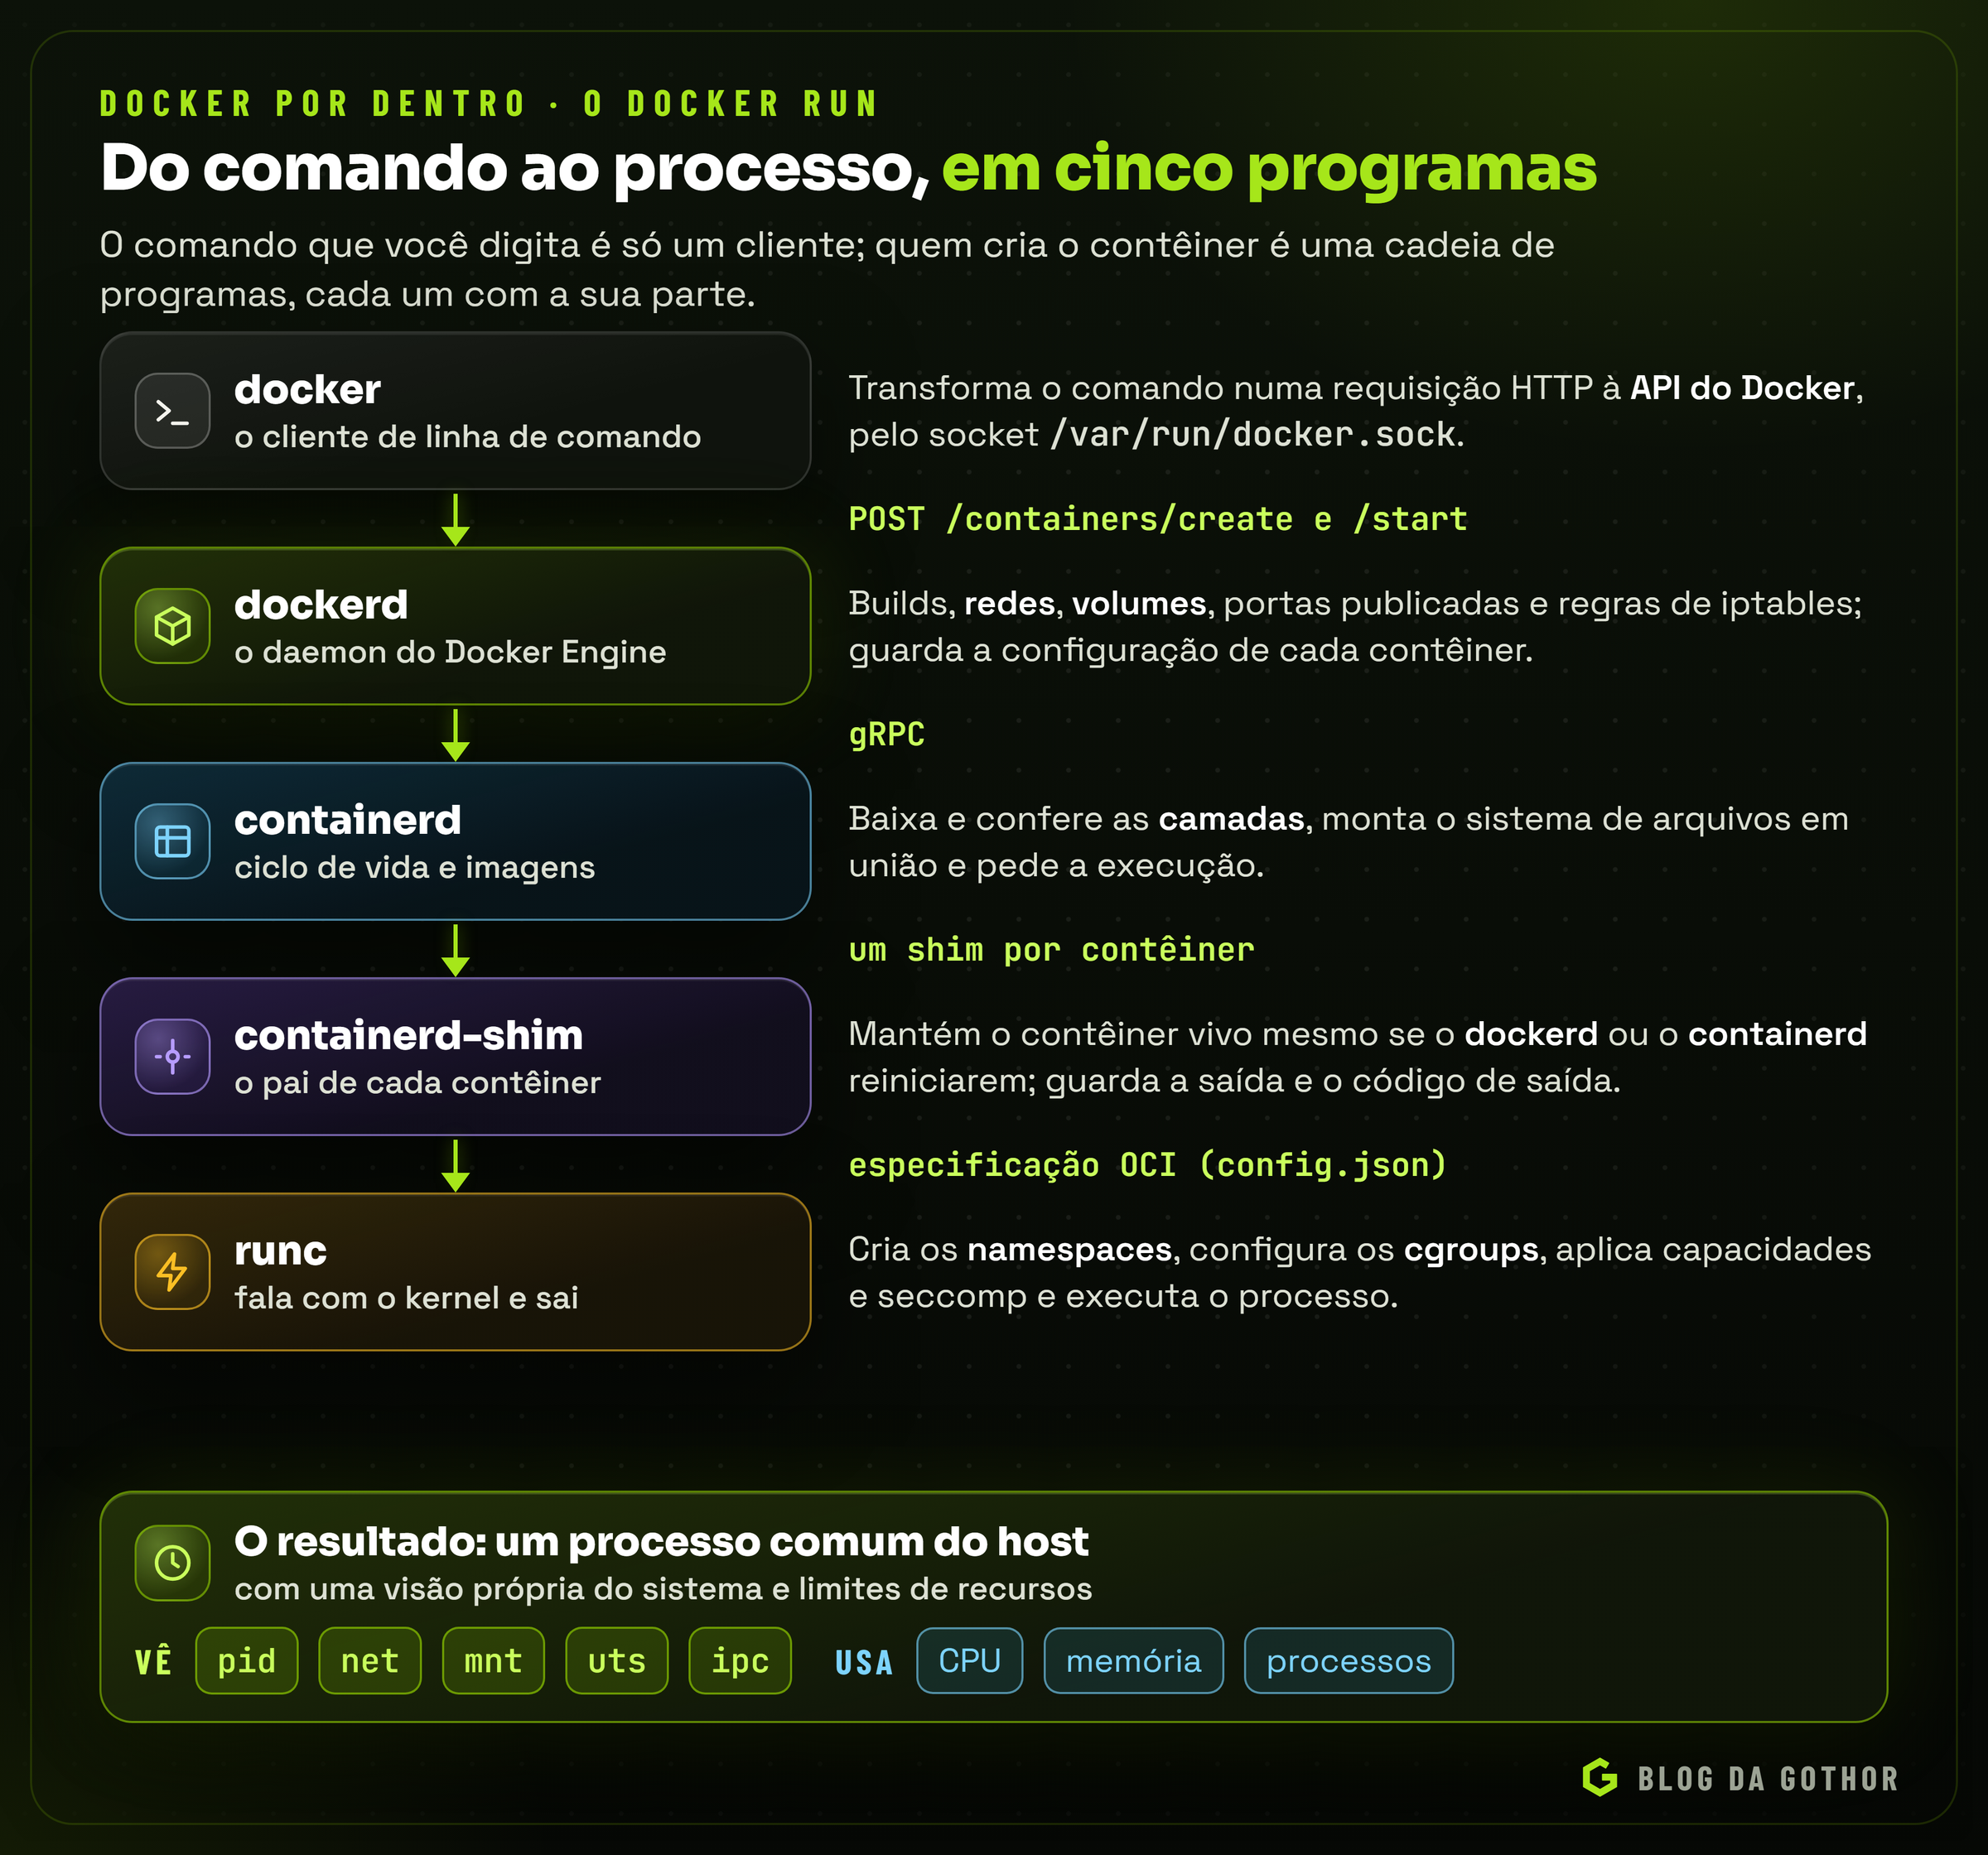
- **O cliente
docker** transforma o comando numa requisição HTTP para a API do Docker, por padrão pelo socket Unix/var/run/docker.sock. - **O
dockerd**, o daemon do Docker Engine, cuida do que é específico do Docker: construir imagens, criar redes e volumes, publicar portas, guardar a configuração dos contêineres. - **O
containerd** gerencia o ciclo de vida dos contêineres e das imagens: baixa as camadas, monta o sistema de arquivos e pede a execução. - **O
containerd-shim** fica como pai de cada contêiner. Ele permite que odockerde ocontainerdsejam reiniciados (numa atualização, por exemplo) sem derrubar os contêineres em execução, e guarda a saída e o código de saída do processo. - **O
runc** é quem conversa com o kernel: cria os namespaces, configura os cgroups, prepara o sistema de arquivos, aplica as restrições de segurança e executa o processo da aplicação. Feito isso, ele sai de cena.
Na prática, um docker run -d -p 127.0.0.1:8890:8890 api:1.4.2 percorre esta sequência:
- O cliente pede ao daemon para criar e iniciar um contêiner com aquela imagem.
- Se a imagem não está no disco, o daemon a baixa do registro, camada por camada, conferindo cada uma pelo hash.
- O daemon cria a camada gravável e monta o sistema de arquivos em união.
- Cria a interface de rede do contêiner, liga-a à rede bridge, reserva um endereço IP e escreve as regras de
iptablesque redirecionam a porta 8890 do loopback do host. - Monta a especificação OCI do contêiner (o comando, as variáveis, o usuário, os limites, os namespaces) e a entrega ao containerd, que chama o runc.
- O runc cria o processo isolado e sai; o shim fica como pai do processo, e o cliente devolve o identificador do contêiner.
Todo esse trabalho leva frações de segundo quando a imagem já está no disco, e é por isso que contêineres sobem tão depressa.
O kernel é compartilhado, e isso tem consequências
Como todos os contêineres usam o kernel do host, três coisas decorrem disso:
- Contêineres Linux precisam de um kernel Linux. No Windows e no macOS, o Docker Desktop roda uma máquina virtual Linux leve por baixo (no Windows, normalmente pelo WSL 2), e os contêineres rodam nela.
- O isolamento é mais fraco que o de uma VM. Uma falha no kernel pode, em tese, permitir que um processo escape do contêiner. Para cargas de terceiros não confiáveis, existem alternativas que somam uma camada de virtualização, como gVisor e Kata Containers.
- Root no contêiner é perigoso. Sem namespace de usuário, o root de dentro do contêiner é o root do host com algumas restrições. Por isso a recomendação de rodar a aplicação com um usuário comum aparece em toda recomendação de segurança.
| Aspecto | Máquina virtual | Contêiner |
|---|---|---|
| O que isola | um computador inteiro, com kernel próprio | um processo, com recursos do kernel do host |
| Tamanho típico | gigabytes | megabytes |
| Tempo para subir | o boot de um sistema | o início de um processo |
| Fronteira de segurança | hardware virtual | namespaces, cgroups e filtros de chamadas de sistema |
| Melhor uso | sistemas operacionais diferentes, isolamento forte | empacotar e escalar aplicações |
Imagens: camadas, cache e endereços
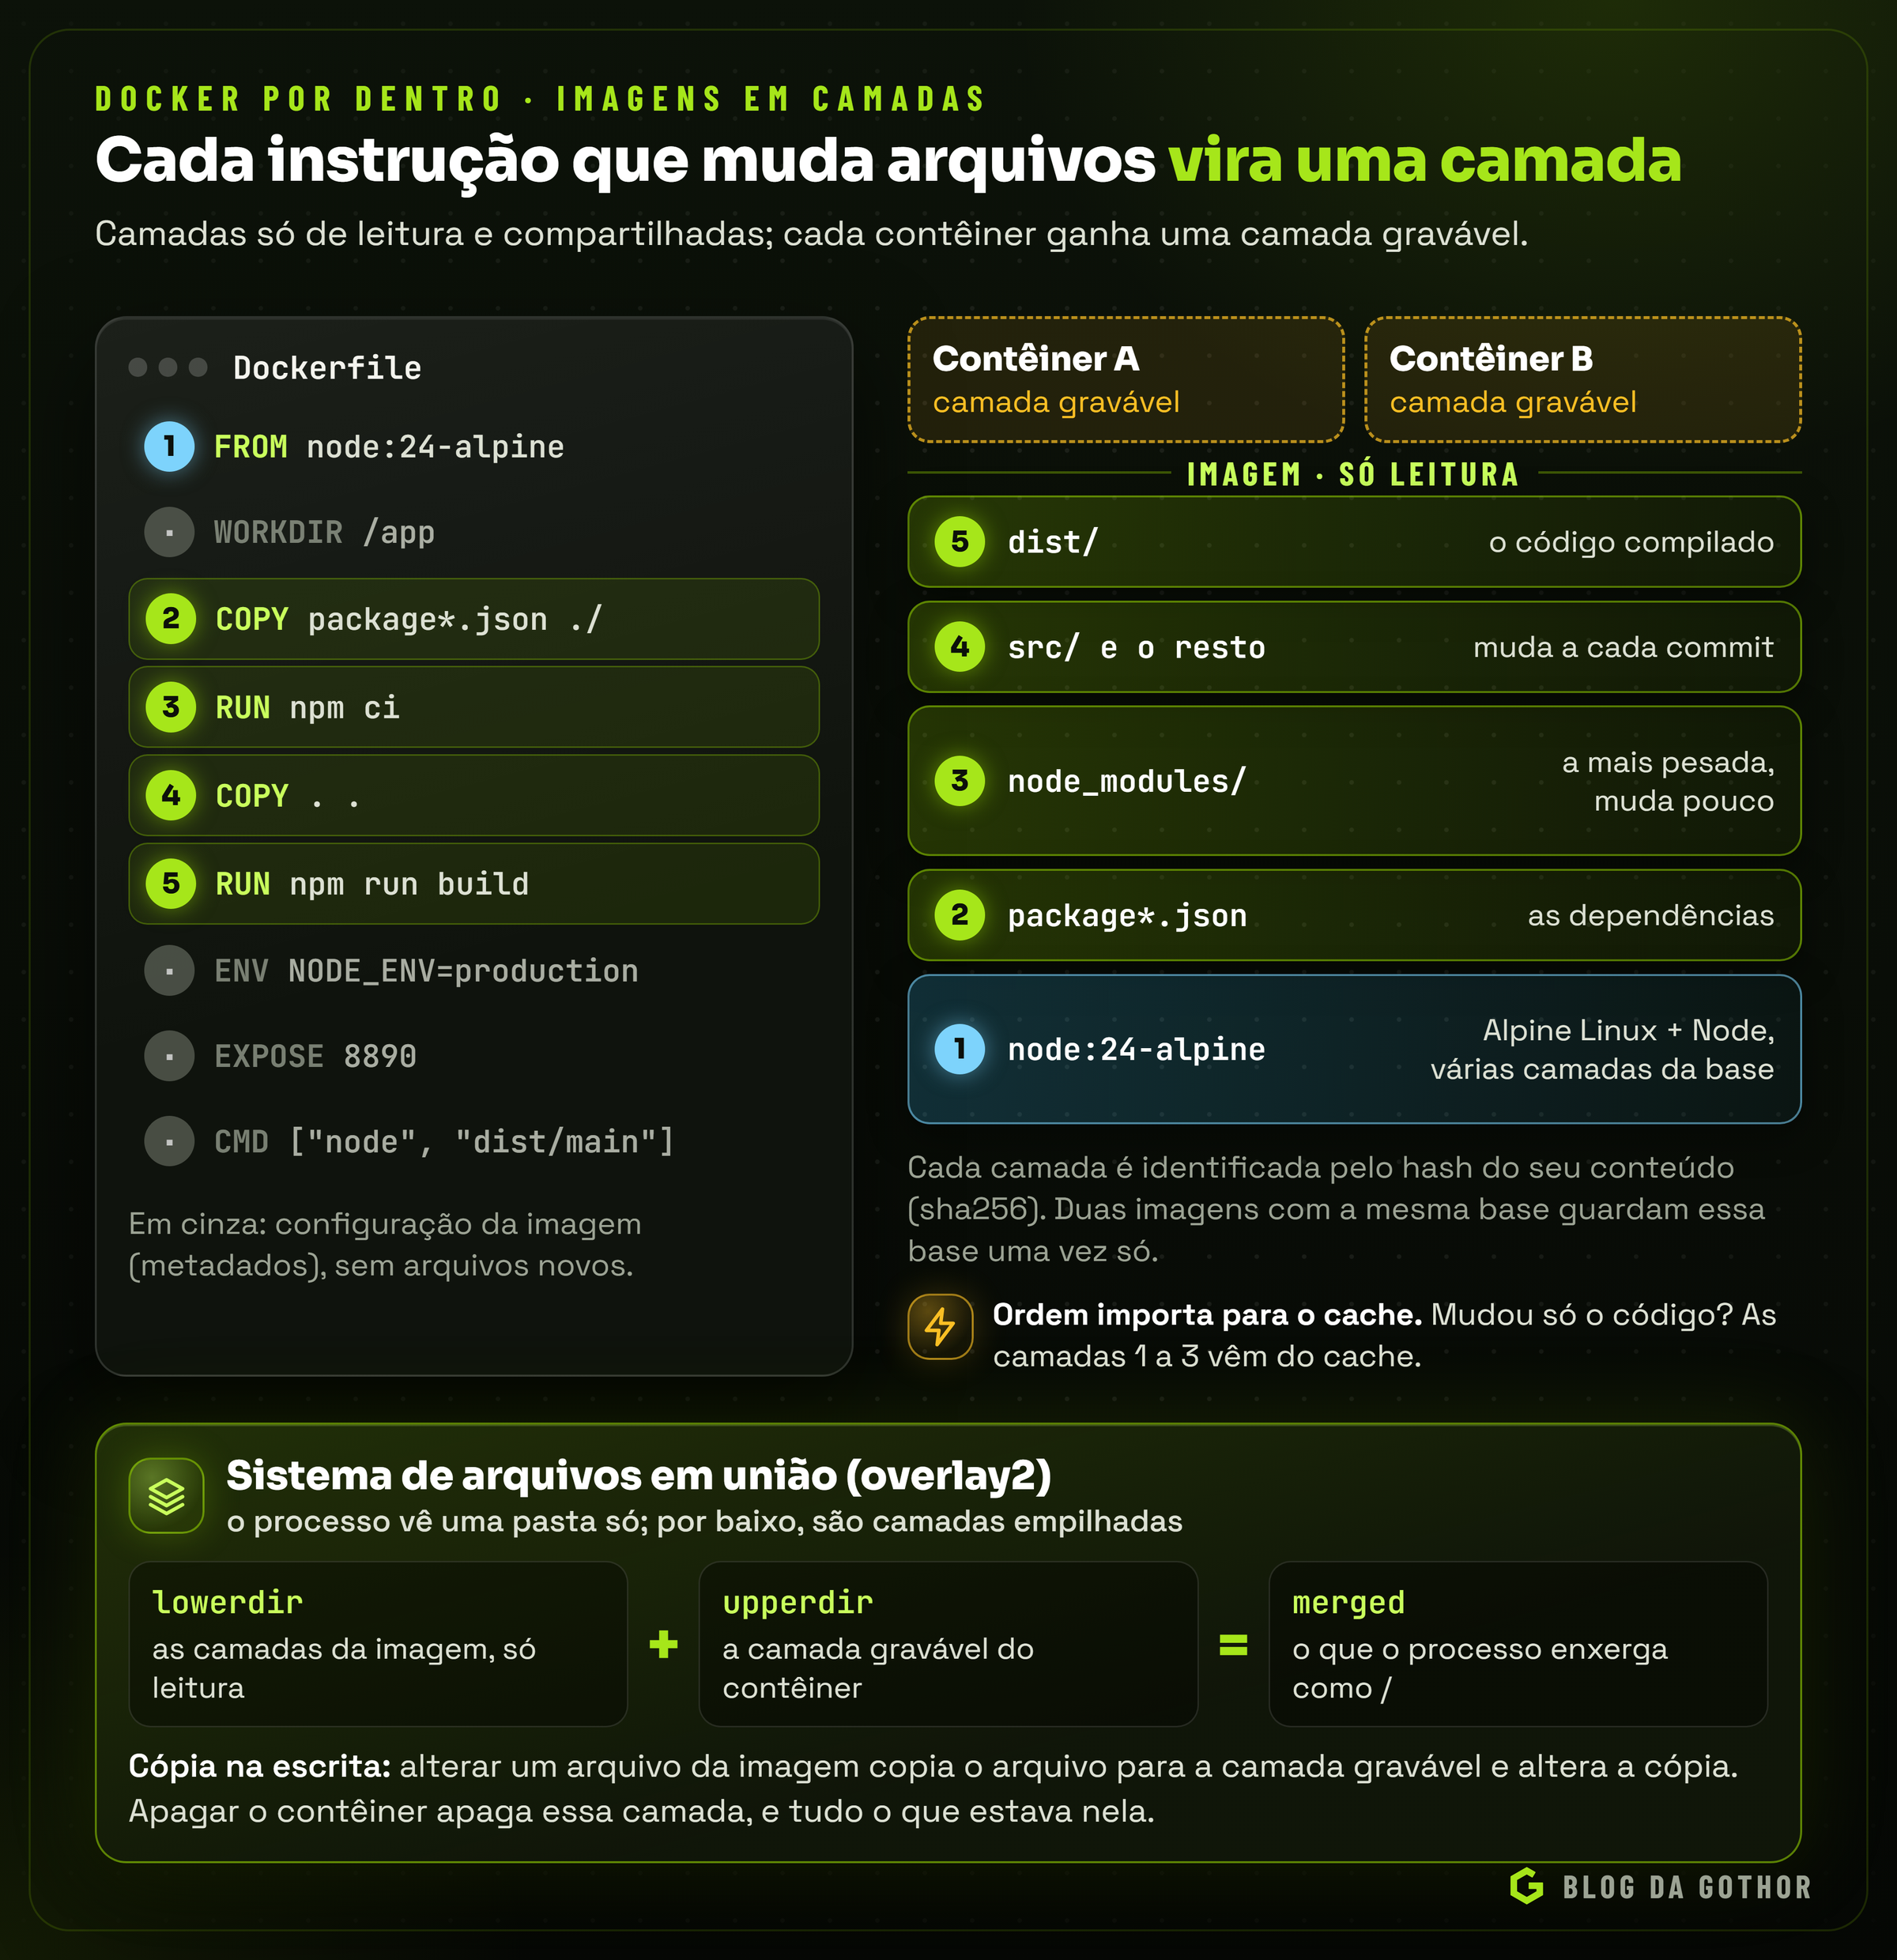
Uma imagem não é um arquivo único. Ela é uma pilha de camadas, cada uma com as diferenças de sistema de arquivos introduzidas por uma instrução do Dockerfile, mais um arquivo de configuração com os metadados (o comando padrão, as variáveis de ambiente, o usuário, as portas) e um manifesto que lista tudo isso.
Camadas e o sistema de arquivos em união
As camadas são somente leitura e identificadas pelo hash SHA-256 do seu conteúdo, a mesma ideia de endereçamento por conteúdo que o Git usa para os commits. Duas imagens construídas sobre a mesma base compartilham essas camadas no disco e na rede: o servidor só baixa o que ainda não tem.
Quando um contêiner é criado, o Docker empilha as camadas da imagem e coloca por cima uma camada gravável, exclusiva daquele contêiner. Um sistema de arquivos em união, normalmente o overlay2, apresenta tudo isso ao processo como uma pasta só. Ler um arquivo é procurá-lo de cima para baixo nas camadas. Alterar um arquivo que veio da imagem dispara uma cópia na escrita: o arquivo é copiado para a camada gravável e a cópia é alterada, enquanto a imagem continua intacta.
Daí vem uma regra que evita muita dor de cabeça: a camada gravável é descartável. Quando o contêiner é removido, ela vai junto. Tudo o que precisa sobreviver, como os dados de um banco, vai para um volume, que veremos adiante.
O cache de build
Ao construir uma imagem, o BuildKit verifica, instrução a instrução, se já tem uma camada pronta para aquela instrução com aquela entrada. Para um RUN, a entrada é o texto do comando e a camada anterior; para um COPY, é também o conteúdo dos arquivos copiados. Se nada mudou, a camada vem do cache. Se algo mudou, aquela instrução e todas as seguintes são refeitas.
É por isso que a ordem das instruções importa tanto. Copiar primeiro só o package.json e o package-lock.json, instalar as dependências e só depois copiar o resto do código faz com que uma mudança no código não reinstale as dependências, que é a etapa mais lenta.
Tags e digests
Uma imagem tem dois tipos de nome. A tag, como node:24-alpine ou api:1.4.2, é um rótulo legível e móvel: o dono da imagem pode apontá-la para outra versão amanhã. A tag latest não tem nada de especial; é só o nome usado quando nenhum outro é informado, e não garante que a imagem seja a mais recente.
O digest, como node@sha256:..., é o hash do manifesto e é imutável: o mesmo digest sempre devolve exatamente as mesmas camadas. Em produção, fixar a versão com uma tag específica já é muito melhor que usar latest; fixar pelo digest garante reprodutibilidade total.
Uma mesma tag também pode servir várias arquiteturas (linux/amd64, linux/arm64), e cada máquina baixa a sua variante.
O que há dentro de uma imagem
Por baixo do nome, uma imagem OCI é um punhado de arquivos JSON e de pacotes compactados. Um índice lista as variantes por arquitetura; cada variante tem um manifesto, que aponta para um arquivo de configuração e para as camadas, todos pelo hash:
{
  "schemaVersion": 2,
  "mediaType": "application/vnd.oci.image.manifest.v1+json",
  "config": { "digest": "sha256:3b1f…", "size": 7023 },
  "layers": [
    { "mediaType": "application/vnd.oci.image.layer.v1.tar+gzip", "digest": "sha256:9c1e…", "size": 3624711 },
    { "mediaType": "application/vnd.oci.image.layer.v1.tar+gzip", "digest": "sha256:7a44…", "size": 41203874 }
  ]
}
Cada camada é um arquivo tar compactado com os arquivos acrescentados ou alterados. Arquivos apagados aparecem como marcadores especiais (whiteouts), e é por isso que apagar um arquivo grande numa instrução posterior não diminui a imagem: ele continua inteiro na camada anterior. Quem precisa baixar algo grande, usar e descartar deve fazer tudo no mesmo RUN, ou num estágio separado. Para ver de onde vem o tamanho de uma imagem, docker history lista as camadas com o tamanho de cada uma, e ferramentas como o dive mostram o conteúdo camada a camada. Imagens para várias arquiteturas são construídas com o docker buildx build --platform linux/amd64,linux/arm64, que gera o índice e uma variante para cada plataforma.
Escolhendo a imagem base
A primeira linha do Dockerfile decide boa parte do tamanho, da segurança e até do comportamento da imagem:
| Base | Tamanho aproximado | O que tem | Cuidados |
|---|---|---|---|
| Debian ou Ubuntu completos | dezenas de MB a mais | shell, gerenciador de pacotes, muitas ferramentas | mais pacotes para atualizar e mais superfície de ataque |
variantes slim | menores | o essencial do Debian, com a glibc | um bom equilíbrio para a maioria dos casos |
| Alpine | poucos MB | shell e apk, sobre a biblioteca musl | binários compilados para a glibc podem não rodar; diferenças sutis em DNS e desempenho |
| distroless | mínimo | só o necessário para executar o programa, sem shell | depurar exige outras técnicas, como uma imagem de depuração ou o nsenter |
scratch | vazio | nada | só para binários estáticos, que não dependem de bibliotecas |
A diferença entre a musl e a glibc merece atenção. As duas implementam a biblioteca C do sistema, mas não são iguais: um programa ou uma biblioteca nativa compilada para uma pode não rodar na outra, e algumas bibliotecas de aprendizado de máquina e de criptografia exigem versões recentes da glibc. Quando a aplicação usa módulos nativos, uma base slim costuma dar menos surpresas que a Alpine.
O Dockerfile, instrução por instrução
O Dockerfile é a parte do Docker com que você mais vai conviver. Um exemplo completo para uma API em Node.js com TypeScript, em três estágios:
# Estágio 1: instala tudo e compila
FROM node:24-alpine AS build
WORKDIR /app
COPY package.json package-lock.json ./
RUN npm ci --no-audit --no-fund
COPY . .
RUN npm run build

# Estágio 2: mantém só as dependências de produção
FROM build AS podado
RUN npm prune --omit=dev

# Estágio 3: a imagem final, sem compilador nem código-fonte
FROM node:24-alpine
ENV NODE_ENV=production
WORKDIR /app
COPY --from=podado /app/node_modules ./node_modules
COPY --from=podado /app/dist ./dist
COPY package.json ./
USER node
EXPOSE 8890
HEALTHCHECK --interval=30s --timeout=5s CMD wget -qO- http://127.0.0.1:8890/saude || exit 1
CMD ["node", "dist/main"]
As instruções mais usadas, e o que cada uma faz:
| Instrução | O que faz | Cria camada? |
|---|---|---|
FROM | escolhe a imagem base e inicia um estágio | usa as da base |
WORKDIR | define a pasta de trabalho das instruções seguintes | só se criar a pasta |
COPY | copia arquivos do contexto ou de outro estágio | sim |
ADD | como o COPY, mas também baixa URLs e extrai arquivos compactados | sim |
RUN | executa um comando durante o build | sim |
ENV | define variáveis de ambiente para o build e a execução | não, é metadado |
ARG | define variáveis que existem só durante o build | não |
USER | define o usuário que executa os comandos seguintes e a aplicação | não |
EXPOSE | documenta a porta que a aplicação usa (não publica nada) | não |
HEALTHCHECK | define como o Docker verifica se a aplicação está saudável | não |
CMD e ENTRYPOINT | definem o comando executado quando o contêiner sobe | não |
Builds em vários estágios
O exemplo acima usa multi-stage build: vários FROM no mesmo arquivo, cada um iniciando um estágio, e COPY --from levando para o estágio final só o que interessa. O compilador do TypeScript, as dependências de desenvolvimento e o código-fonte ficam para trás. A imagem final fica menor, sobe mais rápido e tem menos programas que um atacante poderia aproveitar. Um estágio intermediário também pode ser alvo de um build próprio, com docker build --target nome, o que é útil para gerar uma imagem auxiliar, como a que roda as migrações de um banco.
CMD, ENTRYPOINT e o processo 1
O CMD e o ENTRYPOINT aceitam duas formas, e a diferença tem consequências reais:
- A forma exec, com colchetes (
CMD ["node", "dist/main"]), executa o programa diretamente. Ele é o processo 1 do contêiner e recebe os sinais do sistema. - A forma shell, sem colchetes (
CMD node dist/main), executa/bin/sh -c "node dist/main". O processo 1 passa a ser o shell, que nem sempre repassa os sinais para a aplicação.
Isso importa no desligamento. O docker stop envia SIGTERM ao processo 1, espera dez segundos por padrão e então envia SIGKILL, que encerra na hora. Quem recebe o SIGTERM pode terminar as requisições em andamento e fechar conexões; quem não recebe é morto no meio do trabalho. Use a forma exec e trate o SIGTERM na aplicação.
O processo 1 e os processos zumbis
Ser o processo 1 traz duas responsabilidades que um programa comum não tem. A primeira é com os sinais: o kernel não aplica ao PID 1 o comportamento padrão de sinais que ele não trata. Um processo comum que recebe SIGTERM sem ter um tratador é encerrado; o PID 1, nas mesmas condições, simplesmente ignora o sinal, e o contêiner só para no SIGKILL, dez segundos depois. A segunda é com os processos zumbis: quando um processo filho termina, alguém precisa recolher o seu código de saída, e no Linux os órfãos são adotados pelo PID 1. Uma aplicação que cria subprocessos e não os recolhe acumula zumbis até esgotar o limite de processos.
A solução para os dois problemas é a mesma: tratar os sinais na aplicação e, quando ela cria subprocessos, colocar um init mínimo na frente. A opção docker run --init (ou init: true no Compose) faz exatamente isso, com o tini, que repassa os sinais e recolhe os zumbis. Um desligamento limpo numa API em Node fica assim:
const servidor = app.listen(8890);

process.on('SIGTERM', () => {
  // para de aceitar conexões novas e espera as requisições em andamento terminarem
  servidor.close(async () => {
    await banco.desconectar();
    process.exit(0);
  });
  // se algo travar, sai antes do SIGKILL
  setTimeout(() => process.exit(1), 8_000).unref();
});
Frameworks como o NestJS trazem isso pronto (enableShutdownHooks), e o prazo pode ser ajustado com docker stop -t ou com o stop_grace_period do Compose, quando a aplicação precisa de mais tempo para terminar o que está fazendo.
O contexto e o .dockerignore
O último argumento do docker build, normalmente um ., é o contexto: a pasta cujo conteúdo fica disponível para os COPY. Tudo o que está nela é enviado ao construtor, por isso um .dockerignore é obrigatório em qualquer projeto real:
node_modules
dist
.git
.env
*.log
coverage
Sem ele, o build envia node_modules e o histórico do Git à toa, o cache se invalida sem motivo e um .env com senhas pode acabar dentro da imagem.
Do build ao servidor
Com o Dockerfile pronto, o caminho até a produção tem poucos passos, e cada um corresponde a um comando.
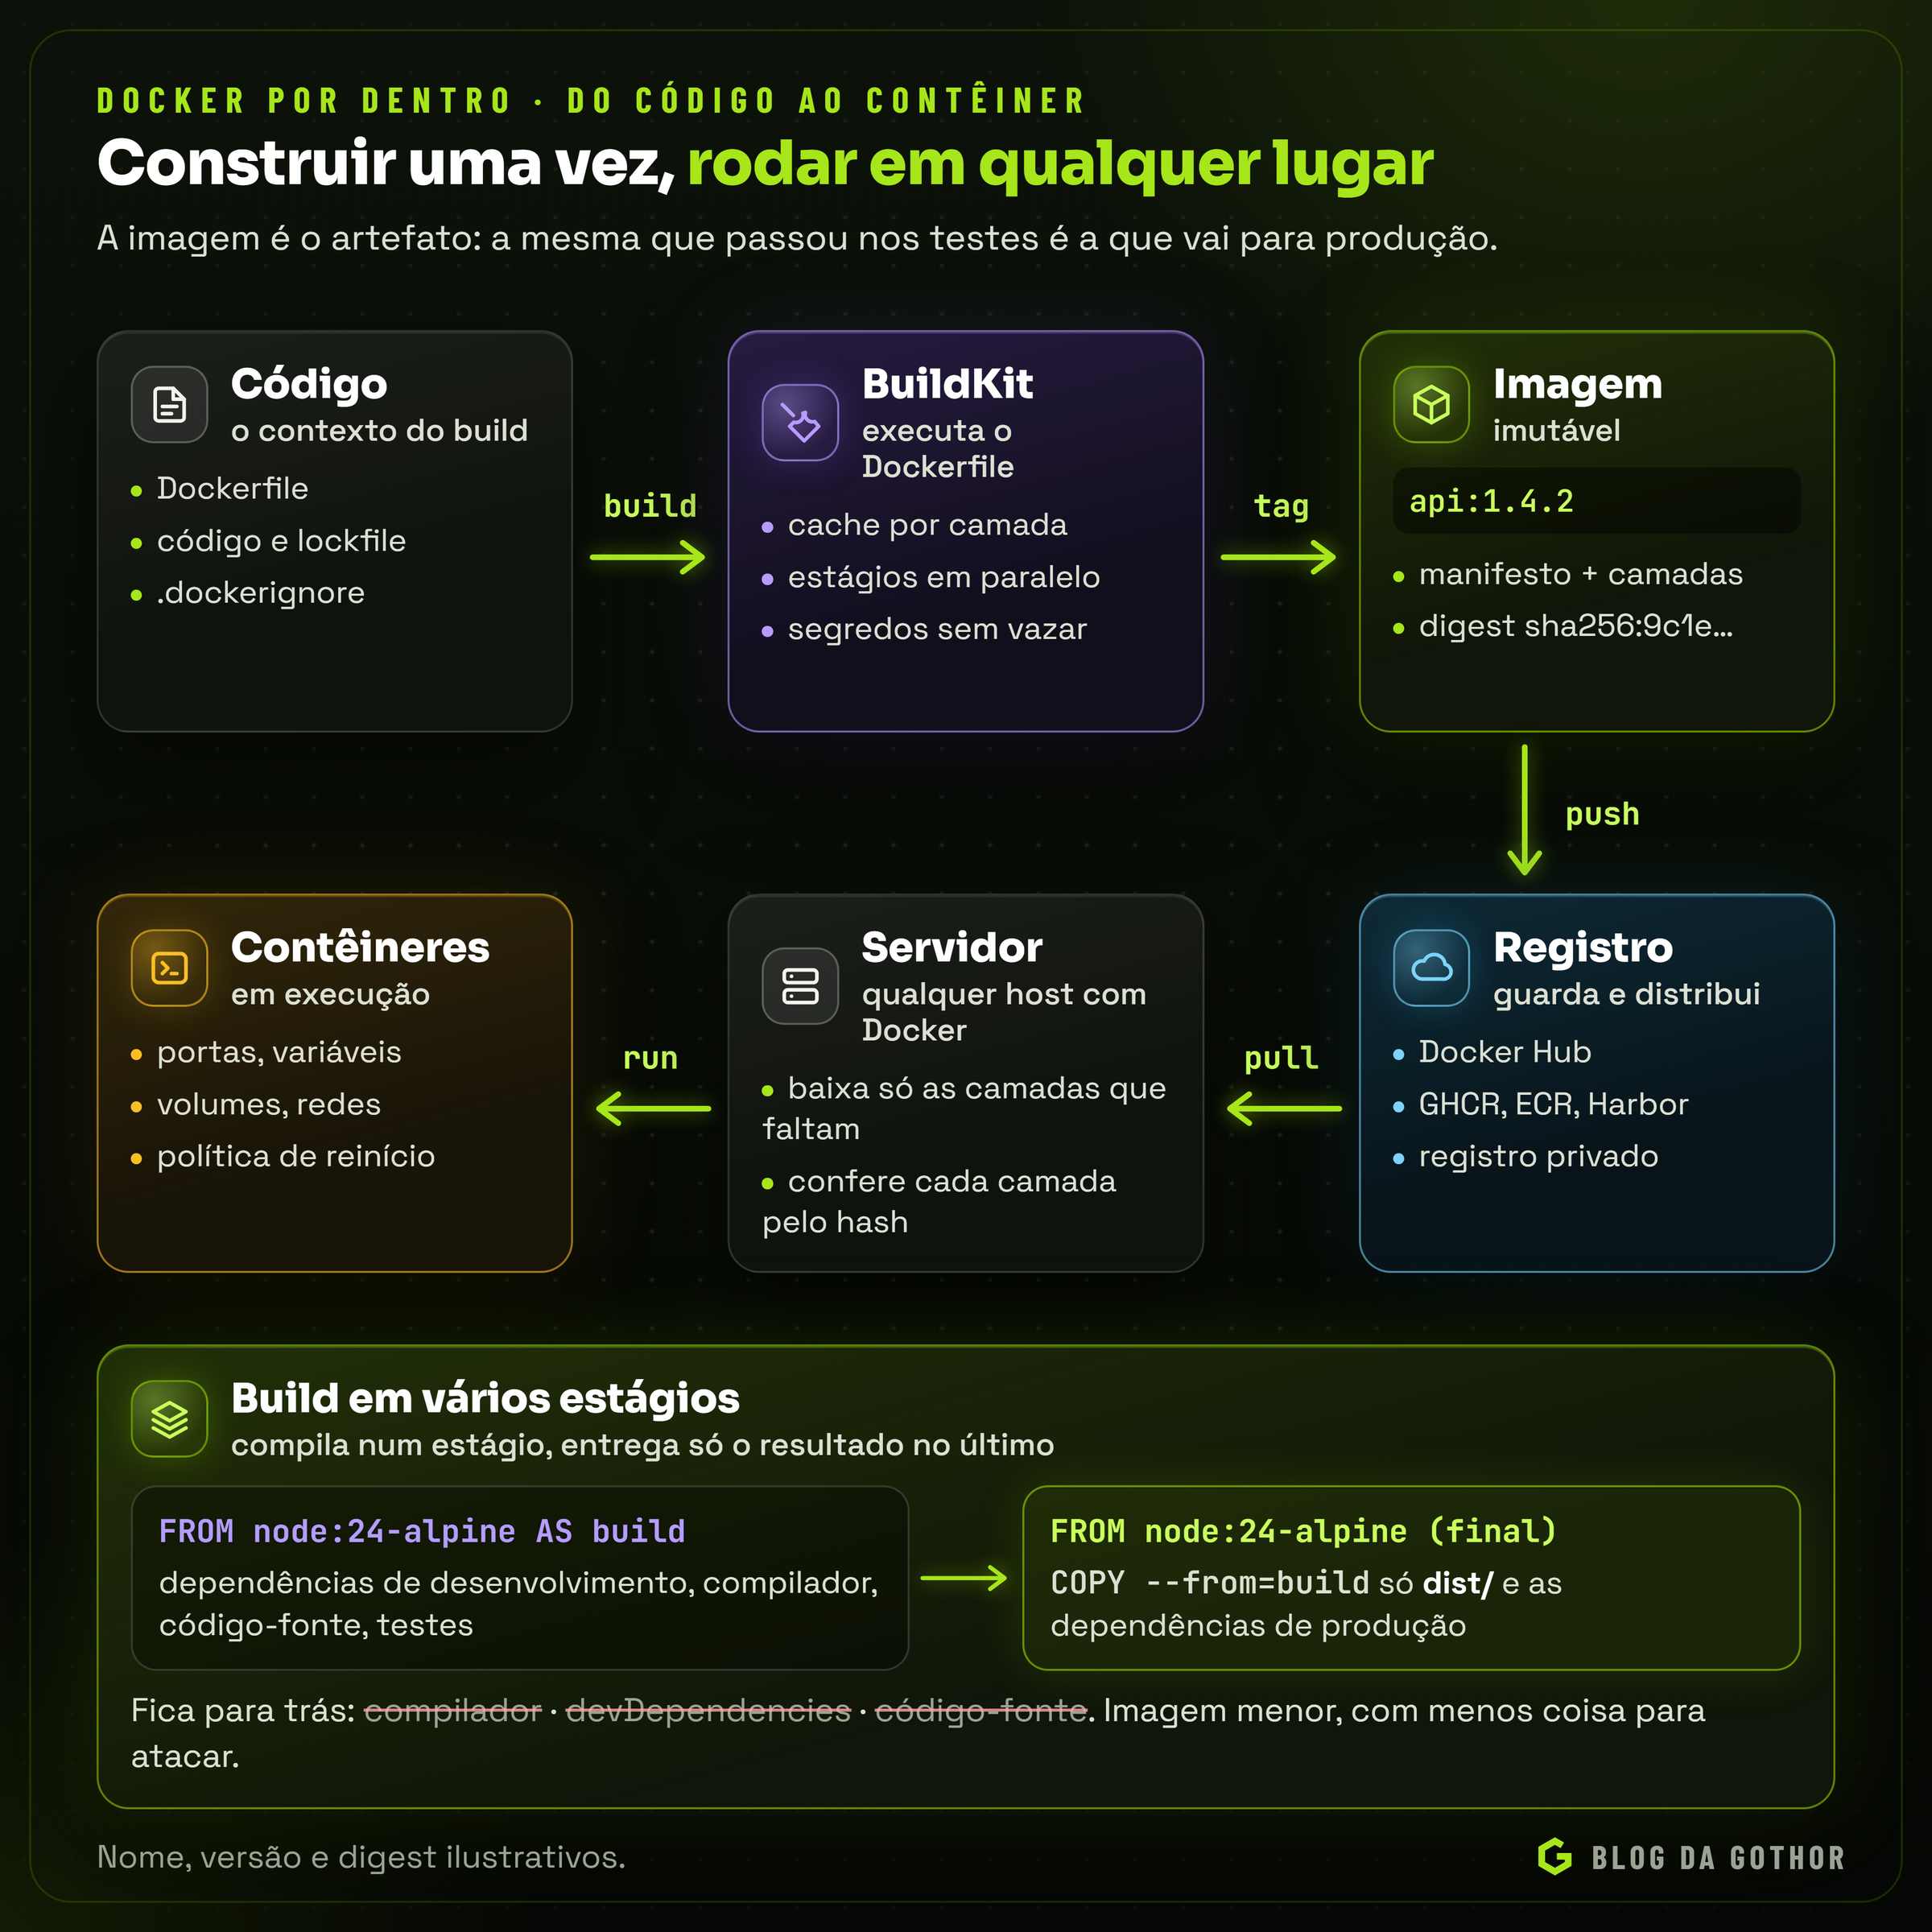
docker build -t registro.exemplo.com.br/api:1.4.2 .   # constrói e dá nome
docker push registro.exemplo.com.br/api:1.4.2         # envia ao registro
docker pull registro.exemplo.com.br/api:1.4.2         # no servidor: baixa só as camadas que faltam
docker run -d --name api -p 127.0.0.1:8890:8890 \
  --env-file /etc/api.env --restart unless-stopped \
  --memory 512m registro.exemplo.com.br/api:1.4.2
O ponto central é que a imagem é o artefato: a mesma que passou nos testes roda em produção, byte a byte. Atualizar é trocar uma imagem por outra.
O ciclo de vida de um contêiner
| Comando | Para que serve |
|---|---|
docker ps -a | lista os contêineres, inclusive os parados |
docker logs -f api | acompanha o que a aplicação escreve na saída padrão |
docker exec -it api sh | abre um terminal dentro de um contêiner em execução |
docker inspect api | mostra toda a configuração, redes, volumes e estado |
docker stats | mostra CPU, memória e rede de cada contêiner em tempo real |
docker stop api | pede o desligamento (SIGTERM e, depois do prazo, SIGKILL) |
docker rm api | remove o contêiner e a sua camada gravável |
docker image prune | apaga imagens que nenhum contêiner usa |
A política de reinício decide o que acontece quando o processo termina ou a máquina reinicia: no (o padrão), on-failure, always ou unless-stopped, que reinicia sempre, a não ser que alguém tenha parado o contêiner de propósito. Já o healthcheck faz o Docker executar periodicamente um comando dentro do contêiner e marcá-lo como healthy ou unhealthy. Sozinho, o Docker Engine não reinicia um contêiner doente; quem usa esse estado são orquestradores e o Compose, para decidir a ordem de subida.
Logs merecem cuidado: por padrão, o Docker grava a saída de cada contêiner em arquivos JSON no host, sem limite de tamanho. A rotação, com max-size e max-file, evita que o disco encha.
Quando algo dá errado: um roteiro de diagnóstico
A maior parte dos problemas com contêineres cai em poucas categorias, e um roteiro fixo resolve quase todos.
1. O contêiner está de pé? docker ps -a mostra o estado e, para os que pararam, o código de saída. O código já diz muito:
| Código | O que costuma significar |
|---|---|
| 0 | o processo terminou normalmente; para um serviço, talvez o comando esteja errado e ele não fique em execução |
| 1 ou outro baixo | a própria aplicação falhou: configuração ausente, erro na inicialização |
| 125 | o Docker não conseguiu nem criar o contêiner: opção inválida, porta em uso |
| 126 e 127 | o comando existe mas não pode ser executado, ou não foi encontrado na imagem |
| 137 | encerrado por SIGKILL (128 + 9): falta de memória ou o fim do prazo do docker stop |
| 143 | encerrado por SIGTERM (128 + 15), normalmente um desligamento pedido |
Para separar falta de memória de um encerramento comum, docker inspect --format '{{.State.OOMKilled}}' api responde true ou false.
2. O que a aplicação disse? docker logs --tail 100 api mostra as últimas linhas, e quase sempre a causa está ali: uma variável de ambiente faltando, uma conexão recusada, uma migração com erro.
3. Ela está saudável? docker inspect --format '{{json .State.Health}}' api mostra o resultado das últimas verificações do healthcheck, com a saída de cada uma. Um contêiner unhealthy que responde normalmente de fora costuma ter um healthcheck errado: uma porta diferente, uma ferramenta (wget, curl) que não existe na imagem.
4. A rede alcança o que precisa? De dentro do contêiner, teste o nome e a porta do serviço vizinho. Se a imagem não tem ferramentas, rode um contêiner auxiliar na mesma rede, como docker run --rm -it --network minha-rede alpine sh, e teste de lá. Erros clássicos: usar localhost para falar com outro contêiner (dentro do contêiner, localhost é ele mesmo), a aplicação escutando só em 127.0.0.1 dentro do contêiner (o redirecionamento de porta não a alcança; ela precisa escutar em 0.0.0.0) e serviços em redes diferentes.
5. A imagem tem o que deveria? docker run --rm -it --entrypoint sh api:1.4.2 abre um shell na imagem sem executar a aplicação, para conferir arquivos, permissões e variáveis.
6. E o disco? docker system df mostra quanto ocupam imagens, contêineres, volumes e o cache de build. Imagens antigas e cache acumulado são a causa mais comum de disco cheio num servidor com Docker; docker image prune e docker builder prune liberam espaço sem tocar nos volumes.
Redes e volumes
Dois recursos completam o quadro: como os contêineres conversam entre si e com o mundo, e onde ficam os dados que não podem sumir.
Redes
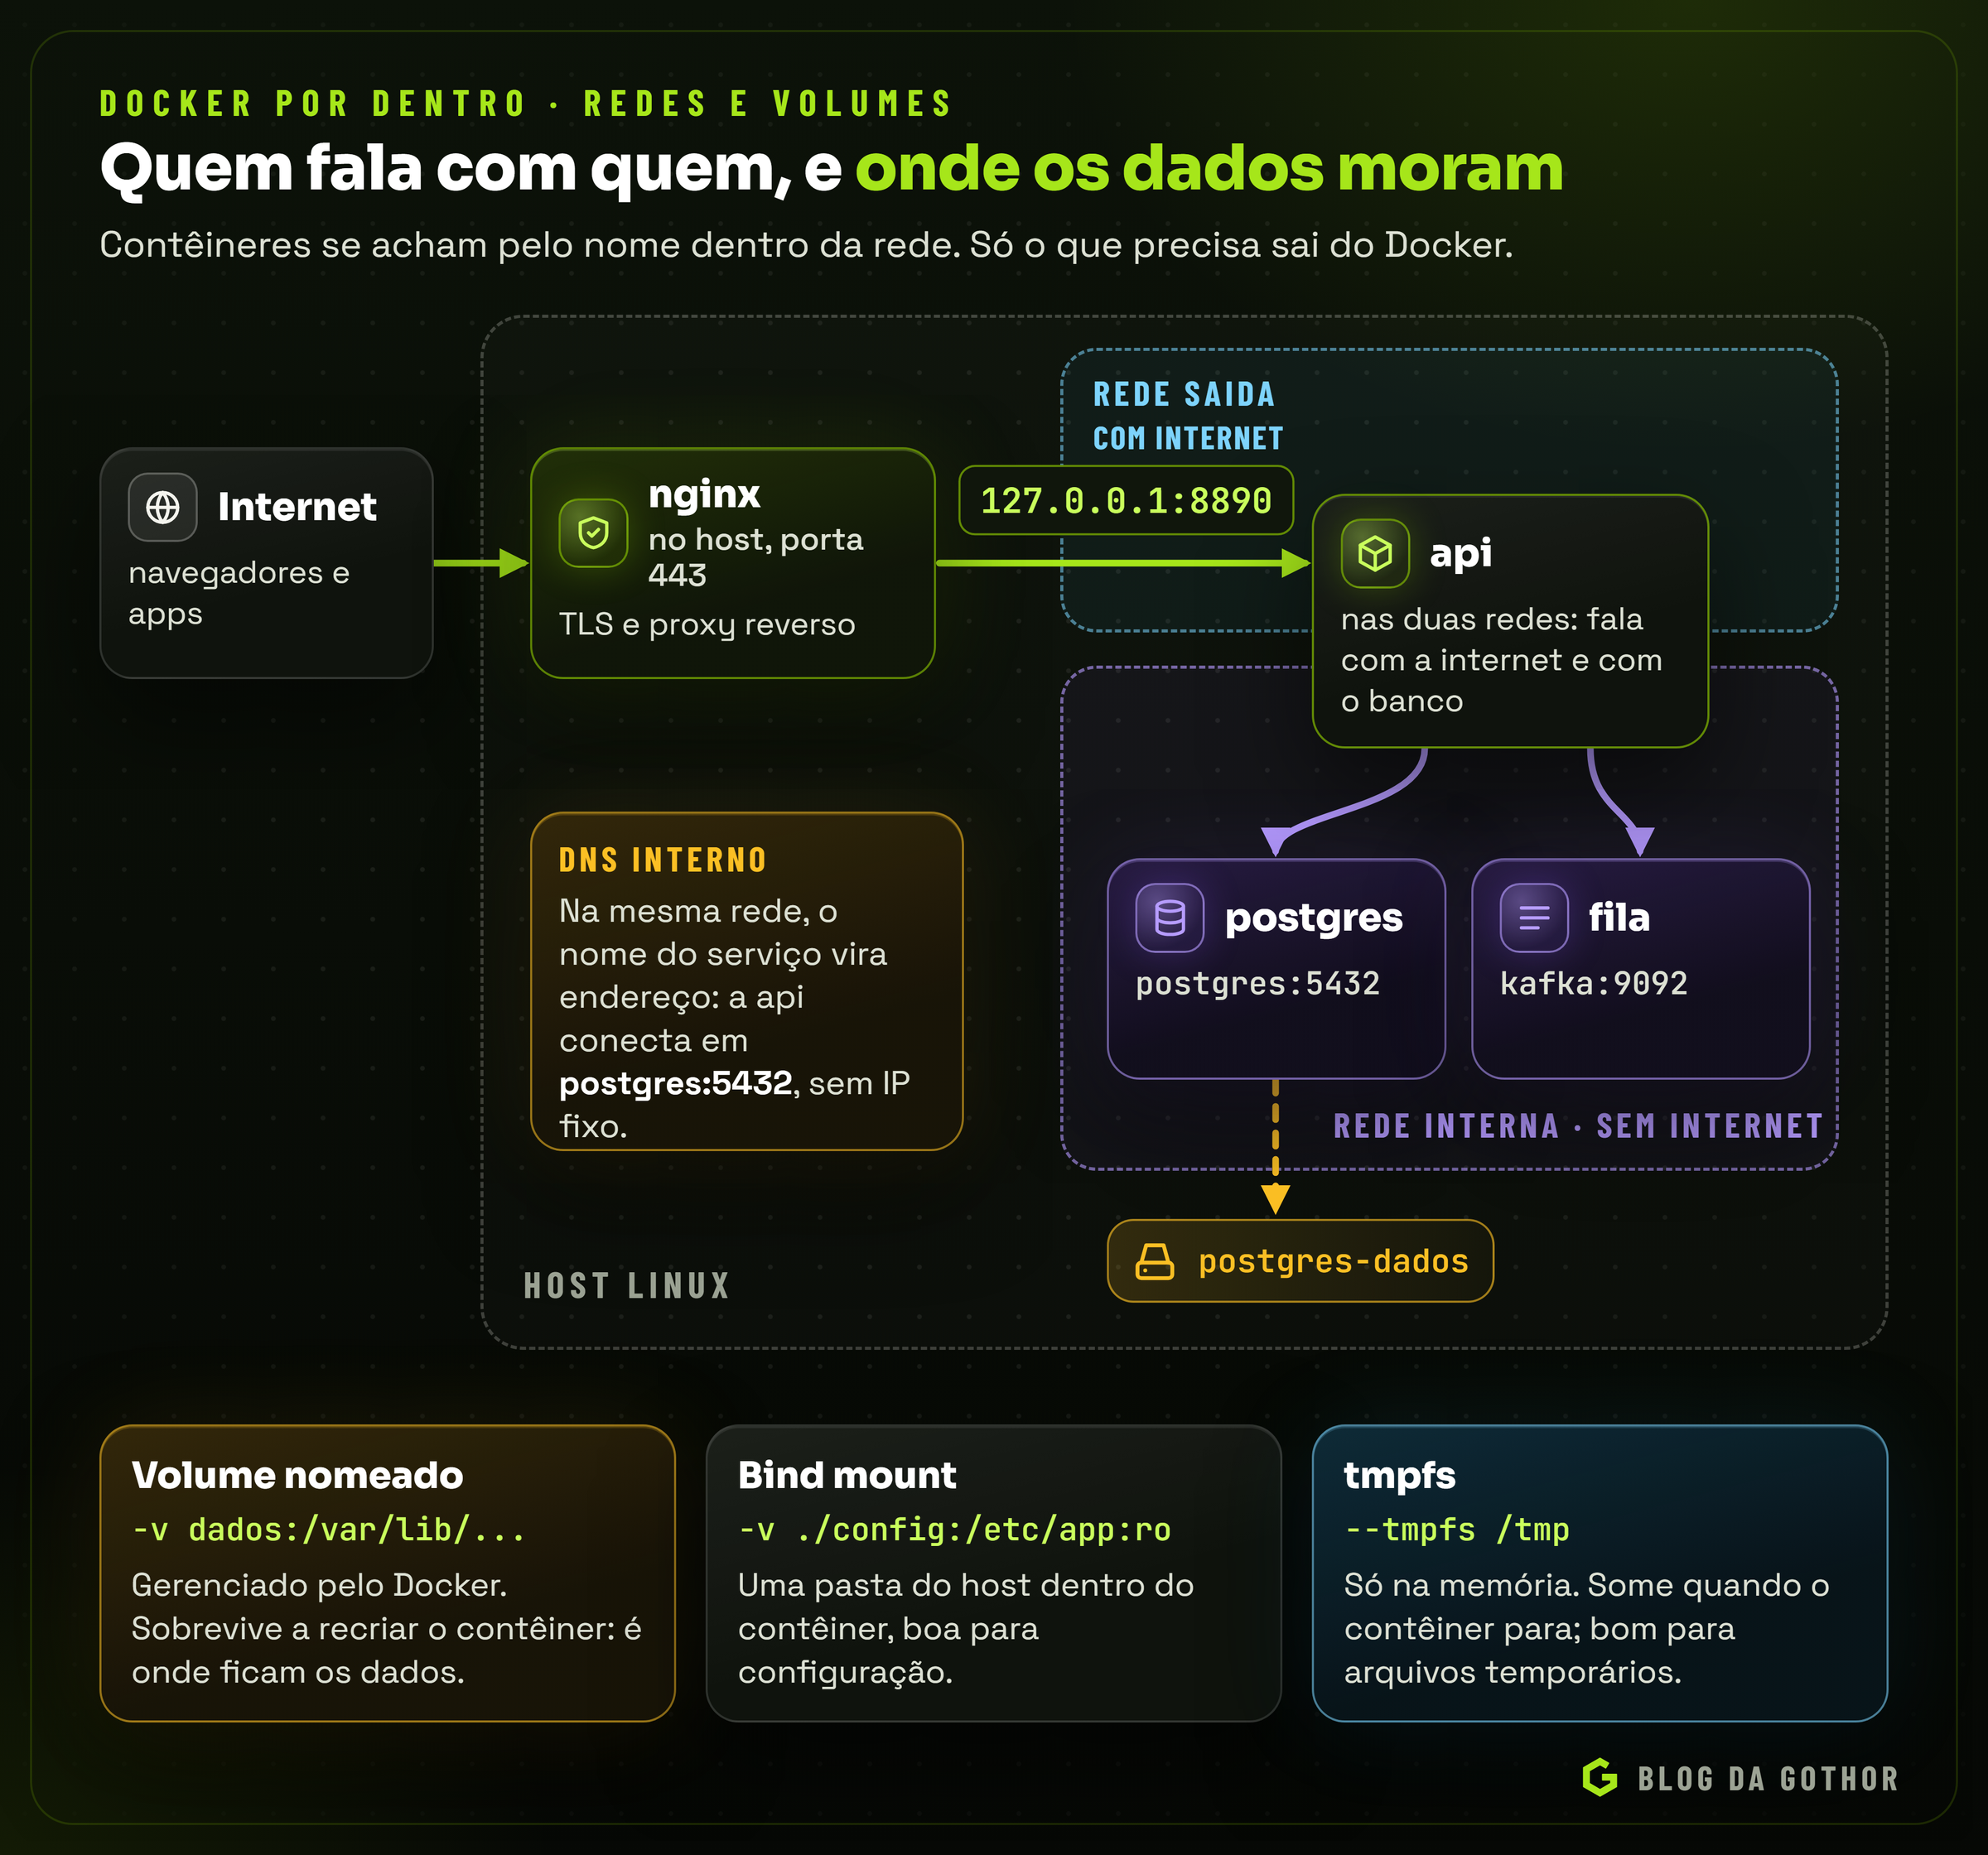
Cada contêiner recebe a sua própria pilha de rede, e o Docker oferece alguns drivers para ligá-las. O mais comum é o bridge: uma rede virtual dentro do host, com endereços privados. Há uma diferença importante entre a rede bridge padrão e as que você cria:
- Na rede padrão, os contêineres só se encontram por endereço IP, que muda a cada recriação.
- Numa rede criada por você (
docker network create minha-rede, ou qualquer rede do Compose), o Docker oferece um DNS interno: o nome do contêiner ou do serviço vira um endereço. A API conecta empostgres:5432, sem IP fixo.
Uma rede criada com a opção internal não tem saída para a internet. É uma forma simples de garantir que um banco de dados ou uma fila não falem com o mundo e não possam ser alcançados por ele. Um contêiner pode estar em várias redes ao mesmo tempo, como a API do diagrama, que precisa falar com o banco e com serviços externos.
Publicar uma porta, com -p, cria um redirecionamento de uma porta do host para a do contêiner. Dois detalhes evitam incidentes:
- Sem um endereço,
-p 8890:8890escuta em todas as interfaces do host, inclusive a pública. Se a porta só deve ser acessada por um proxy reverso na mesma máquina, publique no loopback:-p 127.0.0.1:8890:8890. - O Docker cria as próprias regras no
iptables, e elas passam na frente de firewalls como o UFW. Uma porta publicada pode ficar acessível de fora mesmo que o firewall pareça bloqueá-la. A documentação do Docker tem uma página só sobre isso.
Volumes
Há três formas de dar armazenamento a um contêiner:
| Tipo | Exemplo | Quando usar |
|---|---|---|
| Volume nomeado | -v dados:/var/lib/postgresql/data | dados que precisam sobreviver: bancos, filas, índices |
| Bind mount | -v ./config:/etc/app:ro | arquivos do host dentro do contêiner, como configuração; código em desenvolvimento |
| tmpfs | --tmpfs /tmp | arquivos temporários, só em memória |
O volume nomeado é gerenciado pelo Docker, existe independentemente de qualquer contêiner e é o lugar certo para dados: recriar o contêiner ou atualizar a imagem não o afeta. Apagá-lo é uma ação explícita (docker volume rm), a que mais merece atenção numa limpeza.
O bind mount monta uma pasta do host: ótimo em desenvolvimento e para configuração ou certificados, de preferência somente leitura (:ro).
Backup e restauração de volumes
Volume não é backup: ele sobrevive à recriação do contêiner, mas não a um disco que falha, a um comando apagado por engano ou à perda do servidor. Há duas formas de copiar os dados, e a escolha depende do que está guardado:
- Pela ferramenta da aplicação, quando ela existe. Para um banco de dados,
docker compose exec -T postgres pg_dump -Fc ... > backup.dumpgera uma cópia coerente com o banco no ar, restaurável compg_restore. É sempre a melhor opção para bancos, porque copiar os arquivos de um banco em funcionamento pode capturar um estado no meio de uma gravação. - Pelos arquivos do volume, para dados sem ferramenta própria. Um contêiner descartável monta o volume somente leitura e compacta o conteúdo:
docker run --rm -v dados:/dados:ro -v "$PWD":/backup alpine tar czf /backup/dados.tgz -C /dados .. Se a aplicação grava continuamente, pare-a por alguns segundos durante a cópia.
Três regras completam o quadro: guarde cópias fora da máquina (um backup no mesmo disco não protege da perda do servidor), mantenha um número limitado de versões com rotação automática e, de tempos em tempos, teste a restauração. Um backup que nunca foi restaurado é só uma esperança.
Docker Compose: vários serviços como um sistema
Quase nenhuma aplicação real é um contêiner só. Há a API, o banco, uma fila, um serviço de busca. O Docker Compose descreve tudo isso num arquivo YAML e sobe o conjunto com um comando. Um exemplo, simplificado e ilustrativo:
name: loja

services:
  postgres:
    image: postgres:16-alpine
    environment:
      POSTGRES_PASSWORD: ${POSTGRES_SENHA:?defina no .env}
    volumes:
      - postgres-dados:/var/lib/postgresql/data
    networks: [interna]
    healthcheck:
      test: ["CMD-SHELL", "pg_isready -U postgres"]
      interval: 5s
      retries: 30

  migracoes:
    build: { context: ./api, target: migracoes }
    depends_on:
      postgres: { condition: service_healthy }
    networks: [interna]
    restart: "no"

  api:
    build: ./api
    restart: unless-stopped
    ports:
      - "127.0.0.1:8890:8890"
    depends_on:
      migracoes: { condition: service_completed_successfully }
    networks: [interna, saida]
    logging:
      driver: json-file
      options: { max-size: "10m", max-file: "5" }

networks:
  interna: { internal: true }
  saida: {}

volumes:
  postgres-dados:
Alguns detalhes fazem diferença em produção:
- O
depends_oncom condições define a ordem real de subida.service_healthyespera o healthcheck do banco passar;service_completed_successfullyespera um serviço de execução única, como as migrações, terminar sem erro. Sem condição, o Compose só garante que o outro contêiner foi iniciado, não que está pronto. - A sintaxe
${VARIAVEL:?mensagem}faz o Compose recusar subir se a variável não estiver definida, em vez de subir com uma senha vazia. - O nome do projeto (
name) fixa o nome dos volumes. Atualizar o código e recriar os contêineres não mexe nos dados.
Os comandos do dia a dia são poucos: docker compose up -d --build --wait constrói o que mudou, sobe tudo em segundo plano e espera os healthchecks; docker compose logs -f api acompanha um serviço; docker compose down derruba o conjunto, preservando os volumes, a não ser que você peça -v. O campo version no topo do arquivo, que aparece em muitos tutoriais antigos, é obsoleto e pode ser removido.
Compose no desenvolvimento
O mesmo Compose que organiza a produção resolve um problema antigo do desenvolvimento: deixar a máquina de cada pessoa da equipe com o banco, a fila e os serviços auxiliares nas mesmas versões da produção, sem instalar nada disso no sistema. Alguns recursos ajudam nesse uso:
- Bind mount do código. Montar a pasta do projeto dentro do contêiner, com o servidor de desenvolvimento observando mudanças, dá recarga automática sem reconstruir a imagem a cada alteração. O
docker compose watchfaz algo parecido de forma declarada: sincroniza arquivos e reconstrói a imagem só quando muda o que exige isso, como opackage.json. - Arquivos de sobreposição. Um
compose.override.ymlao lado do arquivo principal é lido automaticamente e acrescenta o que só faz sentido na máquina de quem desenvolve: portas extras, variáveis de depuração, volumes de código. A produção usa só o arquivo principal. - Perfis. Serviços marcados com
profilessó sobem quando o perfil é pedido (docker compose --profile gpu up). É o jeito de manter no mesmo arquivo serviços que dependem de um hardware específico ou ferramentas usadas só de vez em quando. - Portas para o host. Um serviço pode escutar num endereço para os outros contêineres e em outro para o host, de modo que a aplicação rode tanto dentro quanto fora do Docker contra a mesma infraestrutura.
O resultado é que uma pessoa nova na equipe clona o repositório, copia o modelo do arquivo de variáveis e roda um comando. O tempo de preparar uma máquina cai de dias para minutos.
Segurança: o que o contêiner não resolve sozinho
Um contêiner isola, mas não torna nada seguro por mágica. A maioria dos problemas vem de escolhas no Dockerfile e na execução:
- Rode como usuário comum. A instrução
USERantes doCMDfaz a aplicação rodar sem privilégios. As imagens oficiais do Node já trazem o usuárionode. - Use bases mínimas. Imagens
alpineouslimtêm menos pacotes, e as imagens distroless não têm nem shell nem gerenciador de pacotes: só o necessário para o programa rodar. Menos software é menos vulnerabilidade e menos ferramenta à disposição de um invasor. - Nunca coloque segredos na imagem. Um
COPY .env, umENV SENHA=...ou umARGcom um token ficam gravados nas camadas ou no histórico da imagem, e qualquer pessoa com acesso a ela consegue lê-los comdocker historyou extraindo as camadas. Segredos entram na execução, por variáveis de ambiente, arquivos montados ou um cofre; no build, pelas montagens de segredo do BuildKit (RUN --mount=type=secret). - Fixe versões e confira o que baixa. Tags específicas ou digests na base, lockfiles nas dependências e, para arquivos baixados,
ADD --checksum=sha256:..., que faz o build falhar se o conteúdo mudar. - Limite recursos.
--memory,--cpuse--pids-limitimpedem que um contêiner com problema derrube os vizinhos. - Não monte o socket do Docker (
/var/run/docker.sock) num contêiner, a não ser que saiba exatamente por quê: quem controla esse socket controla o host. - Varra as imagens com ferramentas como o Docker Scout ou o Trivy, que listam vulnerabilidades conhecidas nos pacotes.
Camadas extras de proteção
Além dos namespaces e dos cgroups, o Docker aplica por padrão outras restrições, e é possível apertá-las:
- Capacidades. O poder do root no Linux é dividido em dezenas de capabilities (alterar a rede, montar sistemas de arquivos, carregar módulos do kernel). O Docker já remove as mais perigosas;
--cap-drop ALLremove todas, e--cap-adddevolve só a que a aplicação realmente precisa, comoNET_BIND_SERVICEpara escutar numa porta abaixo de 1024. - seccomp. Um filtro bloqueia chamadas de sistema que uma aplicação comum nunca usa. O perfil padrão do Docker já bloqueia dezenas delas, e desligá-lo (
--security-opt seccomp=unconfined) quase nunca é necessário. - Sem escalada de privilégio.
--security-opt no-new-privilegesimpede que um processo ganhe privilégios por meio de programas com o bit setuid. - Sistema de arquivos somente leitura.
--read-onlytorna a camada gravável imutável; com umtmpfspara/tmp, a aplicação continua funcionando, e um invasor não consegue gravar ferramentas no disco. - Modo sem root. O próprio daemon do Docker pode rodar como um usuário comum (rootless mode), de modo que nem uma fuga do contêiner daria acesso de root ao host. Tem limitações de rede e de desempenho, mas é uma opção a considerar em máquinas compartilhadas.
Nenhuma dessas medidas substitui as outras. A segurança de um contêiner é a soma de várias barreiras pequenas, e cada uma que se acrescenta torna mais difícil transformar uma falha na aplicação num problema no servidor inteiro.
Erros comuns
- Tratar o contêiner como um servidor. Entrar com
exec, instalar um pacote e corrigir um arquivo "só desta vez" cria um estado que some na próxima recriação. Toda mudança vai para o Dockerfile e vira uma imagem nova. - Guardar dados na camada gravável. Banco sem volume perde tudo quando o contêiner é removido.
- Ordem ruim no Dockerfile. Copiar todo o código antes de instalar as dependências invalida o cache a cada commit e deixa o build lento.
- **Esquecer o
.dockerignore.** Contexto gigante, build lento e segredos dentro da imagem. - Publicar portas em todas as interfaces sem perceber que o firewall não as protege.
- Logs sem rotação. O disco enche, e tudo para ao mesmo tempo.
- **
depends_onsem condição**, achando que o banco já está pronto quando a API sobe. - **Usar
localhostpara falar com outro contêiner.** Dentro de um contêiner,localhosté ele mesmo. Use o nome do serviço na rede. - **Aplicação escutando só em
127.0.0.1dentro do contêiner.** O redirecionamento de porta chega pela interface de rede do contêiner, e a aplicação precisa escutar em0.0.0.0para recebê-lo. - Apagar arquivos numa instrução separada. O arquivo continua na camada anterior, e a imagem não diminui. Baixe, use e apague no mesmo
RUN, ou use um estágio separado. - Ignorar o sinal de desligamento. Sem tratar o SIGTERM, cada atualização derruba requisições no meio e espera os dez segundos até o SIGKILL.
- Uma imagem para tudo. API, banco e agendador no mesmo contêiner não podem ser atualizados nem reiniciados separadamente. A regra prática é um processo principal por contêiner.
Docker, Kubernetes e o resto do ecossistema
O Docker resolve muito bem o caso de uma máquina, ou de algumas poucas. Quando a aplicação precisa de dezenas de máquinas, escalonamento por carga e recuperação de falhas sem intervenção humana, entra um orquestrador, e o padrão de mercado é o Kubernetes, que executa exatamente as mesmas imagens OCI. Também há alternativas para executar contêineres, como o Podman, que aceita quase os mesmos comandos. Para muitas empresas, um ou dois servidores com Docker, Compose e um proxy reverso na frente resolvem com folga, com muito menos complexidade que um cluster.
Docker no dia a dia de uma empresa
Contêineres não são assunto só de empresas de software. Alguns usos aparecem em qualquer operação com sistemas próprios ou integrações:
- Integrações com o ERP. Um serviço que lê pedidos de um e-commerce e os grava no ERP, ou que envia notas para um parceiro, roda bem num contêiner com política de reinício, logs com rotação e limite de memória. Se cair de madrugada, volta sozinho.
- Sistemas antigos isolados. Uma aplicação que depende de uma versão antiga de uma linguagem ou de uma biblioteca pode continuar rodando num contêiner, sem impedir que o resto do servidor seja atualizado.
- Ambientes de teste descartáveis. Testar uma migração de banco, uma versão nova de um sistema ou um relatório pesado num banco de cópia, criado e apagado em minutos, sem risco para a produção. Bibliotecas como o Testcontainers fazem isso dentro dos próprios testes automatizados.
- Ferramentas internas. Painéis, automações e scripts agendados ganham o mesmo processo de publicação dos sistemas principais, com histórico de versões e volta rápida.
- Recuperação de desastres. Com as imagens num registro, o Compose e os scripts no repositório e os backups fora da máquina, reconstruir um servidor perdido vira um procedimento conhecido, e não uma investigação sobre como ele foi configurado anos atrás.
Perguntas frequentes
Contêiner deixa a aplicação mais lenta? Para CPU e memória, a diferença é desprezível: o processo roda direto no kernel, sem emulação. O custo aparece em pontos específicos, como a rede bridge e o redirecionamento de portas, que acrescentam uma pequena latência, e o sistema de arquivos em união, que é mais lento para escrita intensa. Por isso dados de bancos ficam em volumes, que escrevem direto no disco do host.
Posso rodar banco de dados em contêiner na produção? Sim, desde que os dados estejam em volume, o contêiner tenha limites e healthcheck e exista uma rotina de backup testada. Para cargas muito grandes ou equipes sem tempo para operar o banco, um serviço gerenciado de nuvem pode valer o custo.
Preciso de Kubernetes? Só quando o problema exige: muitas máquinas, escalonamento automático, várias equipes publicando serviços de forma independente. Para uma ou poucas máquinas, Docker com Compose é mais simples de operar e de entender.
O Docker Desktop é gratuito? O Docker Engine, que roda os contêineres no Linux, é software livre. O Docker Desktop, o aplicativo para Windows e macOS, é gratuito para uso pessoal, educação, projetos de código aberto e empresas pequenas; empresas maiores precisam de uma assinatura paga. O Podman Desktop e o Rancher Desktop são alternativas.
Docker ou Podman? Os dois executam as mesmas imagens OCI e aceitam quase os mesmos comandos. O Podman não usa um daemon central e roda sem root por padrão; o Docker tem o ecossistema mais conhecido e o Compose mais maduro. Para quem está começando, a escolha importa menos do que aprender bem os conceitos, que valem para os dois.
Por que a minha imagem ficou tão grande? As causas mais comuns são uma base completa quando uma slim bastaria, dependências de desenvolvimento e compiladores na imagem final, arquivos baixados e apagados em instruções diferentes e um contexto de build sem .dockerignore, que leva para dentro da imagem pastas que ela não usa. O docker history mostra qual camada pesa mais, e um build em vários estágios costuma resolver a maior parte de uma vez.
Onde ficam as configurações de cada ambiente? Fora da imagem. A mesma imagem roda no teste e na produção, e o que muda entre eles (endereços, chaves, níveis de log) entra como variável de ambiente ou arquivo montado na hora de executar. É o princípio que permite promover a imagem testada até a produção sem reconstruí-la.
Como atualizo uma imagem base com uma correção de segurança? Reconstruindo a imagem: docker build --pull força o download da versão mais recente da base, e um novo deploy troca os contêineres. Por isso vale reconstruir as imagens periodicamente, mesmo sem mudança no código.
Como usamos o Docker na Gothor
Na Gothor, todo serviço que roda em servidor vai num contêiner, e o Dockerfile vive no monorepo ao lado do código do serviço.
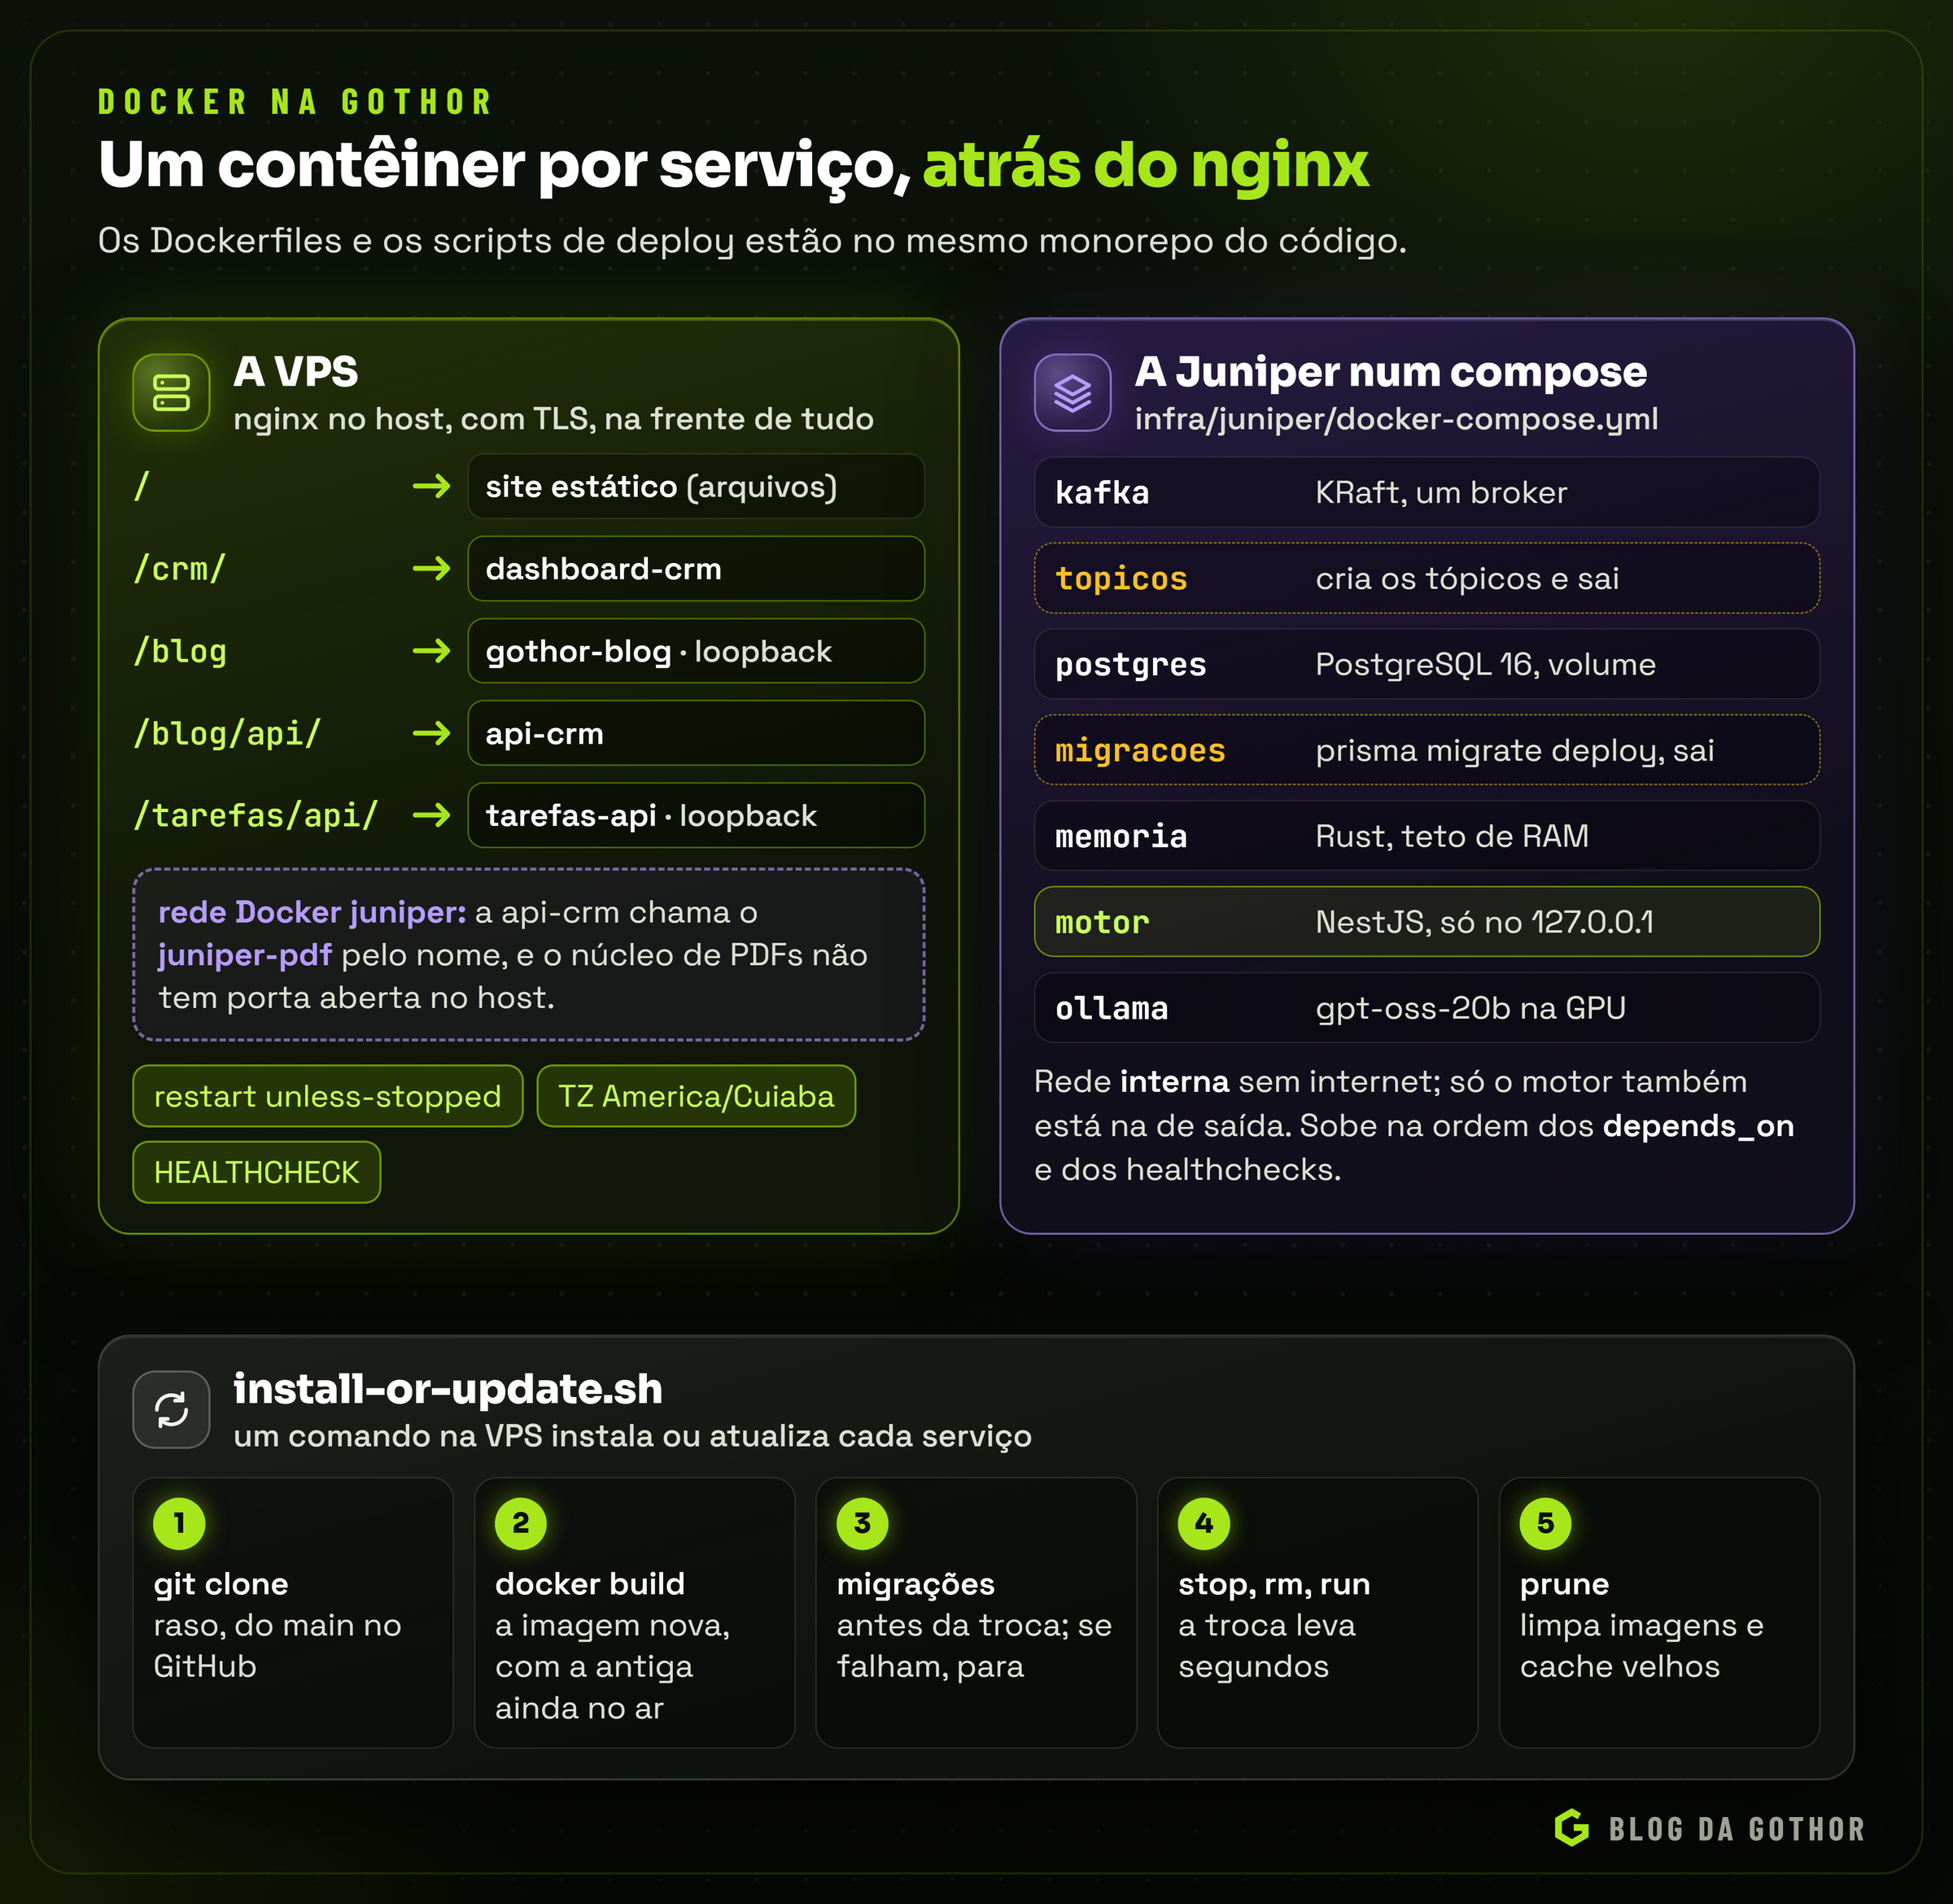
Sete imagens, cada uma do seu jeito. Há Dockerfiles para a API e o painel do CRM, as páginas deste blog, a API do app Tarefas, o juniper-motor (o serviço de IA da Juniper, em NestJS), o juniper-memoria (a memória de longo prazo da Juniper, em Rust) e o juniper-pdf (o núcleo que gera propostas e contratos em PDF, também em Rust). Todos fixam o fuso em America/Cuiaba, para que datas e horários batam com os da operação.
Builds em vários estágios. O juniper-motor e a API do Tarefas compilam o TypeScript num estágio, podam as dependências de desenvolvimento em outro e entregam uma imagem final que só tem o código compilado, as dependências de produção e o usuário node. Um estágio intermediário, chamado migracoes, gera uma segunda imagem que roda prisma migrate deploy e sai; assim, a imagem do serviço não carrega a ferramenta de migração.
Imagens mínimas e verificadas. O juniper-memoria é o caso mais extremo. O binário Rust é compilado com caches do BuildKit, e o modelo de embeddings que ele usa é baixado numa revisão fixa, com ADD --checksum: se o arquivo mudar, o build falha. A imagem final é distroless, sem shell, com usuário sem privilégios; como não há wget lá dentro, o próprio binário responde ao healthcheck com a opção --saude.
Atrás do nginx, e só no loopback. Na VPS, o nginx do host recebe todo o tráfego com TLS e repassa cada caminho para o contêiner certo: o painel do CRM, as páginas do blog, a API do blog, a API do Tarefas. Os serviços que só o nginx precisa alcançar, como o blog e a API do Tarefas, são publicados em 127.0.0.1. O núcleo de PDFs nem tem porta no host: ele está numa rede Docker chamada juniper, e a API do CRM, ligada à mesma rede, o chama pelo nome.
Um script de deploy por serviço. Cada serviço tem um install-or-update.sh versionado, com uma cópia na VPS. O script faz um clone raso do main no GitHub (em vários casos, só da pasta do serviço), constrói a imagem nova enquanto a antiga continua no ar, roda as migrações antes da troca, para e remove o contêiner antigo, sobe o novo e limpa as imagens que sobraram. Como o build vem antes da troca, a indisponibilidade dura poucos segundos, e se as migrações falharem o script para ali e a versão anterior continua atendendo.
A Juniper num compose. A Juniper roda numa máquina própria, separada da VPS do CRM, a partir de um único docker-compose.yml, o infra/juniper/docker-compose.yml do monorepo. Nele estão o Kafka (no modo KRaft, com um broker), o PostgreSQL 16, o juniper-memoria e o juniper-motor; dois serviços de execução única, um que cria os tópicos do Kafka com as partições e retenções certas e outro que roda as migrações do banco; e o Ollama, que executa na placa de vídeo da máquina o gpt-oss-20b do orquestrador local e entra pelo perfil gpu. Kafka, banco, memória e Ollama ficam numa rede internal, sem saída para a internet; só o motor está também na rede de saída, porque fala com os provedores de IA (Google, Anthropic e OpenAI) e com a API do CRM, e só ele é publicado, no loopback, atrás do nginx com TLS. A subida segue os depends_on com condições: o Kafka saudável libera a criação dos tópicos, que libera a memória; o banco saudável libera as migrações, que liberam o motor, e o motor só sobe depois que a memória responde ao healthcheck. Os dados ficam em volumes com nome fixo, os logs têm rotação de 10 MB por arquivo, todos os serviços fixam o fuso de Cuiabá, e a memória tem um teto de RAM, para que um vazamento reinicie só ela. No desligamento, o motor tem 30 segundos de prazo para devolver à fila a tarefa que estava executando.
Atualizar sem medo, e com volta. O install-or-update.sh da Juniper clona do monorepo só as três pastas de que precisa, constrói as imagens novas com tudo no ar, guarda as atuais com a etiqueta anterior para permitir voltar uma versão, faz um backup do banco com pg_dump, roda as migrações e só então troca os contêineres com docker compose up -d --wait, que espera os healthchecks. Um backup diário, pelo cron, guarda o banco e o índice da memória: para copiar o volume do índice de forma coerente, o script para a memória por alguns segundos, monta o volume somente leitura num contêiner Alpine descartável, compacta e religa o serviço. As cópias também vão, criptografadas, para o Google Drive pelo rclone.
A base certa para cada caso. O juniper-memoria compila sobre o Debian 13, e não sobre uma base Alpine, porque o ONNX Runtime que executa o modelo de busca por significado pede uma versão recente da glibc, a biblioteca C do sistema. Já os serviços em Node usam node:24-alpine, menor. Para desenvolver, o motor tem o seu próprio docker-compose.dev.yml, que sobe o Kafka, a memória e o motor na máquina de quem programa, e expõe o Kafka também em localhost:9094 para quem prefere rodar o motor fora do Docker, com recarga automática.
Resumo
- Um contêiner é um processo do host isolado por namespaces (o que ele vê) e limitado por cgroups (quanto ele usa). Ele compartilha o kernel, ao contrário de uma VM.
- A imagem é uma pilha de camadas somente leitura, endereçadas pelo hash do conteúdo; cada contêiner ganha uma camada gravável e descartável.
- O cache de build refaz uma instrução e todas as seguintes quando algo muda: dependências antes do código.
- Builds em vários estágios entregam só o necessário;
USER, bases mínimas e nenhum segredo nas camadas tornam a imagem mais segura. - O
docker runpassa pelo cliente, pelo dockerd, pelo containerd e pelo runc, que cria o processo isolado. - Forma exec no
CMD, tratamento do SIGTERM e, quando há subprocessos, um init como o tini garantem um desligamento limpo. - Código de saída, logs, estado do healthcheck e um shell na imagem resolvem a maior parte dos diagnósticos.
- Redes criadas por você têm DNS interno; redes
internalnão saem para a internet; portas devem ser publicadas só onde precisam. - Dados vão para volumes nomeados, com backup fora da máquina e restauração testada; o Compose organiza vários serviços, com ordem de subida por healthcheck, na produção e no desenvolvimento.
- Capacidades reduzidas, seccomp, sistema de arquivos somente leitura e usuário comum somam barreiras à segurança.
- A imagem é o artefato: construída uma vez, testada e promovida até a produção.
Para ir além
- Documentação oficial do Docker, com tutoriais, referência dos comandos e boas práticas.
- Referência do Dockerfile e boas práticas de build.
- Builds em vários estágios e cache de build.
- Redes no Docker, Docker e firewalls com iptables e volumes.
- Referência do arquivo do Compose.
- Segurança no Docker Engine, com seccomp e o modo sem root.
- Compose Watch e perfis do Compose.
- Open Container Initiative, os padrões de imagem e de execução.
- Páginas de manual do Linux sobre namespaces e cgroups.
Este post foi escrito com a ajuda da Juniper, a assistente de IA da Gothor, e revisado pela nossa equipe antes de ir ao ar.