Git por dentro: como funciona o controle de versão que guarda a história do seu código
Commits, ramos, merge, rebase e remotos explicados de dentro para fora. Entenda como o Git guarda cada versão, por que criar ramos custa quase nada e como desfazer erros sem perder trabalho, com exemplos reais e as práticas que usamos na Gothor.
Todo software que está em produção hoje passou por milhares de mudanças: uma correção às pressas numa sexta-feira, uma funcionalidade que levou três semanas, uma refatoração que ninguém queria fazer. Saber o que mudou, quando, por quem e por quê é o que separa uma equipe que conserta um problema em minutos de uma que passa a tarde procurando o culpado. Quem guarda essa memória, em praticamente todos os projetos de software do mundo, é o Git.
A maioria das pessoas aprende meia dúzia de comandos (add, commit, push, pull) e segue em frente até o dia em que algo dá errado: um conflito que não faz sentido, um commit que "sumiu", um push recusado. Este artigo faz o caminho inverso. Começa pelo que o Git é por dentro, porque, quando o modelo mental está certo, os comandos deixam de ser fórmulas decoradas e passam a ser consequências óbvias.
O que é o Git, e o que ele não é
O Git é um sistema de controle de versão distribuído. Controle de versão é o registro organizado de todas as mudanças de um conjunto de arquivos, com a possibilidade de voltar a qualquer ponto, comparar versões e combinar o trabalho de várias pessoas. Distribuído significa que cada cópia do repositório é completa: o computador de cada desenvolvedor tem o histórico inteiro, e não só a versão mais recente.
Essa segunda parte é a grande diferença em relação aos sistemas centralizados que vieram antes, como o CVS e o Subversion. Neles existia um servidor com o histórico, e cada pessoa tinha apenas uma "cópia de trabalho". Sem acesso ao servidor, não havia como consultar o histórico, criar um ramo ou registrar uma mudança. No Git, quase tudo acontece localmente: log, diff, commit, branch e merge funcionam no avião, sem internet, e respondem em milissegundos.
Também vale separar duas coisas que costumam ser confundidas:
- Git é a ferramenta: um programa de código aberto que roda no seu computador.
- GitHub, GitLab e Bitbucket são serviços que hospedam repositórios Git e acrescentam recursos de colaboração, como pull requests, revisão de código, issues e integração contínua.
Você pode usar Git sem nenhum desses serviços. O inverso não é possível.
Uma história curta: o Git nasceu de uma crise
Até 2005, o desenvolvimento do kernel do Linux usava o BitKeeper, um sistema de controle de versão distribuído e proprietário, cedido gratuitamente à comunidade. Naquele ano a licença gratuita foi retirada, e o projeto, um dos maiores e mais movimentados do mundo, ficou de uma hora para outra sem ferramenta.
Linus Torvalds decidiu escrever a sua própria. Os objetivos eram claros e moldam o Git até hoje: ser muito rápido, ter um desenho simples, suportar desenvolvimento não linear, com milhares de ramos em paralelo, ser totalmente distribuído e aguentar projetos do tamanho do kernel. Em poucas semanas, em abril de 2005, o Git já versionava o próprio código. Em julho do mesmo ano, Junio Hamano assumiu a manutenção do projeto, papel que mantém há duas décadas, e a versão 1.0 saiu em dezembro.
O resto é conhecido: o GitHub, lançado em 2008, transformou o Git no padrão de fato da colaboração em software, e hoje é difícil encontrar um projeto relevante que use outra coisa.
Como o Git pensa: fotos, não diferenças
A ideia mais importante para entender o Git é esta: cada commit é uma foto completa do projeto, e não uma lista de diferenças em relação ao anterior.
Muitos sistemas antigos guardavam um arquivo base e uma sequência de alterações ("na linha 12, troque isto por aquilo"). O Git guarda, a cada commit, o estado de todos os arquivos. Isso parece um desperdício enorme de espaço, mas não é, por dois motivos que veremos a seguir: arquivos que não mudaram não são copiados de novo, e o armazenamento final é comprimido com deltas.
Os quatro tipos de objeto
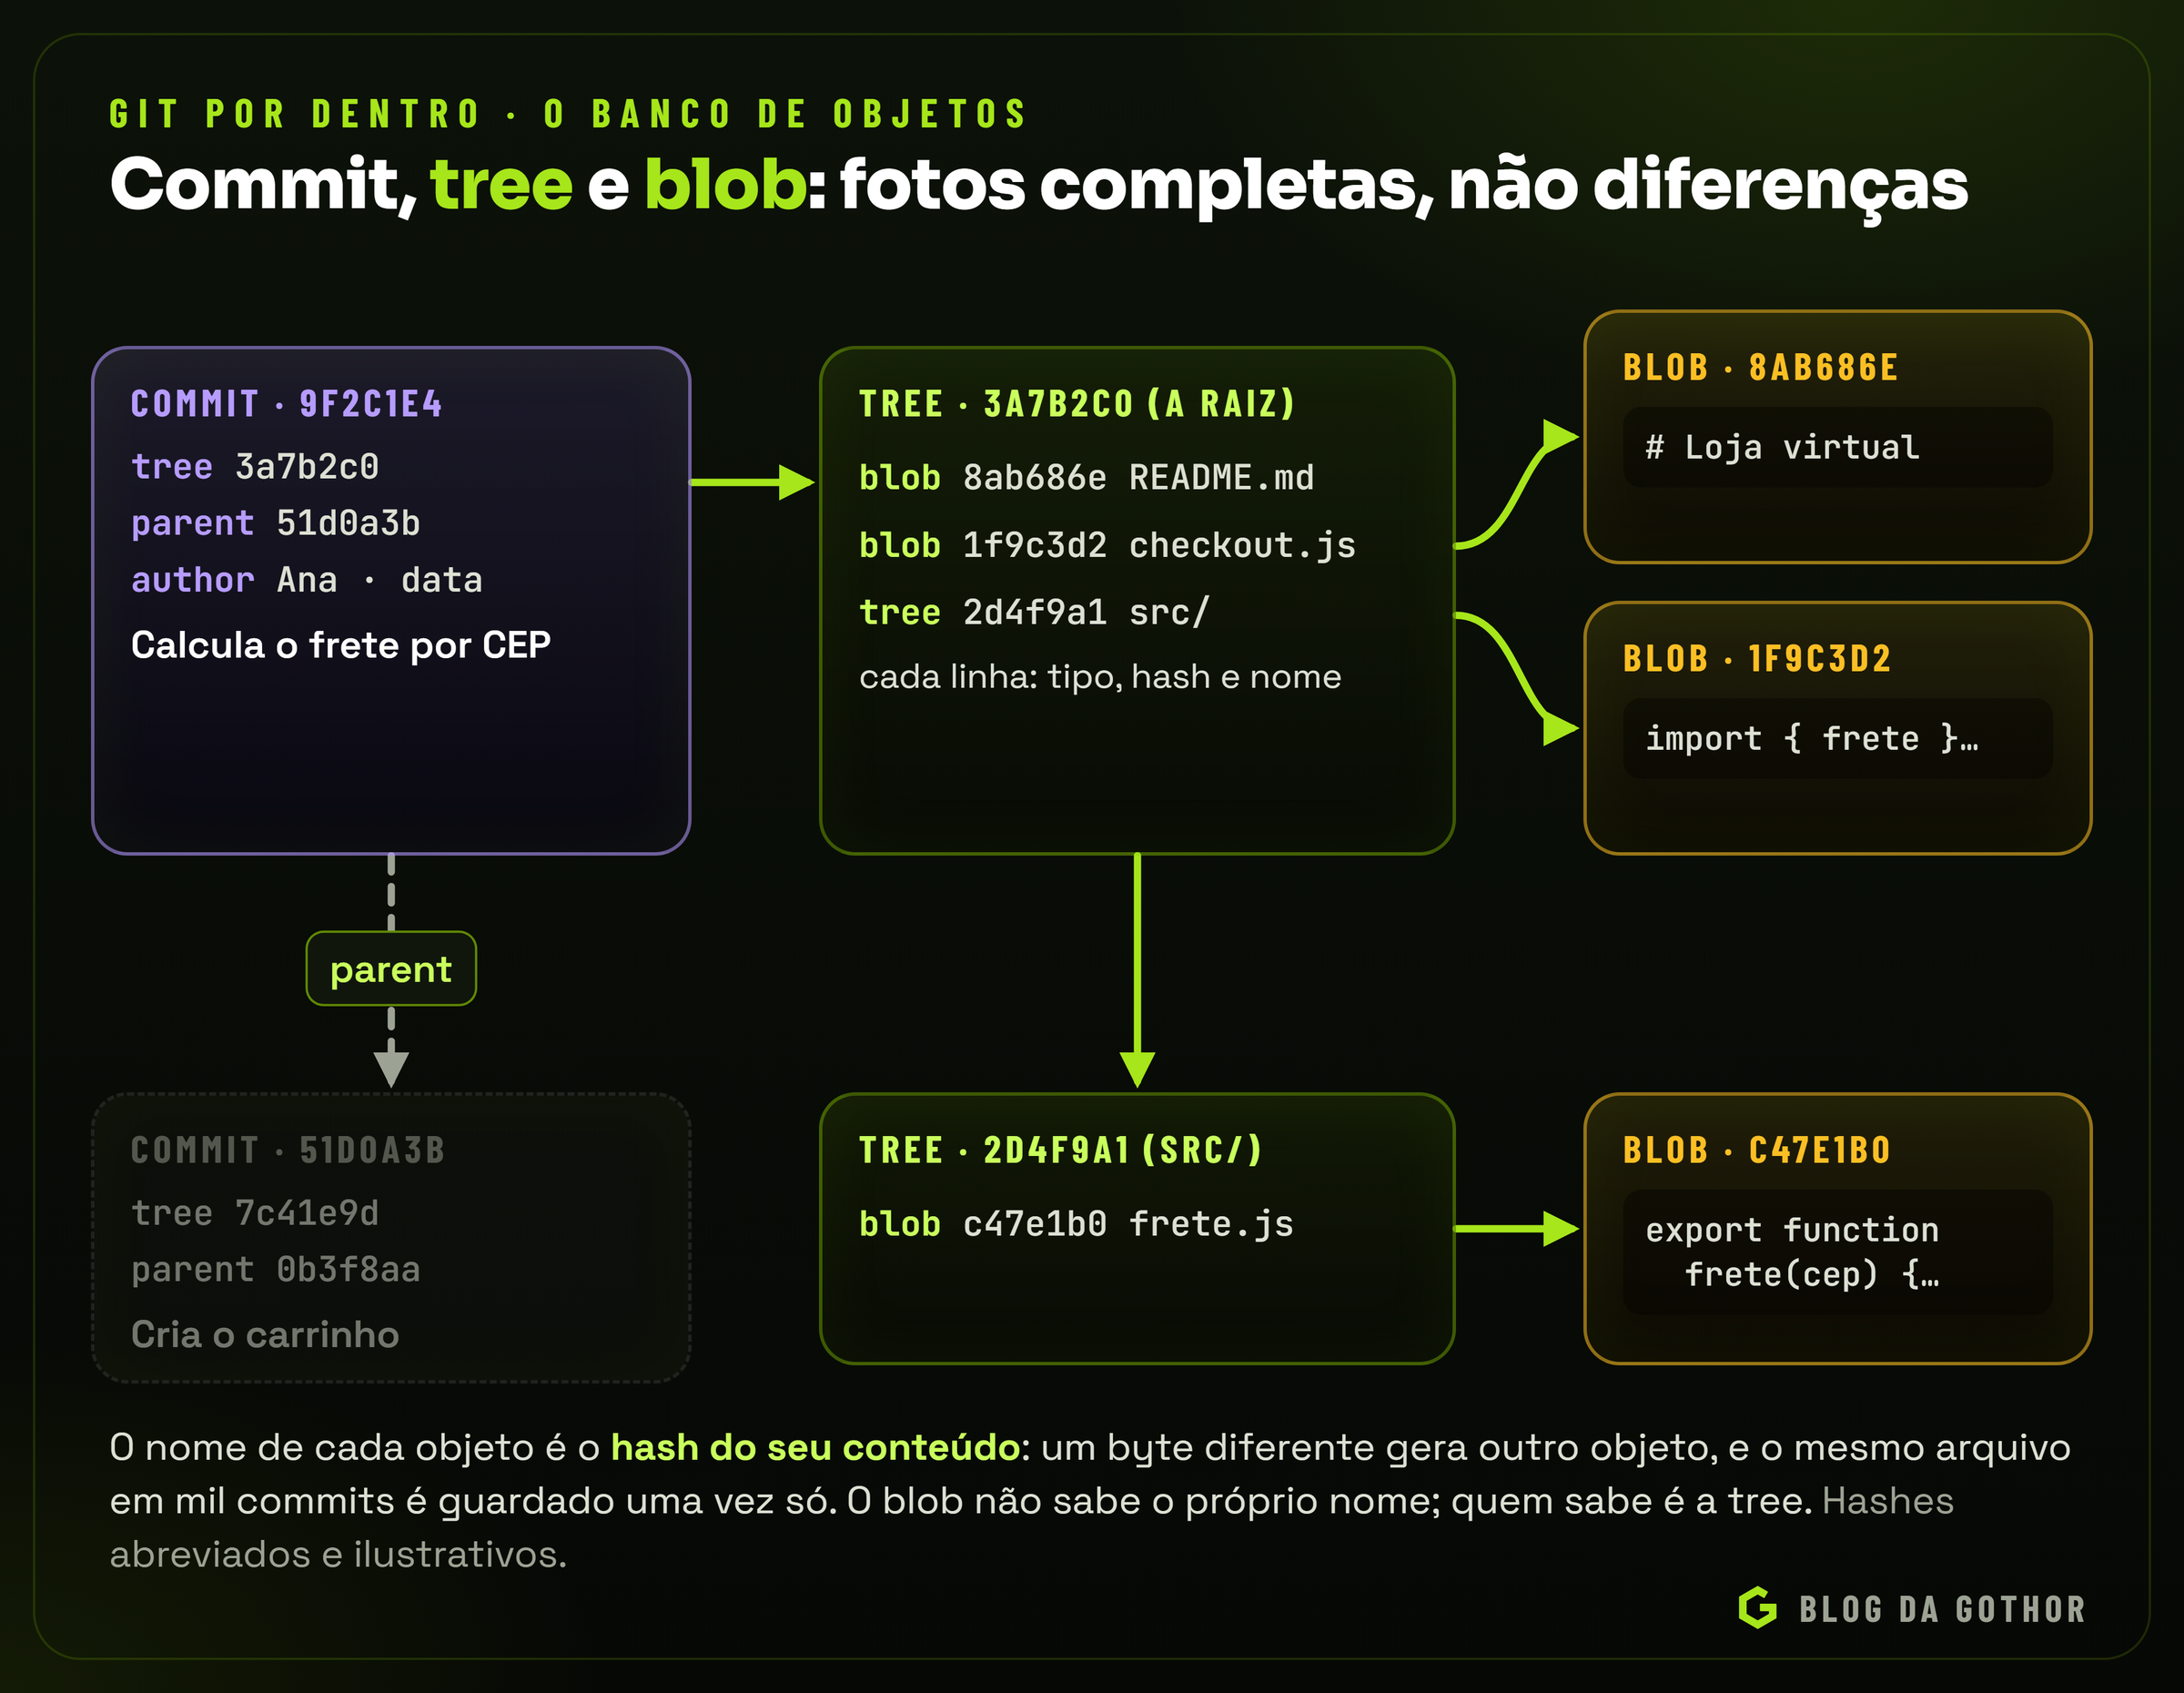
Por dentro, a pasta .git é um pequeno banco de dados de objetos. São só quatro tipos:
- blob: o conteúdo de um arquivo, e nada mais. Nem o nome, nem a permissão, só os bytes.
- tree: uma pasta. Lista entradas com o tipo, o hash e o nome de cada arquivo (blob) ou subpasta (outra tree).
- commit: aponta para a tree da raiz do projeto naquele momento e registra o autor, a data, a mensagem e o commit anterior (o pai).
- tag anotada: um rótulo permanente para um commit, com autor, data e mensagem, usado para marcar versões.
Dá para ver tudo isso com os próprios comandos do Git. Num repositório de exemplo com um README.md e uma pasta src, o comando git cat-file -p mostra o conteúdo cru de cada objeto:
$ git cat-file -p HEAD
tree 1db6eeb7be8cf28bc8fd2857e42cb12e4957f3e0
author Ana <ana@exemplo.com.br> 1792414800 -0400
committer Ana <ana@exemplo.com.br> 1792414800 -0400

Cria a loja

$ git cat-file -p 'HEAD^{tree}'
100644 blob 955be2c96a48dcc1d8a71fb48210a635415868a0	README.md
040000 tree f888aa4fd1b3c1f04904277db64fd46959020895	src
Repare em dois detalhes. O commit não guarda arquivos: guarda o hash de uma tree. E o blob não sabe o próprio nome: quem sabe que aquele conteúdo se chama README.md é a tree. É por isso que renomear um arquivo sem alterá-lo não cria um blob novo.
O endereço é o próprio conteúdo
Cada objeto é identificado pelo hash do seu conteúdo, historicamente um SHA-1 de 40 caracteres hexadecimais. O Git calcula o hash sobre um pequeno cabeçalho (o tipo e o tamanho) mais o conteúdo. O resultado é determinístico: o mesmo conteúdo gera sempre o mesmo hash, em qualquer computador do mundo.
$ echo 'hello' | git hash-object --stdin
ce013625030ba8dba906f756967f9e9ca394464a
Rode esse comando na sua máquina e o resultado será idêntico. Essa propriedade, chamada de endereçamento por conteúdo, tem consequências práticas importantes:
- Deduplicação automática. Um arquivo que não mudou em mil commits é guardado uma única vez: todas as trees apontam para o mesmo blob.
- Integridade. Se um byte de um objeto for corrompido, o hash deixa de bater e o Git percebe. Como cada commit inclui o hash do pai, alterar qualquer ponto do passado muda todos os hashes dali em diante.
- Comparação barata. Para saber se duas pastas são iguais, basta comparar o hash das trees, sem ler um único arquivo.
O SHA-1 deixou de ser considerado seguro contra ataques deliberados, e o Git reagiu em duas frentes: passou a usar uma versão do SHA-1 que detecta as colisões conhecidas e ganhou suporte a repositórios com SHA-256. A transição do ecossistema para o novo formato ainda está em andamento, mas o modelo é exatamente o mesmo, só muda a função de hash.
Packfiles: como tanta foto cabe em pouco espaço
Quando um objeto é criado, ele é gravado comprimido (com zlib) num arquivo próprio dentro de .git/objects. De tempos em tempos, e sempre que você envia ou recebe dados de um remoto, o Git agrupa os objetos em packfiles: arquivos únicos em que versões parecidas de um mesmo arquivo são guardadas como uma versão completa mais deltas. Ou seja, o modelo lógico é de fotos completas, mas o armazenamento físico é inteligente. O comando git gc faz essa arrumação manualmente, e o git count-objects -v mostra quanto espaço o repositório ocupa.
As três áreas: trabalho, índice e repositório
Com os objetos em mente, fica fácil entender o fluxo do dia a dia. Os arquivos que você edita passam por três lugares antes de virarem histórico:
- Diretório de trabalho: os arquivos no disco, que você vê e edita no editor.
- Índice, também chamado de staging area: um arquivo binário (
.git/index) que representa o próximo commit, montado aos poucos. - Repositório: os commits já gravados, imutáveis, dentro de
.git.
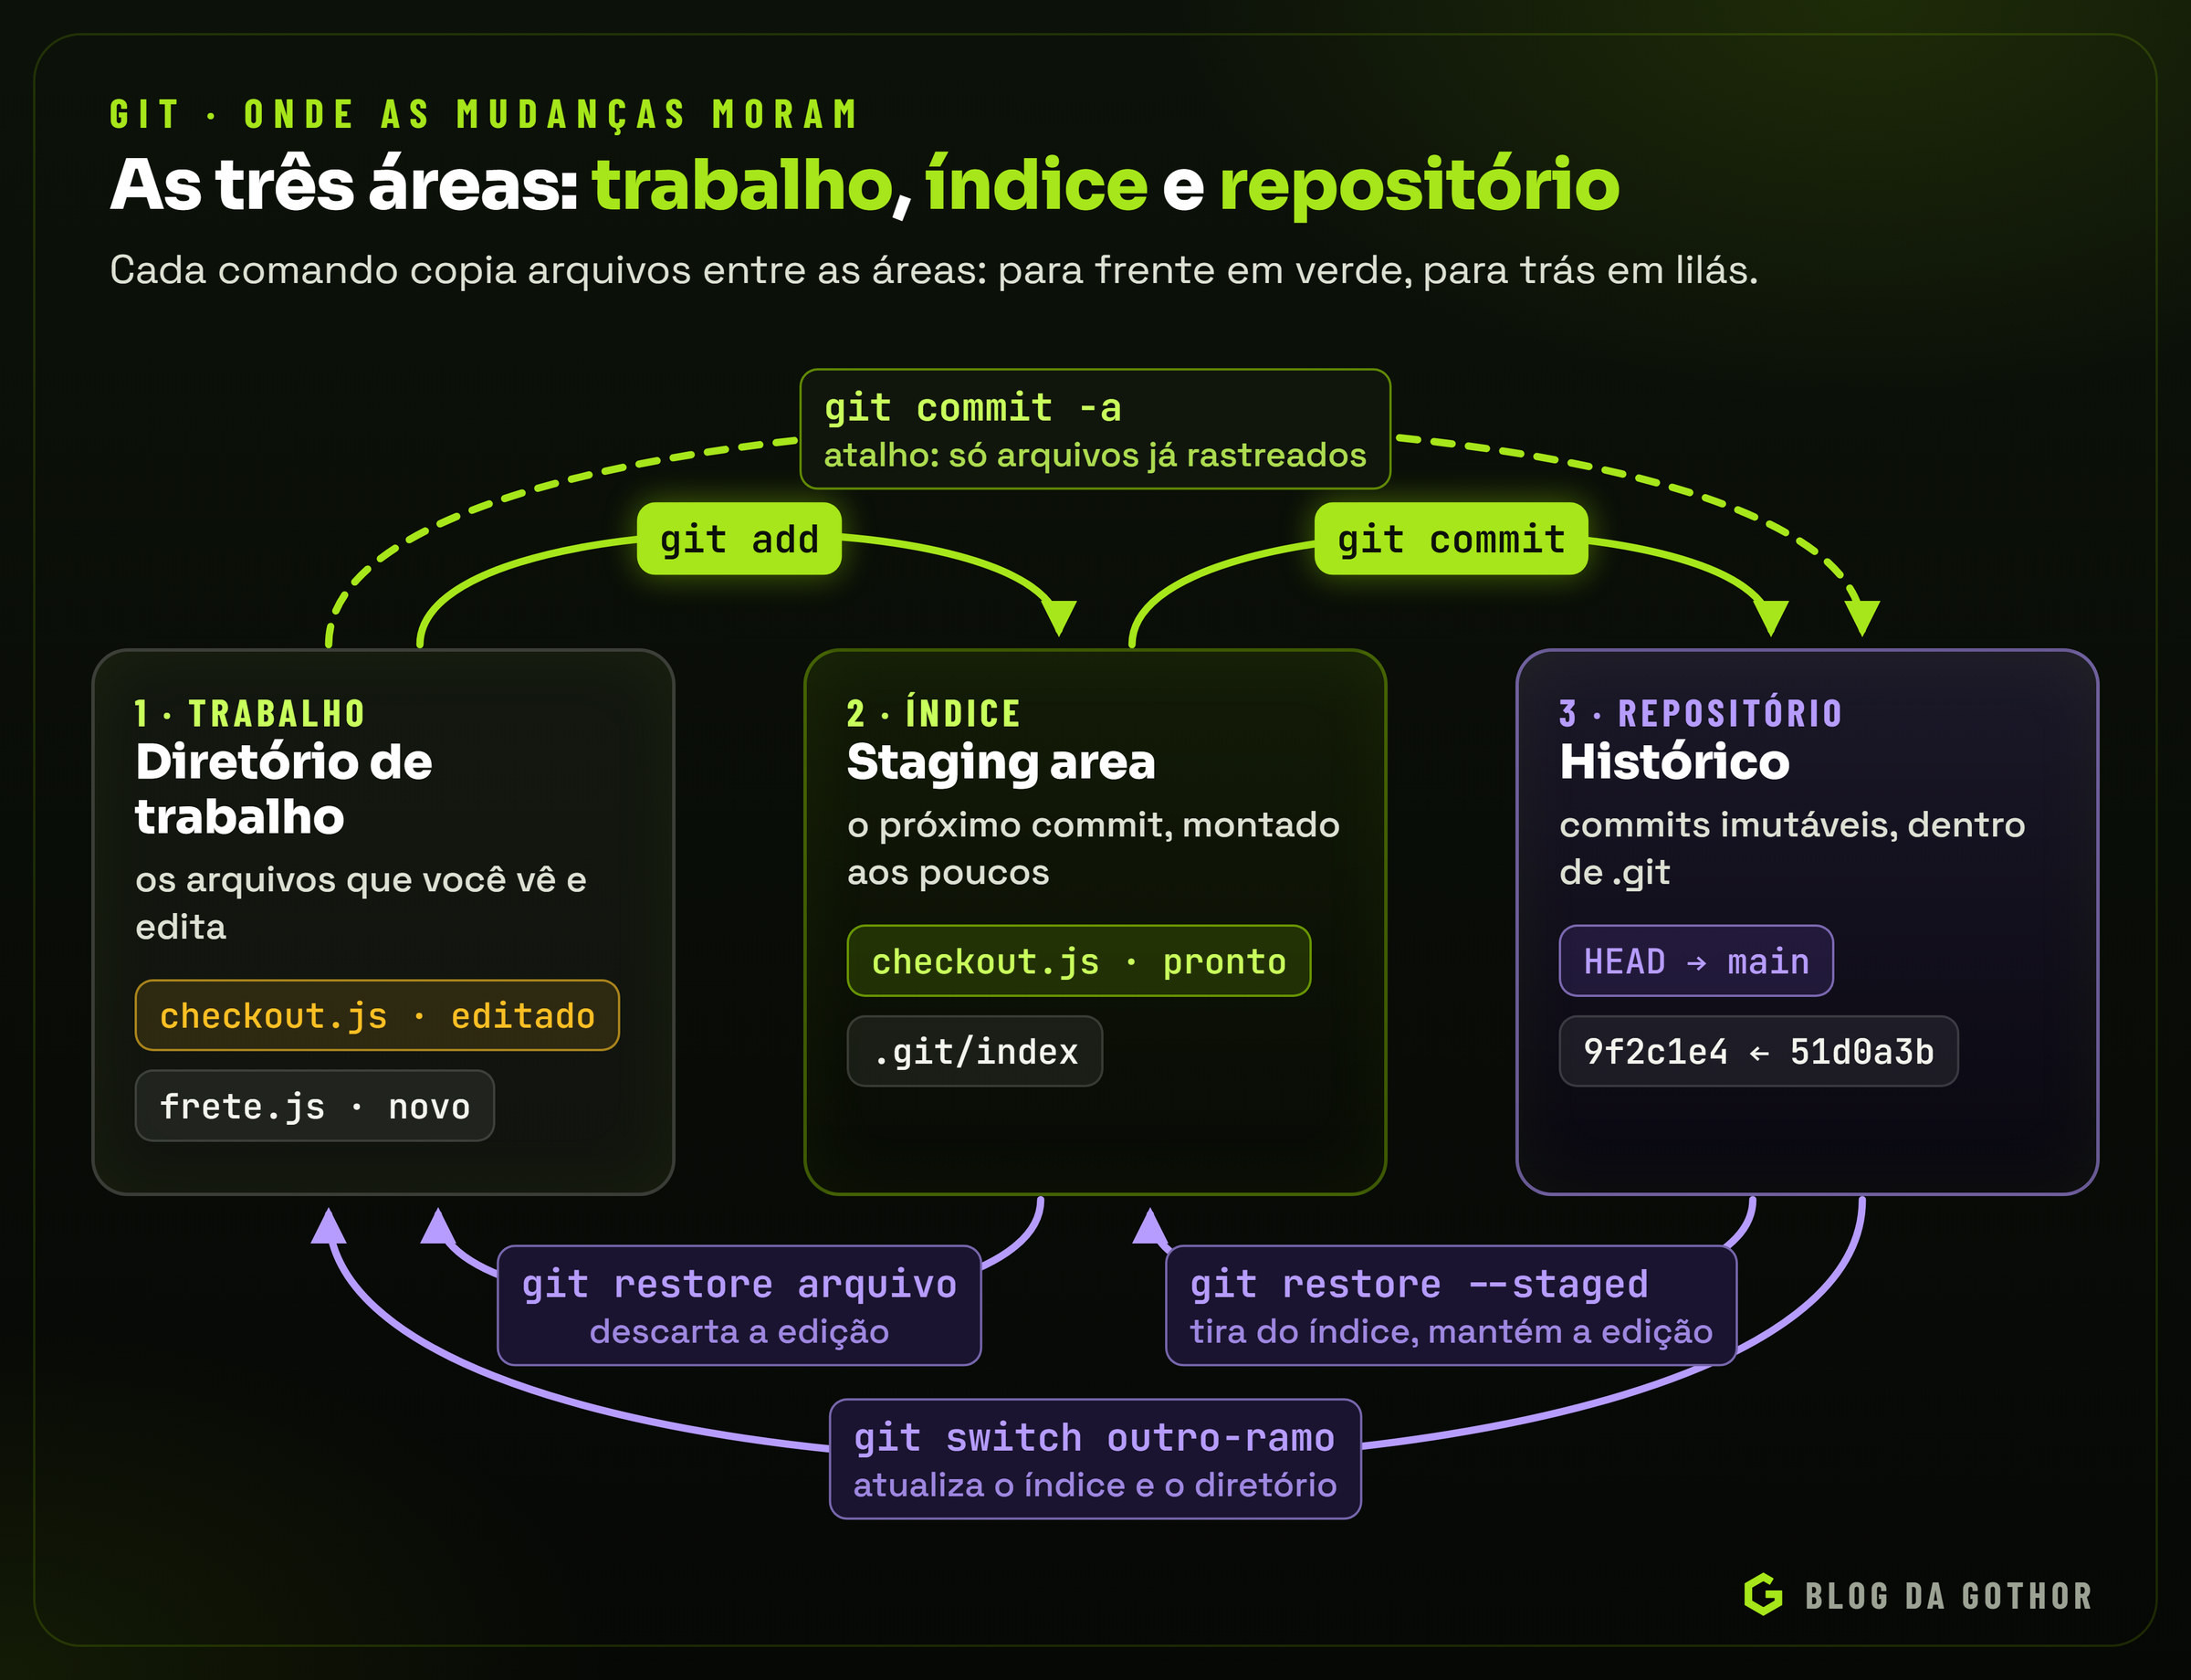
O índice é o que mais confunde quem vem de outras ferramentas, e é também o que dá ao Git a sua flexibilidade. Ele permite que você edite dez arquivos e faça dois commits separados e coerentes, cada um com uma parte das mudanças. Com git add -p, dá para escolher até trechos de um mesmo arquivo:
git status                 # o que mudou no diretório e o que já está no índice
git diff                   # diferenças entre o diretório de trabalho e o índice
git diff --staged          # diferenças entre o índice e o último commit
git add -p src/frete.js    # escolhe, trecho a trecho, o que entra no próximo commit
git commit -m "Calcula o frete por CEP"
Os comandos de volta seguem a mesma lógica. git restore arquivo copia a versão do índice para o diretório de trabalho, descartando a edição. git restore --staged arquivo copia a versão do último commit para o índice, ou seja, tira o arquivo do próximo commit sem mexer no que você editou. git switch troca de ramo e atualiza as duas áreas de uma vez. Os comandos switch e restore existem desde 2019 justamente para separar responsabilidades que antes se acumulavam no git checkout, que continua funcionando.
Ramos, HEAD e o grafo de commits
Como cada commit aponta para o seu pai, o histórico forma uma cadeia. Quando dois commits têm o mesmo pai, a cadeia se divide; quando um commit tem dois pais, ela se junta. O resultado é um grafo acíclico dirigido, que é a forma técnica de dizer "uma árvore que pode se dividir e se juntar, mas nunca andar em círculo".
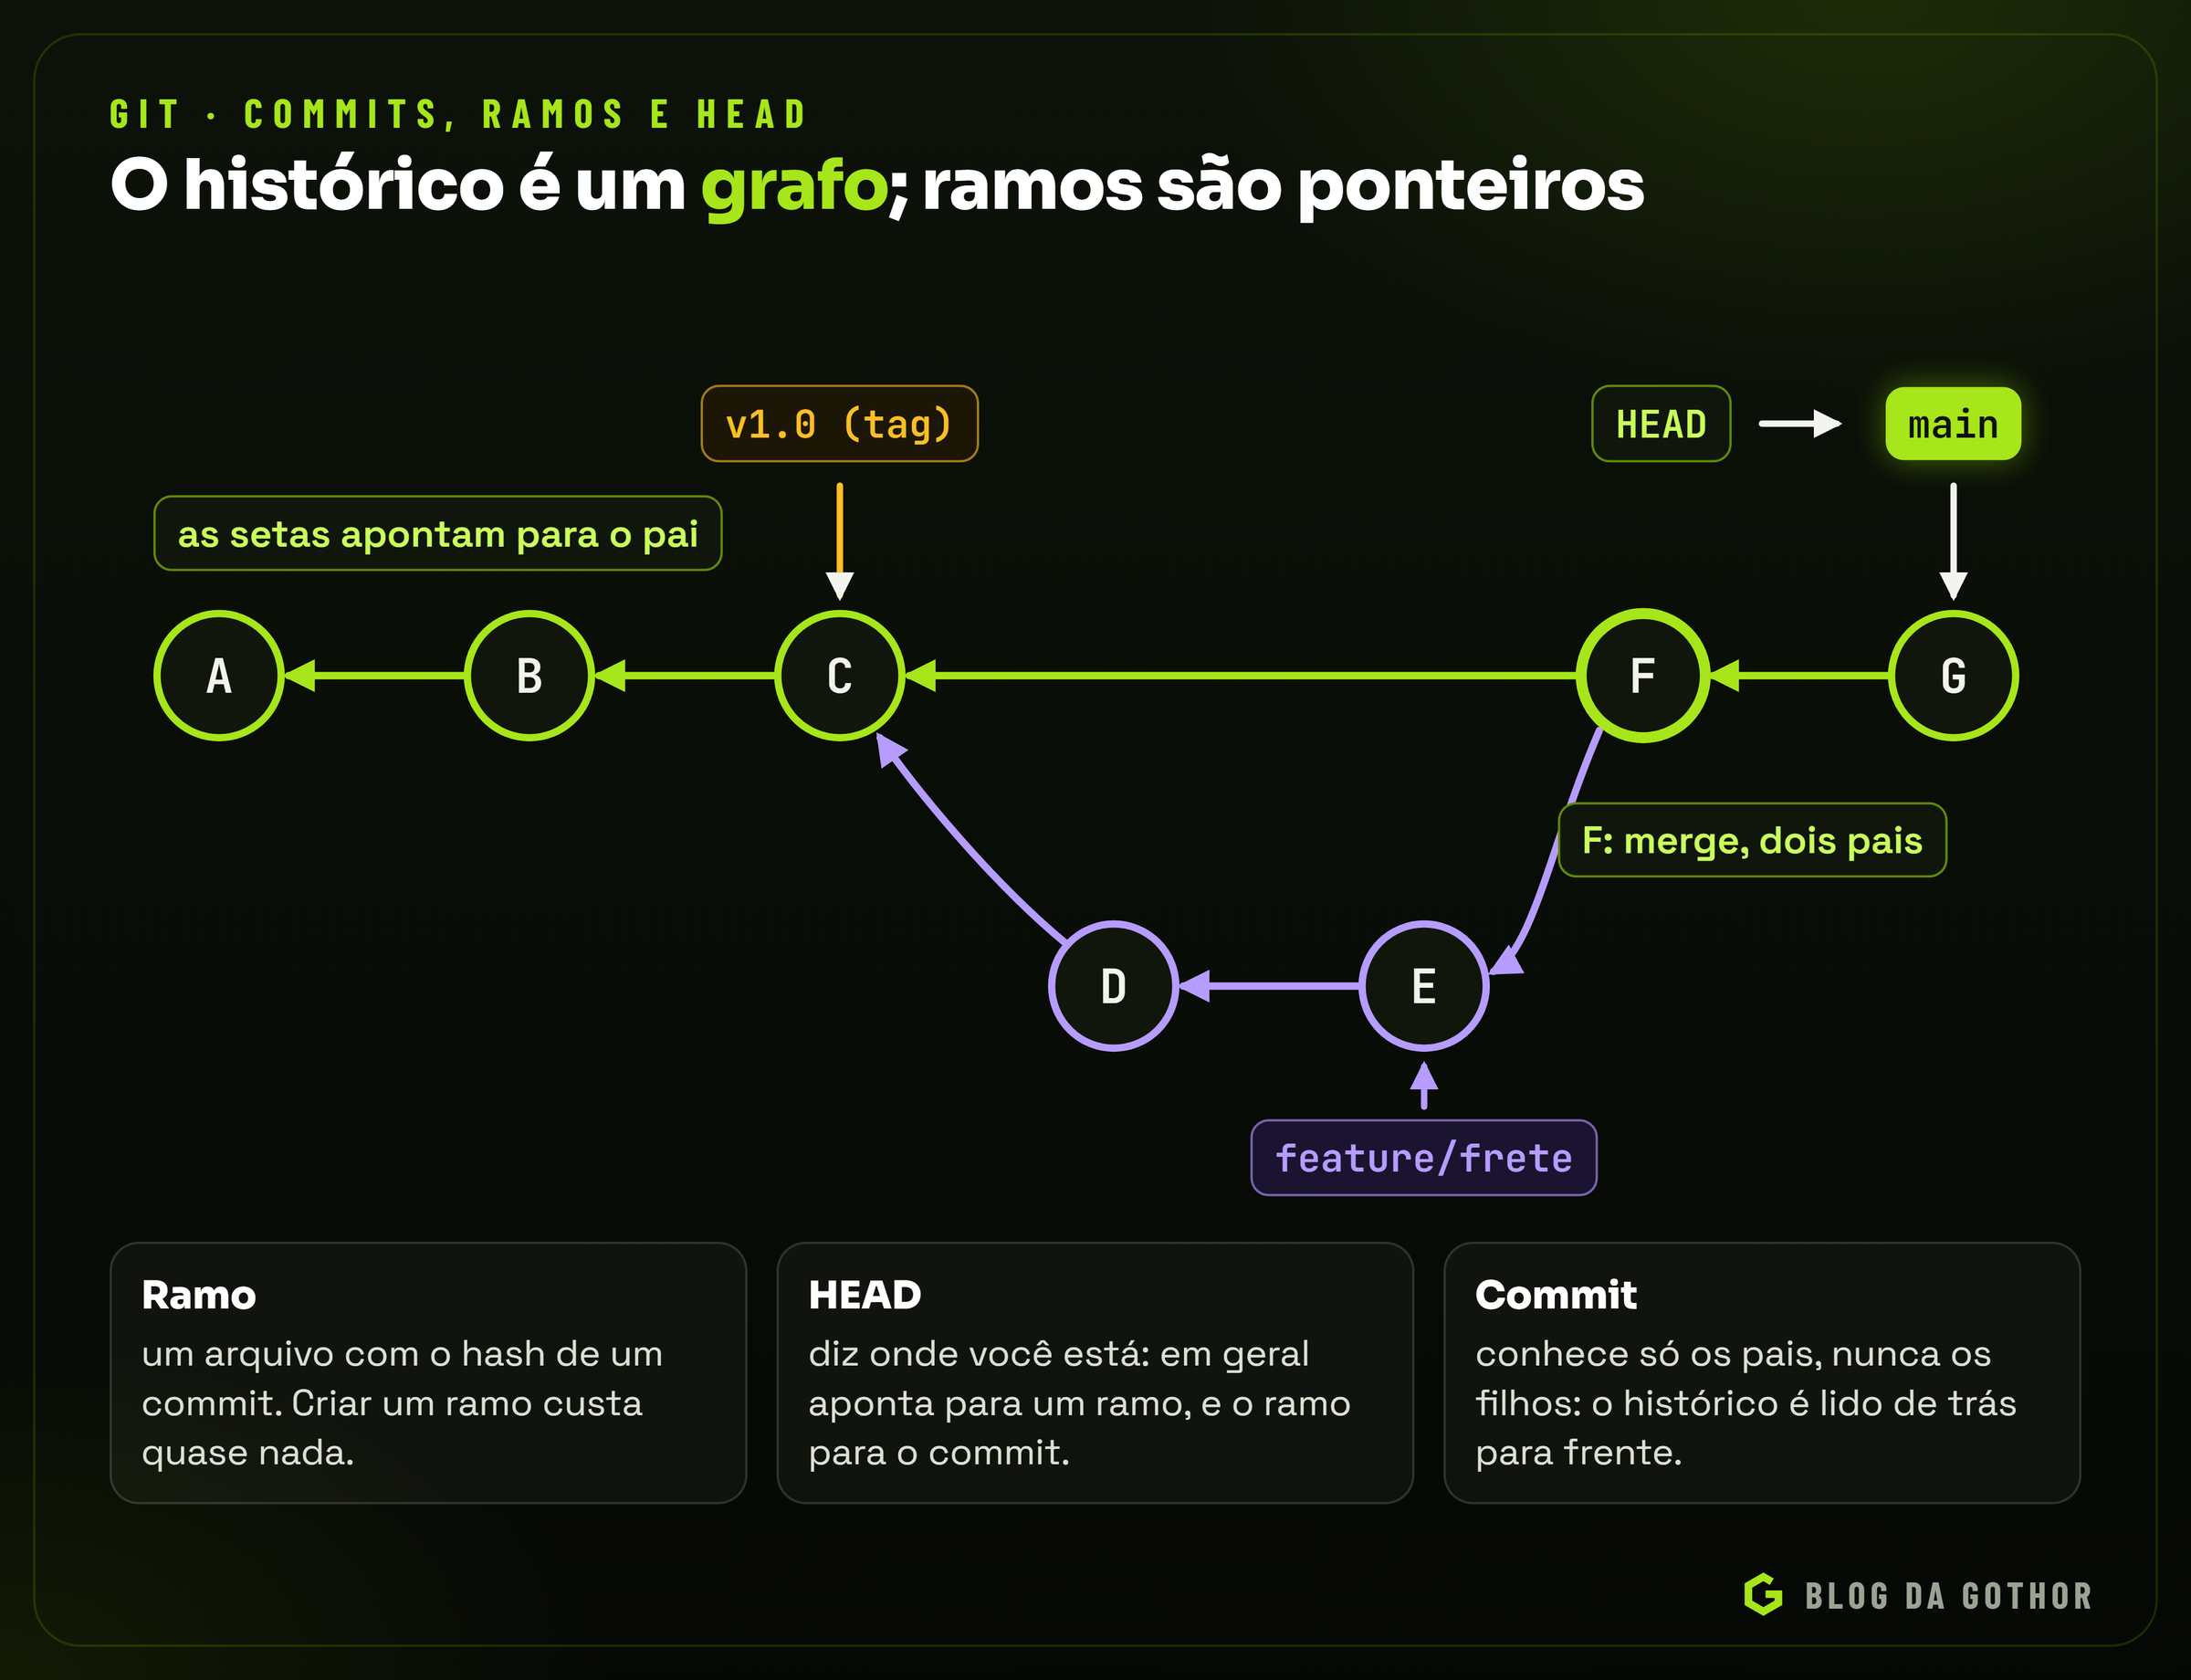
Nesse grafo, um ramo (branch) é surpreendentemente simples: é um arquivo de texto com o hash de um commit. No repositório de exemplo:
$ cat .git/HEAD
ref: refs/heads/main

$ cat .git/refs/heads/main
86ce5566c75b782e4aa762fee0a4b6a73fb50072
É só isso. Na forma mais simples, criar um ramo é criar um arquivo de 41 bytes (o Git também pode agrupar essas referências num arquivo só, mas a ideia é a mesma); por isso é instantâneo, e por isso o Git incentiva criar ramos para qualquer tarefa, por menor que seja. Quando você faz um commit, o Git grava os objetos e move o ponteiro do ramo atual para o commit novo.
O HEAD é o ponteiro que diz onde você está. Em geral ele aponta para um ramo, que aponta para um commit. Se você fizer git switch --detach para um commit específico, o HEAD passa a apontar diretamente para o commit, no estado chamado de detached HEAD. Não há nada de errado nisso para inspecionar uma versão antiga; o cuidado é que commits feitos nesse estado não pertencem a nenhum ramo e podem ficar esquecidos.
As tags são ponteiros que não andam. Uma tag v1.0 marca para sempre o commit que foi para produção naquela versão, o que facilita voltar exatamente àquele estado.
Criar, trocar e apagar ramos
git switch -c feature/frete     # cria o ramo a partir de onde você está e muda para ele
git switch main                 # volta para a main
git branch                      # lista os ramos locais
git branch -d feature/frete     # apaga o ramo (só se já foi integrado)
git log --oneline --graph --all # desenha o grafo no terminal
Um detalhe que ajuda muito a ler o histórico: um commit conhece os pais, mas nunca os filhos. Por isso o git log sempre anda de trás para frente, a partir de um ponteiro. Commits que nenhum ramo, tag ou HEAD alcança são considerados inacessíveis e, depois de um tempo, são removidos pela coleta de lixo.
Integrar trabalho: merge e rebase
Ramos só têm valor se puderem voltar a se juntar. O Git oferece duas formas de integrar o trabalho de um ramo em outro, e entender a diferença entre elas evita boa parte dos problemas de equipe.
Merge
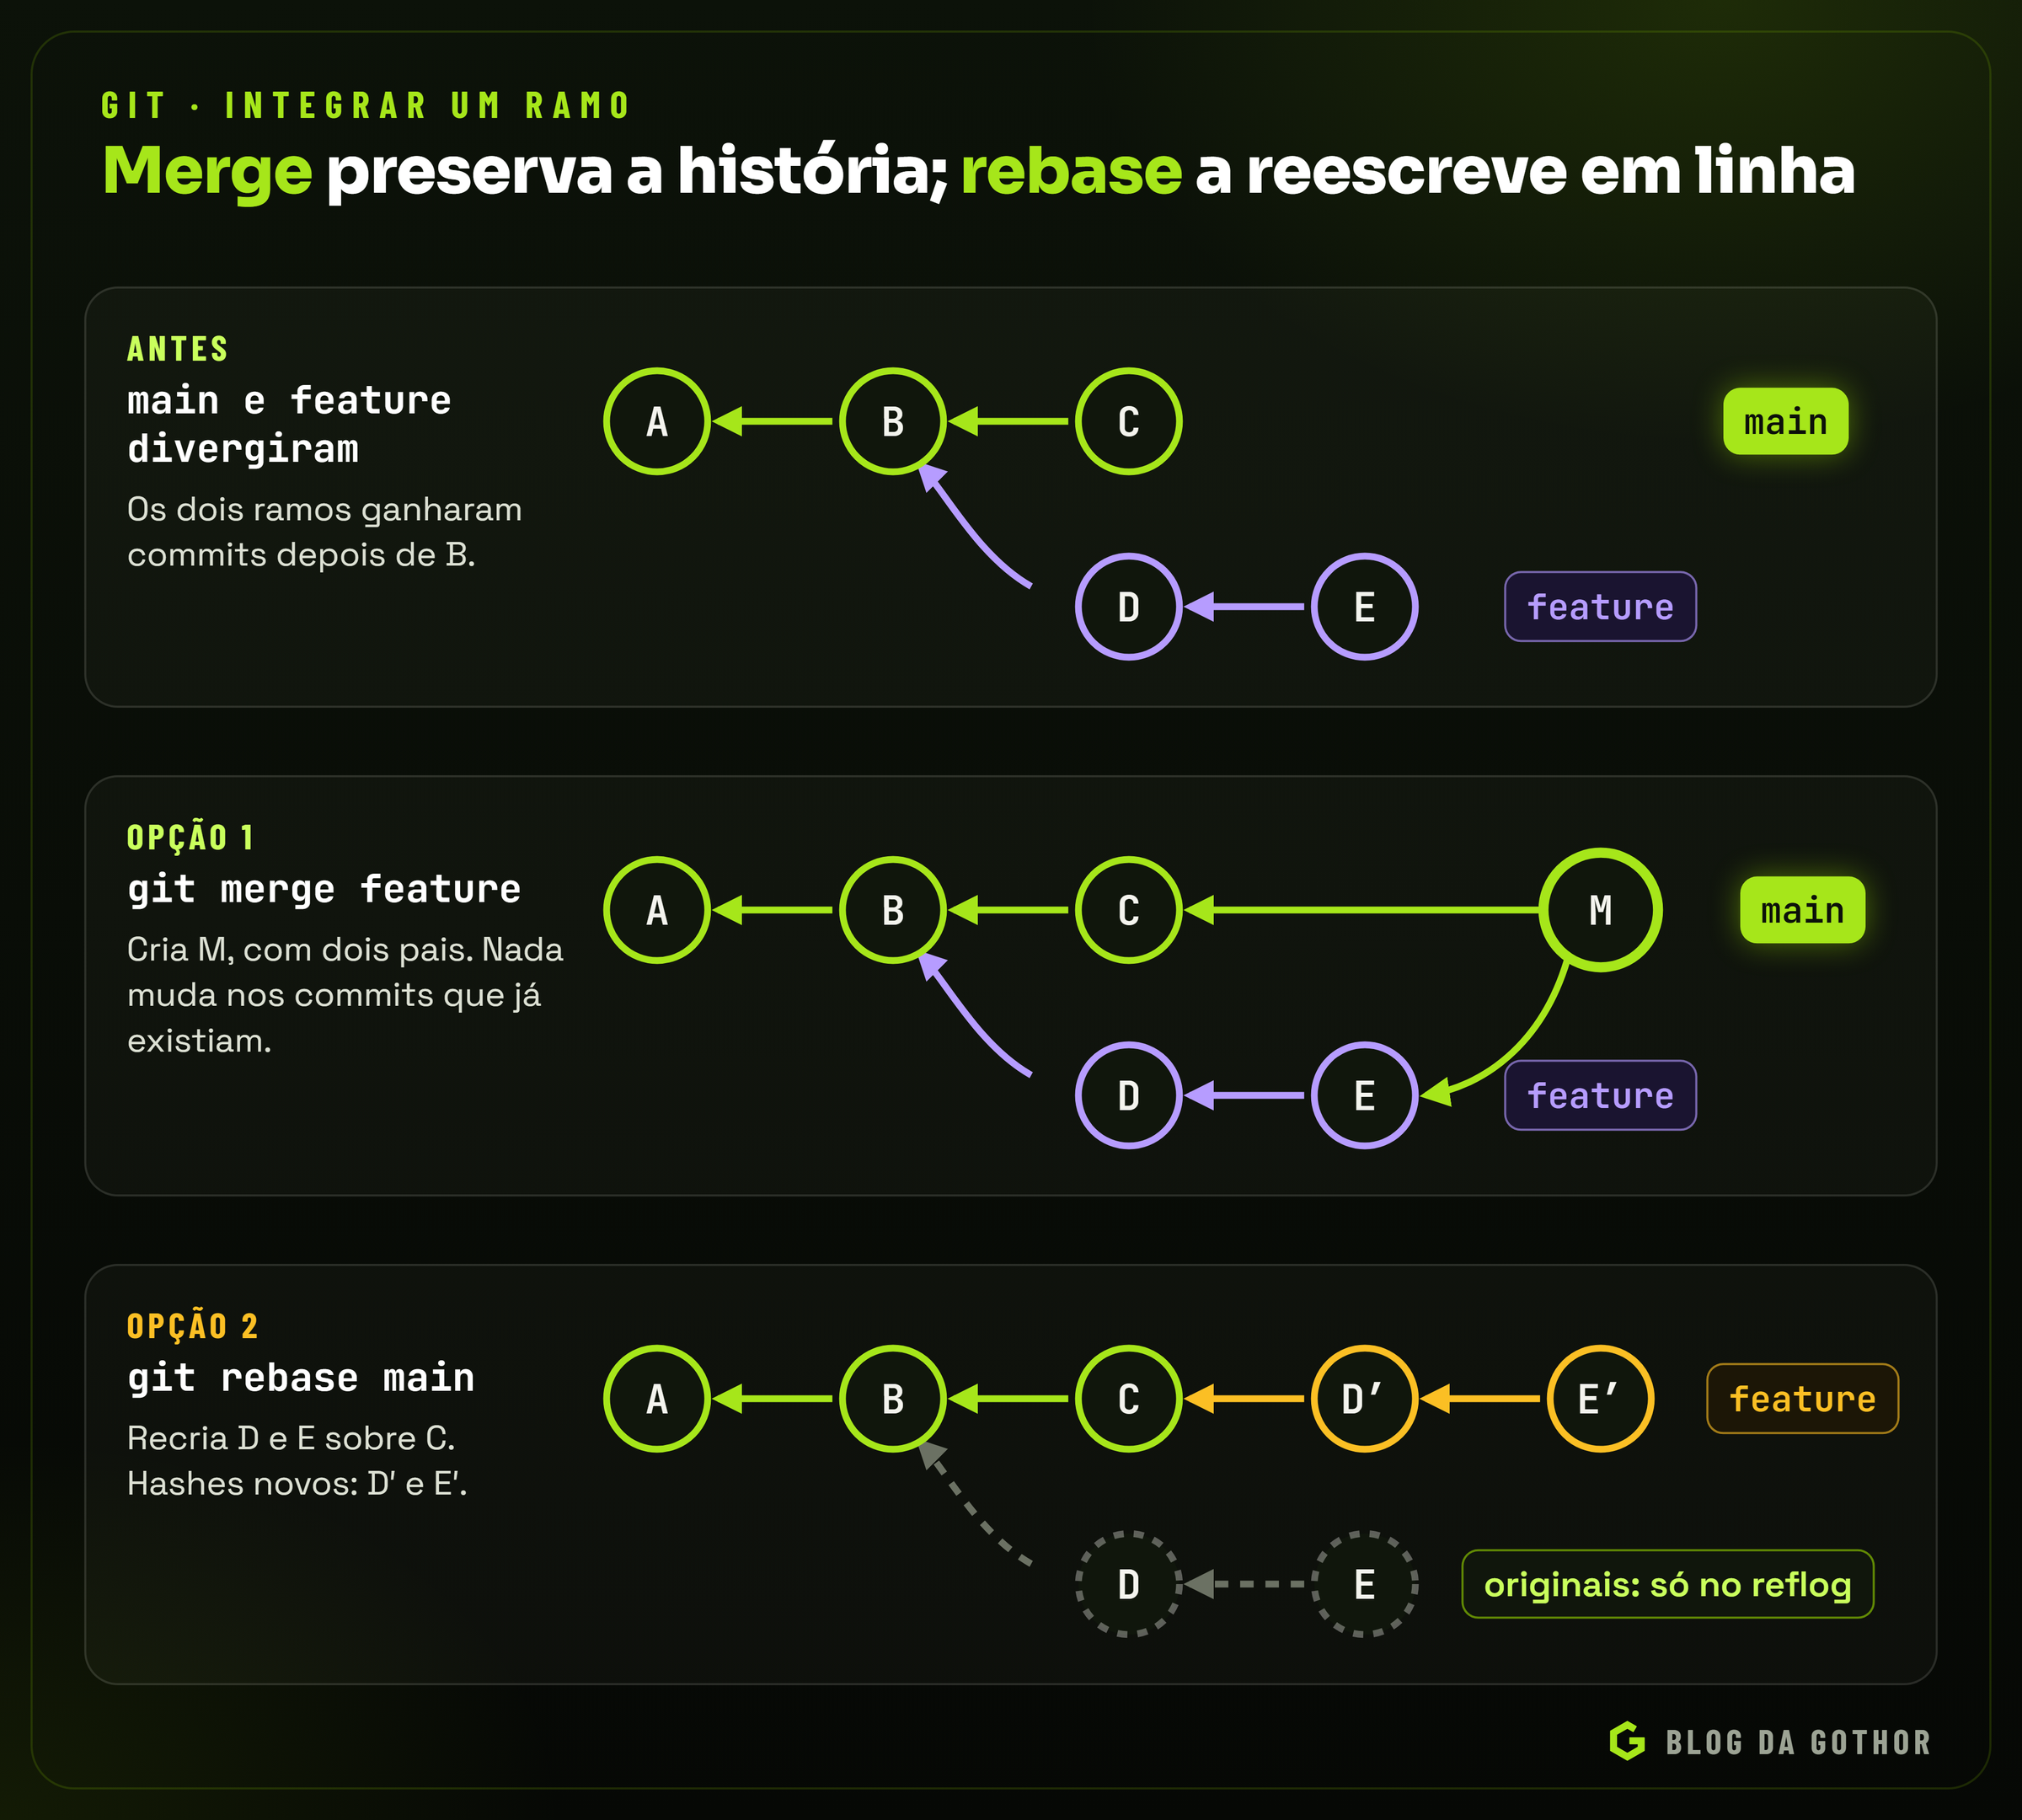
O git merge junta dois históricos. Há dois casos:
- Fast-forward: se a
mainnão andou desde que o ramo foi criado, não há nada para combinar. O Git simplesmente avança o ponteiro damainaté o último commit do ramo. - Merge de três vias: se os dois lados andaram, o Git encontra o ancestral comum (a merge base), compara cada lado com ele e combina as mudanças, criando um commit de merge com dois pais. Desde a versão 2.34, a estratégia padrão para isso se chama
ort, mais rápida e previsível que a antigarecursive.
O merge não altera nenhum commit existente. Ele só acrescenta. Isso o torna seguro para ramos compartilhados e preserva a história como ela de fato aconteceu, com o custo de um grafo mais ramificado.
Rebase
O git rebase main, executado no ramo de funcionalidade, faz outra coisa: pega os commits do ramo que ainda não estão na main e os reaplica um a um sobre a ponta da main. O resultado é um histórico linear, como se o trabalho tivesse começado depois das últimas mudanças da main.
O ponto essencial é que os commits reaplicados são commits novos, com hashes novos, porque o pai mudou e o hash depende do pai. Os originais continuam existindo por um tempo, alcançáveis só pelo reflog. Daí vem a regra de ouro:
Não faça rebase de commits que outras pessoas já baixaram. Reescrever um histórico publicado obriga todos a reconciliar cópias que não batem mais.
O rebase também tem um modo interativo, git rebase -i, que permite reordenar, juntar (squash), editar ou descartar commits antes de publicar um ramo. É a forma usual de transformar uma sequência de commits de rascunho ("ajuste", "agora vai", "corrige o anterior") em dois ou três commits limpos e revisáveis.
Conflitos sem drama
Um conflito acontece quando os dois lados alteraram o mesmo trecho de forma diferente e o Git não tem como decidir sozinho. Ele para, marca o arquivo e espera você:
export function frete(cep) {
<<<<<<< HEAD
  return cep.startsWith("78") ? 15 : 30;
=======
  return cep.startsWith("78") ? 12 : 30;
>>>>>>> feature/frete
}
Entre <<<<<<< e ======= está a versão do lado em que você está; entre ======= e >>>>>>>, a do outro lado. Resolver é editar o arquivo até ele ficar como deve ser, apagar os marcadores, rodar os testes e concluir com git add e git commit (num merge) ou git rebase --continue (num rebase). Se a situação ficar confusa, git merge --abort ou git rebase --abort voltam tudo ao estado anterior. Para conflitos que se repetem, a opção rerere ("reuse recorded resolution") faz o Git lembrar como você resolveu e reaplicar a solução.
Conflitos frequentes quase sempre indicam ramos que vivem tempo demais. Integrar com mais frequência, em pedaços menores, é o melhor remédio.
Quando usar cada um
| Situação | Melhor escolha | Por quê |
|---|---|---|
Atualizar o seu ramo local com a main | rebase | mantém o seu trabalho linear e fácil de revisar |
Integrar um ramo revisado na main | merge (ou squash, se a equipe preferir) | não reescreve nada que já foi publicado |
| Limpar commits de rascunho antes de abrir o pull request | rebase interativo | a revisão fica mais clara |
| Ramo que outras pessoas já baixaram | merge | o rebase obrigaria todos a reconciliar cópias |
| Corrigir a mensagem do último commit, ainda local | commit --amend | recria só o último commit |
Trabalho em equipe: remotos, fetch, pull e push
Um remoto é outra cópia do mesmo repositório, normalmente num servidor como o GitHub. Por convenção, o remoto de onde você clonou se chama origin. Os comandos de sincronização são poucos, e cada um tem uma direção:
git clonecopia um repositório inteiro, com todo o histórico, na primeira vez.git fetchbusca os commits novos do remoto e atualiza os ramos de rastreamento remoto, comoorigin/main. Não mexe nos seus ramos nem nos seus arquivos.git pullé umfetchseguido de uma integração (merge ou rebase) no ramo atual.git pushenvia os seus commits e move o ramo correspondente no remoto.
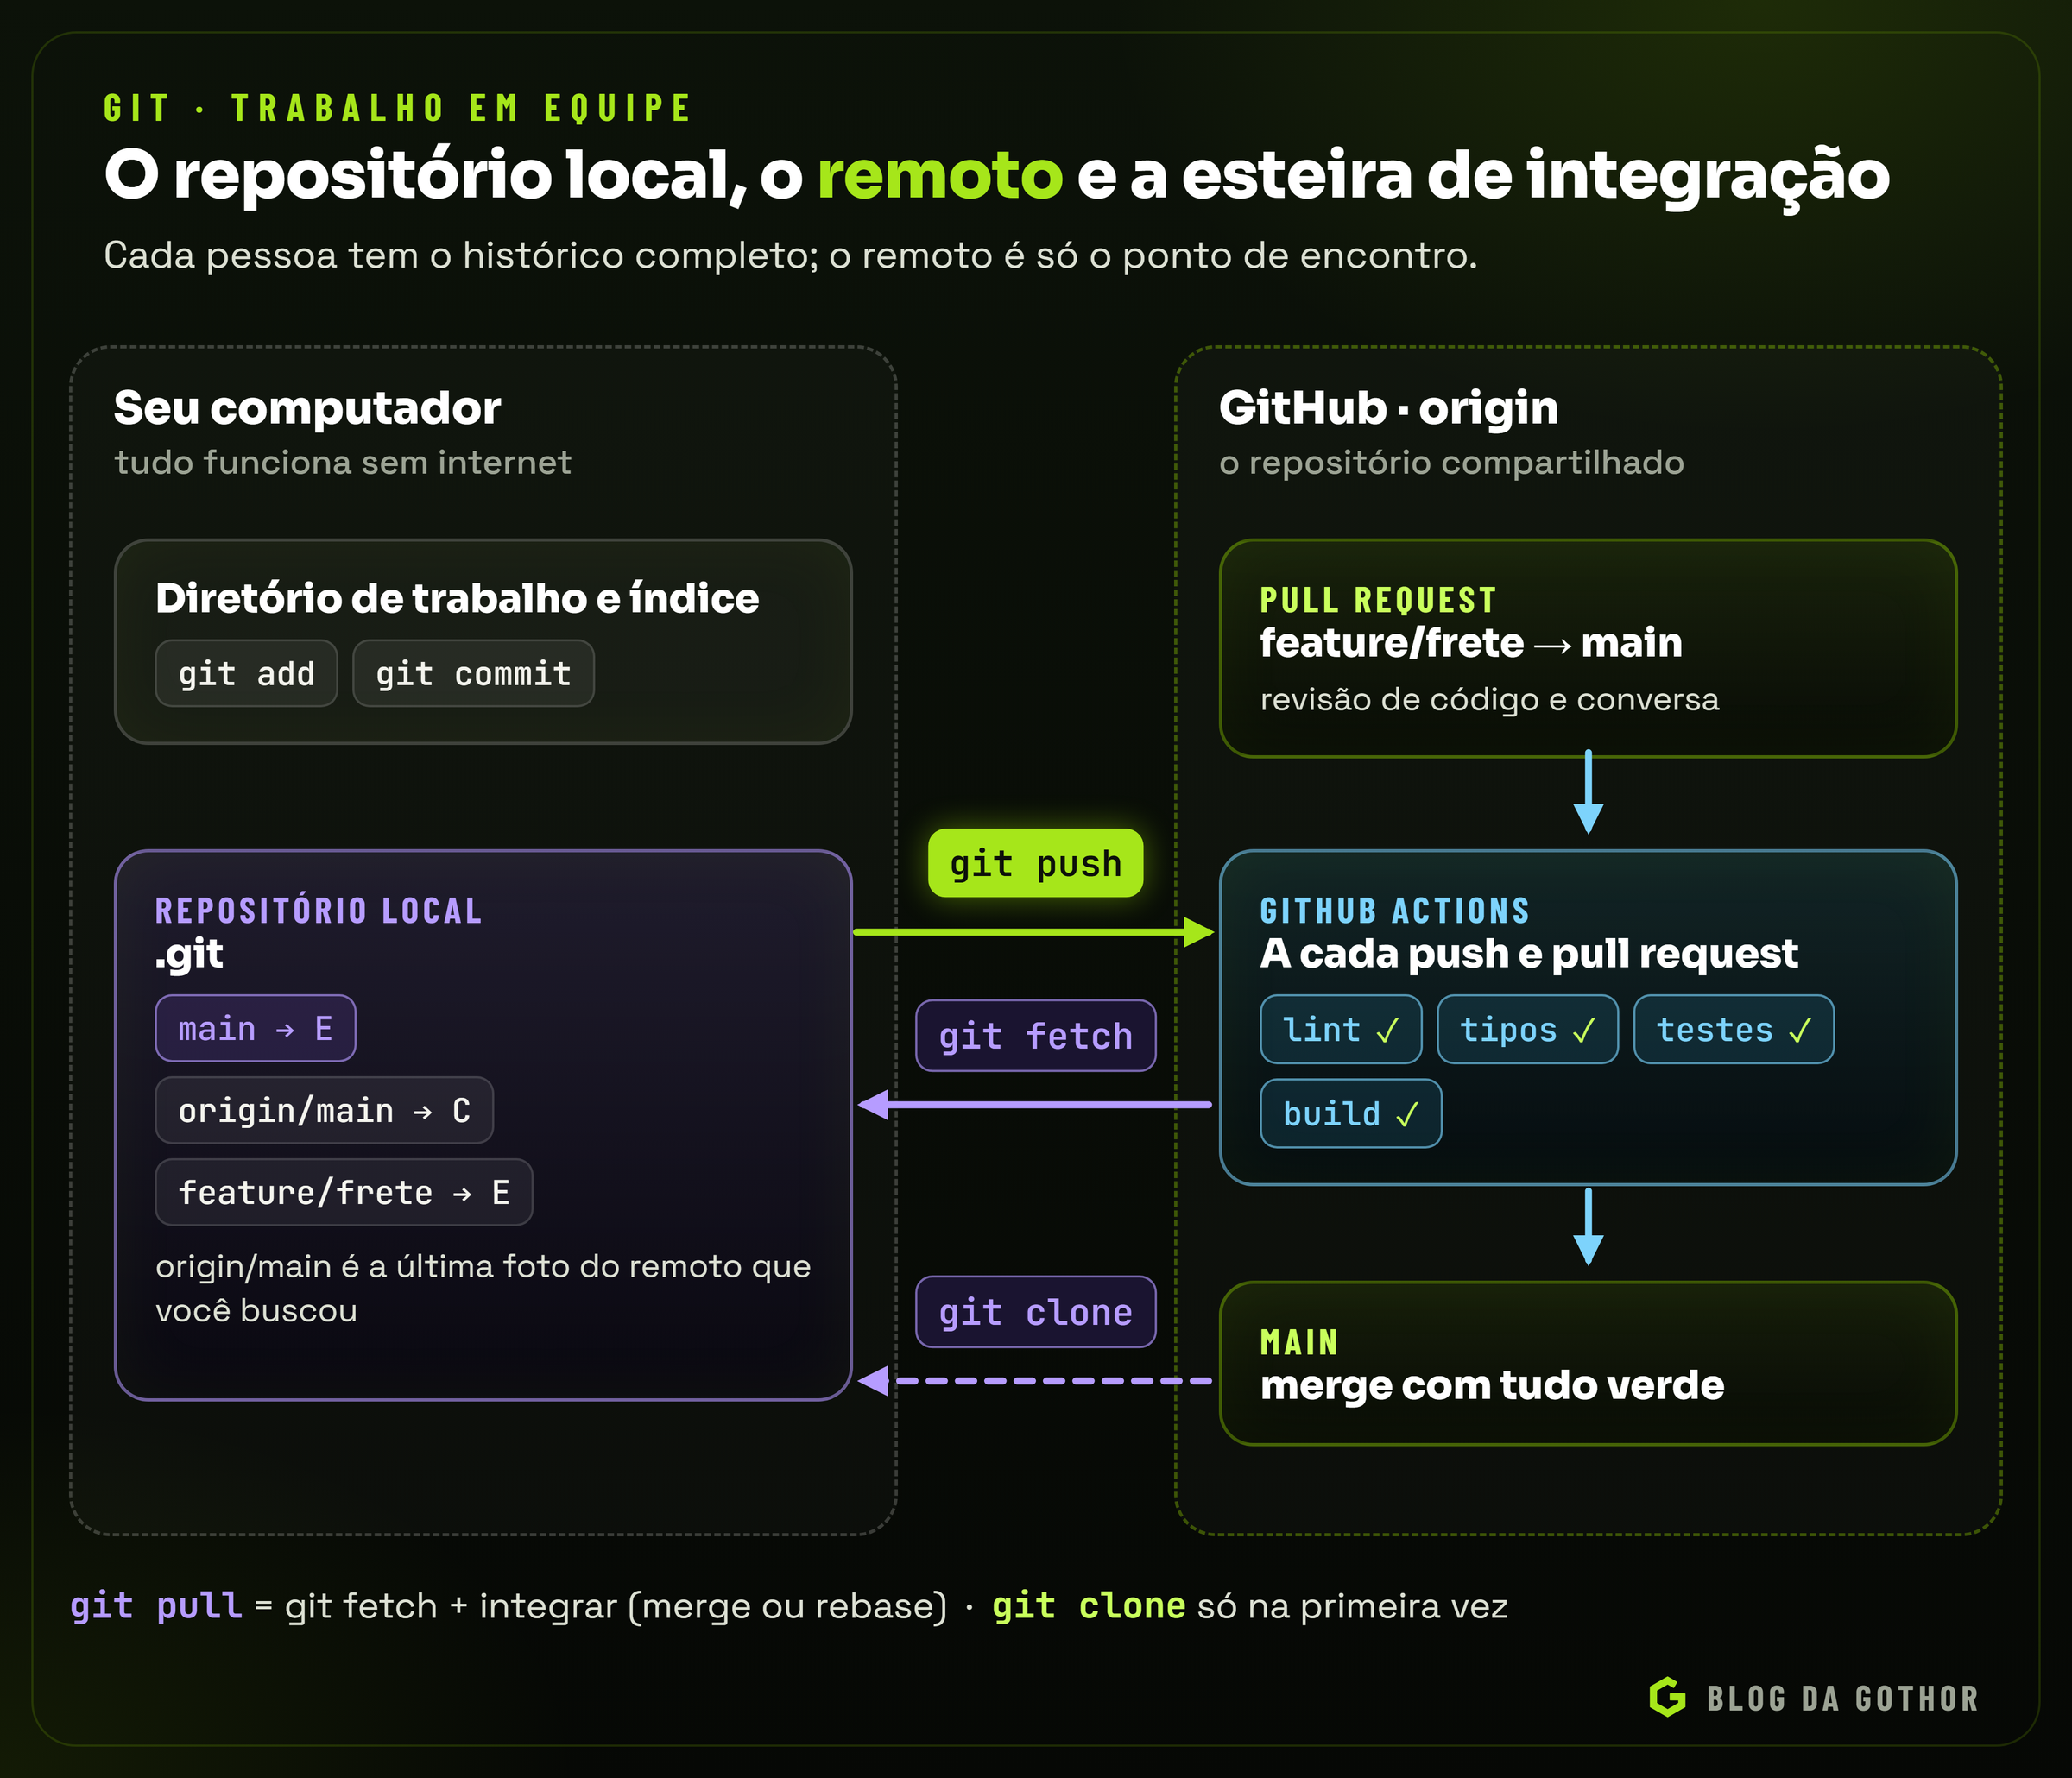
O origin/main merece atenção: ele é a última foto do remoto que você buscou, e não o remoto em tempo real. Por isso um git log origin/main pode estar desatualizado até o próximo fetch. Rodar git fetch antes de comparar ou integrar é um hábito que evita surpresas.
Quando um push é recusado com a mensagem de que o remoto tem commits que você não tem, o Git está protegendo o trabalho de outra pessoa. A resposta certa é buscar e integrar (git pull --rebase, por exemplo) e enviar de novo. Se você precisa mesmo sobrescrever um ramo seu que reescreveu com rebase, use git push --force-with-lease: ele só sobrescreve se o remoto ainda estiver como você o viu da última vez, o que evita apagar sem querer um commit que alguém enviou nesse meio-tempo.
Algumas configurações deixam o dia a dia mais previsível:
git config --global init.defaultBranch main   # nome do primeiro ramo em repositórios novos
git config --global pull.rebase true          # pull com rebase, sem commits de merge à toa
git config --global fetch.prune true          # remove origin/ramos que já foram apagados no remoto
git config --global rerere.enabled true       # reaproveita resoluções de conflito
Pull requests e fluxos de trabalho
O pull request (ou merge request, no GitLab) não é um recurso do Git: é uma conversa em torno de um ramo, oferecida pelo serviço de hospedagem. Nele acontecem a revisão de código, os comentários e, cada vez mais, a integração contínua: a cada push, um serviço como o GitHub Actions instala as dependências, compila, roda os testes e marca o pull request como aprovado ou reprovado. Junto com regras de proteção do ramo principal, isso impede que um código que quebra o build chegue à main.
Sobre esse mecanismo, as equipes organizam fluxos de trabalho diferentes:
| Fluxo | Como funciona | Combina com |
|---|---|---|
| Trunk-based | ramos curtos, de horas ou poucos dias, integrados na main com frequência | equipes que publicam continuamente e têm boa cobertura de testes |
| GitHub Flow | um ramo por mudança, pull request com revisão, merge na main e publicação | a maioria dos produtos web |
| Git Flow | ramos develop, release e hotfix além da main | produtos com versões numeradas e várias versões em manutenção |
Não existe fluxo certo em abstrato. O que existe é o fluxo que a sua equipe consegue seguir com disciplina, e quanto mais simples ele for, maior a chance de ser seguido.
Desfazer sem medo
A melhor notícia sobre o Git é que é muito difícil perder um trabalho que já foi commitado. Quase todo erro tem volta, desde que você conheça a ferramenta certa:
| Situação | Comando | O que faz |
|---|---|---|
| Quero descartar a edição de um arquivo | git restore arquivo | volta o arquivo para a versão do índice |
| Adicionei ao índice por engano | git restore --staged arquivo | tira do próximo commit, mantém a edição |
| Esqueci um arquivo no último commit (ainda local) | git add arquivo e git commit --amend | recria o último commit com o arquivo |
| Um commit publicado introduziu um erro | git revert hash | cria um commit novo que desfaz aquele |
| Quero desfazer commits locais e manter as mudanças | git reset --soft HEAD~2 | volta o ramo dois commits, mantém tudo no índice |
| Quero jogar fora commits locais de vez | git reset --hard HEAD~2 | volta o ramo e os arquivos; use com cuidado |
| Preciso trocar de ramo no meio de uma edição | git stash e depois git stash pop | guarda e recupera as mudanças em andamento |
| Fiz besteira e "perdi" um commit | git reflog | mostra por onde o HEAD passou, com os hashes |
A diferença entre revert e reset é a mais importante dessa tabela. O revert acrescenta um commit e não reescreve nada, então é o caminho para desfazer algo que já está no remoto. O reset move o ponteiro do ramo para trás e, por isso, só deve ser usado em commits que ainda não foram compartilhados.
O reflog é a rede de segurança. Ele registra, localmente, cada posição por onde o HEAD e os ramos passaram nos últimos meses. Um rebase que deu errado, um reset --hard precipitado ou um ramo apagado podem ser recuperados assim:
$ git reflog
3f1a2b9 HEAD@{0}: reset: moving to HEAD~2
86ce556 HEAD@{1}: commit: Calcula o frete por CEP
51d0a3b HEAD@{2}: commit: Corrige o total do carrinho

$ git switch -c resgate 86ce556   # cria um ramo no commit "perdido"
Ferramentas que poucos usam, e deveriam
Além do básico, o Git traz ferramentas de investigação que economizam horas:
- **
git bisect** encontra o commit que introduziu um erro por busca binária. Você marca um commit bom e um ruim, e o Git vai propondo commits no meio do caminho até isolar o culpado. Comgit bisect rune um script de teste, a busca é automática. Em mil commits, bastam cerca de dez passos. - **
git blame -w -C** mostra quem alterou cada linha pela última vez, ignorando mudanças de espaço em branco e seguindo linhas que foram movidas de outros arquivos. - **
git log -S "texto"** encontra os commits que adicionaram ou removeram um trecho de código. É a forma mais rápida de descobrir quando uma função apareceu ou sumiu. - **
git worktree add** cria um segundo diretório de trabalho ligado ao mesmo repositório, com outro ramo. Dá para revisar um pull request ou corrigir um problema urgente sem guardar o que você está fazendo. - **
git cherry-pick** copia um commit específico de um ramo para outro, útil para levar uma correção damainpara um ramo de versão. - Hooks são scripts que o Git executa em momentos definidos, como antes de cada commit (
pre-commit) ou antes de cada push (pre-push). Ferramentas como o Husky facilitam versioná-los junto com o projeto. - **
.gitattributes** define, por tipo de arquivo, o tratamento de fim de linha, quais arquivos são binários e como comparar formatos especiais. - Git LFS, partial clone e sparse checkout resolvem repositórios muito grandes: o primeiro tira arquivos binários pesados do histórico, os outros dois baixam só a parte do histórico ou das pastas de que você precisa.
Boas mensagens de commit
O histórico só é útil se der para lê-lo. Uma mensagem de commit boa responde a duas perguntas: o que mudou e por quê. O "como" já está no diff.
A convenção mais difundida tem uma primeira linha curta, que funciona como título, uma linha em branco e um corpo explicando o contexto:
Calcula o frete pelo CEP de destino

O valor fixo de frete deixava pedidos do interior com prejuízo. Agora o
cálculo usa a faixa de CEP do destino, com a tabela em src/frete.js.

- Faixas 78xxx-xxx com valor reduzido (entrega própria).
- Testes de unidade para as três faixas e para CEP inválido.
Algumas equipes adotam o padrão Conventional Commits, com prefixos como feat: e fix:, que permitem gerar changelogs e calcular versões automaticamente. Outras preferem títulos em linguagem natural. O formato importa menos do que a consistência e do que o corpo explicar a motivação. Daqui a um ano, ninguém vai lembrar por que aquela linha mudou, e o commit é o único lugar onde essa resposta pode estar.
Commits pequenos e coesos também fazem parte disso. Um commit que mistura uma correção, uma refatoração e uma mudança de formatação é difícil de revisar, difícil de reverter e inútil para o bisect.
Erros comuns, e como evitar
- Commitar segredos. Senhas, tokens e arquivos
.envno repositório são o erro mais caro. Mantenha esses arquivos no.gitignoredesde o primeiro commit. Se um segredo chegou a ser publicado, troque o segredo: apagar o commit não basta, porque o histórico pode já estar em outras cópias. - Versionar arquivos gerados. Pastas como
node_modules,distebuildnão pertencem ao histórico. Elas são reproduzíveis a partir do código e só incham o repositório. - Binários grandes sem LFS. Cada versão de um arquivo binário grande fica para sempre no histórico, e todo clone a baixa.
- Rebase de ramo compartilhado e force-push sem lease. Os dois reescrevem um histórico que outras pessoas têm.
- Ramos que vivem semanas. Quanto mais tempo longe da
main, maiores os conflitos e o risco da integração. - Fim de linha misturado. Equipes com Windows, macOS e Linux devem padronizar o fim de linha com
.gitattributes(por exemplo,* text=auto), para que o diff não mostre arquivos inteiros alterados sem motivo. - Commits gigantes com a mensagem "ajustes". Eles tornam o histórico inútil justamente no dia em que você mais precisa dele.
- Medo do Git. Com
reflog,reverte--abortà mão, quase nada é irreversível. Antes de uma operação arriscada, criar um ramo de segurança (git branch backup) custa um segundo.
Como usamos o Git na Gothor
Na Gothor, o Git é a base de todo o trabalho de produto, e algumas escolhas são deliberadas.
Um monorepo. Os sites, este blog, o CRM (o painel e a API), os apps da Juniper para Android e Windows, os serviços de IA e os documentos de operação vivem num único repositório. Uma mudança que atravessa várias partes, como um campo novo na API que aparece no painel e no app, entra num único commit, revisado de uma vez.
Commits que contam a história. A regra da casa é que cada commit tenha um título em português, uma linha em branco e um corpo que explica o motivo, os pontos alterados por arquivo ou fluxo, os testes executados e as limitações conhecidas. É mais trabalho na hora, e é o que permite entender meses depois por que uma decisão foi tomada.
Hooks para o que não pode ser esquecido. Um hook de pre-commit, gerenciado pelo Husky, sincroniza a versão da Juniper em todos os lugares onde ela aparece (os package.json, os pubspec.yaml dos apps e a cópia usada pelo CRM) e já inclui esses arquivos no commit. O objetivo é que a versão nunca fique diferente entre os apps.
Integração contínua por área. Cada parte do monorepo tem o seu workflow no GitHub Actions, disparado só quando os arquivos daquela parte mudam. O do CRM, por exemplo, tem dois jobs, um para o painel e outro para a API:
on:
  push:
    branches: [main]
    paths:
      - apps/crm-dashboard/**
      - apps/crm-api/**
  pull_request:
    paths:
      - apps/crm-dashboard/**
      - apps/crm-api/**

concurrency:
  group: ${{ github.workflow }}-${{ github.ref }}
  cancel-in-progress: true
O filtro de paths evita rodar os testes do app Flutter quando só a API mudou, e o concurrency cancela uma execução antiga quando chega um push mais novo no mesmo ramo. Os jobs instalam as dependências com npm ci, conferem os tipos, rodam o lint e os testes e fazem o build. Os apps Flutter rodam numa matriz, com o app do Windows num executor Windows, e um workflow de conferências verifica que a versão e a lista do Wisdom estão iguais em todos os lugares. Os selos de cada workflow ficam no README, à vista de todos.
Conteúdo também é código. Os rascunhos deste blog são arquivos Markdown no mesmo repositório, com as imagens ao lado. Cada artigo passa pelo histórico do Git antes de ir para a revisão no CRM, e os diagramas deste texto são gerados por um script versionado junto com ele.
Resumo
- O Git é distribuído: cada cópia tem o histórico completo, e quase tudo acontece localmente.
- Cada commit é uma foto completa do projeto, guardada como objetos (blob, tree, commit, tag) endereçados pelo hash do conteúdo.
- O índice é o rascunho do próximo commit;
add,commit,restoreeswitchmovem arquivos entre as três áreas. - Ramos e tags são ponteiros para commits, e o HEAD diz onde você está. Criar um ramo custa quase nada.
- O merge acrescenta um commit com dois pais e preserva a história; o rebase recria commits sobre outra base e reescreve hashes. Não faça rebase do que já foi compartilhado.
fetchbusca,pullbusca e integra,pushenvia, e--force-with-leaseé a forma segura de sobrescrever.- Com
revert,reset,stashereflog, quase todo erro tem volta. - Mensagens claras, commits pequenos e integração contínua transformam o histórico numa ferramenta de trabalho.
Para ir além
- Documentação oficial do Git, o ponto de partida para tudo.
- Pro Git, em português, o livro completo e gratuito de Scott Chacon e Ben Straub.
- Git Internals: Git Objects, o capítulo do Pro Git sobre o banco de objetos.
- Referência dos comandos, com a página de cada comando, como git rebase, git switch, git restore, git reflog e git bisect.
- gitworkflows, as recomendações do próprio projeto Git sobre fluxos com ramos.
- Documentação do GitHub Actions e pull requests no GitHub.
- Conventional Commits, a especificação de mensagens com prefixos.
Este post foi escrito com a ajuda da Juniper, a assistente de IA da Gothor, e revisado pela nossa equipe antes de ir ao ar.