Agentes de IA por dentro: como funcionam e como governá-los
Uma imersão nos agentes de IA: o laço de percepção e ação, a memória, os padrões de arquitetura, os vários agentes, a avaliação, a segurança e a governança.
Um assistente de IA responde. Um agente de IA trabalha. A diferença parece pequena até se olhar para o que cada um faz com um pedido como "descubra por que as vendas de bebidas caíram na loja 7 no último mês". O assistente escreve uma resposta com o que sabe, que é pouco. O agente consulta as vendas, compara com as outras lojas, olha as rupturas de estoque, confere as promoções do período, levanta uma hipótese, testa, descarta, levanta outra e, no fim, entrega um relatório com os números. Ninguém disse a ele quais consultas fazer, nem em que ordem.
Essa capacidade de decidir os próprios passos é o que torna os agentes úteis, e também o que os torna difíceis de controlar. Um sistema que escolhe o que fazer pode escolher errado, pode ser enganado e pode errar em sequência, com cada erro alimentando o seguinte. Por isso, falar de agentes é falar de duas coisas ao mesmo tempo: de como eles funcionam e de como governá-los.
O artigo segue essa ordem. Primeiro, o que é um agente, de onde vem a ideia e o que o diferencia de um fluxo de automação. Depois, o mecanismo: o laço agêntico, a memória, os padrões de arquitetura, os sistemas com vários agentes e os protocolos que os conectam. Em seguida, como avaliar um agente e o que se sabe sobre a capacidade deles. Por fim, os riscos, os controles e a governança, com a ISO/IEC 42001 e o AI Act europeu.
O que é um agente
A palavra "agente" é antiga na inteligência artificial, bem anterior aos modelos de linguagem, e a definição clássica ajuda a separar o essencial da moda.
A definição clássica
No livro-texto mais usado da área, Stuart Russell e Peter Norvig definem um agente como qualquer coisa que percebe o ambiente por meio de sensores e age sobre ele por meio de atuadores [1]. Um agente inteligente, nessa tradição, é o que percebe o ambiente e age de forma autônoma para atingir objetivos [1]. Um termostato, um robô aspirador e um programa de xadrez são agentes nesse sentido, cada um com sensores, atuadores e um objetivo.
Russell e Norvig classificam os agentes em cinco tipos, do mais simples ao mais sofisticado [1]:
- reflexo simples: escolhe a ação só pela entrada atual, com regras do tipo "se isto, então aquilo";
- reflexo com modelo: mantém um modelo interno do mundo, o que permite lidar com o que não consegue observar diretamente;
- orientado a objetivos: usa a informação do objetivo para escolher ações que levem ao estado desejado, com busca e planejamento;
- orientado a utilidade: dá uma nota a cada resultado possível e escolhe a ação de maior utilidade esperada;
- com aprendizado: melhora com o tempo, com um elemento de aprendizado, um crítico que dá retorno e um gerador de problemas que estimula a exploração.
O agente com modelo de linguagem
Os agentes de que se fala hoje são uma forma nova de uma ideia velha. O "cérebro" é um modelo de linguagem; os sensores são as entradas que ele recebe, como a mensagem da pessoa e o resultado das ferramentas; os atuadores são as ferramentas que ele pode chamar, como consultas a bancos, APIs e sistemas de arquivos. O objetivo vem em linguagem natural.
A Anthropic descreve o bloco básico desses sistemas como o modelo de linguagem ampliado: um modelo com acesso a busca de informação, ferramentas e memória, capaz de gerar as próprias consultas, escolher as ferramentas e decidir o que guardar [2]. Tudo o que vem depois, dos fluxos simples aos sistemas com dezenas de agentes, é montado com esse bloco.
Fluxo ou agente
A mesma Anthropic faz uma distinção que evita muita confusão. Num fluxo de trabalho, o modelo e as ferramentas são orquestrados por caminhos de código definidos de antemão; num agente, o modelo dirige dinamicamente os próprios processos e o uso das ferramentas, mantendo o controle de como a tarefa é feita [2].
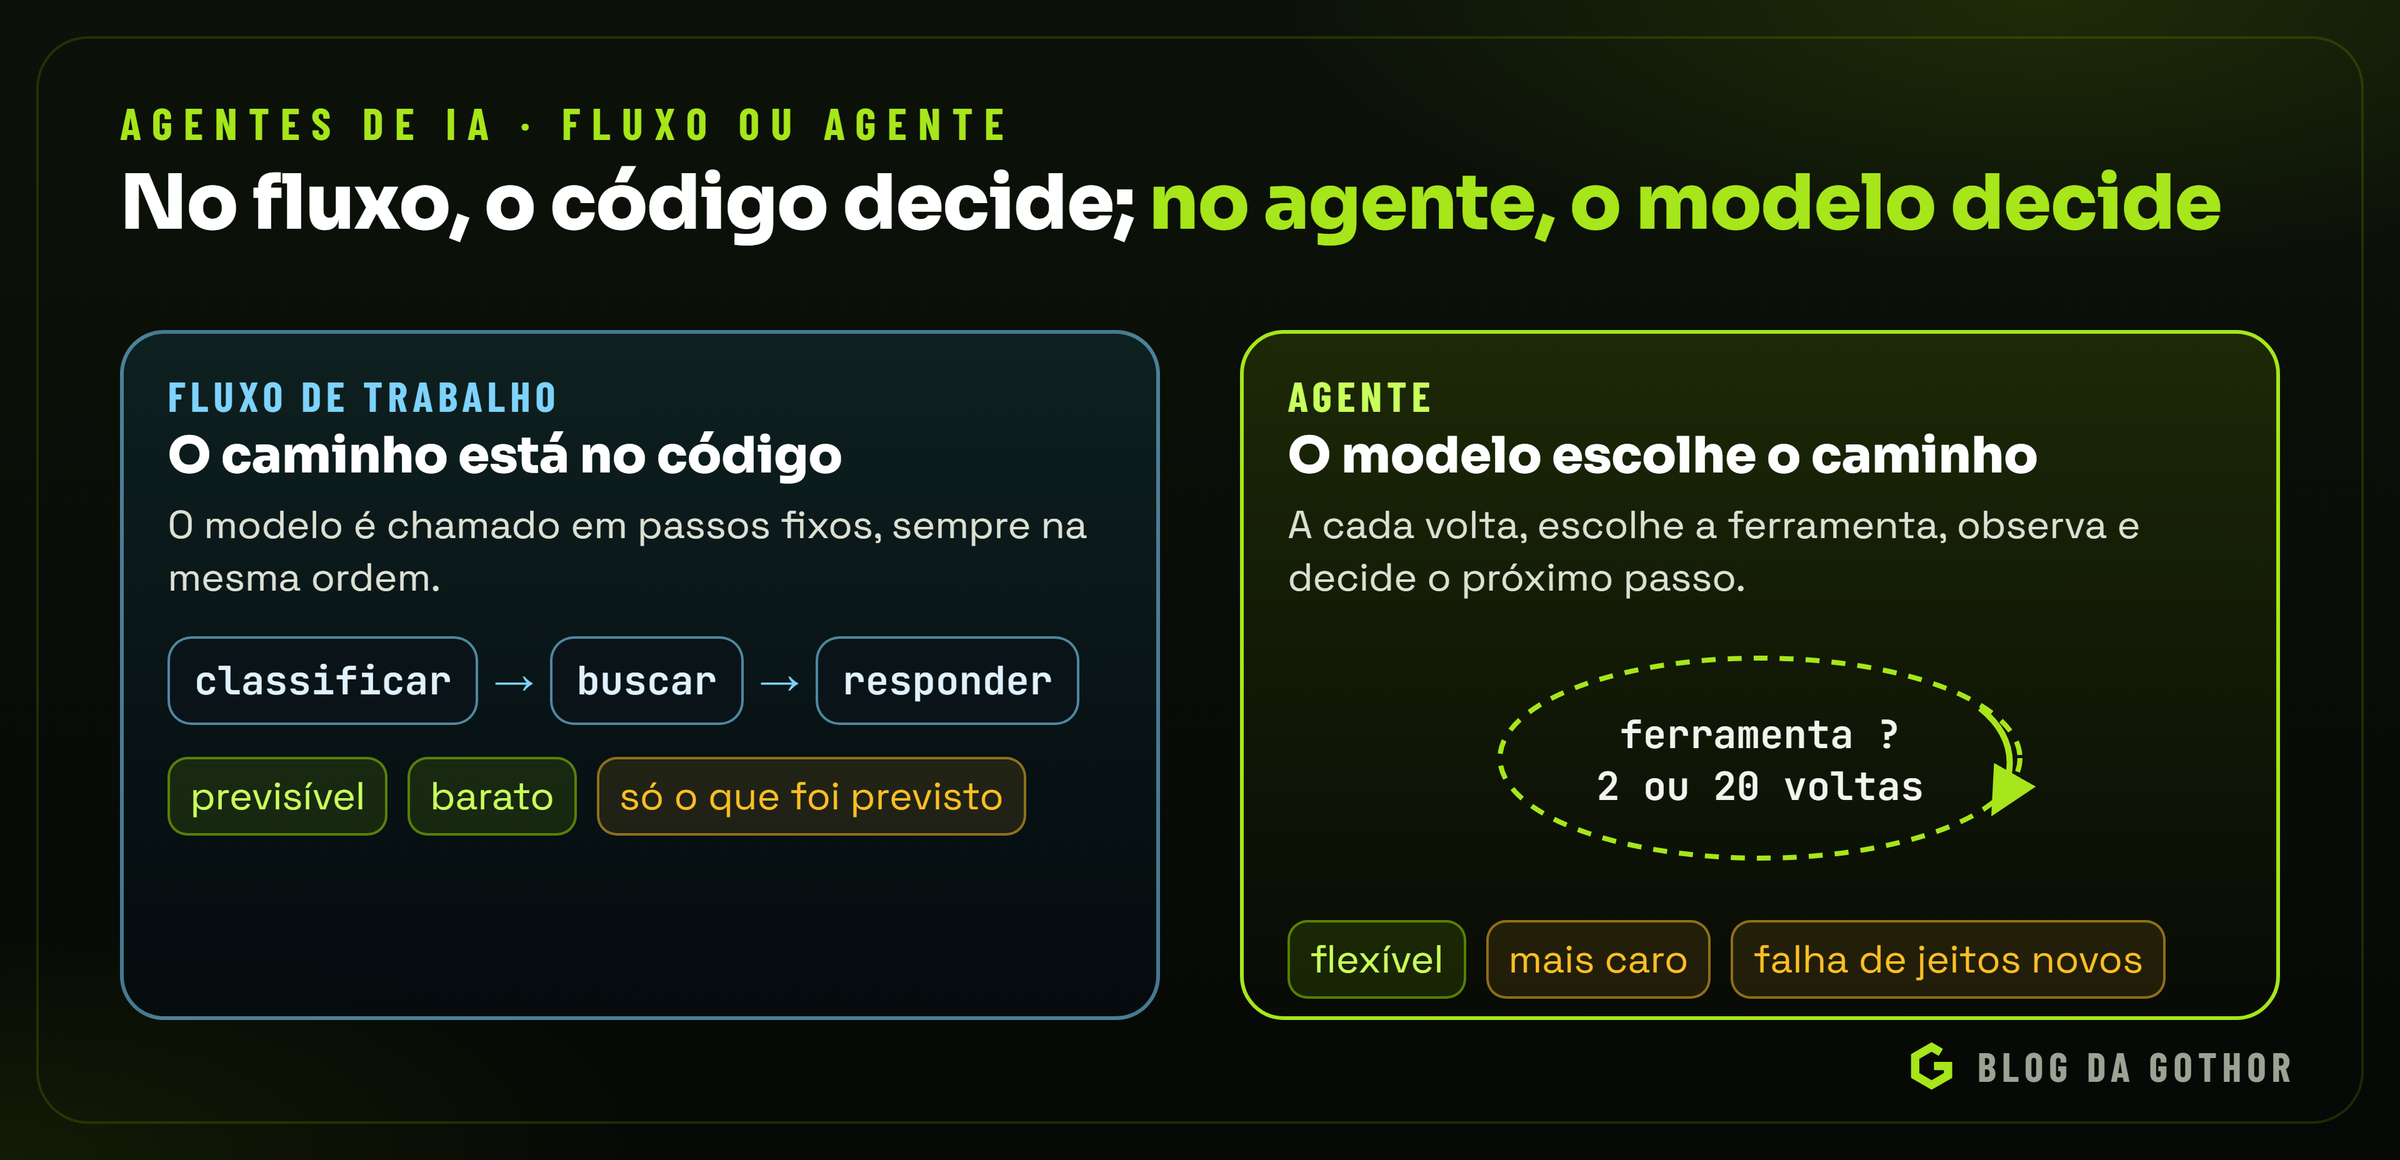
A distinção importa porque as duas coisas têm perfis de custo e risco diferentes. Um fluxo é previsível: faz sempre os mesmos passos, custa sempre parecido, falha de jeitos conhecidos. Um agente é flexível: resolve problemas que não cabem num roteiro, mas custa mais, demora mais e falha de jeitos novos. Muito do que se vende como "agente" é, na verdade, um fluxo, e não há nada de errado nisso.
De onde veio a ideia
A passagem dos modelos que só escrevem para os modelos que agem aconteceu na pesquisa entre 2022 e 2023, e três trabalhos marcam o caminho.
Pensar e agir: o ReAct
Em outubro de 2022, o ReAct propôs que o modelo gerasse, de forma intercalada, raciocínios e ações: o raciocínio ajuda a planejar, acompanhar e corrigir o plano, e as ações buscam informação em fontes externas [5]. Em tarefas de decisão interativa, como navegar numa loja virtual simulada, o método superou métodos de aprendizado por imitação e por reforço em 34 e 10 pontos percentuais de taxa de sucesso [5]. O ciclo pensar, agir e observar virou a espinha dorsal dos agentes.
Aprender com os erros: o Reflexion
Em março de 2023, o Reflexion acrescentou a reflexão: depois de uma tentativa, o agente escreve, em linguagem natural, uma análise do retorno que recebeu, e guarda esse texto numa memória que orienta as tentativas seguintes, sem mudar os pesos do modelo [6]. Na bateria de testes de programação HumanEval, o método chegou a 91% de acerto na primeira tentativa, contra 80% atribuídos pelo artigo ao GPT-4 [6]. A lição é que um agente melhora muito quando pode ver o próprio erro e tentar de novo.
Memória e convivência: os agentes gerativos
Em abril de 2023, pesquisadores de Stanford e do Google publicaram os agentes gerativos, que simulam comportamento humano verossímil [7]. A arquitetura tinha um fluxo de memória, que registra todas as experiências do agente em linguagem natural; a reflexão, que condensa essas memórias em conclusões de nível mais alto; o planejamento, que usa memórias e reflexões para decidir o comportamento; e a recuperação, que traz as memórias relevantes quando são necessárias [7]. Numa cidade simulada com 25 agentes, a partir de uma única ideia, a de que um agente queria dar uma festa de Dia dos Namorados, os agentes espalharam convites ao longo de dois dias, fizeram amizades, convidaram uns aos outros e combinaram chegar juntos na hora certa [7].
Os três trabalhos juntos dão a anatomia de um agente moderno: um laço de raciocínio e ação, a capacidade de aprender com o retorno e uma memória que vai além da conversa atual.
Como um agente planeja
Antes de agir, o agente precisa decidir o que fazer, e essa decisão é, ela própria, um problema de pesquisa.
Raciocinar em linha
A forma mais simples de planejar é raciocinar passo a passo, em linha, antes de responder: o modelo escreve o raciocínio e só depois a ação. É o que o ReAct faz a cada volta do laço, intercalando o pensamento com a ação [5]. O plano é refeito a cada observação, e isso é ao mesmo tempo a força e a fraqueza do método: o agente se adapta ao que encontra, mas pode seguir por um caminho ruim sem perceber, porque só olha um caminho de cada vez.
Raciocinar em árvore
Em maio de 2023, o Tree of Thoughts propôs generalizar o raciocínio em linha: em vez de seguir um único caminho, o modelo explora vários caminhos de raciocínio, avalia as próprias escolhas e pode olhar adiante ou voltar atrás para tomar as decisões globais [22]. No problema do Jogo do 24, em que é preciso combinar quatro números com operações aritméticas para chegar a 24, o GPT-4 com raciocínio em linha resolveu 4% dos casos, e com o Tree of Thoughts, 74% [22].
O resultado mostra uma ideia que aparece em todo agente bom: explorar alternativas e saber voltar atrás vale mais que acertar o primeiro passo. Na prática, os agentes atuais combinam as duas formas. O modelo raciocina em linha a cada volta, e o software em volta permite voltar atrás, por exemplo descartando um ramo da investigação que não deu em nada, ou rodando subagentes em paralelo, cada um explorando uma hipótese.
Mostrar o plano
Um plano escondido não pode ser corrigido. O segundo princípio da Anthropic para agentes, a transparência, pede exatamente que o agente mostre o raciocínio e os planos às pessoas [15], e a recomendação de engenharia é mostrar explicitamente os passos do planejamento [2]. Um agente que diz "vou consultar as vendas por categoria, depois as rupturas, depois as promoções" dá à pessoa a chance de dizer "não, olhe primeiro o preço do concorrente" antes que ele gaste dez minutos e muitos tokens no caminho errado.
O laço agêntico
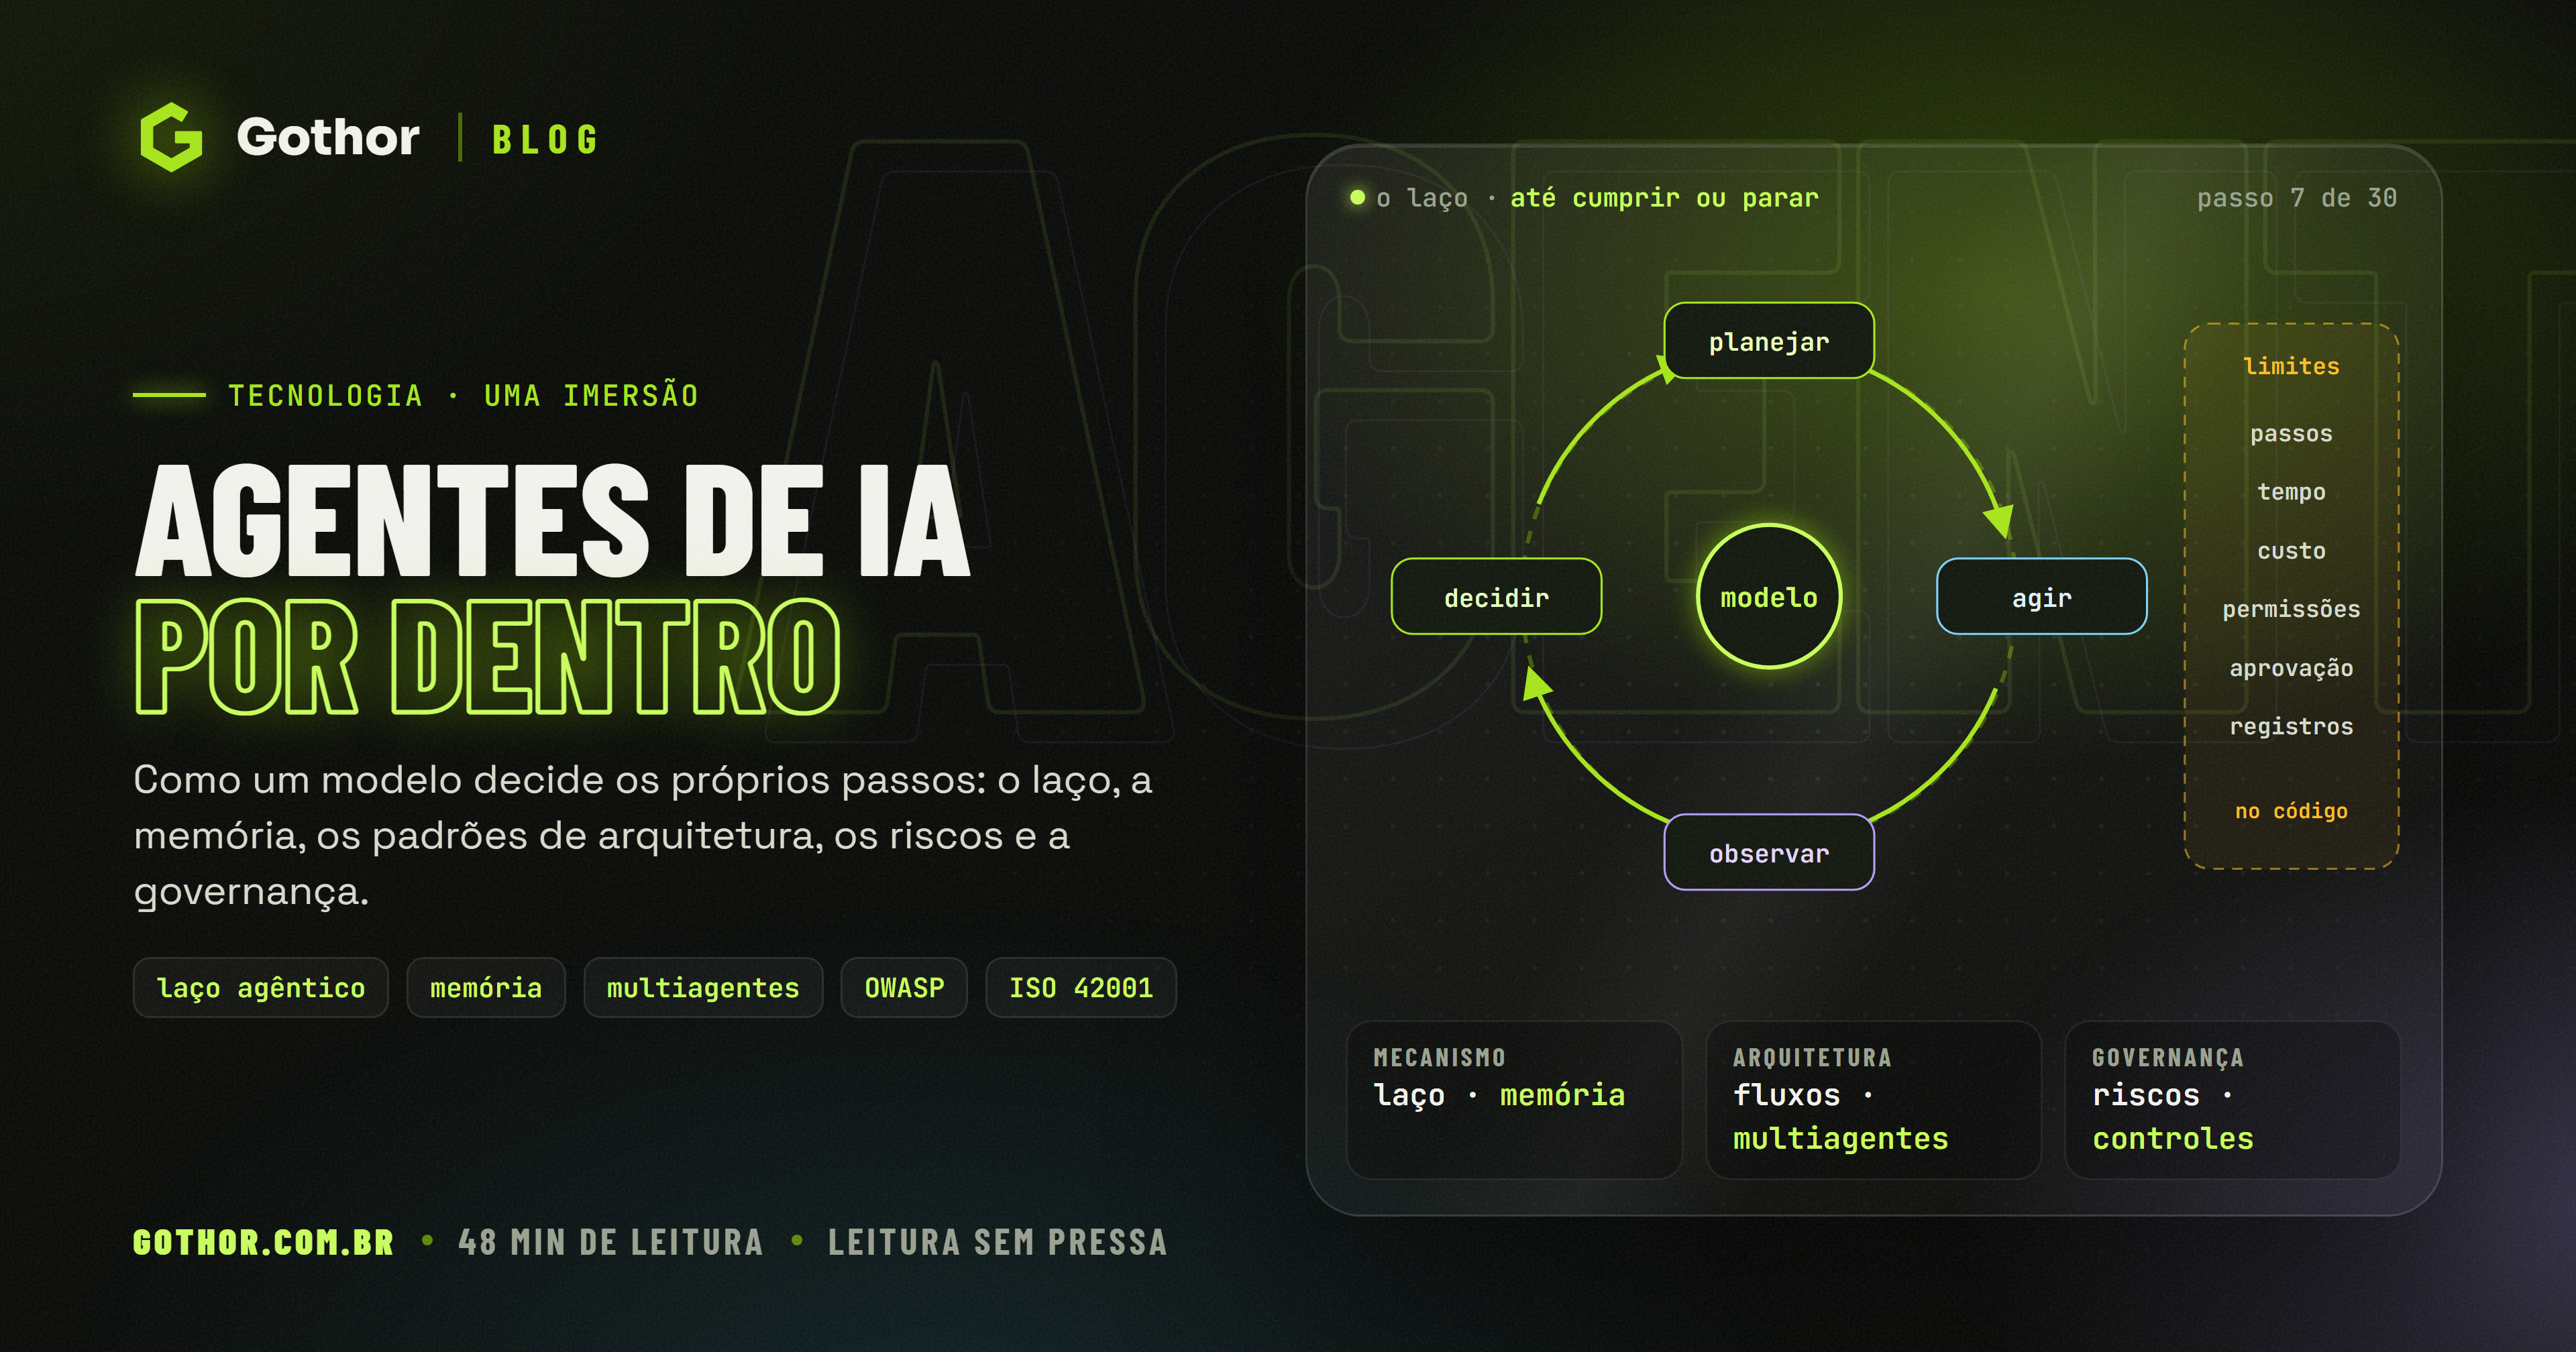
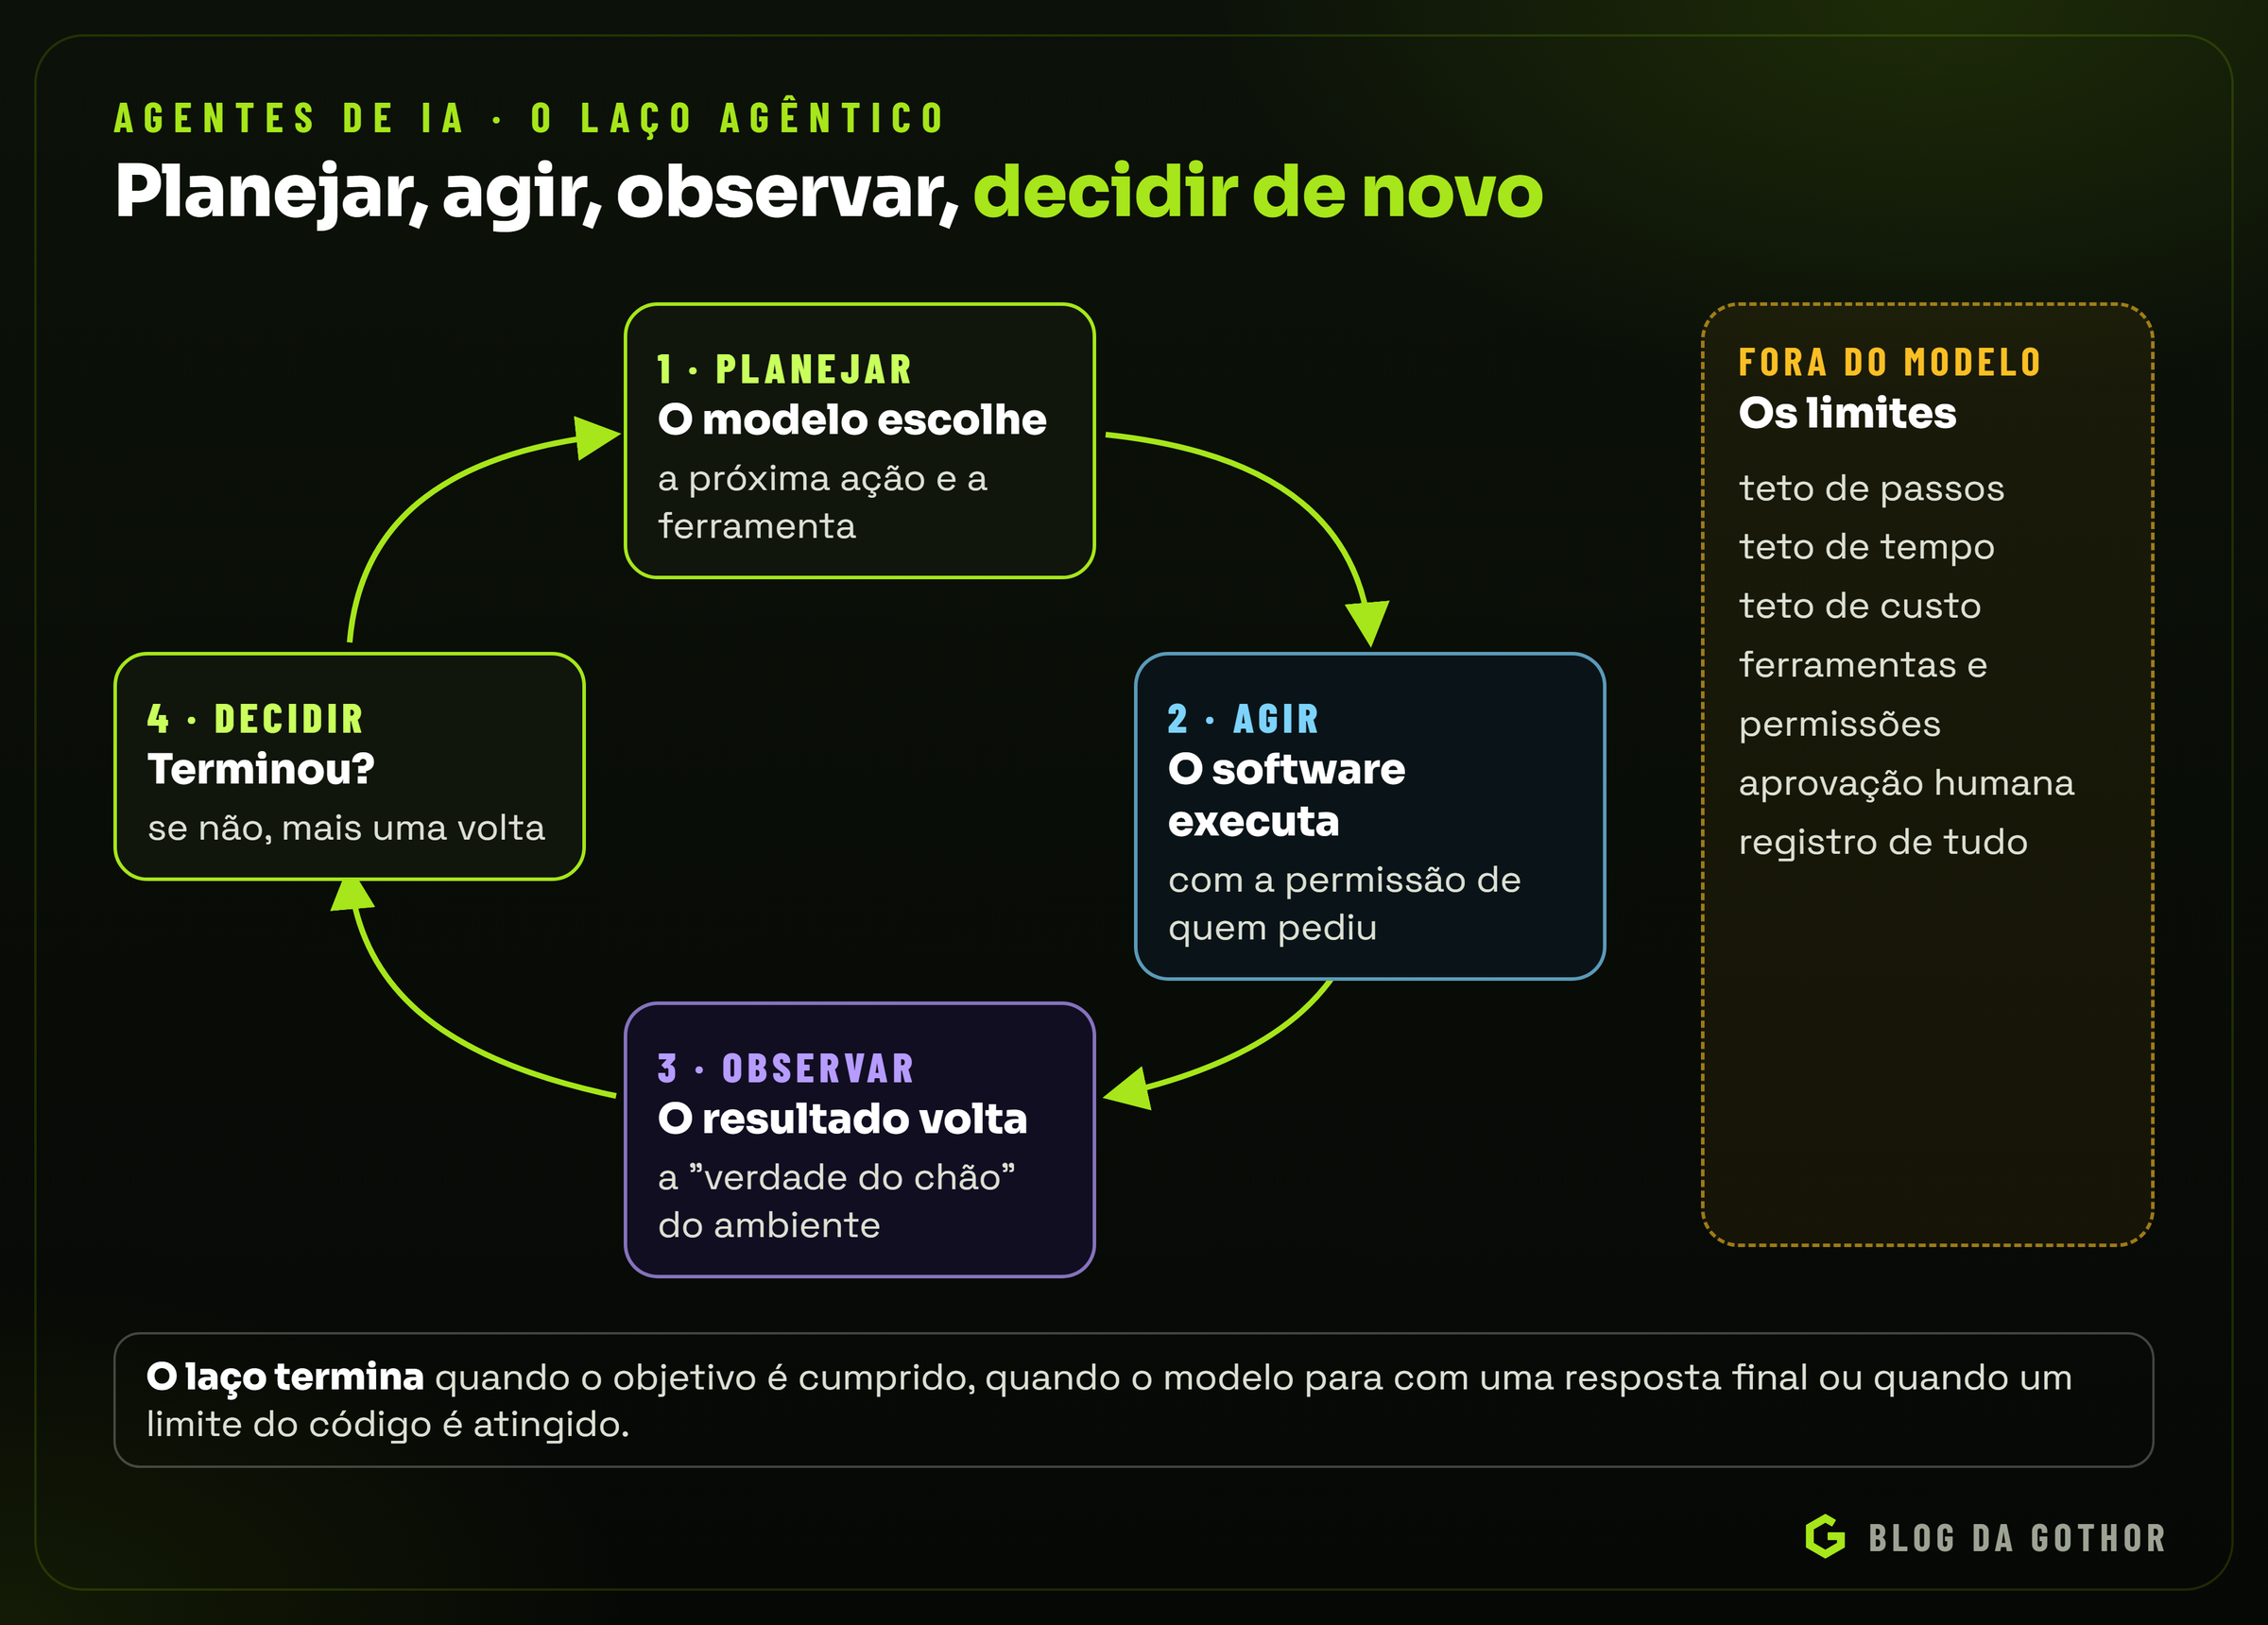
O coração de todo agente é um laço. Ele recebe um objetivo, decide uma ação, executa, observa o resultado e decide de novo, até cumprir o objetivo ou parar por algum limite.
Como o laço roda
Na prática, o laço é código comum. A documentação da Anthropic descreve a forma canônica: enviar a requisição com as ferramentas e a mensagem; receber a resposta que indica o uso de ferramentas; executar cada uma; enviar uma nova requisição com os resultados; e repetir enquanto o modelo continuar pedindo ferramentas [20]. O laço termina quando o modelo para por outro motivo, como uma resposta final, o limite de tokens ou uma recusa [20]. A mecânica de cada volta, com a descrição das ferramentas e o formato dos pedidos, é a chamada de ferramentas, tema de outro artigo deste blog.
O que transforma esse laço num agente é a liberdade: ninguém disse ao modelo quantas voltas dar, nem quais ferramentas chamar em cada uma. Ele decide com base no que observa. A Anthropic diz que os agentes ganham, a cada passo, uma "verdade do chão" vinda do ambiente, como o resultado de uma ferramenta ou de uma execução de código, para avaliar o próprio progresso [2].
Os limites ficam fora do modelo
A mesma liberdade exige limites. A recomendação da Anthropic é incluir condições de parada, como um número máximo de iterações, para manter o controle [2]. E a razão é simples: os agentes custam mais e podem acumular erros, e por isso precisam de testes extensos em ambientes isolados e de proteções adequadas [2].
Os limites que um laço de produção costuma ter são estes:
- passos: um teto de voltas no laço;
- tempo: um teto de duração total;
- custo: um teto de tokens ou de valor gasto;
- escopo: as ferramentas disponíveis e as permissões de cada uma;
- aprovação: os pontos em que o laço para e espera uma pessoa.
Nenhum desses limites deve depender do modelo "lembrar" de respeitá-los. Eles ficam no código que conduz o laço, que é o único lugar onde se pode garantir que serão cumpridos.
Quando usar um agente
A Anthropic recomenda achar a solução mais simples possível e só aumentar a complexidade quando necessário [2]. Os sistemas agênticos trocam latência e custo por desempenho, e essa troca precisa se justificar; muitas vezes, uma única chamada ao modelo, com busca de informação e exemplos no contexto, resolve [2]. Os agentes fazem sentido em problemas abertos, em que não dá para prever nem fixar o número de passos, e em ambientes confiáveis, em que vale a pena escalar [2].
A pergunta prática, então, não é "como faço um agente para isto?", e sim "isto precisa de um agente?". Responder com honestidade a essa pergunta poupa meses de trabalho: boa parte dos projetos que começam como agentes termina, depois de muita experimentação, como um fluxo bem feito, que poderia ter sido o ponto de partida. Uma triagem de chamados que sempre segue os mesmos três passos é um fluxo. Uma investigação de queda de vendas, que pode exigir dois passos ou vinte, é um agente.
A memória
Um modelo de linguagem não lembra de nada entre uma requisição e outra. Tudo o que ele "sabe" sobre a tarefa em andamento está no contexto que recebe a cada chamada. A memória de um agente é, portanto, uma construção do software em volta do modelo.
Memória de trabalho
A memória mais imediata é o próprio histórico do laço: o objetivo, as ações já tomadas e os resultados observados. Ela cresce a cada volta e tem um limite, a janela de contexto do modelo. Em tarefas longas, o histórico precisa ser resumido, podado ou guardado fora, senão o laço para por falta de espaço, ou o modelo se perde no meio de tanto texto.
Memória de longo prazo
A memória que sobrevive entre tarefas é guardada fora do modelo, em arquivos ou bancos, e trazida de volta quando relevante. O exemplo dos agentes gerativos é o mais conhecido: um fluxo de memória com todas as experiências, uma reflexão que as condensa e uma recuperação que traz as relevantes na hora certa [7]. O Reflexion mostra uma versão mais focada: guardar só as lições tiradas das tentativas anteriores [6].
A engenharia de contexto
Em setembro de 2025, a Anthropic chamou de engenharia de contexto o passo seguinte à engenharia de prompts: em vez de só escrever boas instruções, cuidar de tudo o que ocupa a janela do modelo a cada chamada, inclusive as ferramentas, os dados e o histórico de mensagens [23]. A pergunta central passa a ser qual configuração de contexto tem mais chance de produzir o comportamento desejado, e a resposta é refeita a cada chamada, e não escrita uma vez só [23].
O motivo é técnico. Os testes de "agulha no palheiro" mostram que a capacidade do modelo de lembrar com precisão o que está no contexto cai à medida que o número de tokens cresce; o contexto é um recurso finito, e cada token novo consome uma parte do que o texto chama de orçamento de atenção [23]. A queda é gradual, e não um corte brusco [23]. Um agente que acumula no contexto todos os resultados de todas as ferramentas fica, aos poucos, pior em usar qualquer um deles.
As recomendações do texto são [23]:
- as instruções do sistema na "altitude certa": nem regras rígidas demais, nem orientações vagas, com o menor conjunto de informações que define o comportamento esperado;
- as ferramentas em número mínimo, sem sobreposição entre elas, eficientes no uso de tokens e sem ambiguidade;
- os exemplos como um conjunto curto de casos variados e típicos, em vez de uma longa lista de regras para casos raros;
- o contexto sob demanda: em vez de carregar todos os dados de antemão, o agente guarda identificadores leves, como caminhos de arquivos, consultas salvas e links, e carrega o conteúdo na hora, com ferramentas.
Para as tarefas longas, que ultrapassam uma janela de contexto, o texto descreve três técnicas [23]. A compactação resume o conteúdo e recomeça uma janela nova com o resumo, tirando primeiro o que é supérfluo, como resultados antigos de ferramentas. As notas estruturadas são a memória do próprio agente: ele escreve regularmente notas fora da janela de contexto, como uma lista de tarefas ou um arquivo de anotações, e as relê depois. E as arquiteturas com subagentes dão a cada subagente uma janela limpa para uma tarefa focada; cada um devolve ao agente líder só um resumo condensado do trabalho, muitas vezes de 1.000 a 2.000 tokens [23].
O princípio que resume tudo, nas palavras do texto, é encontrar o menor conjunto de tokens de alto sinal que maximize a chance do resultado desejado, e fazer a coisa mais simples que funciona [23].
O risco da memória
A memória traz um risco próprio. A Anthropic observa que, como os agentes podem reter informação entre tarefas, eles podem levar detalhes sensíveis de um contexto para outro, como decisões confidenciais de um departamento aparecendo em outro [15]. E a memória é também uma superfície de ataque: a lista de riscos de aplicações agênticas da OWASP inclui o envenenamento da memória e do contexto, em que a memória do agente é corrompida de forma persistente e passa a moldar as ações futuras [13]. Uma instrução maliciosa que entra na memória numa terça-feira pode ser obedecida numa sexta.
Os padrões de arquitetura
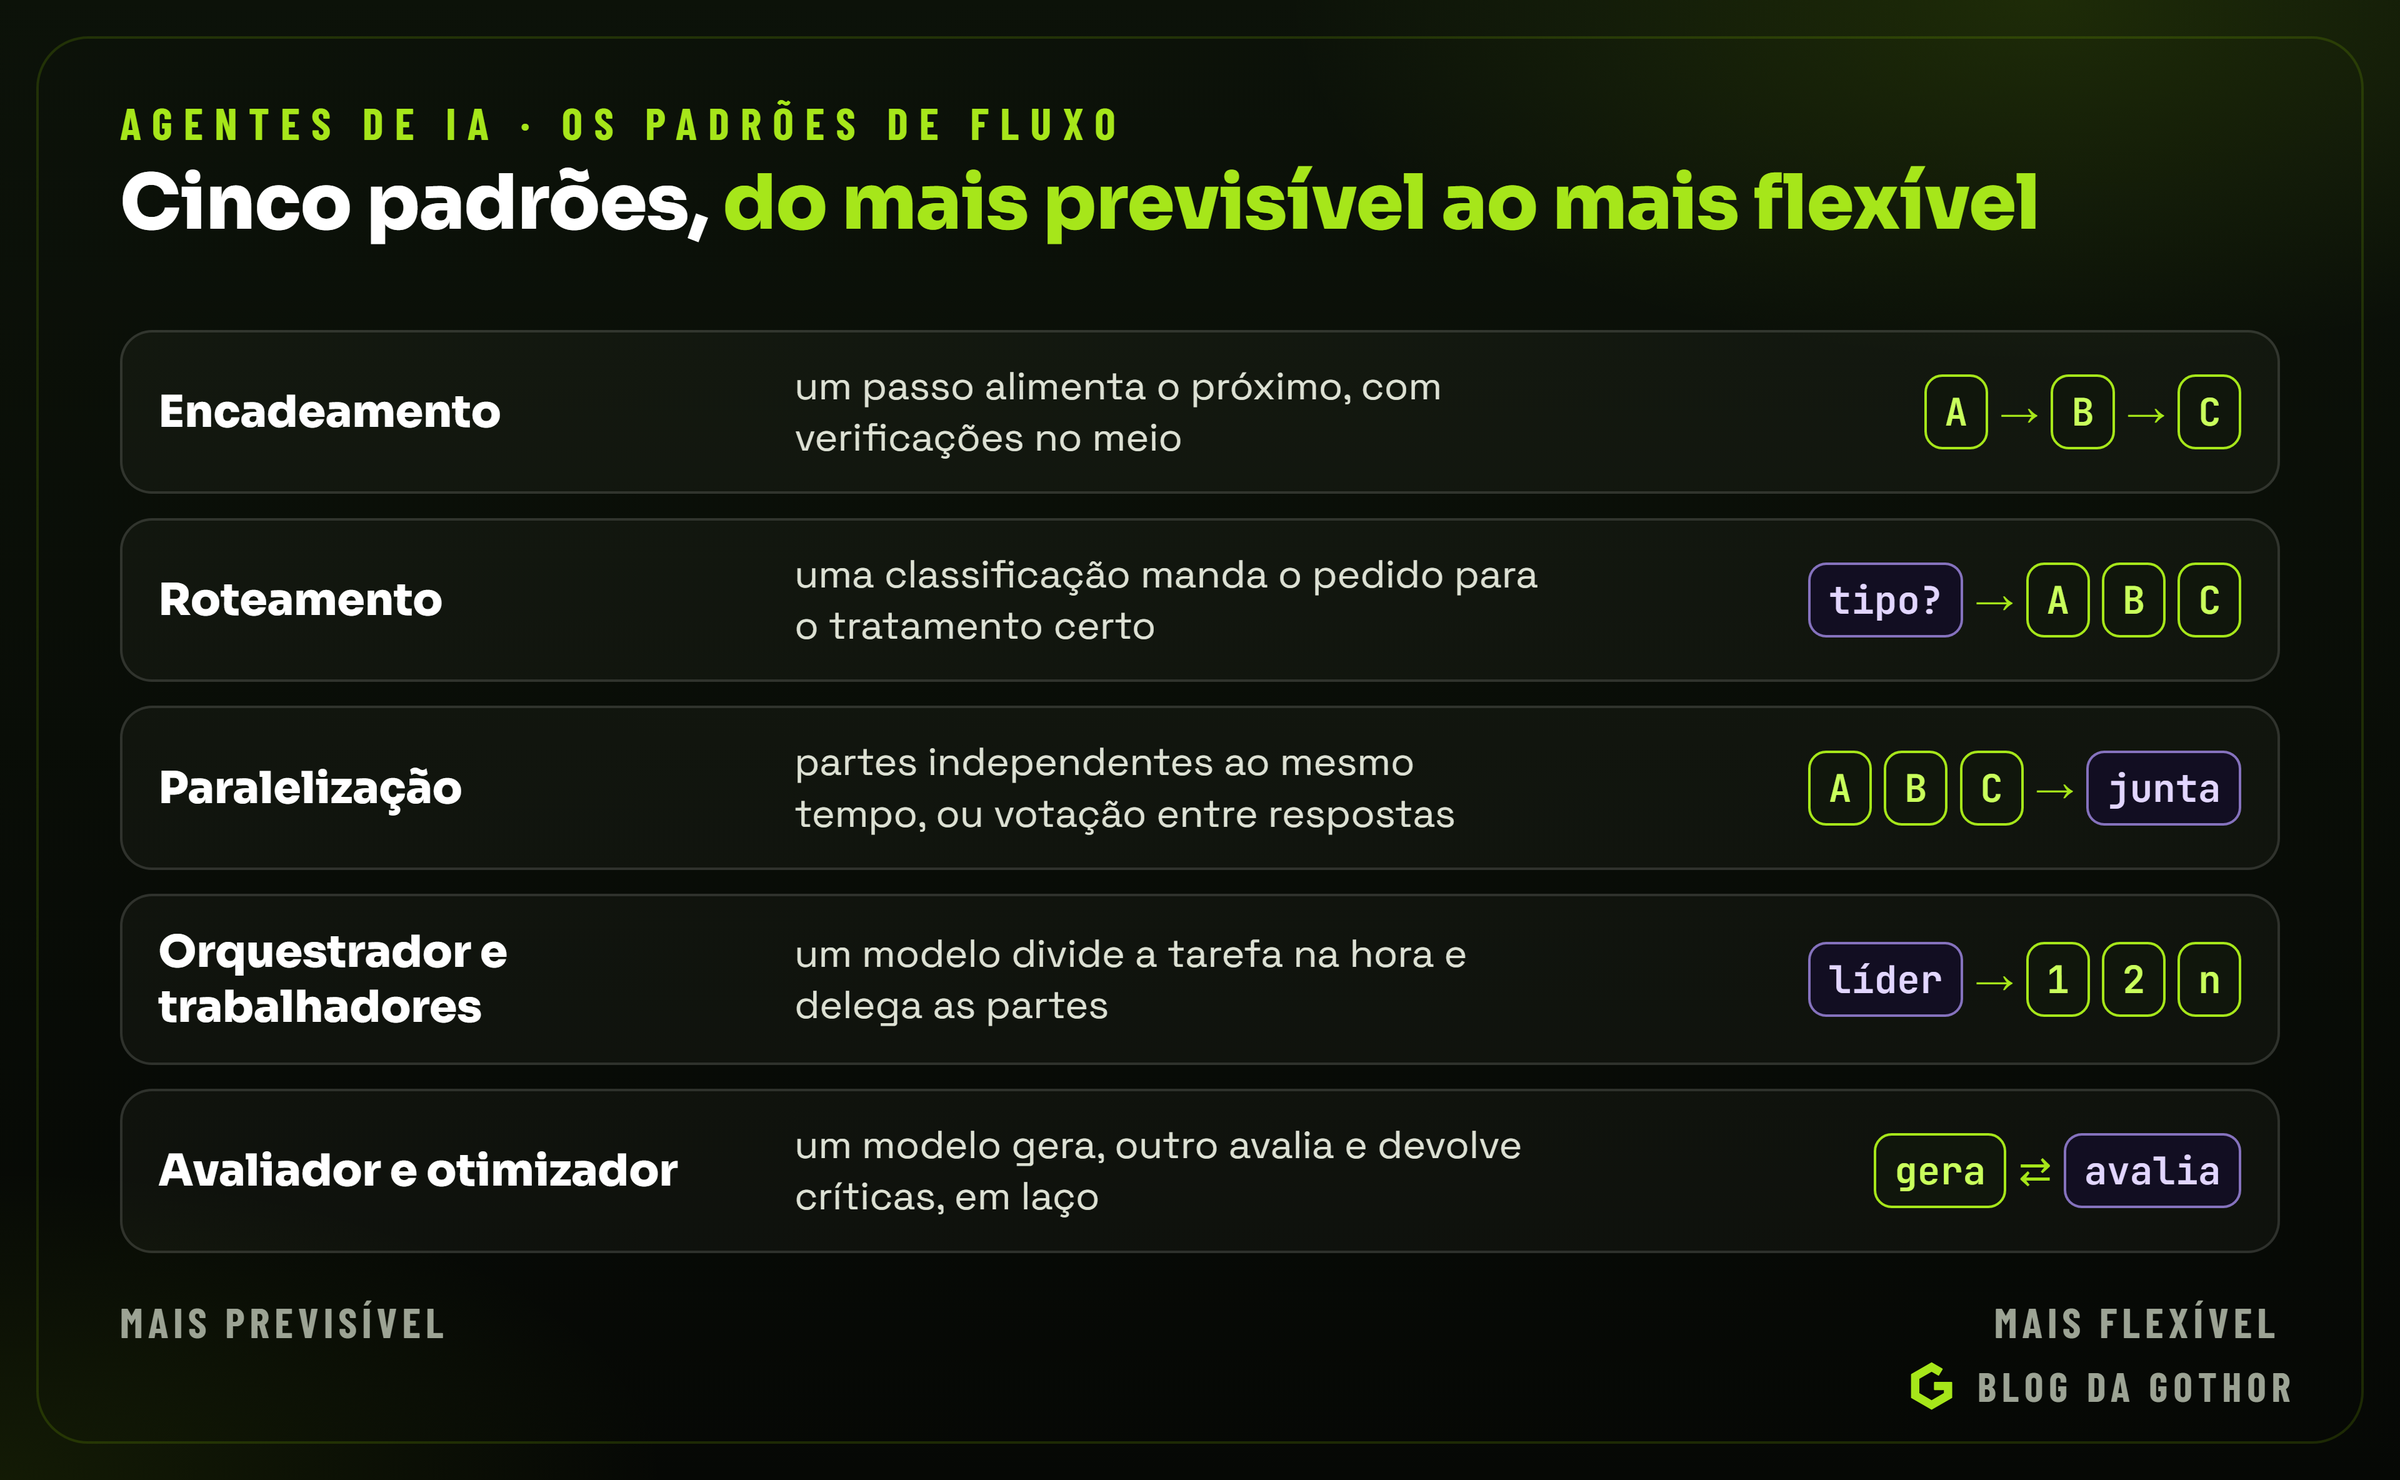
Entre a chamada única e o agente totalmente autônomo, há um espectro de padrões. A Anthropic descreve cinco fluxos de trabalho, que cobrem a maior parte dos casos reais [2].
Encadeamento
O encadeamento de prompts divide a tarefa em passos sequenciais, com verificações programáticas opcionais entre eles; serve para tarefas que se decompõem de forma limpa, trocando latência por precisão [2]. Exemplo: gerar o texto de uma campanha, conferir se cita os produtos certos e só então traduzir.
Roteamento
O roteamento classifica a entrada e a envia para um tratamento especializado; é útil quando categorias diferentes precisam de tratamento diferente, como mandar as perguntas fáceis para modelos menores [2]. Exemplo: separar os chamados de suporte em dúvida, defeito e pedido de mudança, cada um com o seu fluxo.
Paralelização
A paralelização roda chamadas simultâneas e junta os resultados, em duas variantes [2]. Na divisão, a tarefa é quebrada em partes independentes que rodam ao mesmo tempo, o que serve, por exemplo, para checar aspectos separados de uma resposta. Na votação, a mesma tarefa roda várias vezes para obter respostas diversas, o que serve para revisão de vulnerabilidades em código ou moderação de conteúdo [2].
Orquestrador e trabalhadores
No padrão orquestrador-trabalhadores, um modelo central divide a tarefa dinamicamente, delega as partes a modelos trabalhadores e junta os resultados; a diferença para a paralelização é que as subtarefas são decididas na hora, e não de antemão [2]. Serve para mudanças de código em vários arquivos e para buscas em várias fontes [2].
Avaliador e otimizador
No padrão avaliador-otimizador, um modelo gera a resposta e outro a avalia e devolve críticas, em laço; funciona em tarefas com critérios de avaliação claros, em que a melhoria iterativa compensa, como traduções literárias [2].
Os três princípios
A Anthropic fecha com três princípios para quem constrói agentes [2]: manter a simplicidade do desenho; dar transparência, mostrando explicitamente os passos do planejamento do agente; e cuidar da interface entre o agente e o computador, com documentação e testes cuidadosos das ferramentas. Sobre o terceiro, o texto registra que, no agente de programação que a empresa construiu para uma bateria de testes de engenharia de software, o trabalho com as ferramentas levou mais tempo que o do prompt [2].
Sobre os frameworks de agentes, a recomendação é cautelosa: eles facilitam o começo, mas costumam criar camadas de abstração que escondem os prompts e as respostas por baixo, o que dificulta a depuração; a sugestão é começar usando as APIs dos modelos diretamente e reduzir a abstração ao ir para produção [2].
Vários agentes
O padrão orquestrador-trabalhadores, levado ao extremo, vira um sistema com vários agentes, cada um com o próprio laço, as próprias ferramentas e o próprio contexto.
Um caso documentado
Em junho de 2025, a Anthropic publicou como construiu o sistema de pesquisa do Claude, com vários agentes [3]. A arquitetura é a de orquestrador e trabalhadores: um agente líder planeja a pesquisa, cria subagentes que buscam em paralelo e compila a resposta final, e um agente separado atribui cada afirmação à sua fonte [3].
Os números do relato ajudam a entender a troca. Na avaliação interna de pesquisa da empresa, o sistema com vários agentes superou o de agente único em 90,2%, com os maiores ganhos nas perguntas que exigem explorar muitas direções ao mesmo tempo [3]. O custo é proporcional: os agentes usam cerca de quatro vezes mais tokens que uma conversa, e os sistemas com vários agentes, cerca de quinze vezes mais [3]. Numa bateria pública de pesquisa na web, só o volume de tokens explicou 80% da variação de desempenho [3].
Quando compensa
O relato é claro sobre onde o modelo funciona [3]: em tarefas de alto valor, muito paralelizáveis, com mais informação do que cabe numa janela de contexto e com muitas ferramentas complexas. E sobre onde não funciona: em domínios que exigem contexto compartilhado entre todos os agentes ou muitas dependências entre eles; a maior parte das tarefas de programação, por exemplo, tem menos partes paralelizáveis que a pesquisa, e os agentes ainda não são bons em coordenação em tempo real [3]. O custo alto também exige tarefas valiosas o bastante para justificá-lo [3].
As lições de engenharia
As lições do relato valem para qualquer sistema com vários agentes [3]:
- ensinar o orquestrador a delegar: cada subagente precisa de um objetivo, de um formato de saída, de orientação sobre ferramentas e fontes e de limites claros; instruções vagas geraram trabalho duplicado;
- dimensionar o esforço pela complexidade: perguntas simples usaram um agente com 3 a 10 chamadas de ferramentas; comparações diretas, de 2 a 4 subagentes com 10 a 15 chamadas cada; pesquisas complexas, mais de 10 subagentes;
- começar a avaliação pequeno: a equipe começou com cerca de 20 perguntas representativas, porque as primeiras mudanças costumam ter efeitos grandes;
- usar um modelo como juiz, e pessoas também: uma avaliação por modelo, com nota de 0 a 1 e aprovado ou reprovado, foi a mais consistente, mas a revisão humana pegou casos que a automação perdeu, como o viés na escolha das fontes;
- tratar a falha como regra: os agentes guardam estado, e pequenas falhas descarrilam execuções longas; a equipe construiu formas de retomar do ponto da falha, em vez de recomeçar, combinando a adaptabilidade do modelo com proteções determinísticas, como novas tentativas e pontos de restauração;
- atualizar sem interromper: como os agentes podem estar no meio de uma tarefa durante uma atualização, o tráfego é passado aos poucos da versão antiga para a nova, com as duas rodando ao mesmo tempo.
Os protocolos que conectam agentes
Um agente precisa de ferramentas, e, cada vez mais, de outros agentes. Dois protocolos abertos padronizam essas conexões.
MCP: do agente para as ferramentas
O Model Context Protocol padroniza como aplicações de IA se conectam a fontes de dados e ferramentas, com mensagens JSON-RPC 2.0 entre hosts, clientes e servidores [10]. Em dezembro de 2025, ele passou a fazer parte da Agentic AI Foundation, criada sob a Linux Foundation com três projetos fundadores: o MCP, da Anthropic; o goose, um agente de código aberto da Block; e o AGENTS.md, da OpenAI, um formato para dar instruções a agentes de programação dentro dos repositórios [11]. O anúncio registrava mais de 10.000 servidores MCP publicados [11].
A2A: de agente para agente
O protocolo Agent2Agent, o A2A, é um padrão aberto para a comunicação e a colaboração entre agentes de IA, pensado para que agentes construídos em frameworks diferentes, por fornecedores diferentes, consigam trabalhar juntos [9]. Ele foi desenvolvido pelo Google e doado à Linux Foundation, e é mantido por um comitê técnico com representantes de empresas como AWS, Cisco, Google, IBM Research, Microsoft, Salesforce, SAP e ServiceNow [9].
Um ponto do desenho é que os agentes são opacos uns para os outros: colaboram sem compartilhar a memória interna, as ferramentas ou a lógica proprietária [9]. A documentação resume a relação com o MCP: os dois são complementares; o MCP é para a comunicação do agente com as ferramentas, e o A2A, para a comunicação entre agentes, que se descobrem, delegam tarefas e compartilham resultados [9].
O que os protocolos não resolvem
Protocolos padronizam a conversa, e não a confiança. Um agente que recebe uma tarefa de outro agente, por A2A, recebe conteúdo vindo de fora, com todos os riscos da injeção de instruções. A lista da OWASP para aplicações agênticas inclui, entre os dez riscos, a comunicação insegura entre agentes, com fraquezas nos protocolos, na descoberta e na validação do que é trocado, e os riscos da cadeia de suprimentos, com ferramentas, servidores MCP, cartões de agentes e registros maliciosos [13].
Agentes de longa duração
Algumas tarefas levam horas ou dias, e nenhuma janela de contexto dá conta delas. Em novembro de 2025, a Anthropic relatou como resolveu esse problema para um agente de programação encarregado de construir uma aplicação web inteira [24].
O problema
O ponto de partida é que cada sessão nova do agente começa sem nenhuma memória do que veio antes [24]. A compactação sozinha não bastou: mesmo um modelo de ponta, em laço por várias janelas de contexto, não chegou a construir uma aplicação com qualidade de produção a partir de uma instrução de alto nível [24]. O relato identifica dois modos de falha [24]. No primeiro, o agente tentava fazer tudo de uma vez, ficava sem contexto no meio da implementação e deixava uma funcionalidade pela metade, sem documentação. No segundo, as sessões seguintes viam o progresso já feito e declaravam o trabalho concluído antes da hora.
A solução
A resposta foi uma estrutura em duas partes [24]. Um agente inicializador, na primeira sessão, prepara o ambiente: um arquivo com a lista de funcionalidades, um arquivo de notas de progresso, um script de inicialização e um primeiro registro no controle de versão. A lista de funcionalidades foi expandida, a partir da instrução inicial, para mais de 200 itens, todos marcados como não concluídos [24]. Depois, um agente de programação, em cada sessão, trabalha numa funcionalidade de cada vez, começa lendo o histórico do controle de versão e as notas de progresso e termina registrando as mudanças e atualizando as notas, deixando o código num estado limpo, que um desenvolvedor pudesse retomar sem arrumar a bagunça de outra pessoa [24].
Dois detalhes mostram como as escolhas pequenas importam. A lista de funcionalidades ficou em JSON, e não em Markdown, porque o modelo tem menos tendência a sobrescrever indevidamente um arquivo JSON [24]. E o agente costumava marcar funcionalidades como prontas só depois de testes unitários; pedir a ele que testasse pelo navegador, como um usuário faria, melhorou muito os resultados e revelou defeitos que não apareciam no código [24].
A lição
A lição vale fora da programação. Um agente de longa duração precisa de três coisas que um bom profissional também usa: uma lista do que falta fazer, anotações do que já foi feito e do que se aprendeu, e o hábito de deixar o trabalho num estado em que outro possa continuar. A diferença é que o "outro", no caso, é o próprio agente, na sessão seguinte, sem lembrar de nada.
Agentes que usam o computador e escrevem código
Dois tipos de agente ajudam a ver a evolução da área, porque têm medições públicas desde o começo.
O uso do computador
Em 22 de outubro de 2024, a Anthropic lançou, em versão pública de testes, o uso do computador: a capacidade de o modelo operar um computador como as pessoas fazem, olhando a tela, movendo o cursor, clicando e digitando [25]. A própria empresa descreveu o recurso como experimental, às vezes trabalhoso e sujeito a erros [25]. Na bateria OSWorld, que mede como os modelos usam computadores, o resultado foi de 14,9% na categoria só com capturas de tela, contra 7,8% do segundo melhor sistema, e de 22,0% com mais passos disponíveis [25]. O anúncio registrava também os riscos novos, como spam, desinformação e fraude, e recomendava começar por tarefas de baixo risco [25].
O uso do computador é o agente na forma mais geral possível: as ferramentas deixam de ser funções bem definidas e passam a ser a tela inteira. É também a forma mais arriscada, porque tudo o que aparece na tela, inclusive uma página maliciosa, vira entrada para o agente.
Os agentes de programação
O SWE-bench, publicado em outubro de 2023 e apresentado na conferência ICLR de 2024, reúne 2.294 problemas de engenharia de software tirados de issues reais do GitHub e das correções correspondentes, em 12 repositórios populares de Python [26]. A tarefa é dura e realista: receber o código e a descrição do problema e alterar o código para resolvê-lo [26]. No lançamento, o melhor modelo resolvia só 1,96% dos problemas [26].
A distância entre esse número e o que os agentes de programação fazem hoje é o melhor retrato da evolução da área, e é coerente com a tendência do horizonte de tempo medida pela METR, que encontrou uma duplicação ainda mais rápida, de menos de três meses, numa versão verificada do SWE-bench [4]. Mas o mesmo cuidado de antes vale: acertar uma bateria de testes não é o mesmo que trabalhar sem supervisão num repositório real, com as regras, as dependências e as pessoas de uma empresa.
Até onde os agentes chegam
Afirmações sobre o que os agentes "já conseguem fazer" costumam vir sem medida. Algumas medições públicas ajudam a calibrar.
O horizonte de tempo
Em março de 2025, a organização de pesquisa METR propôs medir a capacidade dos agentes pelo horizonte de tempo de 50%: o tamanho das tarefas, medido pelo tempo que profissionais humanos levam para fazê-las, que os agentes completam sozinhos com 50% de sucesso [4]. O resultado principal foi que esse horizonte vinha dobrando aproximadamente a cada sete meses nos seis anos anteriores [4]. Na época da publicação, o melhor modelo medido tinha um horizonte de cerca de uma hora; os modelos acertavam quase sempre as tarefas de menos de quatro minutos e menos de 10% das de mais de quatro horas [4].
Os próprios autores listam as ressalvas [4]: as tarefas são de software e de raciocínio; as estimativas dependem das tarefas escolhidas e das pessoas usadas como referência; e as tendências ficam mais ruidosas em subconjuntos, como o das tarefas consideradas "bagunçadas". A página registra ainda que a METR não atualiza mais essa série com modelos novos [4]. Mesmo assim, a medida é útil por trocar uma pergunta vaga, "o agente é bom?", por uma concreta: "que tamanho de tarefa ele consegue fazer sozinho, com que taxa de sucesso?".
A confiabilidade
A segunda medida importante é a consistência. O τ-bench, publicado em junho de 2024, avalia agentes em conversas com um usuário simulado, com ferramentas de API de um domínio, como o varejo, e regras de política a seguir; o acerto é conferido comparando o estado final do banco de dados com o estado esperado [8]. A bateria introduziu a métrica pass^k, que mede se o agente acerta a mesma tarefa em k tentativas seguidas [8]. Os resultados da época foram duros: mesmo os agentes de ponta acertavam menos de 50% das tarefas, e, no varejo, a taxa de acertar a mesma tarefa em oito tentativas ficava abaixo de 25% [8].
A diferença entre acertar uma vez e acertar sempre é o que separa uma demonstração de um produto. Um agente que resolve um estorno corretamente em sete de cada dez vezes não é 70% útil; é uma fonte de problemas em três de cada dez clientes.
Avaliar um agente
As medições públicas comparam modelos. Para saber se um agente funciona numa empresa, é preciso avaliá-lo com as tarefas dela.
Começar com poucas tarefas reais
A lição da Anthropic é começar pequeno: cerca de 20 perguntas representativas bastaram no início, porque as primeiras mudanças têm efeitos grandes [3]. O que importa é que as tarefas sejam reais, com o resultado esperado definido de antemão. No texto sobre como escrever ferramentas para agentes, a recomendação é a mesma: avaliações realistas, com tarefas de vários passos, análise das transcrições e um conjunto de testes separado, que não entra nos ajustes [19].
O que medir
Para cada tarefa, vale medir mais que o acerto final:
- o resultado: a tarefa foi cumprida, conforme o estado final esperado, como no τ-bench [8];
- a consistência: acerta em várias tentativas seguidas, e não só uma vez [8];
- o caminho: escolheu as ferramentas certas, sem passos desnecessários;
- o custo: quantos tokens, chamadas e segundos gastou [3];
- a segurança: respeitou as permissões, pediu confirmação quando devia, não vazou dado de um contexto para outro.
Modelos como juízes
Avaliar à mão centenas de execuções não escala, e o uso de um modelo como juiz virou prática comum. No relato da Anthropic, um único prompt de avaliação, com nota de 0 a 1 e um veredito de aprovado ou reprovado, foi o mais consistente e o mais alinhado ao julgamento humano [3]. Mas o mesmo relato mostra o limite: a revisão humana pegou problemas que o juiz automático não viu [3]. O juiz é uma ferramenta de triagem, e não um substituto para olhar as transcrições.
O custo de um agente
Agentes custam mais que conversas, e o custo cresce de formas que nem sempre aparecem nos testes.
Tokens
O número mais citado vem do relato da Anthropic: os agentes usam cerca de quatro vezes mais tokens que uma conversa, e os sistemas com vários agentes, cerca de quinze vezes mais [3]. A razão é estrutural. A cada volta do laço, o modelo recebe de novo as instruções, as descrições das ferramentas e o histórico acumulado; uma investigação de vinte passos manda o contexto inicial vinte vezes, cada vez maior.
Esforço proporcional
A resposta não é cortar o agente, e sim dimensionar o esforço. O mesmo relato mostra a regra que a equipe ensinou ao orquestrador: uma pergunta simples, de busca de um fato, usa um agente com 3 a 10 chamadas de ferramentas; uma comparação direta usa de 2 a 4 subagentes; e só a pesquisa complexa usa mais de 10 [3]. Um agente que trata toda pergunta como uma investigação complexa gasta dez vezes mais do que precisa nas perguntas simples, que costumam ser a maioria.
Latência
O custo também é de tempo. A Anthropic lembra que os sistemas agênticos trocam latência e custo por desempenho [2], e cada volta do laço é pelo menos uma ida e volta ao modelo e outra à ferramenta. Para tarefas que a pessoa acompanha em tempo real, como um atendimento, um agente de vinte passos pode ser lento demais, e um fluxo de três passos, com a resposta em segundos, serve melhor, mesmo sendo menos esperto.
Fazer a conta antes
Antes de colocar um agente em produção, vale estimar o custo por tarefa com a própria bateria de avaliação: quantos tokens, quantas chamadas e quantos segundos cada caso real consumiu, em média e no pior caso. Multiplicado pelo volume esperado, esse número costuma decidir mais projetos do que a qualidade das respostas. Um agente que acerta 95% dos casos a um custo maior que o do trabalho que substitui não é um bom negócio, por melhor que seja tecnicamente.
Pessoas e agentes: a confiança calibrada
O último risco da lista da OWASP para agentes não é técnico: é a exploração da confiança humana, em que a tendência a atribuir qualidades humanas e autoridade ao agente é usada para enfraquecer a supervisão [13]. Ele aponta para um problema que aparece mesmo sem atacante nenhum.
O excesso de confiança
Um agente que acerta nove vezes seguidas ganha a confiança de quem o acompanha, e a décima resposta é aprovada sem ser lida. A aprovação humana, nesse ponto, deixa de ser um controle e vira um carimbo. Quanto mais o agente parece competente, mais fácil é deixar de conferir o que ele faz.
A aprovação que funciona
Os princípios da Anthropic ajudam a evitar isso [15]. A transparência, com o plano visível e o raciocínio explicado, dá à pessoa algo concreto para avaliar, em vez de um simples "aprovar". A aprovação reservada às ações de alto impacto, como no exemplo do agente que pede licença antes de cancelar assinaturas, evita que a pessoa seja chamada a aprovar tudo e acabe não lendo nada [15]. E as permissões permanentes para tarefas de rotina, que o Claude Code permite conceder, deixam a atenção humana para o que de fato merece [15].
Medir a confiança
Uma confiança calibrada é a que acompanha o desempenho real. Por isso a avaliação contínua não é só uma ferramenta de engenharia: é também o que diz às pessoas quanto confiar. Se a bateria de testes mostra que o agente acerta os casos simples e erra os de um certo tipo, a supervisão se concentra nesses. Sem a medida, a confiança vira impressão, e a impressão costuma ser boa demais.
Os riscos
Os riscos dos agentes são os dos modelos de linguagem multiplicados pela autonomia: um erro de raciocínio vira uma ação errada, e uma instrução maliciosa vira uma ação maliciosa.
A lista da OWASP para agentes
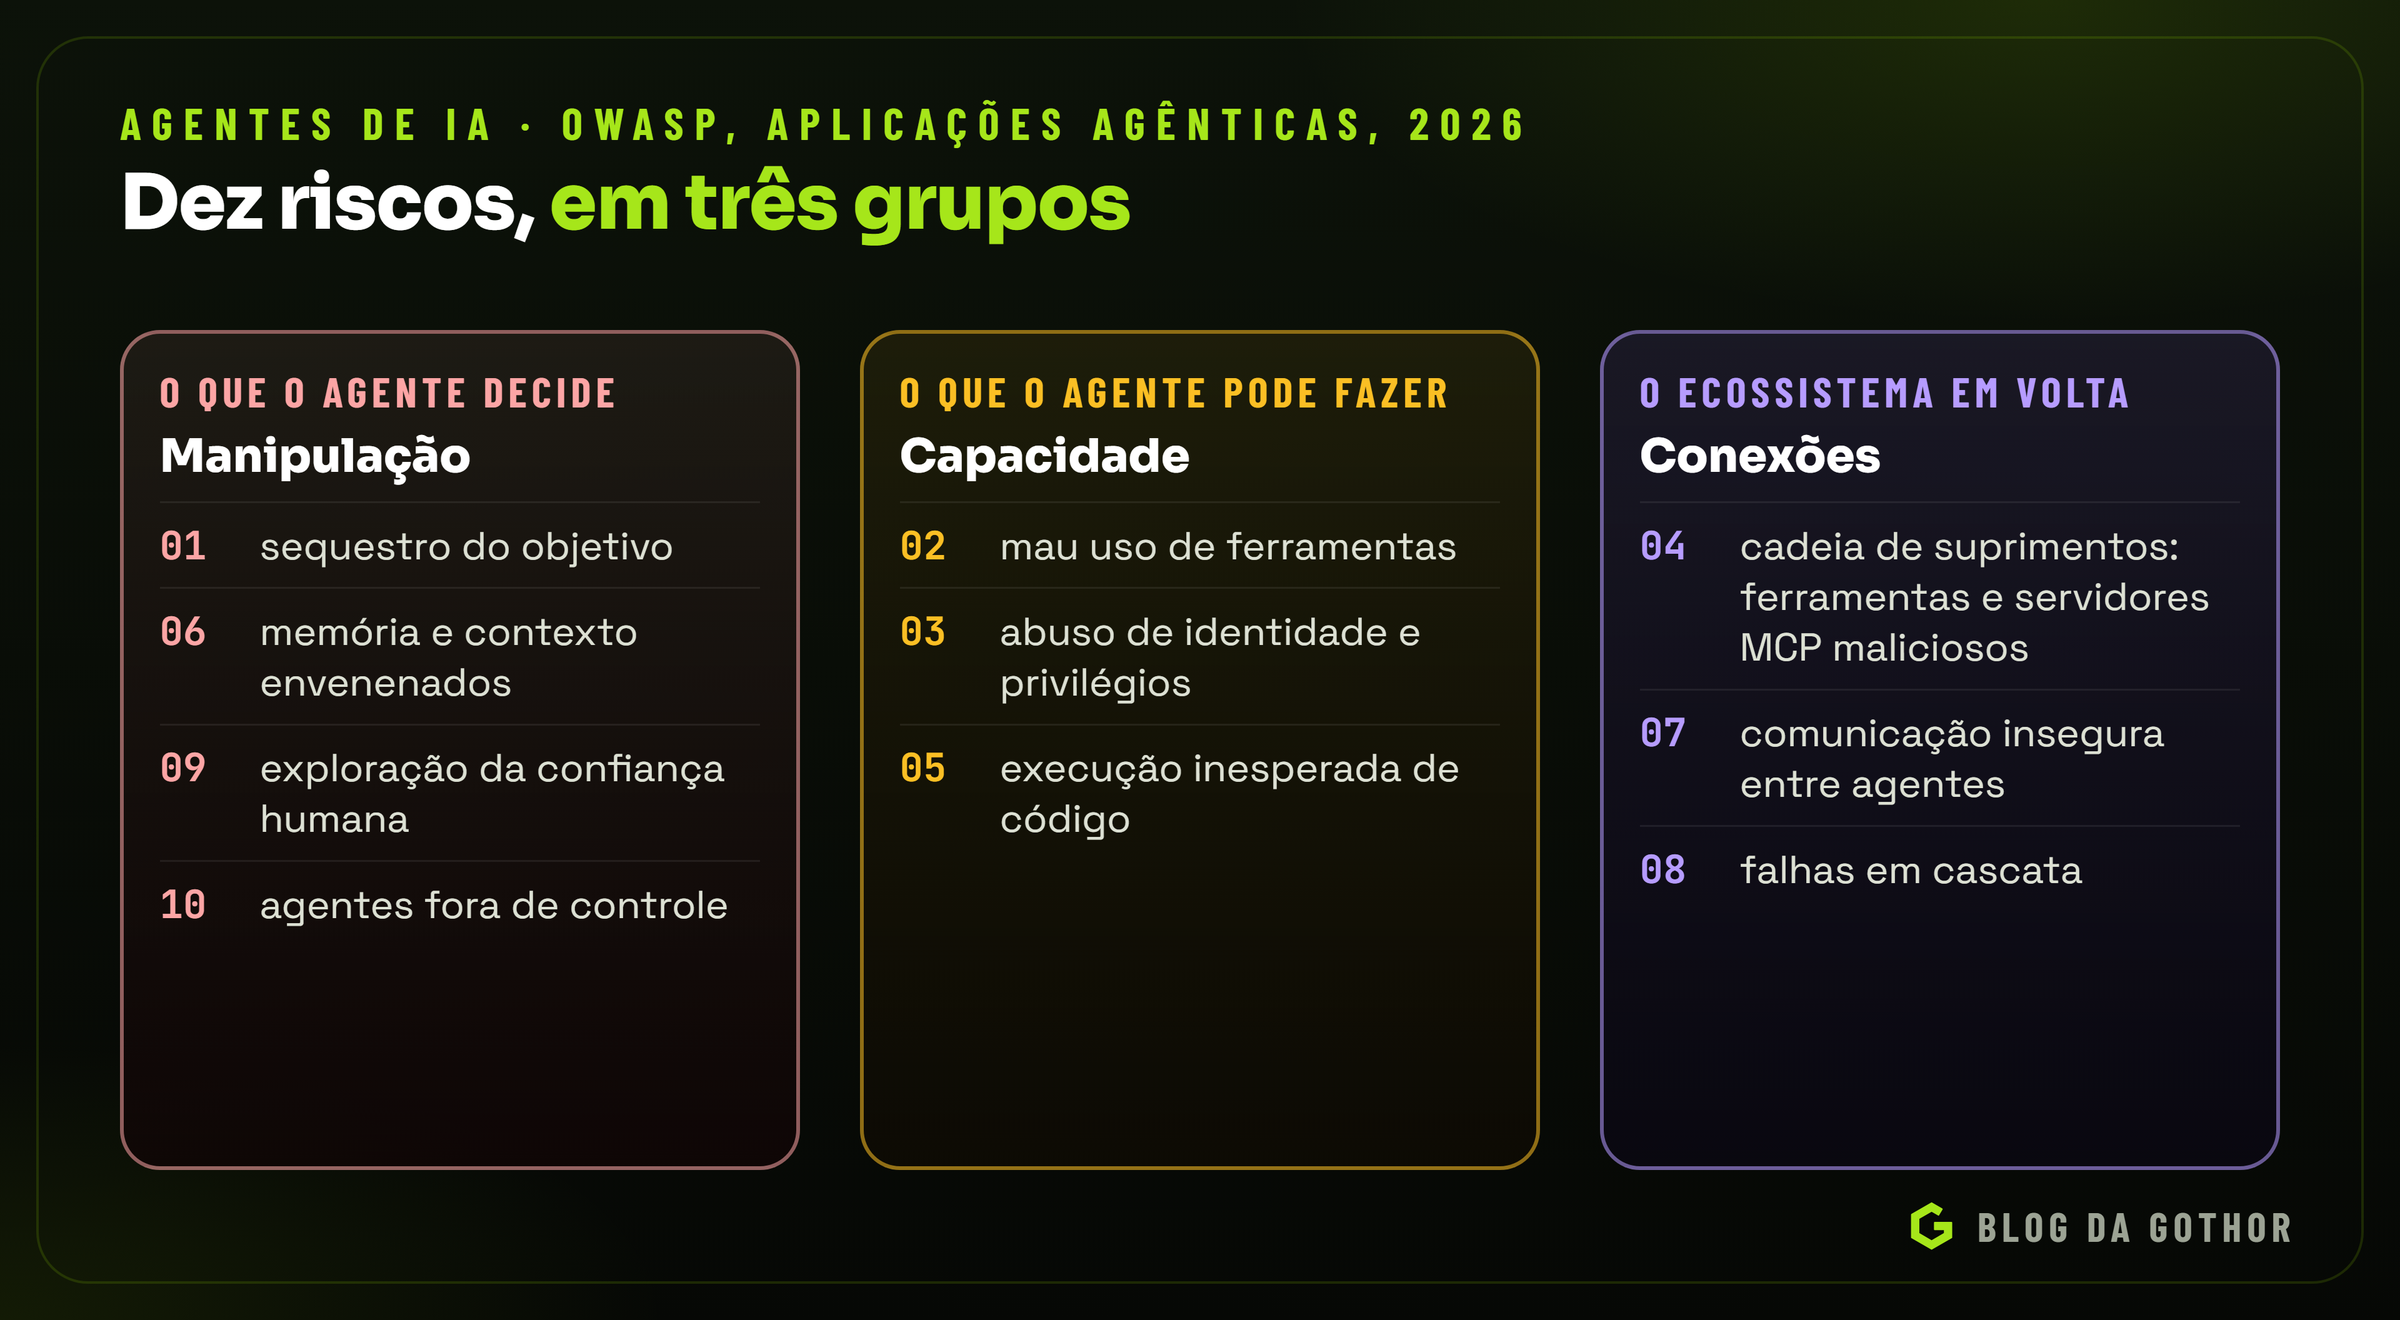
Em 9 de dezembro de 2025, o projeto de segurança de IA generativa da OWASP publicou uma lista específica para aplicações agênticas, revisada por especialistas de vários países [12]. Os dez riscos são [13]:
- sequestro do objetivo do agente: o atacante manipula os objetivos do agente por injeção de instruções ou entradas envenenadas;
- mau uso de ferramentas: ferramentas legítimas são usadas de forma abusiva, dentro dos privilégios que o agente recebeu;
- abuso de identidade e privilégios: o agente herda ou delega credenciais sem o escopo adequado, o que confunde a atribuição de quem fez o quê;
- cadeia de suprimentos: ferramentas, servidores MCP, cartões de agentes e registros maliciosos;
- execução inesperada de código: caminhos de código gerados pelo agente contornam os controles tradicionais;
- envenenamento da memória e do contexto: a memória e o contexto compartilhado são corrompidos de forma persistente;
- comunicação insegura entre agentes: fraquezas nos protocolos, na descoberta e na validação do que os agentes trocam;
- falhas em cascata: uma falha se propaga entre agentes e fluxos;
- exploração da confiança humana: a tendência a atribuir qualidades humanas e autoridade ao agente é usada para enfraquecer a supervisão;
- agentes fora de controle: agentes que se desviam do comportamento esperado, se combinam ou se replicam.
A agência excessiva
A lista para aplicações com modelos de linguagem, da mesma OWASP, tem um item que resume a raiz de vários desses riscos: a agência excessiva, a vulnerabilidade que permite ações danosas em resposta a saídas inesperadas, ambíguas ou manipuladas do modelo [14]. Ela tem três causas [14]: funcionalidade excessiva, quando as ferramentas fazem mais do que precisam; permissões excessivas, quando o acesso aos sistemas é mais amplo que o necessário; e autonomia excessiva, quando ações de alto impacto rodam sem verificação.
A tríade letal
Um agente fica especialmente perigoso quando junta três capacidades, que o desenvolvedor Simon Willison chamou de tríade letal: o acesso a dados privados, a exposição a conteúdo não confiável e a capacidade de se comunicar com o exterior [18]. Com as três, um atacante pode plantar instruções num conteúdo que o agente lê e levá-lo a enviar os dados para fora [18]. Willison lembra que ainda não se sabe impedir isso com 100% de confiabilidade, e que produtos que dizem barrar 95% dos ataques estão, em segurança, tirando nota de reprovação [18]. A defesa principal é de desenho: não juntar as três capacidades no mesmo agente [18].
Falhas em cascata
O risco menos discutido, e talvez o mais comum, não é o ataque: é o erro que se acumula. A Anthropic observa que os agentes têm custo maior e potencial de erros que se acumulam [2], e o relato do sistema de pesquisa diz que, como os agentes guardam estado, pequenas falhas podem descarrilar execuções longas [3]. Um agente que interpreta mal o primeiro resultado constrói os passos seguintes sobre o erro, e cada passo parece razoável visto de perto. Por isso as verificações intermediárias, os pontos de restauração e os limites do laço são tão importantes quanto as defesas contra ataques.
Os controles
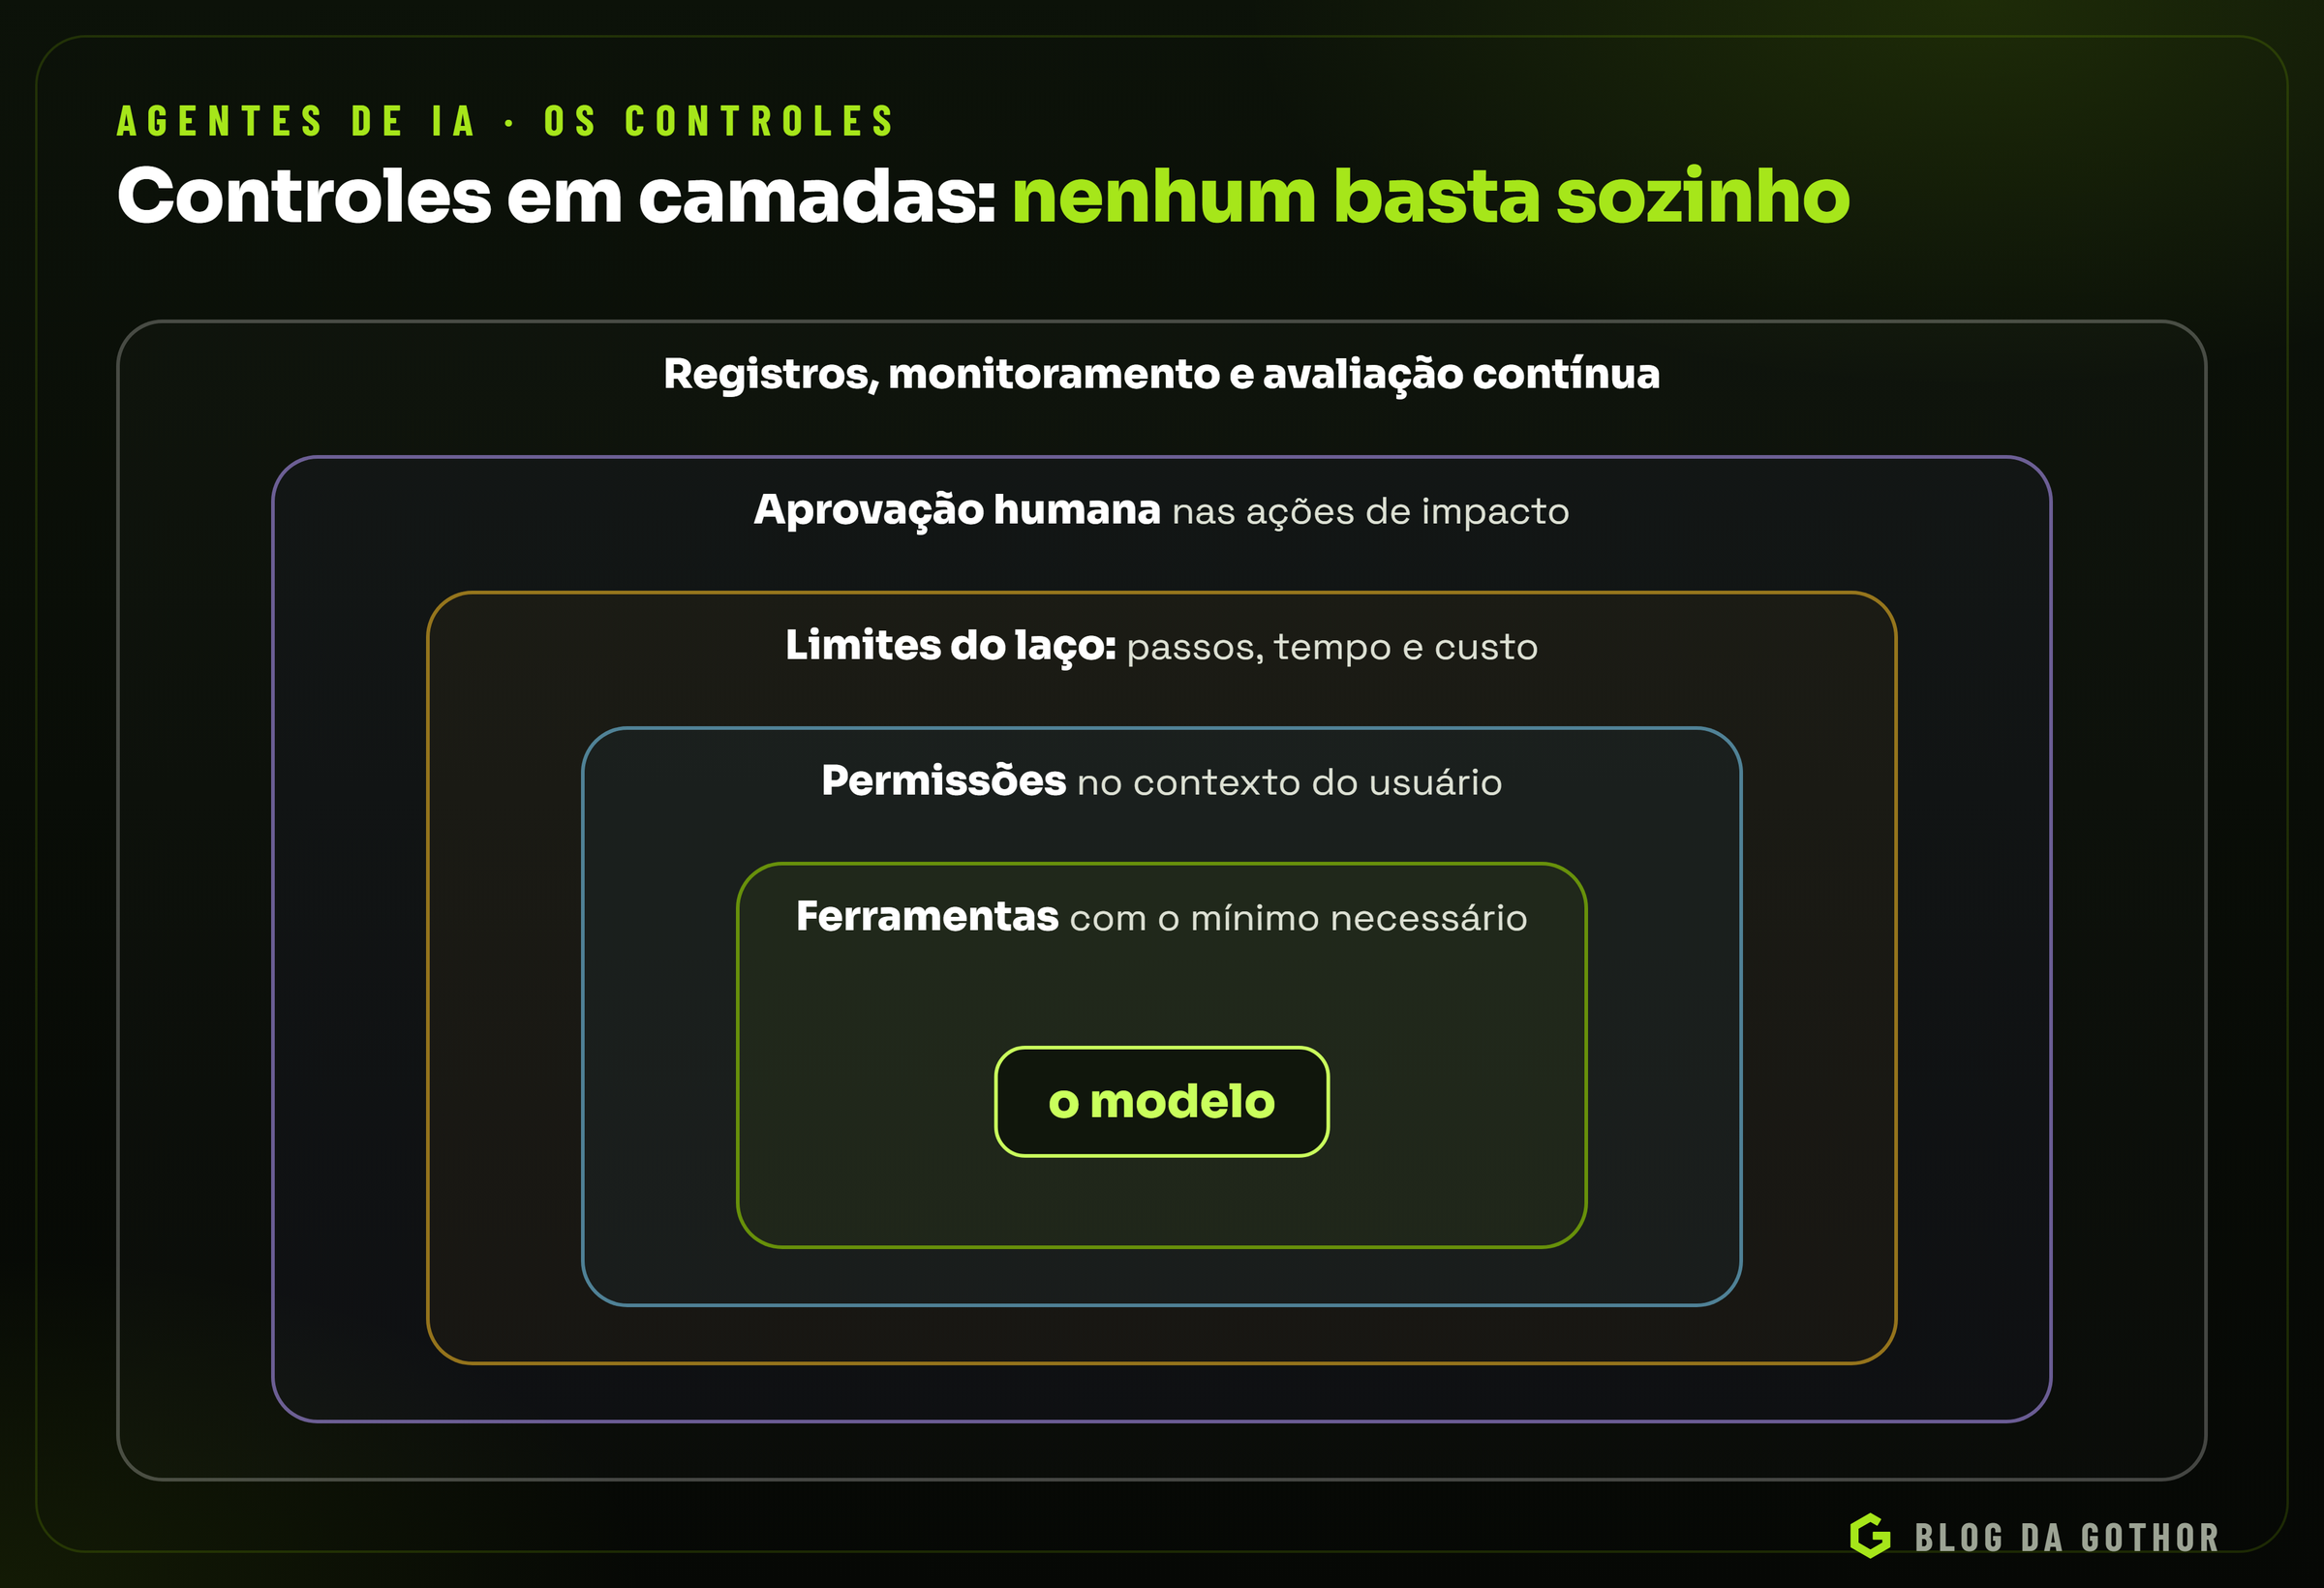
Os riscos têm respostas conhecidas. Nenhuma é perfeita sozinha; juntas, reduzem bastante o problema.
Pessoas no controle
O primeiro princípio do quadro de agentes seguros da Anthropic, publicado em agosto de 2025, é manter as pessoas no controle sem impedir a autonomia: os agentes precisam trabalhar sozinhos, mas as pessoas devem supervisionar como os objetivos são perseguidos, principalmente antes de decisões de alto impacto [15]. O exemplo do texto é um agente de gestão de despesas, que deveria pedir aprovação antes de cancelar assinaturas de software [15]. Outro exemplo é o próprio Claude Code: por padrão, ele só lê; pode examinar arquivos sem pedir, mas precisa de aprovação antes de alterar código ou sistemas, e a pessoa pode conceder permissões permanentes para tarefas de rotina [15].
Transparência
O segundo princípio é a transparência: as pessoas precisam ver o raciocínio e os planos do agente [15]. O exemplo é um agente que, pedido para reduzir a perda de clientes, explica que os clientes de áreas barulhentas do escritório cancelam mais e propõe mudar as mesas de lugar; no Claude Code, a transparência aparece numa lista de tarefas em tempo real, que a pessoa pode revisar e ajustar [15]. O texto admite que acertar o nível de detalhe é difícil e exige iteração [15].
Alinhamento com o que a pessoa quis
O terceiro princípio é alinhar o agente com os valores e as expectativas humanas: um agente pode tomar ações que lhe parecem razoáveis, mas que a pessoa não queria [15]. O exemplo é o pedido "organize meus arquivos", que pode levar o agente a apagar o que ele considera duplicado e reestruturar as pastas [15]. Como ainda é difícil medir o alinhamento de forma confiável, a transparência e o controle importam enquanto isso [15].
Privacidade e segurança
Os dois últimos princípios tratam da privacidade ao longo de interações longas, para que informação de um contexto não vaze para outro, e da segurança das interações do agente, contra a injeção de instruções e a exploração das ferramentas e subagentes [15]. No MCP, por exemplo, as pessoas podem permitir ou bloquear conectores específicos, conceder acesso único ou permanente, e os administradores de empresas podem controlar quais conectores os usuários podem ligar [15].
Testar em ambiente isolado
Antes de qualquer agente tocar sistemas reais, ele passa por um ambiente isolado. A recomendação da Anthropic é explícita: os agentes, pelo custo maior e pelo risco de erros acumulados, pedem testes extensos em ambientes isolados, com as proteções adequadas [2]. Na prática, isso significa uma cópia dos sistemas com dados fictícios ou mascarados, ferramentas que gravam numa base de testes e registros completos de cada execução. É ali que se descobre que o agente apaga o que não devia, repete uma ação três vezes ou interpreta uma instrução de um jeito que ninguém previu, sem que nenhum cliente perceba.
O ambiente isolado também serve depois da implantação. Cada mudança nas ferramentas, nas instruções ou no modelo passa primeiro por ele, com a bateria de avaliação, antes de chegar à produção.
O menor privilégio, de novo
As mitigações da OWASP para a agência excessiva fecham o quadro [14]: oferecer só as ferramentas necessárias; reduzir a funcionalidade de cada uma; evitar ferramentas abertas, como uma que executa qualquer comando; reduzir as permissões nos sistemas de destino; executar as ações no contexto do usuário, com o menor privilégio; pedir aprovação para as operações de alto impacto; e conferir a autorização nos sistemas de destino, e não no modelo. A OWASP observa que registros, monitoramento e limites de requisições não impedem a agência excessiva, mas limitam o dano quando ela acontece [14].
A governança
Os controles técnicos protegem cada agente. A governança organiza como uma empresa decide quais agentes criar, quem responde por eles, como os riscos são avaliados e como se presta contas. Três referências se destacam.
O NIST AI RMF
Nos Estados Unidos, o NIST publicou, em 26 de janeiro de 2023, o AI Risk Management Framework, um quadro de uso voluntário para gerir os riscos de IA, organizado nas funções de governar, mapear, medir e gerir [16]. Em 26 de julho de 2024, saiu o perfil para IA generativa, o NIST-AI-600-1, que ajuda a identificar os riscos próprios dessa tecnologia e sugere ações de gestão [16]. O framework está em revisão, e, em abril de 2026, o NIST publicou a nota conceitual de um perfil para IA confiável em infraestrutura crítica [16]. O artigo sobre o Claude, neste blog, trata do AI RMF em mais detalhe.
A ISO/IEC 42001
A ISO/IEC 42001, de 2023, é uma norma internacional que especifica os requisitos para estabelecer, implementar, manter e melhorar continuamente um sistema de gestão de IA numa organização [17]. Um sistema de gestão, nesse sentido, é o conjunto de políticas, objetivos e processos que a organização define para o desenvolvimento, o fornecimento ou o uso responsável de sistemas de IA [17]. A norma é pensada para quem fornece ou usa produtos e serviços baseados em IA, e dá uma forma estruturada de gerir os riscos e as oportunidades, equilibrando inovação e governança [17].
A diferença para o NIST é de natureza. O AI RMF é um quadro de referência voluntário; a ISO/IEC 42001 é uma norma de sistema de gestão, na mesma família de normas como a de segurança da informação, e pode ser certificada por auditoria independente. A Microsoft, por exemplo, mantém a certificação para vários dos seus produtos de IA e lembra aos clientes que, se precisarem da certificação, cabe a eles contratar um auditor para avaliar os próprios controles e processos [17]. Usar um serviço certificado ajuda, mas não certifica quem o usa.
O AI Act europeu
Na União Europeia, o AI Act é a primeira lei abrangente sobre inteligência artificial, e o calendário dele mostra como a regulação chega aos poucos [21]:
| Data | O que passa a valer |
|---|---|
| 1º de agosto de 2024 | a lei entra em vigor, sem exigências ainda |
| 2 de fevereiro de 2025 | as proibições de certos sistemas e a exigência de letramento em IA |
| 2 de agosto de 2025 | as regras dos modelos de IA de uso geral e a estrutura de governança |
| 2 de agosto de 2026 | o restante da lei, salvo exceções |
| 2 de dezembro de 2027 | as obrigações dos sistemas de alto risco do Anexo III |
| 2 de agosto de 2028 | as obrigações dos sistemas de alto risco do Anexo I |
Para uma empresa brasileira, o AI Act importa de duas formas: diretamente, se ela oferece sistemas de IA no mercado europeu, e indiretamente, porque leis de outros países, inclusive a discussão brasileira, costumam seguir a mesma lógica de classificar os sistemas pelo risco.
A governança na prática
Na prática, governar agentes começa por perguntas simples, que qualquer empresa consegue responder sem norma nenhuma:
- inventário: quais agentes existem, quem os criou e o que cada um pode fazer;
- dono: quem responde por cada agente, pelos erros dele e pelas mudanças;
- avaliação de impacto: o que acontece se o agente errar, e com quem;
- permissões: quais sistemas cada agente acessa, com que privilégios, e por quê;
- supervisão: quais ações exigem aprovação humana, e quem aprova;
- registros: o que fica registrado de cada execução, por quanto tempo, e quem pode consultar;
- revisão: de quanto em quanto tempo o agente é reavaliado, e o que dispara uma revisão fora de hora.
As normas e os quadros de referência organizam essas perguntas e acrescentam outras. Mas uma empresa que não sabe responder às sete acima não está pronta para ter agentes em produção, com ou sem certificação.
Um exemplo de ponta a ponta
Para juntar as peças, vale um exemplo ilustrativo: um agente de análise de vendas para os gerentes regionais de uma rede de supermercados, que investiga quedas e altas fora do normal e entrega um relatório.
Fluxo ou agente. A tarefa passa no teste: uma investigação pode exigir dois passos ou vinte, conforme o que se encontra. É um agente. Mas a entrega do relatório, sempre igual, é um fluxo no fim do laço.
As ferramentas. Cinco, todas de leitura: vendas por loja, categoria e período; rupturas de estoque; promoções vigentes; preços de concorrentes coletados; e o calendário de eventos da região. Nenhuma altera dados, e nenhuma envia nada para fora da empresa.
O plano visível. Antes de começar, o agente mostra o plano ao gerente: "vou comparar a loja 7 com as lojas da mesma região, por categoria, e depois cruzar as categorias que caíram com as rupturas e as promoções". O gerente pode ajustar.
O contexto enxuto. As ferramentas devolvem resumos, e não tabelas inteiras. O agente guarda notas do que já descobriu, para não depender do histórico completo do laço, e descarta os resultados intermediários que não levaram a nada.
Os subagentes, se precisar. Uma investigação de toda a regional, com dezenas de lojas, pode ser dividida: um subagente por loja, cada um devolvendo um resumo curto ao agente líder. O custo em tokens sobe muito, e por isso essa opção só entra quando a pergunta justifica.
Os limites. Teto de 30 passos, de 10 minutos e de um custo definido por investigação, todos no código, com valores ilustrativos. Ao bater num limite, o agente entrega o que tem, com a indicação de que a investigação ficou incompleta.
A avaliação. Vinte casos reais de quedas já explicadas, com a causa conhecida, formam a bateria de testes. A cada mudança nas ferramentas ou nas instruções, a bateria roda três vezes, para medir a consistência, e um analista revisa as transcrições das falhas.
A governança. O agente tem um dono, o gerente de inteligência comercial, aparece no inventário de agentes da empresa, com as ferramentas e as permissões listadas, e tem a primeira revisão marcada para três meses depois da implantação. Se um dia ganhar uma ferramenta que altera dados, como sugerir pedidos de compra, ela entra com aprovação humana obrigatória e uma nova avaliação de impacto.
Nada nesse desenho depende de qual modelo está por trás. São decisões de produto e de software, e são elas que fazem o agente ser útil e governável.
Um roteiro para o primeiro agente
Para quem vai construir o primeiro agente, as seções anteriores se resumem num roteiro.
- Confirmar que precisa de um agente. Se o caminho é sempre o mesmo, um fluxo resolve, com menos custo e menos risco [2].
- Começar com leitura. As primeiras ferramentas só consultam; as que alteram dados vêm depois, uma de cada vez [14][15].
- Escrever poucas ferramentas, bem descritas, alinhadas a tarefas, e não a endereços de API [2][19].
- Pôr os limites no código: passos, tempo, custo e escopo [2].
- Definir os pontos de aprovação humana antes de dar a primeira ferramenta que altera dados [15].
- Evitar a tríade letal desde o desenho [18].
- Mostrar o plano: o agente explica o que vai fazer antes de fazer [2][15].
- Montar a avaliação com uma ou duas dezenas de tarefas reais, medindo resultado, consistência e custo [3][8].
- Registrar tudo: cada passo, cada ferramenta, cada aprovação.
- Dar um dono ao agente e uma data para a primeira revisão.
Erros comuns
- Chamar de agente o que é um fluxo. Não há problema em ser fluxo; o problema é tratar com a complexidade de um agente o que não precisa [2].
- Começar pelo sistema com vários agentes. Ele custa cerca de quinze vezes mais tokens que uma conversa e só compensa em tarefas paralelizáveis e valiosas [3].
- Deixar os limites para o modelo. O teto de passos e de custo fica no código [2].
- Confiar num framework sem ver os prompts. As abstrações escondem o que o modelo recebe e dificultam a depuração [2].
- Avaliar com uma tentativa. A consistência em várias tentativas é o que importa em produção [8].
- Avaliar só com um modelo como juiz. A revisão humana pega o que a automática perde [3].
- Dar ao agente mais ferramentas e permissões do que a tarefa exige. É a agência excessiva [14].
- Ações de impacto sem aprovação. Pessoas devem aprovar as decisões de alto impacto [15].
- Juntar dados privados, conteúdo de fora e saída para fora. É a tríade letal [18].
- Memória sem controle. Ela vaza informação entre contextos e pode ser envenenada [13][15].
- Recomeçar do zero a cada falha. Retomar do ponto de falha poupa custo e tempo em tarefas longas [3].
- Agentes sem dono e sem inventário. Ninguém revisa o que ninguém sabe que existe.
Conclusão
Um agente de IA é um modelo de linguagem dentro de um laço: ele recebe um objetivo, escolhe uma ação, observa o resultado e decide de novo [2][20]. A ideia é antiga na inteligência artificial [1]; o que mudou foi o cérebro, que passou a ser um modelo capaz de raciocinar em linguagem natural, aprender com o próprio erro e usar ferramentas [5][6][7]. Entre a chamada única e o agente autônomo há um espectro de padrões, e a recomendação de quem mais constrói agentes é ficar no ponto mais simples que resolve o problema [2].
As medições mostram uma capacidade que cresce rápido, mas também uma confiabilidade que ainda deixa a desejar: o tamanho das tarefas que os agentes fazem sozinhos vinha dobrando a cada sete meses, e ainda assim os melhores agentes erravam com frequência a mesma tarefa em tentativas repetidas [4][8]. Sistemas com vários agentes resolvem problemas maiores, a um custo bem maior [3].
Os riscos acompanham a autonomia. A OWASP lista dez riscos próprios dos agentes, da manipulação do objetivo aos agentes fora de controle [13], e as respostas são conhecidas: ferramentas e permissões mínimas, limites no código, pessoas aprovando as ações de impacto, transparência sobre o plano e nada de juntar dados privados, conteúdo de fora e saída para fora [14][15][18]. Por cima disso, a governança dá nome, dono e prestação de contas a cada agente, com referências como o NIST AI RMF, a ISO/IEC 42001 e o AI Act [16][17][21]. Agentes bem governados são uma das ferramentas mais poderosas que uma empresa pode ter. Mal governados, são um funcionário novo com acesso a tudo e ninguém olhando.
Para quem começa agora, o caminho mais seguro é o gradual: um agente de leitura, com poucas ferramentas, limites no código, plano visível e uma bateria de testes com casos reais. As ações que alteram dados vêm depois, uma de cada vez, com aprovação humana. A confiança no agente cresce na medida das avaliações, e não da impressão.
Fontes
- Intelligent agent — en.wikipedia.org
- Building effective AI agents — anthropic.com
- How we built our multi-agent research system — anthropic.com
- Measuring AI Ability to Complete Long Tasks — metr.org
- ReAct: Synergizing Reasoning and Acting in Language Models — arxiv.org (artigo científico)
- Reflexion: Language Agents with Verbal Reinforcement Learning — arxiv.org (artigo científico)
- Generative Agents: Interactive Simulacra of Human Behavior — arxiv.org (artigo científico)
- τ-bench: A Benchmark for Tool-Agent-User Interaction in Real-World Domains — arxiv.org (artigo científico)
- Agent2Agent (A2A) Protocol — a2a-protocol.org
- Model Context Protocol: Specification — modelcontextprotocol.io
- Linux Foundation Announces the Formation of the Agentic AI Foundation — linuxfoundation.org
- OWASP Top 10 for Agentic Applications for 2026 — genai.owasp.org
- OWASP Top 10 for Agentic Applications 2026 — aigl.blog
- LLM06:2025 Excessive Agency — genai.owasp.org
- Our framework for developing safe and trustworthy agents — anthropic.com
- AI Risk Management Framework — nist.gov
- ISO/IEC 42001:2023 Artificial Intelligence Management System Standards — learn.microsoft.com
- The lethal trifecta for AI agents — simonwillison.net
- Writing effective tools for agents — anthropic.com
- How tool use works — platform.claude.com
- EU AI Act: Implementation Timeline — artificialintelligenceact.eu
- Tree of Thoughts: Deliberate Problem Solving with Large Language Models — arxiv.org (artigo científico)
- Effective context engineering for AI agents — anthropic.com
- Effective harnesses for long-running agents — anthropic.com
- Introducing computer use, a new Claude 3.5 Sonnet, and Claude 3.5 Haiku — anthropic.com
- SWE-bench: Can Language Models Resolve Real-World GitHub Issues? — arxiv.org (artigo científico)
Este post foi escrito com a ajuda da Juniper, a assistente de IA da Gothor, e revisado pela nossa equipe antes de ir ao ar.